Сетевые ошибки “как диагноз”: почему 502/504 появляются именно у вас
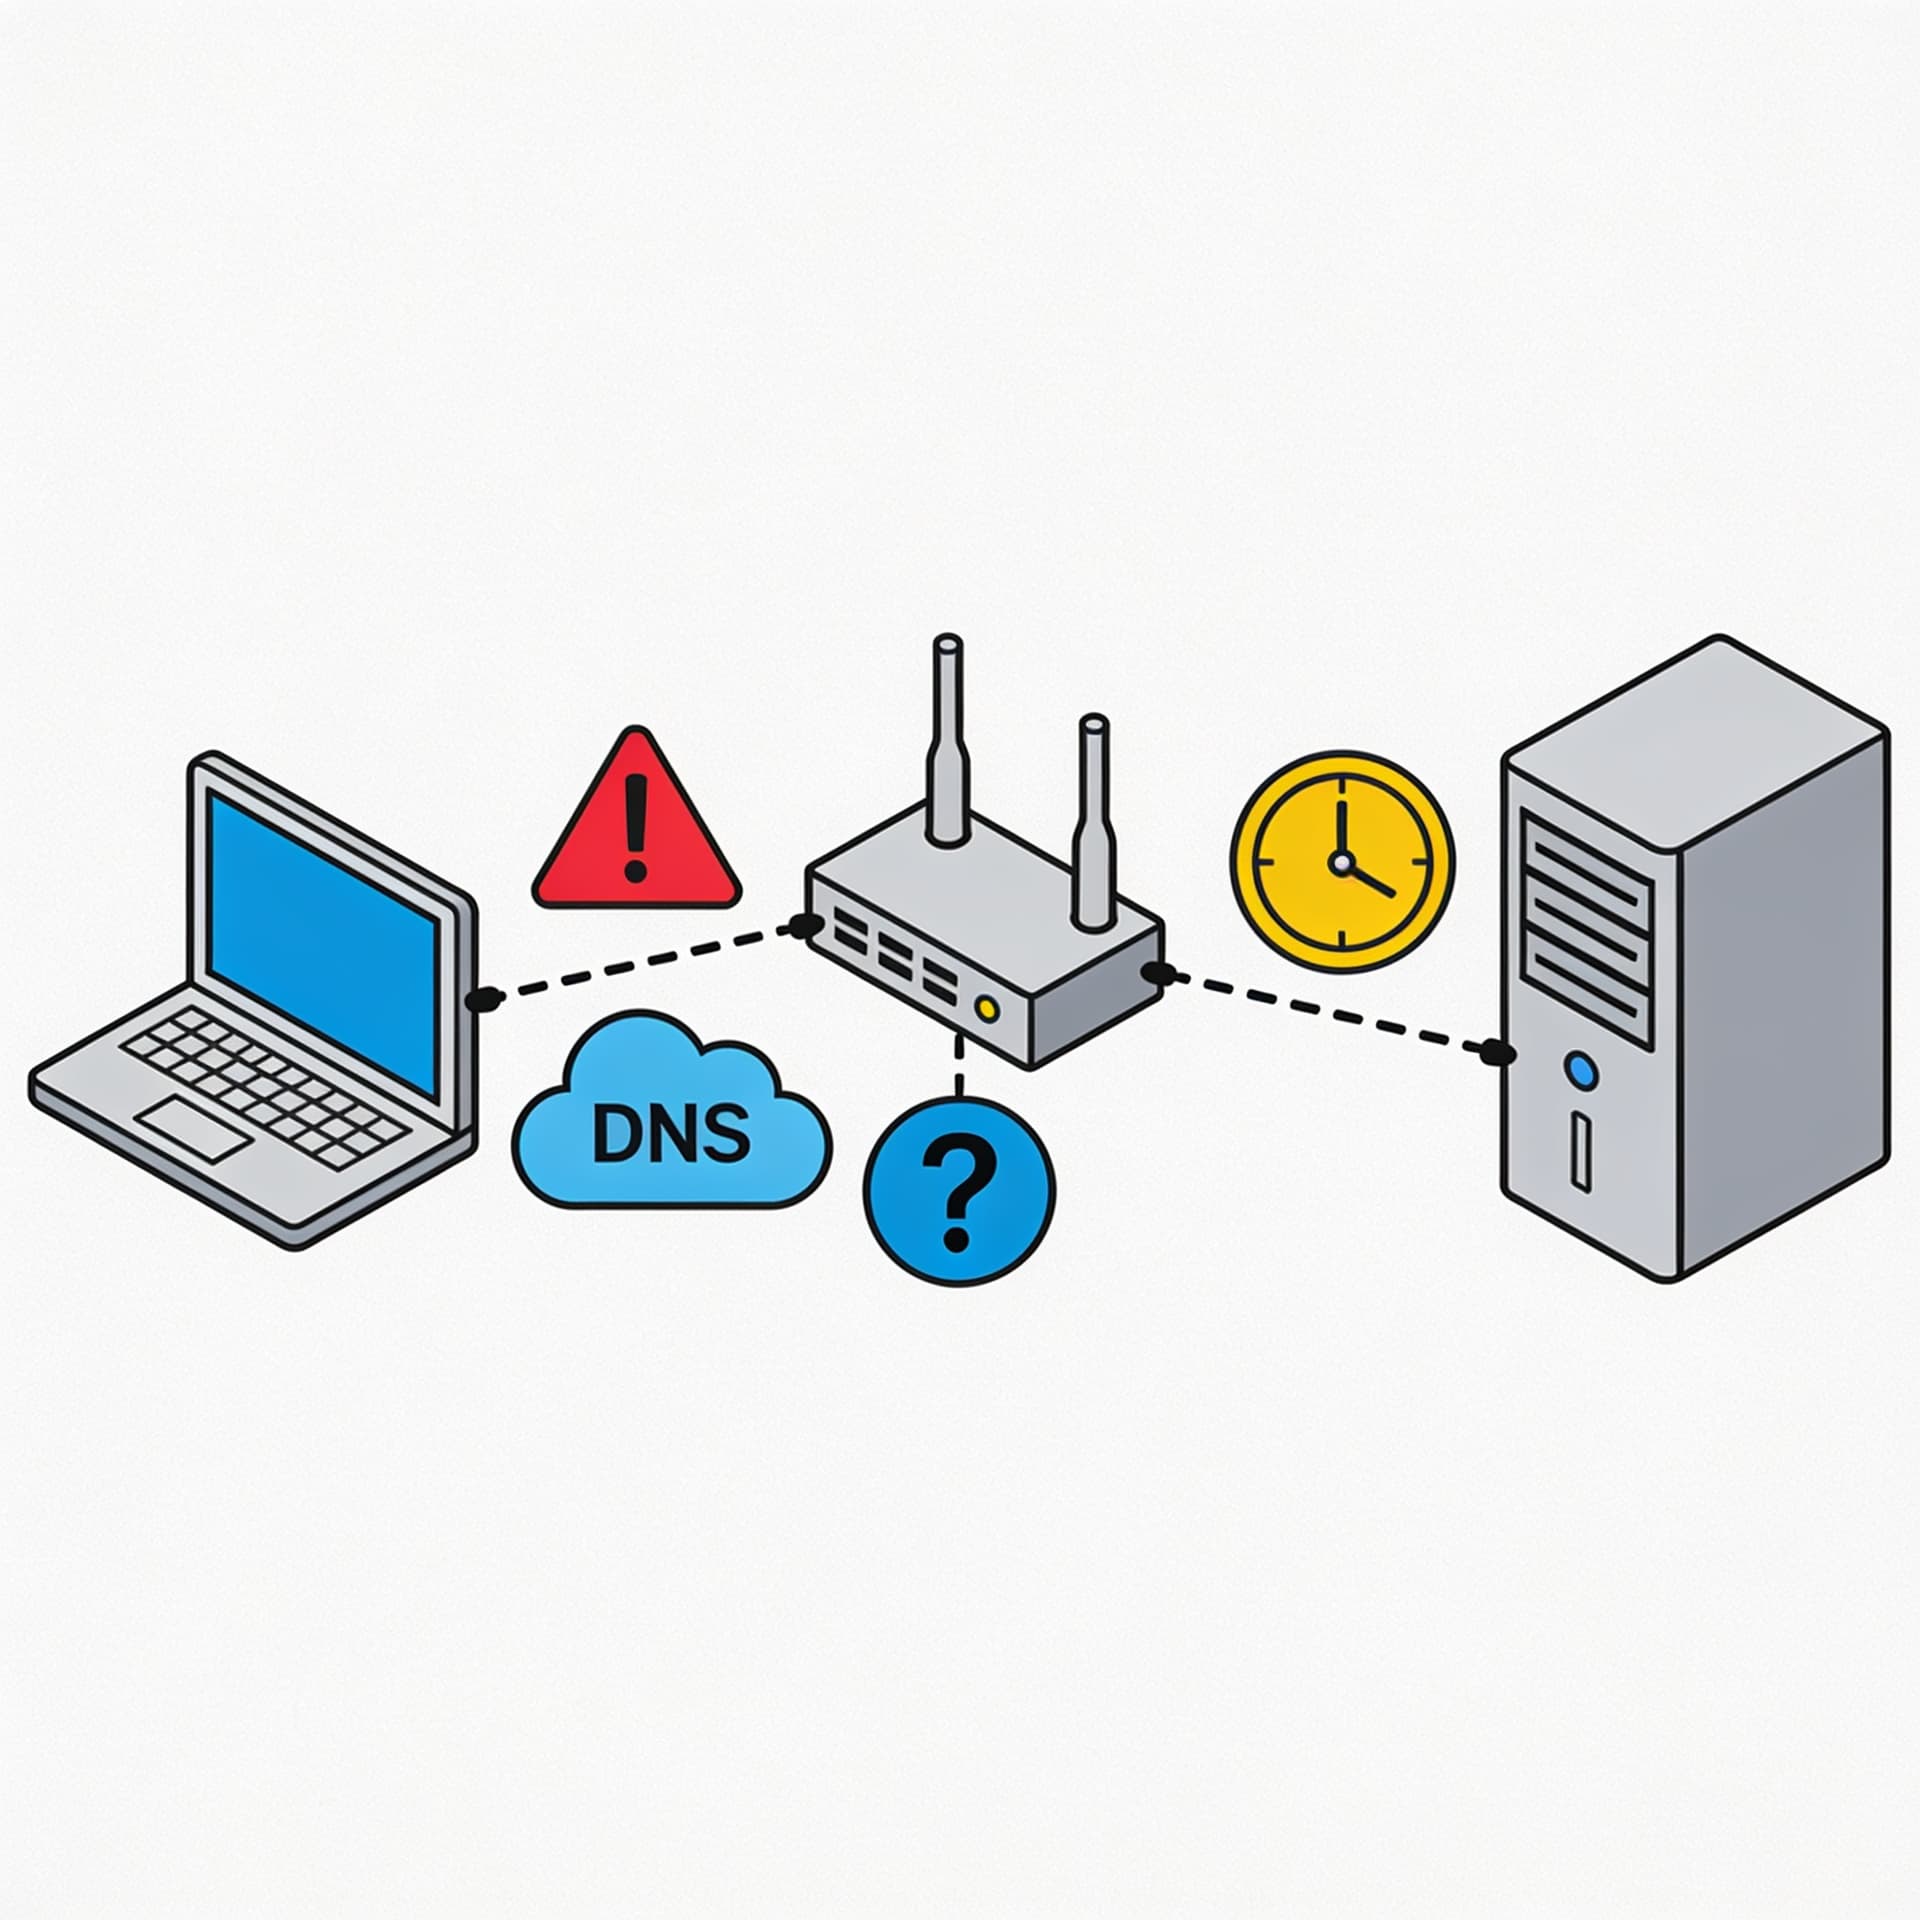
Соберём карту причин по симптомам: от upstream до DNS/таймаутов, и научимся быстро локализовать проблему между клиентом, прокси и приложением.
Содержание
Ошибки 502 и 504 в вебе — это не «что-то сломалось», а, скорее, попытка системы честно сообщить: я не смог получить ответ там, где ожидал. Но большинство команд воспринимают эти коды как одинаковые и начинают “чинить всё подряд”: перезапускают серверы, меняют конфиги, ставят заглушки. В итоге проблема не локализуется — только меняется следующее звено цепочки.
В этой статье мы построим карту причин по симптомам и научимся быстро отделять одно от другого: где именно ломается цепочка между клиентом, прокси (LB/ingress), приложением и внешними зависимостями (upstream), включая DNS и таймауты. Вы получите практический алгоритм диагностики и примеры команд, которые помогут сделать “сетевую ошибку” диагнозом, а не гаданием.
1) Что на самом деле означают 502 и 504
1.1. 502 Bad Gateway: “промежуточный узел получил странный ответ от upstream”
HTTP 502 обычно появляется на прокси/балансировщике, когда он отправляет запрос на следующий hop (upstream) и получает ответ, который не может быть обработан как валидный: от неверного протокола до сбоя соединения, сбоя TLS, ретурна неправильного статуса или обрыва соединения на уровне, который прокси трактует как “gateway error”.
Классические сценарии:
- upstream недоступен (соединение отказано / connection reset / timeout на уровне TCP, но трактуется как 502 в конкретной реализации);
- upstream отвечает, но сбоит TLS (например, сертификат не проходит проверку на стороне прокси);
- upstream или сервис-сторона возвращают данные с нарушенной схемой (например, прокси ожидает HTTP/1.1, а получает неожидаемый формат — это реже, но встречается в миксах конфигураций);
- прокси не может корректно прочитать ответ из upstream (ранний EOF).
1.2. 504 Gateway Timeout: “промежуточный узел не дождался upstream”
504 — про таймаут. Прокси/балансировщик дождался отправки запроса на upstream, но ответ не пришёл за отведённое время.
Классика:
- приложение зависло или медленно обрабатывает запрос;
- upstream перегружен (очереди растут, worker’ы не успевают);
- неверно настроены таймауты: например, прокси ждёт меньше, чем реально нужно приложению (или наоборот, приложение ждёт больше, чем прокси позволяет);
- downstream-зависимости (БД, внешний API) вызываются с длительными ожиданиями и “тянут” ответ до таймаута.
1.3. Почему “появляются именно у вас”
Ключевой тезис: коды 502/504 почти никогда не “случаются сами по себе”. Они возникают когда ваша конкретная цепочка (клиент → edge/LB/proxy → ingress → сервис → внешние зависимости) попадает в определённое состояние: деградация, перегруз, сетевые изменения, неправильная маршрутизация, TTL/DNS, таймауты. Даже одна небольшая разница в окружении (регион, DNS resolver, MTU, параметры keep-alive, лимиты на коннекты) делает проблему уникальной.
2) Симптомы и быстрые “вилки” диагностики
2.1. Вопросы, которые стоит задать в первую минуту
Соберите контекст, прежде чем “лазить в nginx” или “перезапускать контейнеры”:
-
Где именно видите ошибку?
На клиенте (браузер), в API-клиенте, в корпоративном прокси, в CDN, в ingress? -
Кто возвращает код?
Смотрите заголовки ответа:Server,Via,X-...-Request-ID,Age, часто можно понять, какой узел сформировал ошибку. -
Это всегда 502/504 или всплесками?
Постоянная ошибка часто указывает на маршрут/конфигурацию или глобальный сбой upstream. Всплески — на нагрузку, сетевые колебания, проблемы с пулом соединений. -
Есть ли корреляция с конкретными маршрутами (URL), методами, заголовками?
Например, только POST или только большие ответы — значит, виноват payload/streaming/timeout на чтении. -
Наблюдается ли различие между “молодыми” и “долго живущими” клиентскими соединениями?
Если проблема только на новых соединениях — возможен эффект холодного старта, DNS/TLS handshake, пулов, лимитов на connect.
2.2. “Матрица” для первичной локализации
Упрощённо можно мыслить так:
- Если 504 → скорее всего таймаут между прокси и upstream или между upstream и его зависимостями.
- Если 502 → чаще проблема соединения/протокола/нестабильности upstream, либо прокси не смог корректно получить/прочитать ответ.
Но реальность сложнее: некоторые прокси маппят разные сбои в 502. Поэтому важно смотреть логи конкретного hop.
3) Топология цепочки: от edge до приложения
Чтобы диагноз был точным, полезно “нарисовать карту” вашей инфраструктуры:
- Клиент (браузер/клиент API)
- CDN/WAF (если есть)
- Edge/LB (ALB/NLB/ingress-controller)
- Reverse proxy (nginx/traefik/envoy)
- Kubernetes ingress / service mesh (если есть)
- Сервис (upstream app)
- Зависимости (DB, cache, внешние API)
- DNS (внутренний/внешний), резолверы
На каждом звене есть свои таймауты, ретраи, лимиты на коннекты и очереди. Часто ошибка — не “в приложении”, а в рассинхроне этих параметров.
4) Карта причин: upstream, таймауты, DNS и сеть
4.1. Upstream недоступен (DNS/маршрутизация/сервер)
Сценарии, которые часто дают 502:
- upstream IP/endpoint изменился, а прокси/ingress держит старую информацию;
- Service/endpoint в Kubernetes не ready, но маршрут всё равно прокидывается;
- security group/ACL/NetworkPolicy блокирует трафик на нужный порт;
- upstream процесс упал или не слушает порт (LISTEN отсутствует);
- TLS handshake с upstream падает (неправильный SNI, неверный сертификат, протокол TLS версии).
Как это проверить быстро:
- С клиента до edge:
curl -v https://your.domain/pathи посмотрите, кто отвечает (хедеры) и где падает. - С узла прокси до upstream: “сердцем” диагностики будет тест с той же машины/подсети, которая действительно ходит к upstream.
Пример: если у вас nginx/ingress в Kubernetes, запустите ephemeral pod в том же namespace и выполните:
# Внутри кластера: проверить доступность upstream по имени сервиса
nslookup your-upstream-service.default.svc.cluster.local

# Проверить TCP связность
nc -vz your-upstream-service 80

# Проверить HTTP ответ
curl -v --connect-timeout 3 --max-time 10 http://your-upstream-service/health
Если nc не соединяется — это не про приложение, это про сеть/endpoint.
4.2. Таймаут чтения/записи: 504 “упрямо” и с определёнными типами запросов
504 — типичный результат несогласованных таймаутов:
- LB ждёт ответ 30 секунд, а приложение в реальности обрабатывает 45 из-за очереди;
- nginx имеет
proxy_read_timeout, но upstream отдаёт ответ после чтения тела/стриминга дольше лимита; - upstream вызывает внешний API с таймаутом 60 секунд, но ваш edge обрывает раньше.
Проверка:
- посмотрите, какие таймауты выставлены в конфигурации edge/proxy (nginx/ingress/envoy);
- сравните с таймаутами в приложении и клиентах;
- оцените p95/p99 latency: если 504 начинается на нагрузке и растёт с задержкой — таймаут почти наверняка.
Практический приём: выяснить, на каком этапе теряется время. В логах прокси обычно есть таймстемпы upstream connect/read.
4.3. DNS и TTL: “всё работает вчера, а сегодня — 502/504”
DNS — частый невиновный виновник. Причины:
- нестабильный resolver (например, внутренний DNS временно отдаёт NXDOMAIN/не тот IP);
- TTL слишком большой, и вы сменили endpoint, но старые кэши живут дольше;
- прокси кэширует DNS (и не обновляет как ожидается);
- split-horizon DNS и разные резолверы для разных подсетей/регионов.
Симптом: ошибка возникает не у всех пользователей одинаково, а у тех, кто попадёт в конкретный балансировочный узел или подсеть.
Проверки:
# На стороне, откуда прокси/ingress резолвит DNS
dig +time=2 +tries=2 your-upstream-host.example

# Сравнить IP, которые получает edge и ваши рабочие узлы
dig +short your-upstream-host.example
Если IP разные или ответы нестабильны — ищите проблему в DNS инфраструктуре, TTL и кэшировании в прокси.
4.4. Проблемы соединений: keep-alive, лимиты и истощение ресурсов
Иногда 502/504 следуют не за “тяжёлым запросом”, а за тем, что ресурсы закончились:
- исчерпан лимит file descriptors;
- закончились свободные соединения в пуле;
- слишком маленькие лимиты keep-alive/idle connections;
- rate limiting/connection draining с неправильно настроенными параметрами.
Пример симптомов:
- время до первого byte растёт;
- 502 возникает при всплесках новых соединений;
- после рестарта узла проблема временно пропадает.
Проверка на практике:
- мониторьте метрики прокси/LB: active connections, upstream connect time, request latency, error rates;
- в Kubernetes — метрики ingress controller/mesh.
4.5. TLS/SNI/протоколы: 502 на ровном месте
Когда прокси ходит на upstream по HTTPS, TLS-связь может ломаться так, что application не успевает “проявиться”. Типовые причины:
- неверный SNI: сертификат для другого имени;
- upstream использует устаревшие TLS версии;
- цепочка сертификатов/CA не доверена;
- есть разный режим (mTLS vs обычный TLS), и один из hop’ов настроен иначе.
Если 502 наблюдается сразу после включения нового сертификата/маршрута — проверьте TLS handshake. Часто полезно:
curl -v --tlsv1.2 https://your-upstream-host/health --connect-timeout 3 --max-time 10
А также проверить конфигурацию SNI на стороне прокси.
5) Алгоритм локализации за 15–30 минут
Ниже — практичный порядок действий, который обычно быстрее “гадания”.
5.1. Шаг 1: определить, какой узел возвращает ошибку
Возьмите один пример запроса и посмотрите ответ с заголовками:
curl -sv https://your.domain/path -o /dev/null
Смотрите:
Server/ViaX-Request-IDили похожие корреляционные идентификаторы- статус формируется на edge или уже на вашем приложении
Если есть Server: nginx (или имя ingress controller), значит код почти наверняка с вашей стороны proxy.
5.2. Шаг 2: сравнить тайминг “до ошибки”
Снимите timing в curl:
curl -o /dev/null -s -w "\nDNS:%{time_namelookup} TCP:%{time_connect} TLS:%{time_appconnect} TTFB:%{time_starttransfer} Total:%{time_total}\n" https://your.domain/path
Интерпретация:
- если долго
time_namelookup— DNS; - если долго
time_connect— сеть/маршрут/endpoint; - если долго
TLS— сертификаты/handshake; - если TTFB растёт до таймаута — upstream или его зависимости.
5.3. Шаг 3: воспроизвести с точки зрения прокси
Самая частая ошибка — диагностировать “с ноутбука” и пытаться сделать выводы о цепочке, которая уходит из датацентра. Если есть возможность — выполните тесты из той же подсети/кластера, где работает прокси.
В Kubernetes это обычно проще всего через временный pod в том же namespace/сервисном аккаунте.
5.4. Шаг 4: разделить “проблема соединения” vs “проблема обработки”
Сделайте два отдельных теста:
- TCP связность (
nc/curl --connect-timeout):
- если не проходит → 502 вероятнее, это сеть/endpoint/TLS.
- HTTP health/быстрый endpoint с адекватным таймаутом (
curl --max-time):
- если health отвечает быстро, но бизнес-эндпоинт падает → проблема внутри приложения, очередей, зависимостей или payload.
5.5. Шаг 5: проверить таймауты на каждом hop
Соберите значения:
connect timeout(сколько ждём установления соединения)read timeout/response timeout(сколько ждём ответа)- ограничения на размер/буферизацию (иногда большие ответы приводят к неожиданным таймаутам на чтении)
- ретраи (важно: ретраи могут усиливать нагрузку и “размазывать” симптомы)
Золотое правило: таймауты должны быть согласованы по направлению — от прокси к приложению и к внешним зависимостям.
6) Типичные подводные камни (из практики эксплуатации)
6.1. “502/504 только у части пользователей”
Это часто связано с балансировкой по узлам:
- часть запросов попадает на один ingress replica, который деградировал;
- проблема в DNS-кэше или resolver на конкретном node;
- разные маршруты/география у CDN.
Решение: включите корреляцию по request-id и посмотрите распределение по edge nodes.
6.2. “После рестарта всё стало нормально на 20 минут”
Это не победа. Обычно так проявляются:
- утечки соединений,
- исчерпание пулов,
- рост очередей,
- деградация из-за зависимостей (DB/queue), которая потом снова “догоняет”.
Если есть 20 минут — значит, проблема не полностью исчезла. После “лечебного” рестарта снова начните с метрик до момента ошибки.
6.3. Прокси сжимает симптомы
Иногда вы видите 502/504, но реальная первопричина спрятана в статусах upstream или в причине, которую прокси логирует детальнее.
Например:
- upstream возвращает 499/502/503 изнутри;
- прокси по каким-то причинам выдает универсальный 504;
- вы смотрите только клиентский статус, игнорируя upstream logs.
Решение: всегда заглядывайте в логи того узла, который сформировал ответ с 502/504.
7) Практический пример: как отличить “таймаут сети” от “медленной обработки”
Предположим, у вас 504 на URL /report/generate. Логика:
- Если TTFB велик и близок к таймауту edge, а на health всё нормально — вероятно, приложение или его зависимости.
- Если
time_connectрастёт — это не обработка, а установление соединения до upstream. - Если
TLSдолгий — проблема TLS/сертификатов/handshake. - Если DNS меняется — возможно, upstream “прыгает” по IP.
Что делать:
- создайте отдельный health endpoint: он должен быть быстрым и не трогать тяжёлые зависимости;
- измерьте p95 времени
/report/generateи p95 времени вызовов к БД/внешнему API; - настройте таймауты edge выше, чем максимальное ожидание приложения (с запасом), но не бесконечно — иначе вы получите “висячие” запросы и ресурсы будут сгорать.
8) Когда 502 и 504 одинаково “похожи”, но причины разные
Есть состояния, которые порождают оба кода:
- upstream то отвечает, то сбрасывает соединение: прокси иногда получает обрыв и маппит в 502, а иногда ждёт дольше и выходит в 504;
- очередь в приложении растёт: часть запросов успевает до таймаута, часть — нет;
- DNS резолвится нестабильно: часть запросов идёт на живой IP, часть — на неактуальный.
Поэтому важно смотреть связку:
- долю 502/504,
- распределение по времени,
- корреляцию с нагрузкой (CPU/latency),
- распределение по узлам edge/LB.
9) Как “превратить” диагностику в повторяемый процесс команды
Чтобы сетевые ошибки перестали быть стрессом, команде нужен чеклист и дисциплина логирования.
9.1. Минимальный набор: что логировать и хранить
- корреляционный
request-id(илиtraceparentдля distributed tracing); - тайминги upstream: connect/read/response time;
- конечный статус и причина отказа upstream (если доступно);
- параметры конфигурации