Интеграции с ИИ для работы: от промптов к наблюдаемым результатам и тестам
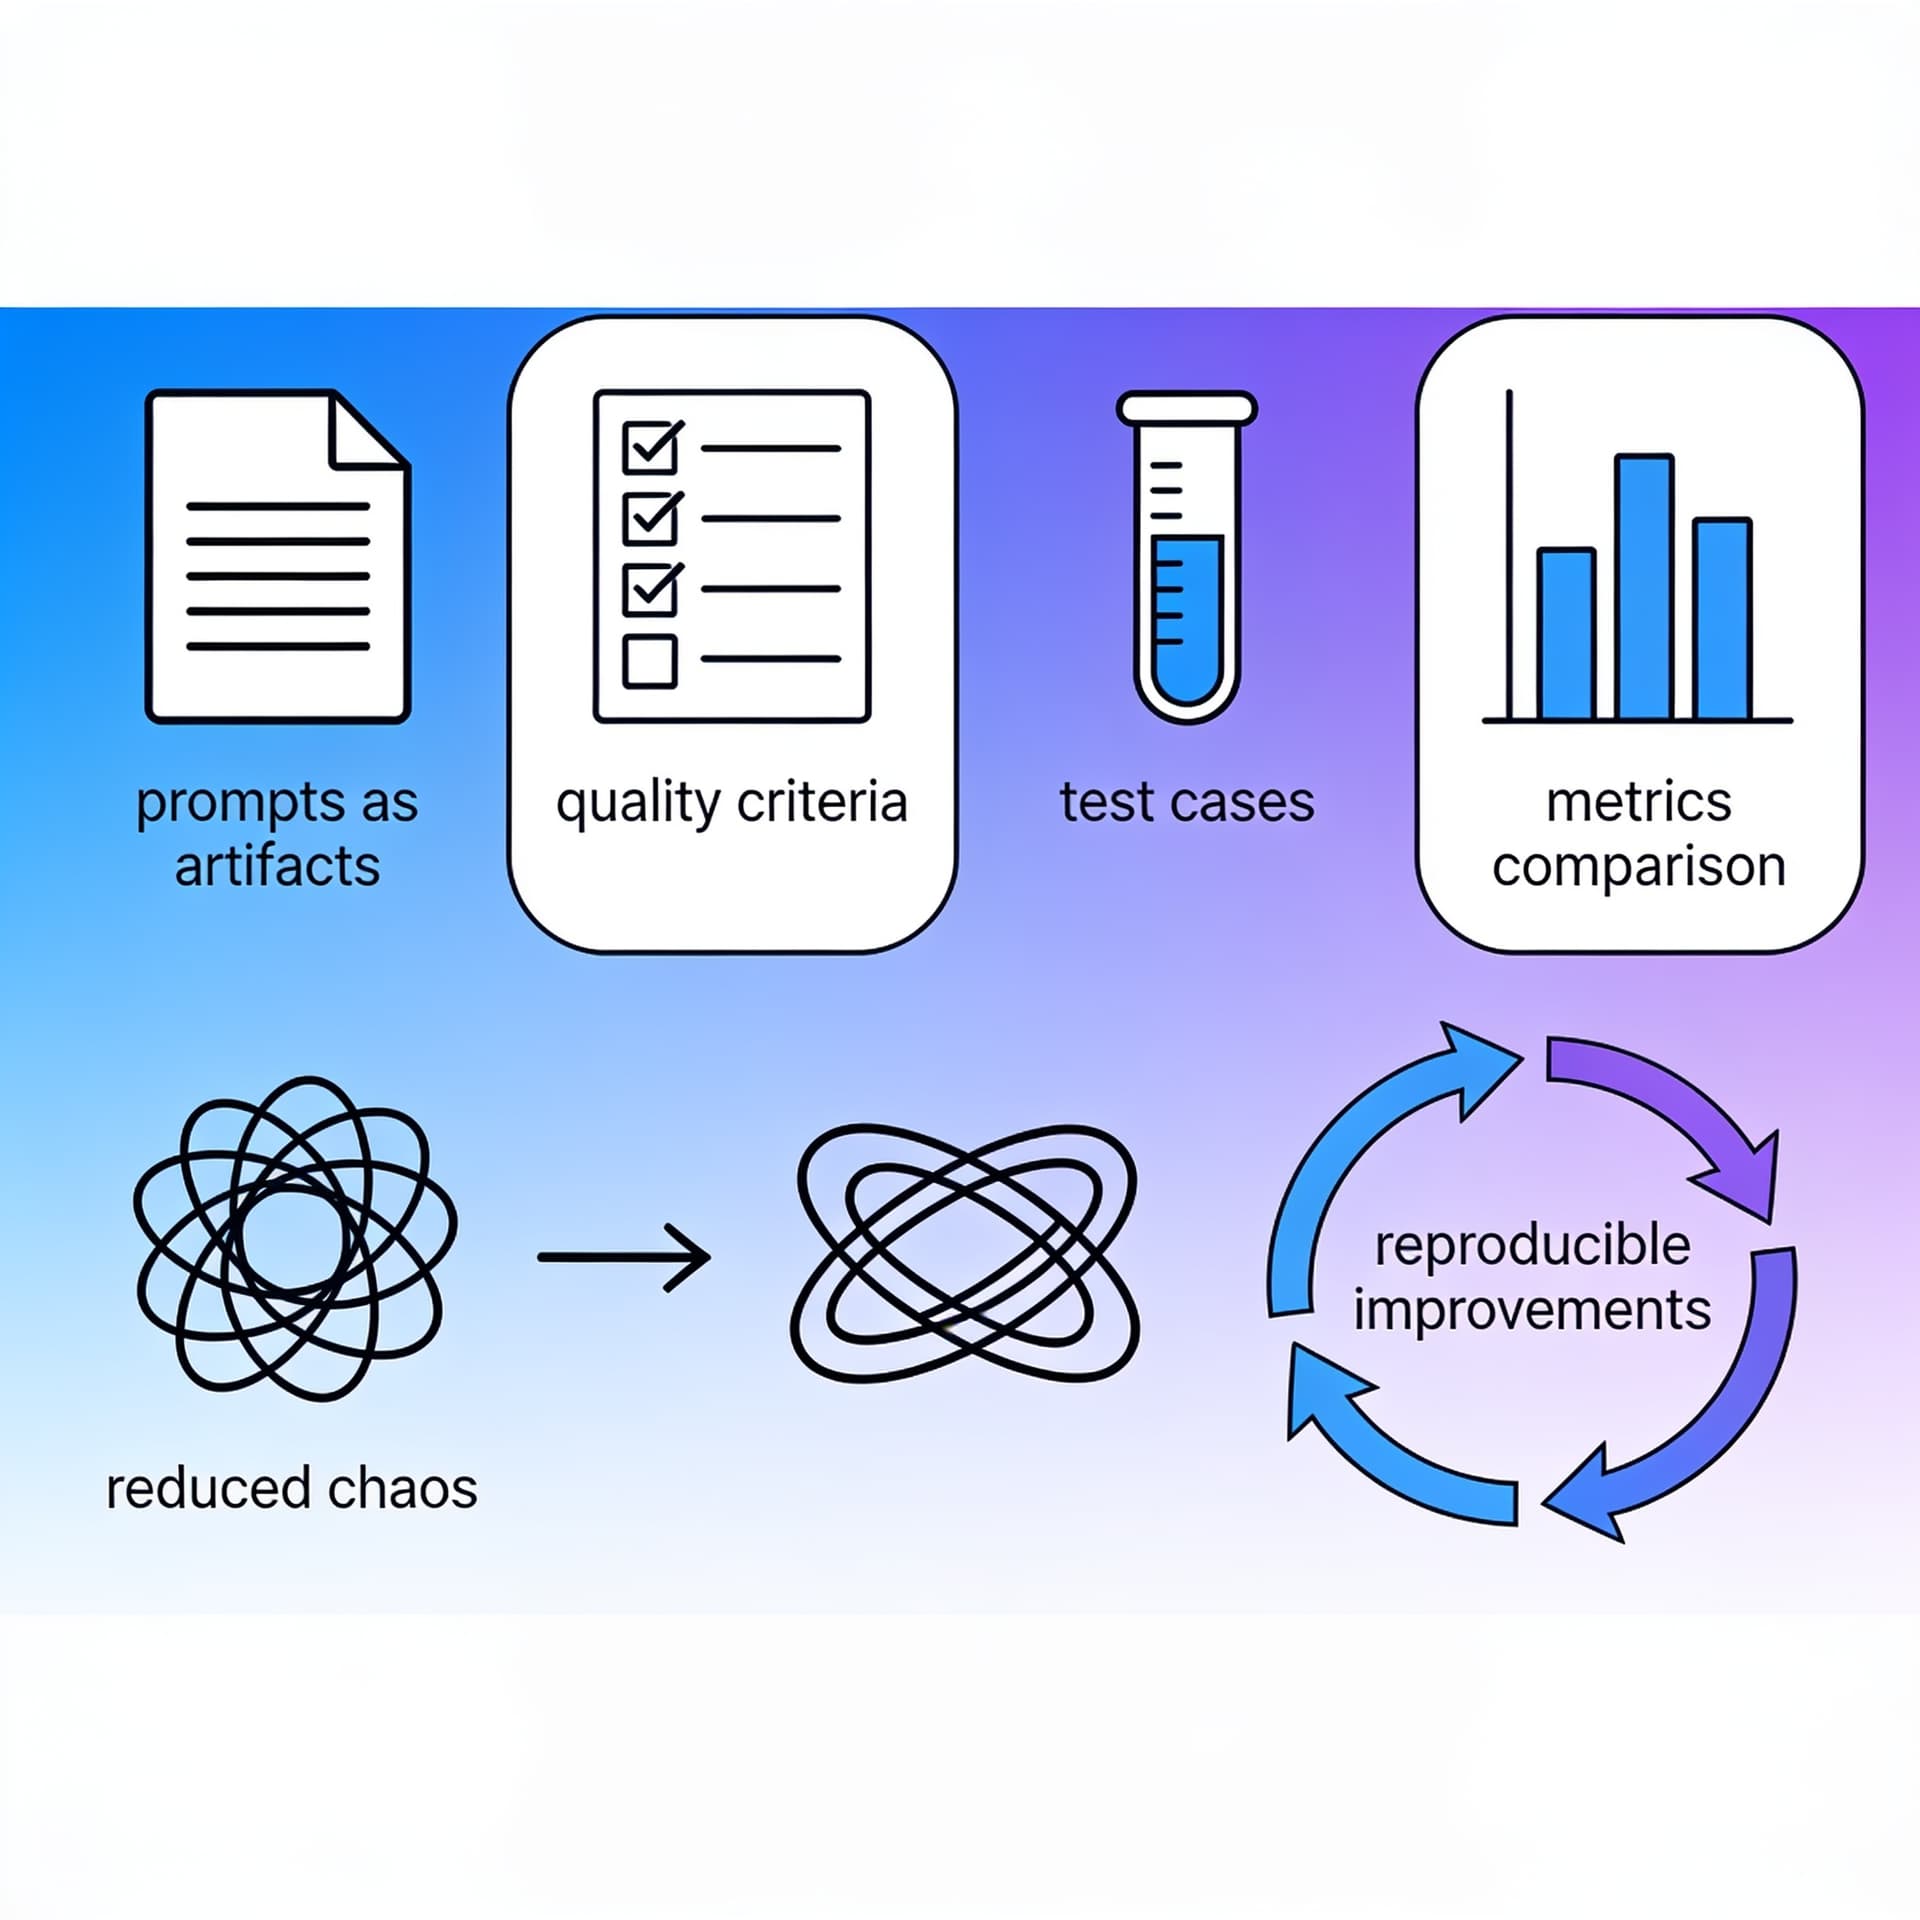
Построим процесс внедрения LLM в продукт: промпты как артефакты, критерии качества, набор тестовых кейсов и метрики для сравнения версий. Покажем, как снижать хаос и превращать эксперименты в воспроизводимые улучшения.
Содержание
Интеграция LLM (Large Language Models) в продукт редко начинается с «правильного процесса». Обычно это выглядит так: есть задача — нужно «попросить модель», набрасывают промпт, проверяют на паре примеров, получают впечатляющий результат… и дальше начинается хаос. Точность то растёт, то падает; качество зависит от формулировки; один и тот же запрос в разные дни может отвечать по-разному; а понять, почему изменения улучшили или ухудшили результат, почти невозможно.
В этом материале разберём, как превратить эксперименты с ИИ в воспроизводимый инженерный процесс: от промптов как артефактов — к критериям качества, тестовым наборам, метрикам и наблюдаемости. В итоге вы получите основу для системы, которая помогает внедрять LLM в рабочие сценарии, а не только демонстрировать «вау» на слайдах.
Почему промпт — это не текст, а артефакт
Промпт как конфигурация (а не как комментарий)
В зрелых командах промпт перестаёт быть «строкой в коде» и становится артефактом. Это означает несколько вещей:
- Промпт имеет версию (как минимум в Git).
- Он тестируется на наборе примеров.
- Имеется контракт между разработчиком и бизнесом: что модель должна делать и какие ограничения должна соблюдать.
- Промпт регистрируется в контуре экспериментов: какая модель, какие параметры, какие системные инструкции, какой контекст.
Практическая формулировка: промпт — это конфигурация поведения модели, а не «пожелание».
Разделяйте роли и состав промпта
Классическая проблема промптов — смешение инструкций, контекста и данных. Лучше разделять:
- System instructions: правила и стиль поведения.
- Task specification: конкретная задача и формат ответа.
- Constraints: требования (например, запрет на выдумывание).
- Few-shot examples: демонстрации успешного поведения (если применимо).
- Input data: реальные данные пользователя/системы.
Это упрощает итерации: вы можете менять примеры, не рискуя разрушить формальные ограничения.
Делайте промпты воспроизводимыми
Чтобы сравнивать версии, нужно минимизировать вариативность. Это включает:
- фиксированные параметры генерации (температура, top_p, max_tokens),
- единый способ сборки контекста,
- единый формат входных данных и шаблонов,
- контроль параметров модели (не только имя, но и конкретная конфигурация).
Процесс внедрения LLM: путь от промптов к наблюдаемым улучшениям
Шаг 1. Определите задачу в терминах результата
Не «улучшить ответы», а сформулировать, как выглядит успех. Для рабочего продукта обычно важны наблюдаемые свойства:
- Структура ответа: JSON, таблица, список полей, цитирование источников.
- Корректность: фактическая точность относительно данных.
- Полнота: все ли требуемые разделы присутствуют.
- Инструкция-совместимость: соблюдение формата, запретов, допустимых действий.
- Безопасность: отсутствие утечек, запрещённого содержимого, обхода политик.
- Устойчивость: качество на «длинных» и «шумных» вводах.
Хорошая практическая метрика на этом этапе — это чеклист критериев качества (см. следующий раздел).
Шаг 2. Сформулируйте критерии качества (quality rubric)
Критерии — это то, что связывает промпт и тесты. Они должны быть:
- измеримыми хотя бы частично,
- понятными не только инженерам,
- устойчивыми к вариациям формулировок.
Пример рубрики для сценария «сгенерировать ответ в формате JSON»:
- Валидность формата: ответ парсится в JSON.
- Полнота полей: присутствуют все обязательные ключи.
- Корректность полей: значения соответствуют входным данным и логике.
- Отказ при недостатке данных: если вход не даёт оснований, модель выбирает режим «недостаточно информации».
- Соблюдение ограничений: не добавляет внешние факты, не угадывает.
Эту рубрику удобно закрепить как отдельный документ/файл рядом с промптом и кодом.
Шаг 3. Постройте тестовый набор: реальные кейсы и “ловушки”
Состав тестов
Сильный тестовый набор для LLM обычно включает несколько типов кейсов:
- Happy path: типичные входы, где модель должна отвечать корректно.
- Edge cases: длинные документы, нестандартная пунктуация, неполные поля.
- Негативные кейсы: входы, где модель должна отказать или запросить уточнение.
- Регрессии: конкретные ситуации, где раньше были ошибки.
- Адверсариальные: попытки заставить модель нарушить правила (prompt injection, попытка получить системные инструкции, подмена контекста).
Минимальный размер vs. покрытие
Нет универсальной цифры «сколько кейсов нужно». Практически полезно начать с 30–80 кейсов, но с высокой долей «опасных» ситуаций. Потом расширять. Главное — чтобы тесты были репрезентативны вашему рабочему домену.
Что именно тестируем
Для разных задач может быть разное «измерение»:
- строгий match к ожидаемой структуре,
- семантическое соответствие (оценка LLM/эвристики),
- сравнительная оценка двух версий (A/B по рубрике),
- факт-чек по источникам (если есть RAG).
Метрики: как сравнивать версии промптов и моделей
Метрики должны быть связаны с рубрикой
Одна из ключевых ошибок команд — собирать «метрики ради метрик». В результате это KPI, который не помогает принять решение о промпте.
Лучше строить метрики в соответствии с рубрикой качества:
- FormatPassRate: доля ответов, которые проходят парсинг/валидацию.
- FieldCompleteness: средняя полнота обязательных полей.
- ConstraintViolationRate: доля нарушений запретов.
- Accuracy: доля верных утверждений (если есть ground truth).
- RefusalCorrectness: корректность отказов/запросов уточнений.
- Helpfulness (аккуратно): оценка по шкале эксперта/LLM-оценщика с заданными правилами.
Сравнение версий: абсолютные и относительные показатели
Для промышленной разработки полезна связка:
- абсолютные метрики (сколько стало хорошо/плохо),
- относительные (на сколько лучше/хуже новая версия на том же наборе).
В идеале вы сравниваете не только «среднее», но и «хвосты» — ухудшение на сложных кейсах.
Рандомизация и “шум” метрик
LLM — вероятностные системы. Даже с фиксированными параметрами возможна небольшая вариативность. Поэтому:
- фиксируйте seed там, где возможно,
- используйте несколько прогонов на кейс, чтобы оценить дисперсию,
- в тестах принимайте решение по критериям с допуском (например, снижение FormatPassRate на 1–2 п.п. может быть шумом, а падение на 10 п.п. — реальная проблема).
Наблюдаемость (observability): фиксируем то, что обычно теряется
Что логировать при вызове LLM
Чтобы превращать эксперимент в управляемое улучшение, нужно хранить контекст и результаты. Минимальный набор логов:
- идентификатор промпта/версии (prompt_version),
- идентификатор модели и параметры генерации,
- входной запрос (или хэш, если это чувствительные данные),
- собранный контекст (RAG: какие фрагменты использованы),
- ответ модели,
- время ответа, ошибки, повторные попытки,
- метрики прохождения валидации (например, JSON parsed ok).
Почему это критично для тестов в проде
Если после деплоя качество упало — вы хотите воспроизвести ситуацию. Иначе это будет «интуитивный» разбор. Хорошая наблюдаемость позволяет:
- построить постмортем по конкретной версии промпта,
- сравнить распределения ошибок между версиями,
- выявить, что изменилось: промпт, контекст, модель, данные, окружение.
Red-teaming для реальных потоков
Помимо статических тестов полезно делать мониторинг «красных» кейсов в реальном трафике:
- запросы, провоцирующие на выдачу системных инструкций,
- попытки prompt injection,
- выходы за формат,
- повторяемые классы ошибок.
Эти случаи стоит добавлять обратно в тестовый набор как новые регрессии.
Структура “промпт + тесты + метрики” как инженерный модуль
Рекомендуемая архитектура
Один из практичных способов организовать процесс — выделить слой “LLM Evaluation”:
- Сборка промпта из шаблона и входных данных.
- Выполнение (вызов модели) с фиксированными параметрами.
- Проверка результата (валидация формата, применение ограничений).
- Семантическая оценка (по рубрике).
- Сбор метрик и отчётность по версиям.
Этот модуль может использоваться и локально (в CI), и в прод-репликации.
Минимальный пример на Python: прогон тестов и валидация JSON
Предположим, что модель должна возвращать JSON вида:
{
  "summary": "string",
  "action_items": ["string"],
  "confidence": 0.0
}
Тогда валидацию можно сделать через Pydantic:
from pydantic import BaseModel, Field, ValidationError
from typing import List
import json

class LLMResponse(BaseModel):
    summary: str
    action_items: List[str] = Field(default_factory=list)
    confidence: float

def validate_response(text: str) -> tuple[bool, str]:
    try:
        data = json.loads(text)
        LLMResponse.model_validate(data)
        return True, "ok"
    except (json.JSONDecodeError, ValidationError) as e:
        return False, str(e)
Дальше — прогон набора кейсов. Пусть generate(prompt, ...) — ваша обёртка над LLM:
from dataclasses import dataclass
from typing import Callable, Any

@dataclass
class TestCase:
    id: str
    input_text: str
    expected_format: str = "json"

def run_suite(
    test_cases: list[TestCase],
    prompt_version: str,
    generate_fn: Callable[[str], str]
) -> dict[str, Any]:
    results = []
    format_pass = 0

    for tc in test_cases:
        prompt = f"""System: You output strict JSON only.
Task: Summarize and return action items.
Input: {tc.input_text}

Respond in JSON only."""
        output = generate_fn(prompt)

        ok, reason = validate_response(output)
        format_pass += int(ok)

        results.append({
            "id": tc.id,
            "ok": ok,
            "reason": reason,
            "output": output
        })

    total = len(test_cases)
    return {
        "prompt_version": prompt_version,
        "total": total,
        "format_pass_rate": format_pass / total if total else 0.0,
        "results": results
    }
Это минималистично, но уже даёт важное: вы можете прогнать одинаковый набор кейсов для двух версий промпта и увидеть, как изменилась доля валидных ответов.
Семантические метрики: когда JSON валиден, но ответ неверен
Формат — только часть качества. Для семантики понадобятся дополнительные проверки. Часто применяют один из подходов:
- Сверка с ground truth (если есть ответы-эталоны).
- LLM-оценщик: другой моделью/режимом оцениваем соответствие рубрике.
- Правила: эвристики на ключевые признаки (например, обязательно упомянуть конкретные элементы из входа).
- Retrieval-based факт-чек: если используете RAG, проверяйте, что утверждения согласуются с извлечёнными источниками.
LLM-оценщики удобны, но требуют дисциплины: нужно фиксировать промпт оценщика, критерии и формат ответа оценщика, иначе вы получите «сравнение двух блуждающих систем».
Типичный путь эволюции: как снизить хаос в внедрении
Этап 0: “работает на глаз” — но не проходит в прод
Самый распространённый старт: промпт меняют по ощущению. Обычно проблемы проявляются так:
- один фикс “чинит” 5 кейсов и ломает 2 других,
- при изменении входных форматов модель начинает отвечать по-разному,
- команда спорит: «вроде стало лучше» — без чисел.
Этап 1: “минимальные тесты” — появляется дисциплина
Переход к хотя бы базовым проверкам:
- валидность формата,
- корректность отказов,
- наличие обязательных полей,
- отсутствие грубых нарушений (например, отсутствие запрещённых слов/фраз).
Даже это уже резко снижает хаос: вы отделяете случайные улучшения от системных.
Этап 2: “рубрика + метрики + отчёт по версиям”
Дальше добавляется рубрика и метрики, привязанные к бизнес-ценности:
- точность по классам задач,
- снижение violation rate,
- устойчивость на сложных кейсах.
На этом этапе вы можете сделать процесс похожим на CI/CD: промпт версии “прилетает” в тесты, получает отчёт и только затем идёт в релиз.
Этап 3: “observability + feedback loop”
Наконец, замыкаете цикл:
- мониторите деградации,
- выявляете новые классы ошибок,
- добавляете кейсы в тестовый набор,
- уточняете рубрику.
Эта петля — то, что превращает эксперименты в управляемый рост качества.
Подводные камни: где команды чаще всего ломаются
1) Тесты слишком “маленькие” или не отражают реальность
Если тестовый набор состоит из идеальных примеров из документации — вы почти гарантированно получите сюрпризы в проде. Увеличивайте долю:
- неполных данных,
- нестандартных запросов,
- шумных формулировок.
2) Непостоянный контекст (особенно в RAG)
Если качество зависит от того, какие фрагменты ретривера попали в контекст, то изменения в ретривере (или индексации) будут выглядеть как «проблема промпта». Разделяйте причины:
- логируйте какие документы использовались,
- фиксируйте поведение ретривера в тестовой среде,
- сравнивайте “промпт-эффект” отдельно от “контекст-эффекта” (по возможности).
3) Оценка “по ощущениям” вместо рубрики
Когда нет рубрики, оценка превращается в субъективность. На практике нужен формальный документ критериев и способ автоматической валидации хотя бы части пунктов.
4) Игнорирование дисперсии и рандомности
Если вы сравниваете версии по одному прогону — результаты могут быть шумом. Используйте несколько прогонов или статистическую стабильность (хотя бы на ключевых кейсах).
5) Замещение тестов “обучением промпта” без проверки
Иногда команды начинают “подгонять” промпт или примеры под тесты, не расширяя набор. Это приводит к переобучению промпта на вашу выборку. Выявление таких проблем — вопрос расширения тестов и контроля регрессий.
Практический шаблон документации процесса (что завести в репозиторий)
Чтобы команда действительно работала по процессу, полезно держать рядом:
prompts/— шаблоны промптов,prompt_versions.json— манифест версий, параметры генерации,evaluation/— тестовые кейсы и их категории,rubrics/— критерии качества,reports/— артефакты результатов прогона.
Даже если пока всё “ручное”, дисциплина структуры делает улучшения воспроизводимыми.
Итог: от экспериментов к инженерии качества в LLM
Интеграции с ИИ для работы ломаются не из‑за «плохих моделей», а из‑за отсутствия инженерного контура качества. Когда промпты рассматриваются как разовый текст, а результаты — как впечатления, команда остаётся в режиме бесконечных правок и споров.
Чтобы снизить хаос и превратить эксперименты в системные улучшения, придерживайтесь трёх принципов:
- Промпт — артефакт с версией и контрактом поведения.
- Качество описывается рубрикой и измеряется метриками, связанными с результатом.
- Любое изменение проходит через тестовый набор и наблюдаемость в проде, формируя feedback loop.
Если хочется глубже разобраться в практиках интеграции LLM в продуктовую разработку (включая подходы к оценке и управлению качеством), можно начать с материалов по теме, например