Качество данных в пайплайнах: валидация на входе и «контракты» в обработчиках
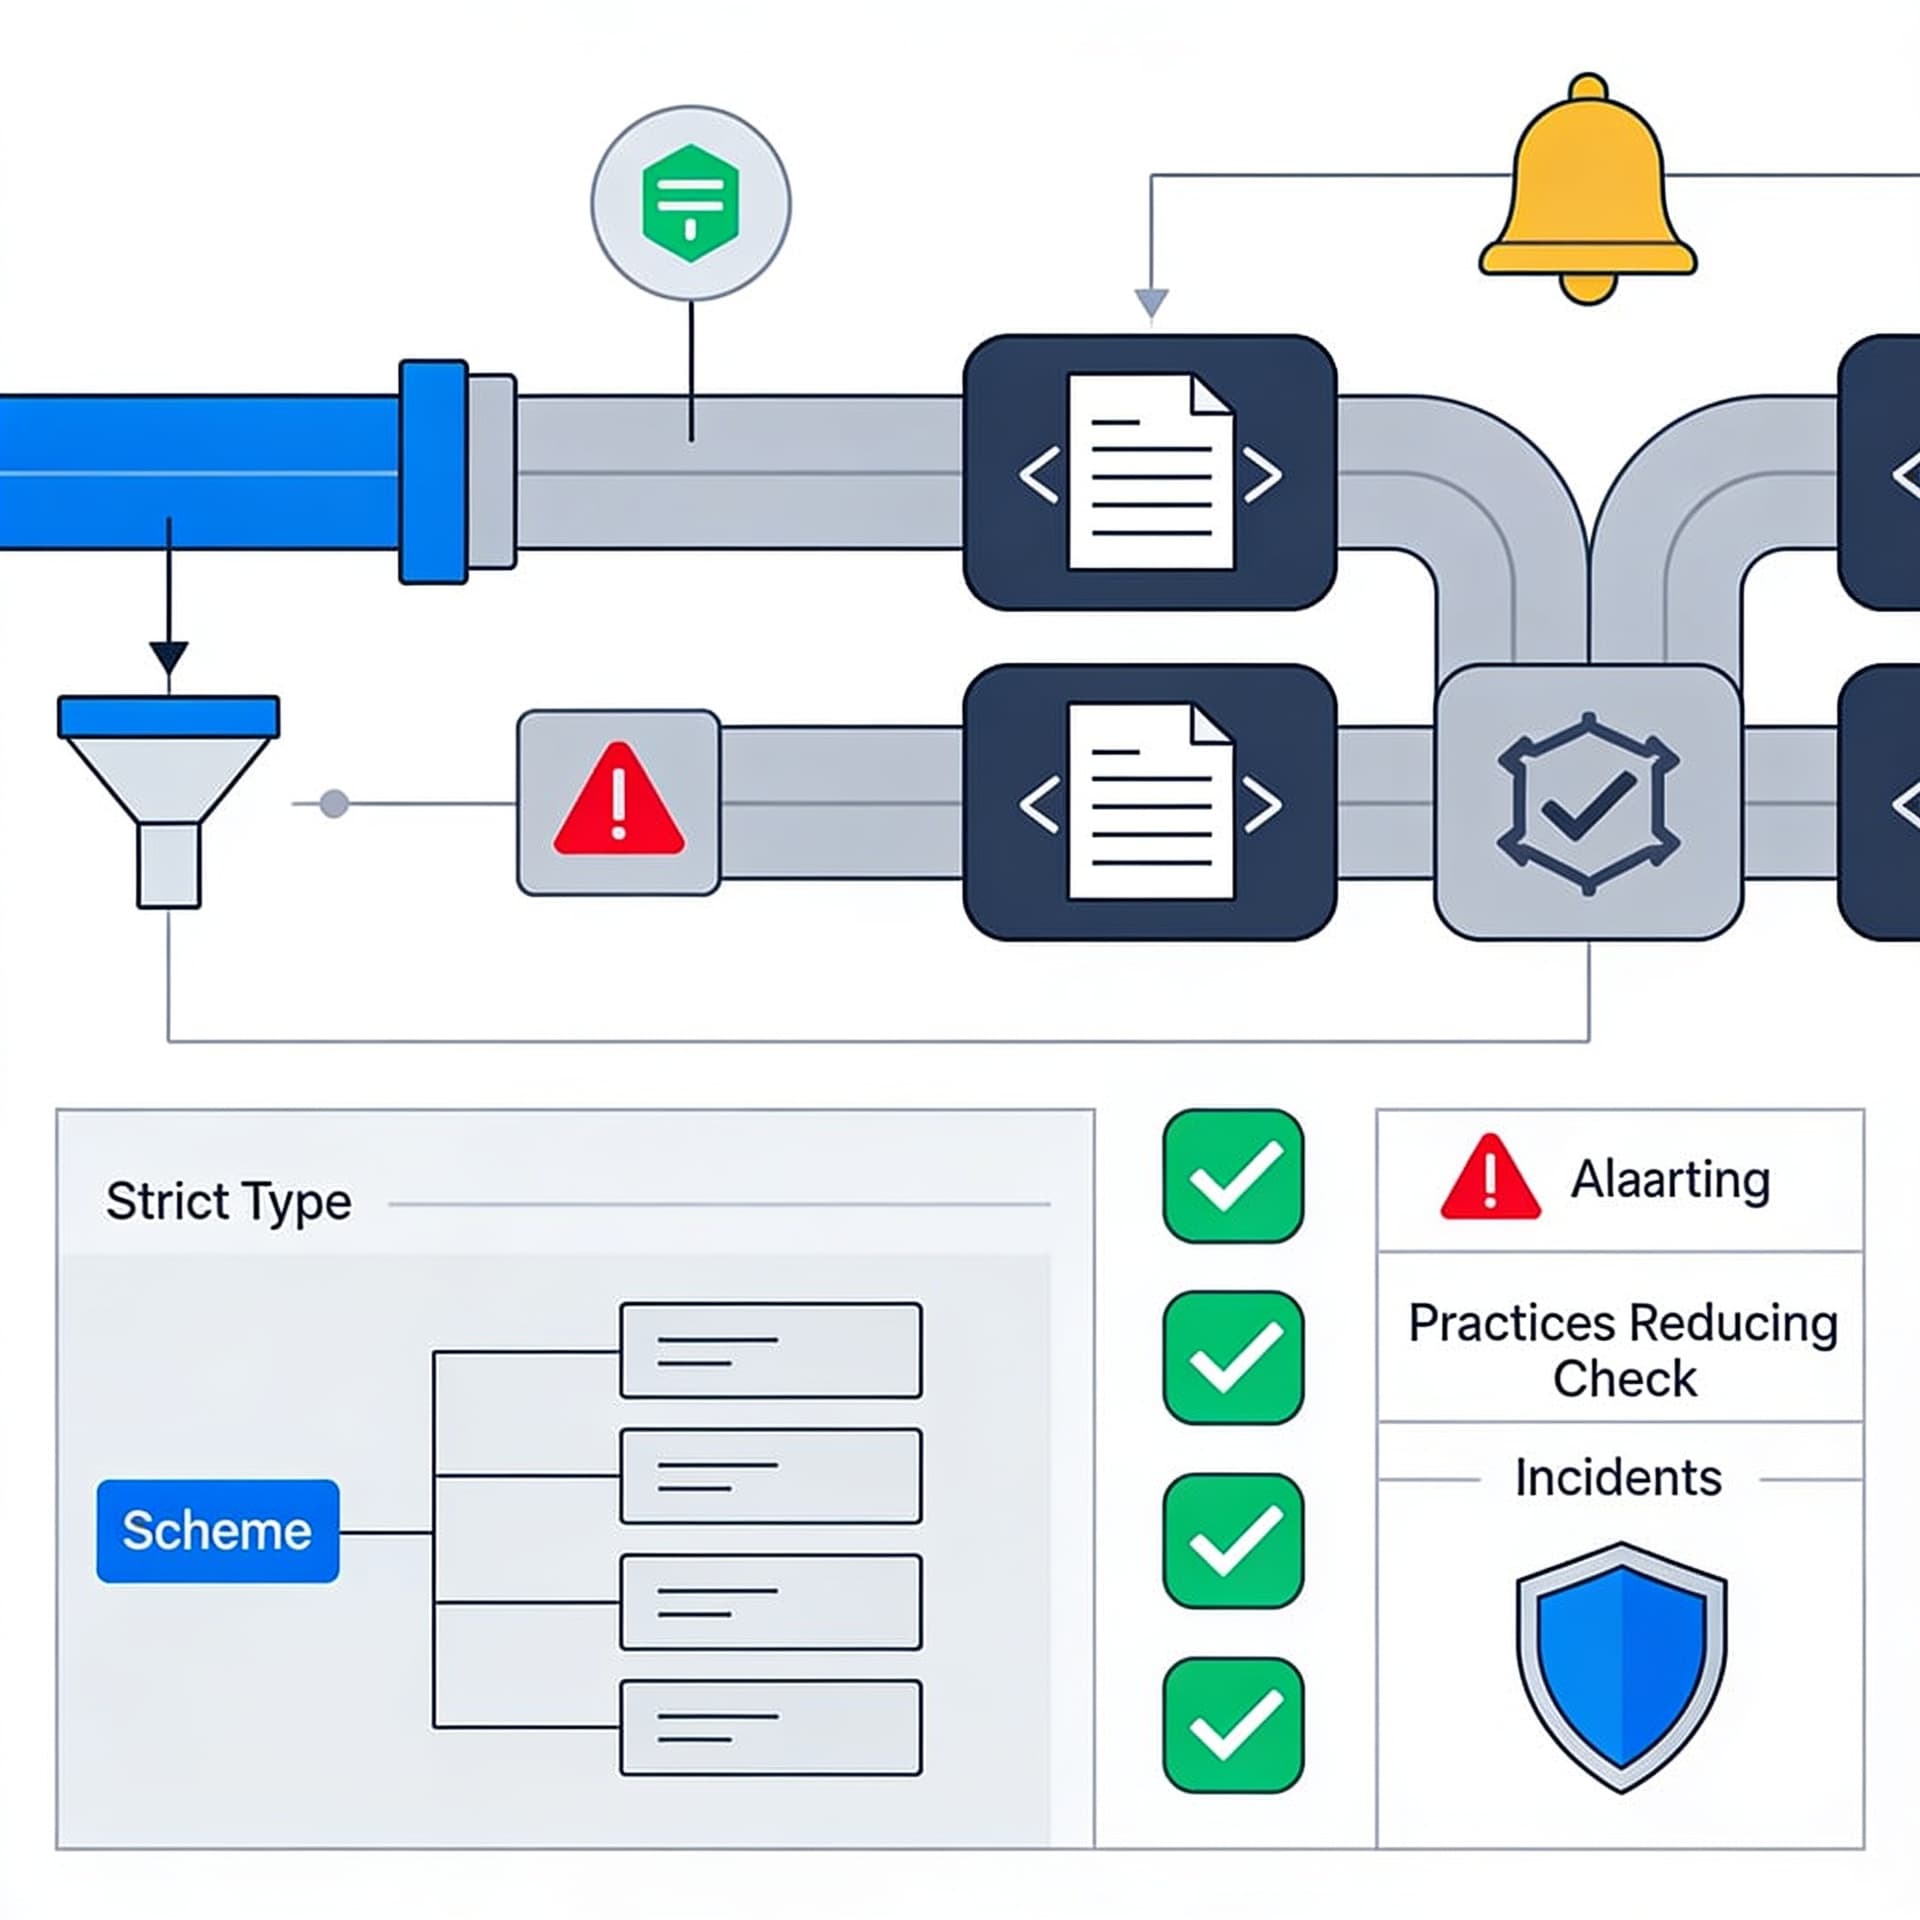
Научимся выявлять плохие данные раньше: схемы, строгие типы, проверки инвариантов и алертинг. Покажем практики, которые снижают число инцидентов в проде.
Содержание
Плохие данные в дата-пайплайнах — это не редкая неприятность, а системная проблема. Она проявляется одинаково: инцидент в проде, «плавающие» метрики, внезапные нули в витринах, лаги из‑за неожиданных форматов и, что хуже всего, случаи, когда сбой не ломает пайплайн полностью, а незаметно портит смысл данных. В итоге команда тратит часы на расследование, хотя первопричина могла быть простой: данные пришли не в том виде, в котором их ожидали.
Хорошая новость: качество данных в значительной степени управляемо. Практики, которые дают эффект, обычно сводятся к двум уровням:
- Валидация на входе — раннее обнаружение несовместимых/повреждённых данных до того, как они попадут в бизнес-логику.
- Контракты в обработчиках — формализация ожиданий внутри кода: что считается допустимым состоянием, какие инварианты должны выполняться, что делать при нарушениях.
В этой статье разберём подходы к валидации и «контрактам», обсудим схемы и строгие типы, проверки инвариантов, алертинг и типичные ошибки. Плюс покажем несколько практичных примеров кода.
Почему «валидация в конце» не работает
Самая частая ошибка — пытаться «чинить» данные ближе к выходу пайплайна: на витрине, в отчёте или в потребляющем сервисе. Это по нескольким причинам:
- Поздняя точка обнаружения: если данные некорректны, вы теряете возможность локализовать, где именно произошло нарушение.
- Непредсказуемые побочные эффекты: многие трансформации необратимы; ошибка может проявиться только через шаг или даже через несколько часов.
- Проблема с причинностью: даже если вы поставили алерт на «странное значение», вам придётся гадать, из какого источника пришёл неверный формат и какие преобразования его усугубили.
Вместо этого целесообразно выстроить контур контроля:
- На входе — проверяем структуру и типизацию данных.
- В обработчиках — подтверждаем инварианты (логические правила) и предусловия/постусловия.
- На выходе — мониторим дистрибуции и согласованность (а не только «валидность по схеме»).
Уровень 1: валидация на входе
Схемы: JSON Schema, Avro, Protobuf
В большинстве современных пайплайнов данные приходят в формате JSON, Avro или Protobuf. Схема — это формальный контракт о структуре:
- какие поля обязательны,
- их типы,
- допустимые значения (например,
enum), - ограничения формата (
pattern, минимумы/максимумы), - вложенность и массивы.
Ключевой момент: схема должна жить не только в голове разработчика, а в исполняемой форме, чтобы валидация выполнялась автоматически.
JSON Schema хорош тем, что легко интегрируется с веб/ETL. Пример на Node.js:
import Ajv from "ajv";

const ajv = new Ajv({ allErrors: true, strict: true });

const userSchema = {
  type: "object",
  additionalProperties: false,
  required: ["userId", "email", "age", "country"],
  properties: {
    userId: { type: "string", minLength: 1 },
    email: { type: "string", format: "email" },
    age: { type: "integer", minimum: 0, maximum: 130 },
    country: { type: "string", minLength: 2, maxLength: 2 }
  }
};

const validate = ajv.compile(userSchema);

export function validateUser(payload) {
  const ok = validate(payload);
  if (!ok) {
    // Возвращаем структурированный список ошибок — это важно для алертинга и расследований
    return { ok: false, errors: validate.errors };
  }
  return { ok: true };
}
Что важно:
additionalProperties: false— запрещаем лишние поля, чтобы ловить неожиданные изменения формата.strict: trueиallErrors: true— помогаем быстрее заметить несовместимости.
Для Avro/Protobuf аналогично: схема генерирует код валидации/парсинга либо обеспечивает контракт на уровне десериализации.
Строгие типы и «типизация границ»
Схема — это проверка данных. Но есть следующий слой: строгая типизация в коде. Идея проста: если вы десериализуете payload в тип, то большая часть ошибок будет отловлена компилятором/рантаймом.
Типичные подходы:
- В TypeScript — использовать типы + runtime validation (схема/валидатор), чтобы не полагаться только на
interface. - В Python — использовать Pydantic, dataclasses + validation или typeguard-подход.
- В Java/Go — использовать строгие модели и валидировать при маппинге.
Пример на Python с Pydantic:
from typing import Literal
from pydantic import BaseModel, EmailStr, Field, ValidationError

class User(BaseModel):
    userId: str = Field(min_length=1)
    email: EmailStr
    age: int = Field(ge=0, le=130)
    country: str = Field(min_length=2, max_length=2)

    # Пример инварианта на уровне модели (частный случай)
    # Можно и отдельные @model_validator, но базовых ограничений часто достаточно.

def parse_user(payload: dict) -> User:
    # Pydantic выполнит валидацию структуры и типов
    return User.model_validate(payload)
Почему это важно для пайплайнов: вы превращаете «сырые данные» в «валидированную модель» на границе системы и дальше работаете только с корректным типом.
Валидация в точке входа пайплайна
Самая практичная схема:
- Получили событие/запись.
- Десериализовали в тип.
- Прогнали схему/валидатор.
- Если ошибка — отправили запись в dead-letter queue (DLQ) или в отдельное хранилище ошибок.
- Зафиксировали метаданные: source, версия схемы, хэши payload, таймстамп, идентификаторы корреляции.
Ключевое преимущество: вы сохраняете «контекст» для расследования и не ломаете поток из-за одной плохой записи (но и не теряете её бесследно).
Уровень 2: «контракты» в обработчиках
Валидация на входе защищает от несовместимой структуры и типовых ошибок. Но большинство «смысловых» инцидентов — это нарушение инвариантов и бизнес-правил, которые схема не всегда выражает (или выражает неудобно).
Инварианты: что это и как их формализовать
Инвариант — это утверждение, которое должно быть истинным в некоторой точке обработки. Например:
start_time <= end_timeamount >= 0currencyсоответствует регионуdiscount <= pricesum(line_items) == total_amount(в пределах округления)statusиз набора и согласован сrefund_amount
Если инвариант нарушен — это не «валидная запись с странностью», а признак, что дальше вычисления становятся бессмысленными.
Контракт как часть кода: preconditions / postconditions
Один из надёжных паттернов — выделить проверяемые ожидания:
- preconditions: что должно быть истинно до выполнения трансформации.
- postconditions: что должно быть истинно после выполнения.
В языках с контрактными библиотеками можно оформлять явно. В остальных случаях — используйте единый стиль проверок и единый формат ошибки.
Пример (условный Python):
from dataclasses import dataclass
from datetime import datetime
from decimal import Decimal

@dataclass(frozen=True)
class OrderEvent:
    order_id: str
    start_time: datetime
    end_time: datetime
    total_amount: Decimal
    currency: str

def transform_to_fact(event: OrderEvent) -> dict:
    # Preconditions
    assert event.start_time <= event.end_time, "Invariant violated: start_time > end_time"
    assert event.total_amount >= 0, "Invariant violated: total_amount < 0"

    # Преобразование
    duration_seconds = (event.end_time - event.start_time).total_seconds()

    # Postconditions
    fact = {
        "order_id": event.order_id,
        "duration_seconds": duration_seconds,
        "amount": str(event.total_amount),
        "currency": event.currency
    }
    assert fact["duration_seconds"] >= 0
    return fact
assert хорош как учебный пример, но в проде лучше делать контролируемые исключения с контекстом (и записью в DLQ), а не «голые assert», которые могут быть выключены в некоторых режимах. Ниже пример более «боевого» стиля.
Контрактные ошибки с контекстом
Инциденты расследуются по логам и артефактам, поэтому ошибка должна быть:
- типизированной (чётко отличать схему-ошибку от бизнес-инварианта),
- с корреляцией (request_id / trace_id / event_id),
- с «снимком» ключевых полей (не весь payload, а минимально нужное).
Пример на JavaScript:
export class DataContractError extends Error {
  constructor(message, { eventId, field, got, expected } = {}) {
    super(message);
    this.name = "DataContractError";
    this.eventId = eventId;
    this.field = field;
    this.got = got;
    this.expected = expected;
  }
}

export function validateInvariants(event) {
  if (event.start_time > event.end_time) {
    throw new DataContractError(
      "start_time must be <= end_time",
      { eventId: event.event_id, field: "start_time/end_time" , got: [event.start_time, event.end_time], expected: "<= " }
    );
  }

  if (event.total_amount < 0) {
    throw new DataContractError(
      "total_amount must be >= 0",
      { eventId: event.event_id, field: "total_amount", got: event.total_amount, expected: ">= 0" }
    );
  }
}
Дальше этот тип ошибки можно перехватывать и направлять в DLQ с разметкой причины.
Почему одних проверок схемы недостаточно
Схема контролирует форму. Но данные могут быть «формально валидными», и при этом разрушать аналитику:
-
Семантические ошибки
Например, полеstatus="PAID"приходит приrefund_amount > 0. Схема это не всегда поймает. -
Локальные инварианты
discount <= priceилиsum(items) ~= total— часто требуют вычислений и правил округления. -
Согласованность между полями/измерениями
Например,currency="USD"не соответствует региону пользователя, полученному из другой витрины (это уже кросс-сущностная валидация). -
Стабильность форматов при эволюции схем
Версии схем меняются, и поле может стать optional/другого типа. Если вы не ловите изменения по версии и не обновляете контракты, инциденты будут «ползти».
Поэтому в обработчиках важны инварианты и контрактные проверки — но не бесконечные. Их надо проектировать как часть дизайна пайплайна.
Дизайн валидаций: где ставить границы и как не утонуть
Разделяйте категории проверок
Хорошая практика — разнести проверки на классы:
- Hard validation (неприменимо): запись нельзя обработать (не распарсить, нет ключевых полей, нарушены критические инварианты). → DLQ или отказ обработчика.
- Soft validation (неприятно, но допустимо): есть отклонения, которые можно обработать с дефолтами/округлением, но нужно отметить. → отдельные флаги, метрики качества.
- Monitoring validation (только мониторинг): проверяем, что статистика не «уплыла», но запись можно пропустить без остановки. → алерты/дашборды.
Это снижает риск сценариев, когда вы «включили паранойю» и остановили поток данных из-за несущественного отклонения.
Не делайте всё синхронно и в одном месте
Контроль качества стоит «раскидать»:
- На входе — дешёвые проверки структуры/типа (схема).
- В обработчиках — инварианты на малом наборе критичных полей.
- Периодически — расширенные проверки на выборках или в batch-аудите.
Например, проверка sum(items) == total может быть дорогой для каждого события. Можно:
- делать её для транзакций критичных типов,
- или ограничить по частоте,
- или ввести батч-аудит с задержкой, но с высокой полнотой покрытия.
Алёртинг: как не ловить тишину и ложные тревоги
Контроль данных без мониторинга — это «валидация ради логов». Чтобы качество действительно росло, нужно измерять:
- Сколько записей не проходит валидацию схемы
Метрика:invalid_schema_count+ разбивка по причинам. - Сколько записей нарушают инварианты
Метрика:contract_error_count+ field/invariant. - Доля «мягких» аномалий
Метрика:soft_validation_rate. - Сдвиги распределений
Например, доля пустых значений, медиана/квантили чисел, частоты категорий, распределение дат.
Пример алертинга по структуре: если доля invalid растёт, это сигнал для входной системы/интеграции. При этом важно не алертить на единичные ошибки.
Практический шаблон:
- Для каждой причины (например,
email_format,missing_field_x) держать:- абсолютный счётчик,
- долю от общего объёма,
- EMA/скользящее среднее.
- Алертить при нарушении одновременно порогов доли и объёма (иначе можно получить много шумных сигналов).
Ведение ошибок как часть продукта, а не побочный эффект
Если записи не проходят проверки, их нужно не просто «отбрасывать», а обращаться с ними как с данными:
- DLQ с возможностью ретраев после исправления источника.
- Витрина причин: какие ошибки доминируют.
- Связь ошибок с версией схемы/деплоем обработчика.
- Ретроспективный аудит после инцидентов: не только «кто виноват», но и что изменилось в контрактах и предположениях.
Реальность такая: большинство проблем повторяемы. Если вы фиксируете причины и тренды, команда перестаёт тушить пожары и начинает чинить первопричины.
Типичные подводные камни
1) Считать, что «валидатор схемы» = «данные корректны»
Схема не понимает бизнес-смысл. Контракты в обработчиках нужны почти всегда.
2) Игнорировать эволюцию схем
Если источник обновил поле (например, поменял формат даты) — схема должна отражать версию и иметь стратегию совместимости. Иначе вы получите лавину ошибок или, что хуже, тихие несоответствия.
3) Слишком мягкие дефолты без маркировки
Некоторые команды «лечат» проблему дефолтом: если age отсутствует, ставим 0. В итоге:
- вы портите аналитику,
- теряете сигнал о качестве,
- будущие инциденты сложнее локализовать. Лучше: дефолт возможен только в рамках soft validation, и результат должен нести метку качества.
4) Отсутствие корреляции в ошибках
Без event_id/trace_id расследование превращается в угадывание. Контекст — это часть контракта ошибки.
5) Смешивание ответственности
Проверки качества расползаются по разным слоям: часть в ETL, часть в бизнес-сервисе, часть в витрине. Это усложняет трассировку. Лучше придерживаться «контроль на входе + контракт в обработчиках».
Практический каркас: как это выглядит в реальном пайплайне
Ниже — обобщённый пайплайн для потока событий (можно адаптировать под batch):
- Consumer / ingestion
- десериализация;
- схема + base parsing.
- Contract validation
- инварианты;
- проверка согласованности полей;
- контроль ограничений на значения.
- Transformation
- расчёты, обогащения, маппинг в доменную модель.
- Emit
- запись в downstream с метками качества (например
quality_flags).
- запись в downstream с метками качества (например
- Observability
- метрики invalid/contract_error;
- алерты на рост доли ошибок;
- дамп примеров payload для расследования (с учётом PII).
Небольшой пример: валидация схемы + инварианты + DLQ
import Ajv from "ajv";

const ajv = new Ajv({ allErrors: true, strict: true });

const eventSchema = {
  type: "object",
  additionalProperties: false,
  required: ["event_id", "start_time", "