Дебаг сложных ошибок: как построить воспроизводимый минимальный пример
Научимся сжимать баг до минимума, правильно логировать, отключать лишние факторы и формулировать гипотезы. Покажем пошаговый алгоритм от симптома до причины и исправления.
Содержание
Сложные баги почти никогда не выглядят как «сломалась одна функция». Чаще это цепочка эффектов: непредсказуемый порядок событий, зависимость от окружения, неожиданные входные данные, конкурентность, гонки, тайминги, неверные допущения о внешних сервисах. На практике это превращается в «оно работает у меня» и бесконечный цикл: меняем логирование — стало хуже; добавляем проверки — скрыли первопричину; воспроизводим только на проде — и только иногда.
Единственный способ выбраться из этого — научиться строить воспроизводимый минимальный пример (Minimal Reproducible Example, MRE). Это не «минимальный код в вакууме», а управляемая редукция до набора факторов, который стабильно воспроизводит проблему на твоей машине или в тестовой среде. Такой подход дисциплинирует расследование: ты сокращаешь пространство неопределённости и превращаешь дебаг в эксперимент.
Ниже — пошаговый алгоритм от симптома к причине и исправлению: как сжимать баг до MRE, как логировать так, чтобы не утонуть, как отключать лишние факторы, как формулировать гипотезы и проверять их. Параллельно разберём типичные ошибки, которые мешают добраться до первопричины.
1) Начало расследования: фиксируем симптом, а не «ошибку в голове»
1.1. Сформулируй симптом измеримо
Первый подводный камень — описать баг слишком общо: «иногда падает», «иногда не работает», «данные неверные». Это невозможно расследовать без уточнений.
Собери минимально необходимый набор характеристик:
- Где проявляется: модуль/эндпоинт/воркер/класс, окружение.
- Как проявляется: исключение, зависание, неверный результат, деградация производительности.
- При каких условиях: какой вход, какой сценарий пользователя/триггер в системе.
- Частота: 1 из N, только после X минут, только при нагрузке, только на определённых клиентах.
- Контекст: версии, конфигурация, режимы, внешние зависимости.
Если есть логи — используй их как источник правды. Но важнее другое: зафиксировать “наблюдаемое”. Гипотезы появятся позже; сначала мы обязаны определить, что именно воспроизводим.
1.2. Введи “контракт воспроизведения”
MRE — это не только код. Это набор условий: версия данных, конфигурация, параметры среды, последовательность событий. Поэтому сразу определись:
- Воспроизводим ли мы детерминированно (на 100%) или вероятностно?
- Если вероятностно — что можно стабилизировать: тайминги, количество потоков, размер очереди, seed генератора, конкретные входные данные.
- Что является границей: один процесс, один запрос, один job в очереди, один тестовый прогон.
1.3. Сохрани “сырой материал”
До любых правок забери то, что потом будет трудно восстановить:
- пример запроса/сообщения (payload), заголовки, идентификаторы корреляции;
- stack trace, таймстемпы, версию приложения и зависимостей;
- конфигурацию окружения (feature flags, переменные окружения);
- при необходимости — снапшот состояния данных или хотя бы выборку записей, участвующих в баге.
Идея простая: MRE строится из фактов, а факты лучше брать сразу.
2) Правильное логирование: чтобы видеть причинность, а не шум
2.1. Добавляй логи только там, где меняется причинная цепочка
Логи ради логов почти всегда ухудшают расследование. Твоё логирование должно помогать ответить на конкретные вопросы:
- В каком порядке происходят события?
- Какие значения ключевых переменных участвуют?
- Когда переходишь между стадиями (start/finish)?
- Какой путь выполнения выбран (ветвления)?
- Есть ли расхождение между ожидаемым и фактическим?
Практический принцип: логировать на границах (вход/выход функций, обработка сообщений, переходы состояний) и в точках предположений (там, где, по твоей текущей гипотезе, что-то не так).
2.2. Логи должны быть коррелируемыми
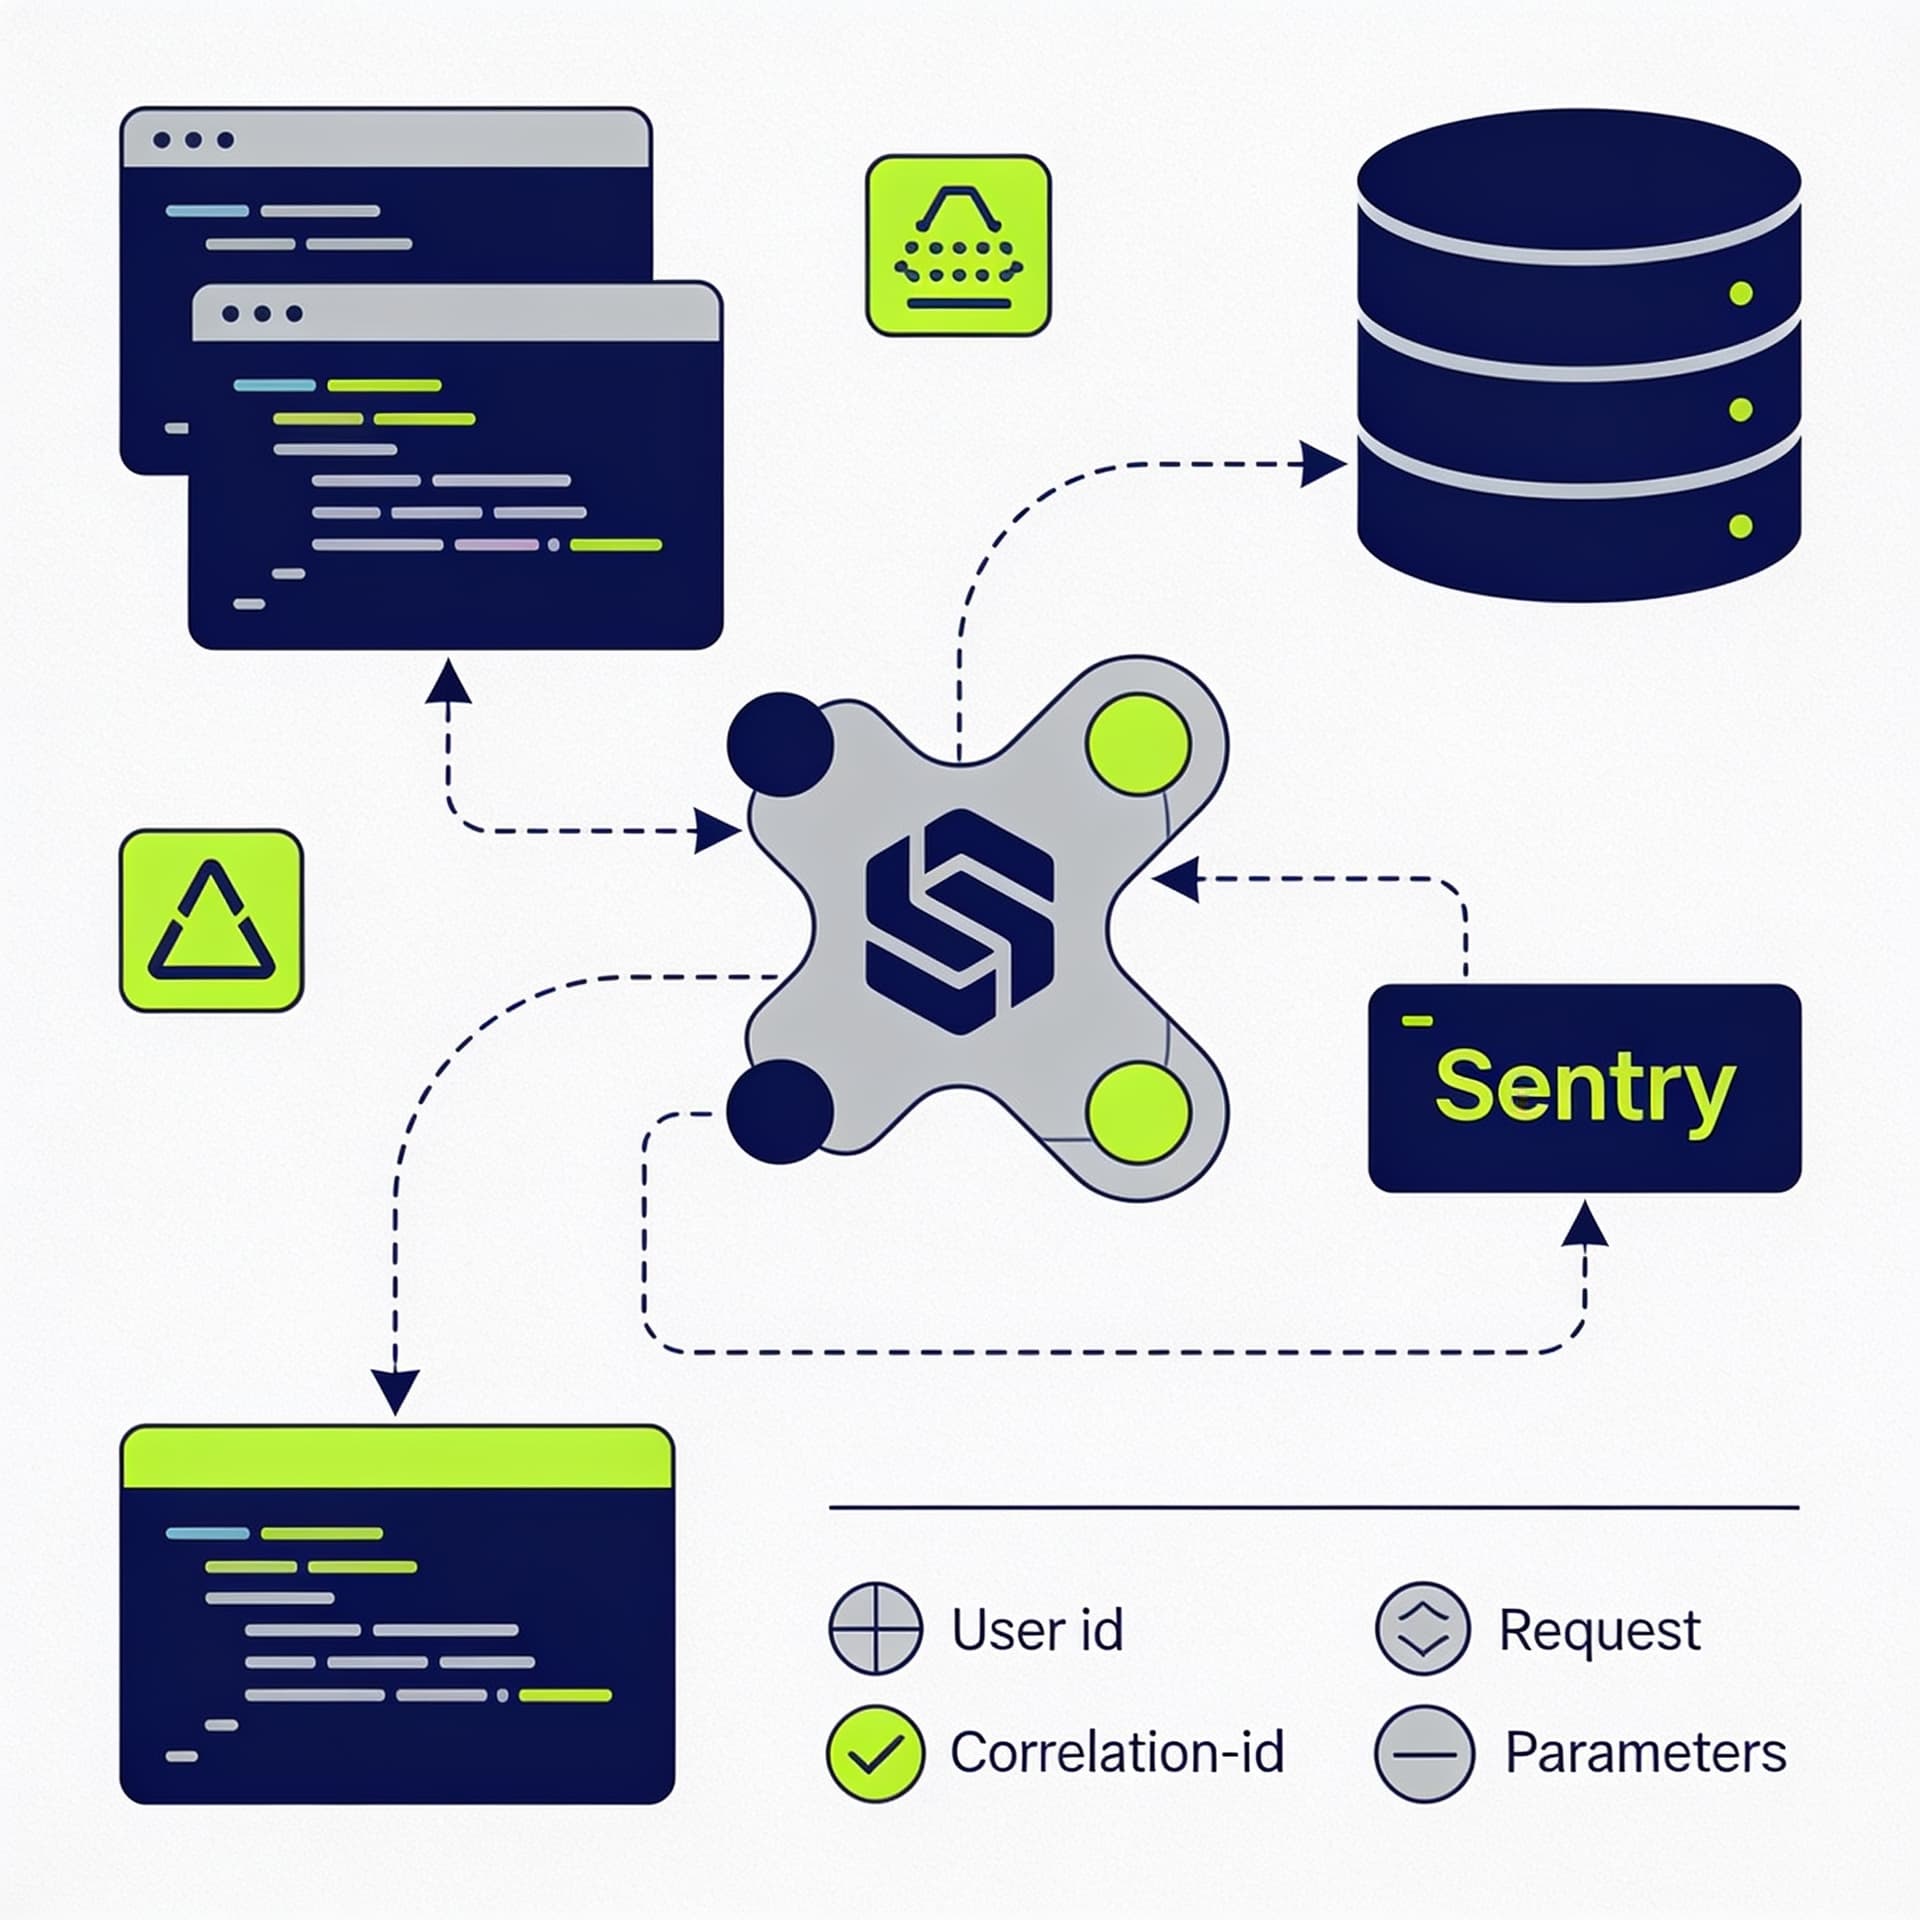
Если система распределённая или многопоточная, без корреляции ты быстро потеряешь нить. Введите:
trace_id/request_id/job_id— общий идентификатор;user_idили другой бизнес-ID, если это возможно;- номер попытки, номер страницы/партии, индекс элемента в цикле.
Один и тот же trace_id должен “вести” через весь путь выполнения.
2.3. Логи должны быть “структурными”
Текстовые строки сложно агрегировать и сравнивать. Если можешь — используй JSON/структурные логи. Пример на псевдо-Python (или под твою технологию аналогично):
import logging
logger = logging.getLogger("app")

def process_item(item, trace_id: str):
    logger.info("process_item.start", extra={
        "trace_id": trace_id,
        "item_id": item["id"],
        "item_type": item.get("type"),
    })

    result = do_work(item)

    logger.info("process_item.finish", extra={
        "trace_id": trace_id,
        "item_id": item["id"],
        "status": result["status"],
    })
    return result
Затем ты сможешь быстро сравнить “правильный” и “падучий” прогон, не читая горы текста вручную.
2.4. Добавляй “метки времени” только там, где это помогает
Для гонок, таймингов и очередей важны длительности. Но чрезмерное логирование замедляет систему и может изменить поведение (эффект наблюдателя). Поэтому:
- измеряй длительность ключевых шагов;
- не логируй на каждой микро-операции;
- если проблема “чувствительна к времени”, попробуй воспроизвести на локально стабилизированном стенде, где ты контролируешь задержки.
3) Минимизация: как построить воспроизводимый минимальный пример
MRE строится итеративно: ты сокращаешь, сохраняя воспроизводимость. Это похоже на бинарный поиск по пространству факторов.
3.1. Определи “что можно выкинуть”
Обычно в баге участвуют множество переменных:
- формат и размер входных данных;
- конкретные значения полей;
- ветвления и опциональные шаги;
- фоновые задачи, ретраи, очереди;
- окружение и конфигурация (feature flags, лимиты, версии зависимостей);
- зависимости (БД, кеш, внешние сервисы);
- порядок сообщений/элементов;
- конкуренция (количество потоков, параллелизм).
Твоя цель — понять: какие из них действительно влияют на наблюдаемую проблему.
3.2. Раздели проблему на “уровни”
Полезно разложить систему на уровни и минимизировать по одному уровню:
- Уровень входа: какие данные и как именно они поступают?
- Уровень бизнес-логики: какая ветка/последовательность операций приводит к багу?
- Уровень инфраструктуры: БД/кеш/очереди/сервисы — что может быть причиной?
- Уровень исполнения: параллелизм/порядок/тайминги.
Минимизация на одном уровне часто упрощает дальнейшую работу, даже если полностью не снимает баг.
3.3. Итерационный процесс: «удаляй — проверяй — закрепляй»
Типовой алгоритм:
- Запиши текущий способ воспроизведения.
- Убери половину факторов (или шагов) — например, отключи часть обработки, сократи payload, отключи один внешний вызов.
- Проверь: воспроизводится ли баг?
- Если воспроизводится — оставь это ядро и снова сократи.
- Если перестало — значит, “удалённый фактор” был существенным; возвращай его и сокращай другое.
Так ты получаешь минимальный набор условий, при котором баг воспроизводится.
3.4. Стабилизируй “недетерминизм”
Частая причина невозможности MRE — проблема зависит от случайности или порядка.
Примеры:
- гонка потока: результат зависит от скорости;
- использование случайного
UUID/seed; - сортировки с нестабильным компаратором;
- чтение из очереди без гарантии порядка;
- “иногда” потому что внешний сервис иногда отвечает медленнее.
Что можно сделать:
- зафиксировать seed генераторов;
- заменить источники случайности детерминированными значениями;
- заморозить порядок: отсортировать вход или сделать детерминированную очередь;
- снизить конкуренцию до управляемого уровня (например, 1 worker), чтобы найти логическую причину;
- внедрить контролируемые задержки (sleep) или использовать “фейки” внешних сервисов.
3.5. Пример: сокращение падения до MRE через “функциональную редукцию”
Допустим, у тебя есть функция, которая иногда кидает исключение при обработке списка событий:
def handle_events(events):
    # ...
    for ev in events:
        if ev["type"] == "refund":
            process_refund(ev)
    return True
Баг “иногда” может быть из-за некорректного поля в одном из событий, но может и из-за порядка. Дальше ты строишь MRE:
- Берёшь минимальную подвыборку
events: обычно достаточно одного “подозрительного” элемента. - Проверяешь, кидает ли исключение только при одном
refund. - Если не кидает — добавляешь ещё один элемент и так далее.
- Если исключение связано с порядком — пробуешь переставлять элементы в MRE до нахождения минимальной перестановки.
Ключевой момент: MRE должен быть самодостаточным: функция + минимальный набор данных + конкретная последовательность вызовов/операций.
4) Отключаем лишние факторы: “изоляция” вместо хаотичных правок
4.1. Убери внешние зависимости
Если проблема может зависеть от БД/кеша/сервиса, сделай так, чтобы в MRE осталась только твоя логика.
Варианты:
- использовать тестовый стенд (in-memory БД, локальный кеш);
- мокать внешние сервисы;
- записать и проигрывать “снимки” ответов (если это безопасно и корректно);
- заменить реальные HTTP-вызовы на фиксированные ответы.
Важно: мок должен быть достаточно реалистичным, чтобы сохранялась проблема. Но он должен быть стабильным — без “плавающих” таймаутов.
4.2. Отключи фон: очереди, ретраи, middleware
Иногда баг рождается не в бизнес-логике, а в оболочке:
- повторные попытки меняют состояние;
- middleware сериализует/десериализует данные иначе;
- очереди переупорядочивают сообщения;
- транзакции с разной изоляцией дают разный результат.
На этапе MRE лучше:
- запускать код напрямую (без очереди) или
- запускать тот же pipeline, но фиксировать параметры: число воркеров = 1, ретраи отключены, время ожидания нормализовано.
4.3. Feature flags и конфигурация
Разработчики часто забывают о конфигурации, хотя она — источник “невоспроизводимости”.
Сделай табличку:
- какие флаги включены в проблемном запуске,
- какие выключены,
- какие значения лимитов/таймаутов.
И в MRE держи конфигурацию минимально необходимой, чтобы проблема воспроизводилась.
5) Формулируем гипотезы: превращаем дебаг в эксперимент
5.1. Гипотеза должна быть проверяемой
Плохая гипотеза: «возможно, проблема в БД». Непроверяемо.
Хорошая гипотеза формулируется как утверждение вида:
- “Если причина — расхождение порядка элементов, то при фиксированной сортировке баг исчезнет.”
- “Если причина — некорректный формат поля X, то при замене этого поля на значение Y ошибка не повторится.”
- “Если причина — гонка при параллельных обработках, то при одном воркере баг пропадёт.”
Смысл: гипотеза должна определять, что именно мы меняем, и какой ожидаемый эффект увидим.
5.2. Раздели гипотезы по слоям
Чтобы не утонуть в догадках, держи список гипотез по категориям:
- вход/валидация;
- бизнес-логика;
- состояние (БД/кеш);
- конкуренция/порядок;
- окружение/версия зависимостей.
Каждая гипотеза должна ссылаться на конкретные факты (логи, наблюдения, данные из проблемного запуска) и иметь минимальный набор экспериментов.
5.3. Сравнение “плохого” и “хорошего”
Рабочая техника: найдя MRE, собери 2 набора:
- bad: параметры/данные, при которых баг происходит;
- good: почти такие же, но без бага.
“Почти” важно: иначе сравнение теряет смысл. Дальше ищи различия по ключевым полям/событиям. Иногда достаточно нескольких отличий — и первопричина находится быстро.
6) От причины к исправлению: как не чинить симптом
6.1. Исправление должно устранить первопричину, а не маскировку
Типичная ошибка — добавить try/catch и проглотить исключение. Иногда это “быстро чинит” симптом в проде, но создаёт:
- тихую потерю данных,
- неконсистентное состояние,
- новые ошибки в будущем.
Хорошее исправление:
- либо корректирует расчёт/логику,
- либо добавляет валидацию на входе,
- либо устраняет гонку (синхронизация/идемпотентность/транзакции),
- либо делает порядок/состояние детерминированным.
6.2. Добавь регрессионный тест на MRE
Самая практичная польза от MRE — ты можешь превратить его в тест. Даже если это не unit-тест в чистом виде, а интеграционный, всё равно важно:
- тест воспроизводит баг;
- после фикса тест проходит;
- при любом будущем изменении он гарантирует, что баг не вернётся.
Пример “ядра” unit-теста (условно):
def test_refund_invalid_currency_raises():
    events = [{"type": "refund", "currency": "???", "id": "1"}]
    with pytest.raises(ValueError):
        handle_events(events)
Если баг был “иногда”, тесту может потребоваться контролируемая стабилизация (seed, порядок, имитация задержек), но в любом случае MRE упрощает создание регресса.
6.3. Проверь исправление на краевых случаях
MRE показывает ядро. Но решение может иметь побочные эффекты. Проверь:
- соседние значения полей;
- разные размеры массивов;
- пустые/частичные данные;
- параллельное выполнение (если проблема была в конкуренции).
7) Типичные подводные камни (и как их обходить)
7.1. “У меня не воспроизводится” — но MRE всё равно нужен
Если ты строишь MRE “на угад”, ты почти гарантированно получишь неверный набор факторов. Поэтому:
- сначала фиксируй симптомы и условия,
- затем минимизируй по системным факторам (данные, порядок, конфигурация),
- затем добавляй стабилизацию недетерминизма.
7.2. Логи меняют поведение
Если проблема чувствительна ко времени или к нагрузке (например, race condition), добавление логов может устранить баг (изменить расписание потоков). Решения:
- использовать меньше логов и/или агрегацию;
- измерять точечно;
- при необходимости логировать в кольцевой буфер и выгружать только при падении.
7.3. Удаление “лишних факторов” уничтожает смысл
Иногда MRE без “инфраструктурного контекста” становится бессодержательным: например, баг был в транзакциях или сериализации данных на границе. Правильный подход: минимизируй по одному измерению, но не обнуляй критические механизмы, которые создают проблему.
7.4. “Тест проходит, но проблема не решена”
Бывают случаи, когда тест основан на неверном представлении о причинах. Поэтому исправление должно соответствовать гипотезе и устранять причинность, а не просто совпадать с одним кейсом.
8) Пошаговый алгоритм: от симптома до исправления (в виде чек-листа)
Ниже — практический план, который можно выполнять почти в любом языке и стеке.
Шаг 1. Зафиксируй симптом и условия
- что именно наблюдаем;
- где происходит;
- как часто;
- какие версии и конфигурации участвуют.
Шаг 2. Собери исходные данные “плохого” кейса
- payload/вход;
- stack trace;
- корреляционные идентификаторы;
- конфигурацию окружения.