Идемпотентность в бэкенде: как строить безопасные повторные запросы
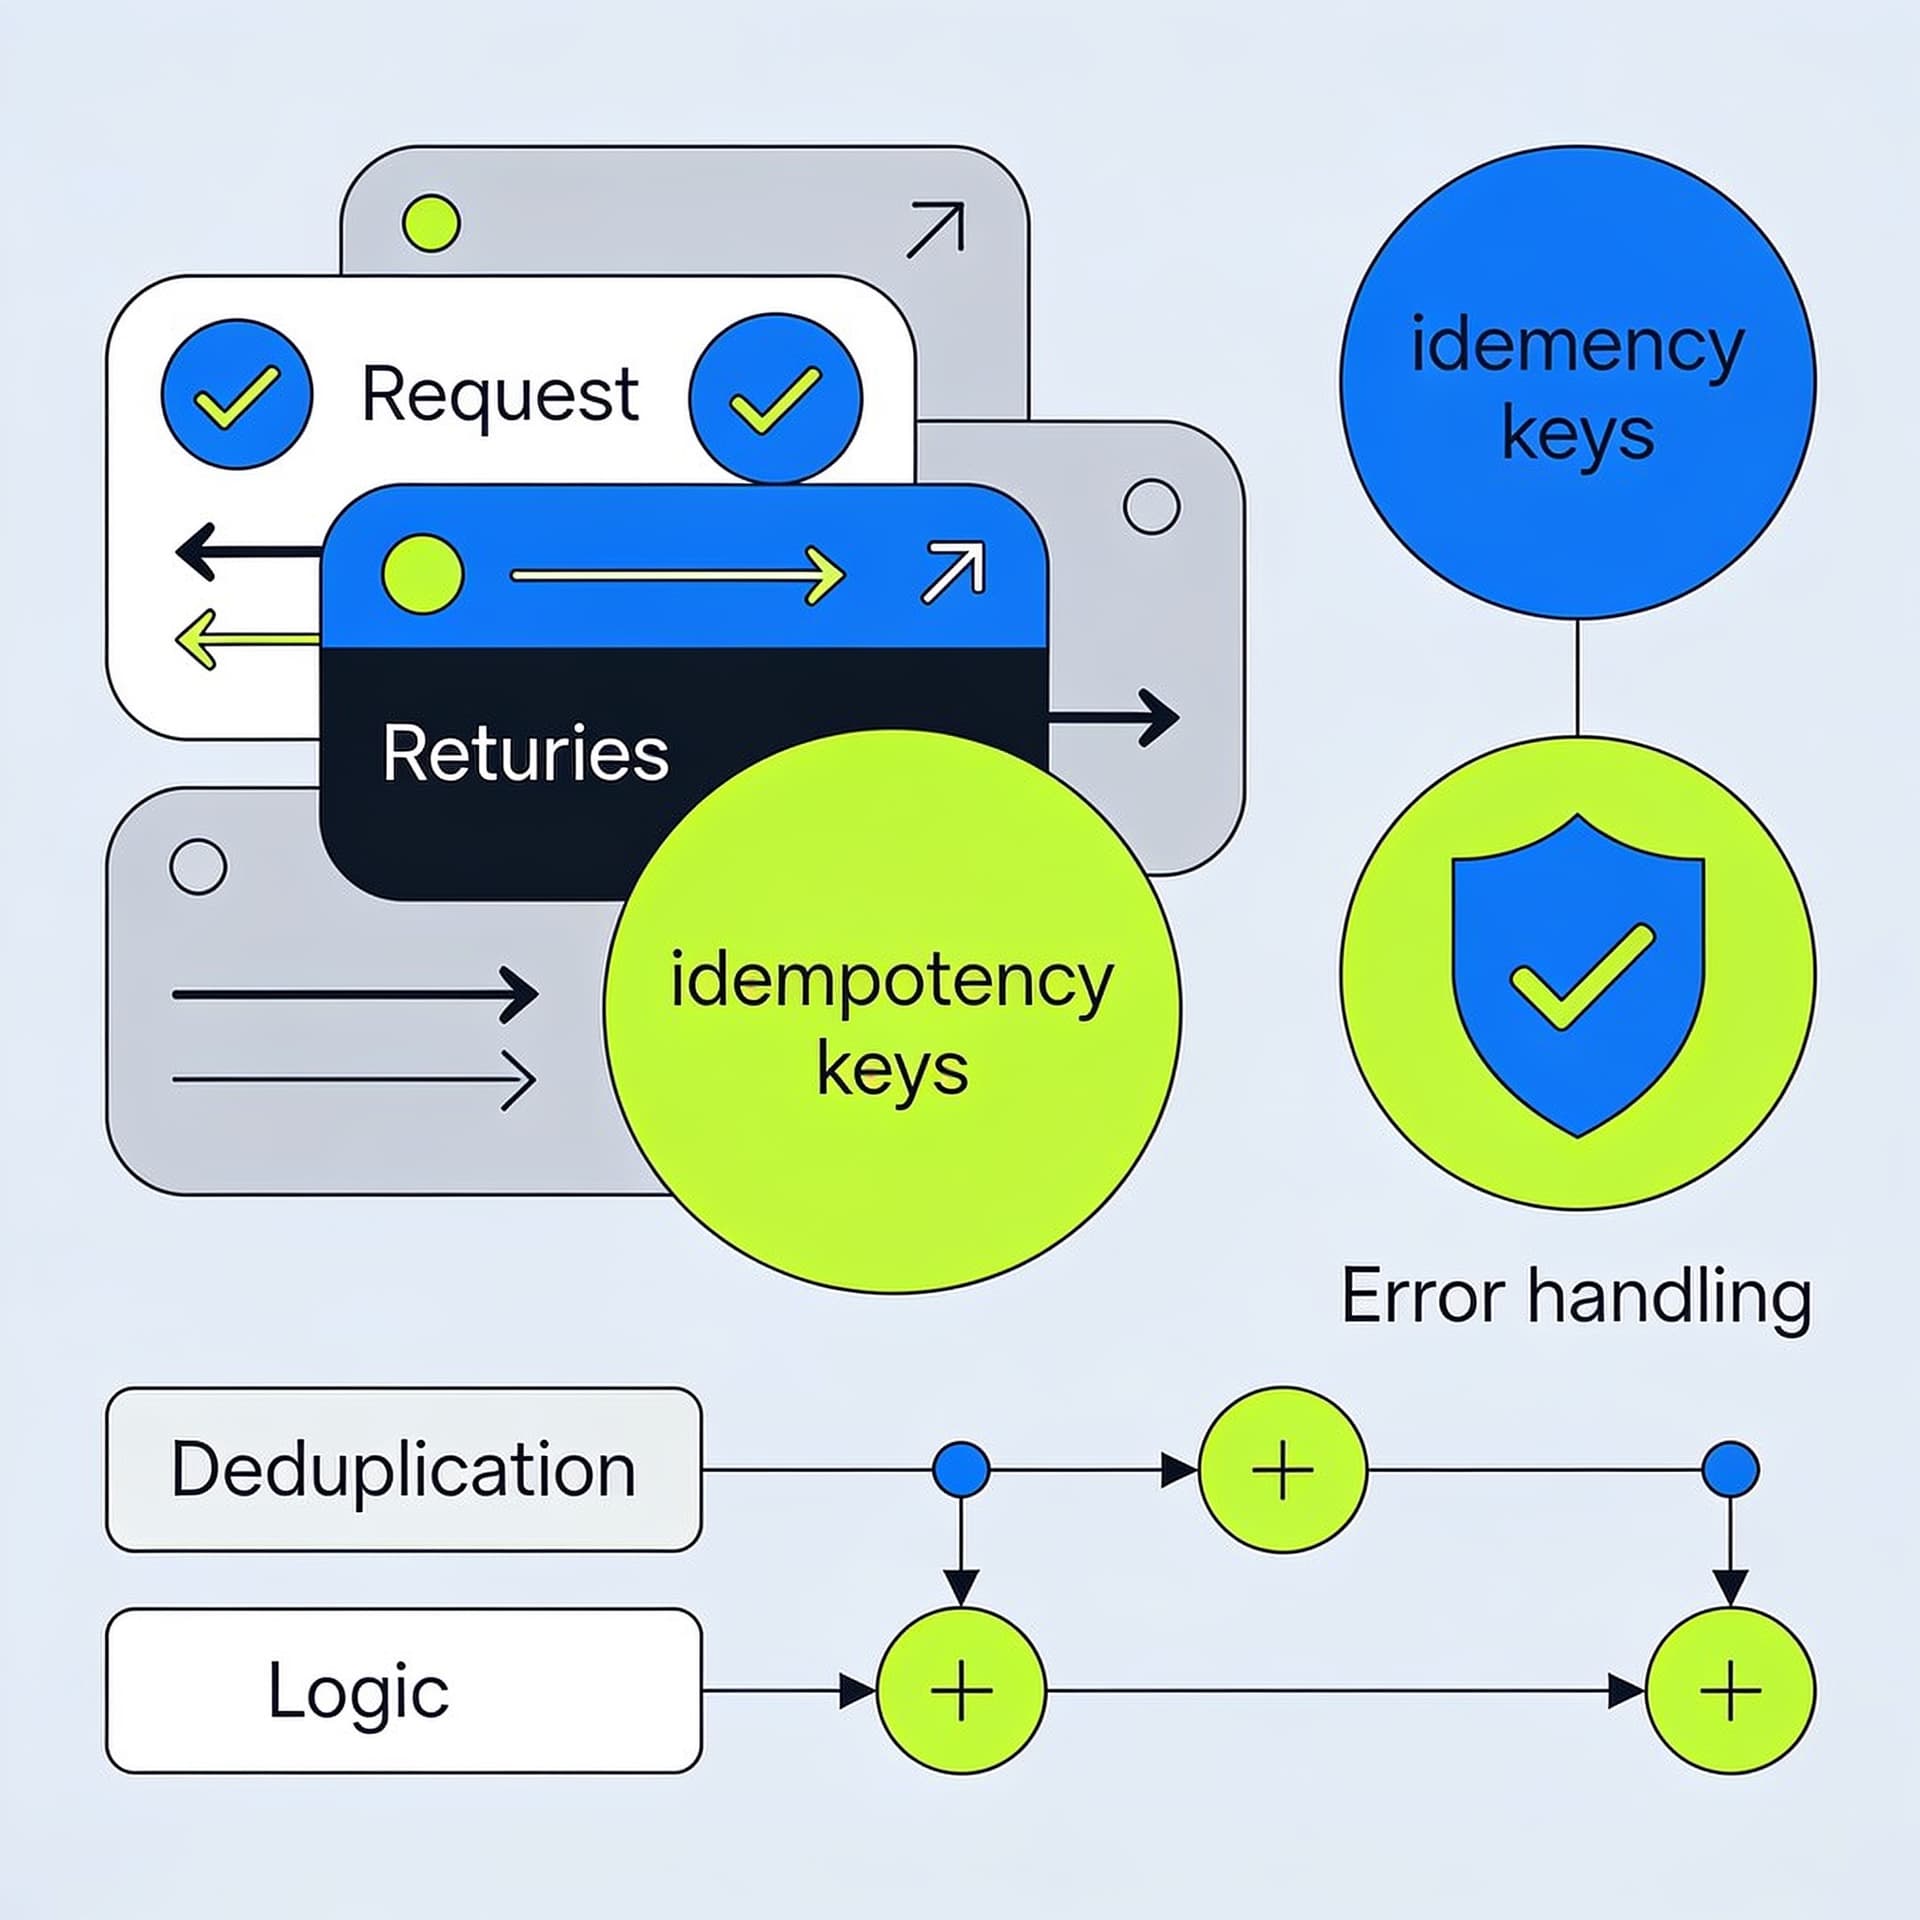
Поговорим о ключах идемпотентности, дедупликации, повторе запросов и схемах ошибок. Покажем, как не ломать бизнес-логику при ретраях клиентов.
Содержание
Повторные запросы — одна из тех проблем, которые всплывают не потому, что «клиенты плохие», а потому что распределённые системы по природе своей не гарантируют доставку и выполнение строго один раз. Клиент может ретраить запрос из‑за таймаута, балансировщик — повторить попытку при отказе upstream, сеть — дублировать пакеты или задерживать подтверждения. В итоге бизнес-операции могут выполняться дважды: списания денег, создание заказов, начисления бонусов, отправка уведомлений.
Идемпотентность — практичный ответ на эту реальность. Она позволяет сделать так, чтобы один и тот же логический запрос, повторённый многократно, приводил к одному и тому же результату. Ниже разберём, как это проектировать в бэкенде: какие бывают ключи идемпотентности, как устроить дедупликацию, как корректно вернуть результат и какие схемы ошибок не ломают клиентскую логику.
Почему «повтор запроса» неизбежен
В идеальном мире каждый HTTP-запрос проходит один путь и один раз попадает в обработчик. В реальности же есть множество причин, по которым сервер может не «увидеть» успешность:
- Таймауты: клиент не дождался ответа, но запрос на сервере мог успеть выполниться.
- Разрывы соединения: ответ ушёл, но клиент не получил его из‑за ошибки сети.
- Ретраи на балансировщике / API gateway: иногда попытки повторяются автоматически при некоторых классах ошибок.
- Параллельные клиенты: пользователь может отправить действие дважды (двойной клик), а UI/мобильное приложение — повторить из‑за плохой обратной связи.
Суть: клиент может ретраить как из «правильных» соображений (обеспечить устойчивость), так и по «наивности». Ваш сервер должен быть устойчив к обоим сценариям, если бизнес-операции не допускают дублей.
Идемпотентность: что именно мы хотим гарантировать
Важно различать несколько похожих, но разных гарантий.
Семантика идемпотентности
Операция идемпотентна, если выполнение одного и того же логического действия несколько раз приводит к одинаковому конечному состоянию.
На практике для API это означает:
- Клиент делает запрос с идемпотентным ключом.
- Повтор с тем же ключом должен:
- либо вернуть тот же результат (включая статус и тело),
- либо обеспечить корректный детерминированный эффект, который соответствует «однократному выполнению».
Уровни идемпотентности
Есть два основных подхода:
- Математическая идемпотентность (редко доступна): например, операция «установить значение X в поле Y» уже идемпотентна по определению.
- Прикладная идемпотентность (самый распространённый): вы добавляете механизм дедупликации на стороне сервера.
Мы сосредоточимся на прикладной идемпотентности, потому что она решает реальный «дубль бизнеса».
Ключ идемпотентности: форма, генерация и правила
Как выглядит ключ
Чаще всего используют заголовок вида:
Idempotency-Key: <opaque-string>
Некоторые делают это через тело запроса или отдельное поле, но заголовок обычно удобнее: не смешивается с доменной моделью.
Ключ должен быть:
- Уникальным для логического действия клиента.
- Стабильным на время ретраев.
- Опробованным на переносимость (например, выдерживать длину/алфавит).
Обычно ключ делают случайным (UUIDv4) на клиенте. Если клиент может определить «логическое действие» детерминированно (например, orderId), можно использовать составной ключ. Однако случайные ключи проще и надёжнее: клиенту не нужно думать о корректности составления.
Кто генерирует ключ
Практически всегда генерация — на клиенте:
- Клиент знает, что именно он пытается сделать.
- Клиент может ретраить столько раз, сколько нужно, сохраняя один и тот же ключ.
- Бэкенд не обязан «угадывать», что два запроса эквивалентны.
На серверной стороне вы лишь валидируете ключ и применяете дедупликацию.
Важное правило: какой запрос считать «тем же»
Идемпотентность завязана не только на ключ, но и на семантику. Если клиент повторяет запрос с тем же ключом, но меняет содержимое, как должен вести себя сервер?
Типовые стратегии:
- Жёсткая: если тело отличается — возвращать
409 Conflictили400 Bad Request. - Мягкая: принимать первый вариант как истинный, а повтор с другим телом отклонять.
- Детерминированная: использовать хэш тела и включать его в запись. Тогда один и тот же ключ + тот же хэш = эквивалентный запрос.
Самый распространённый подход: сохранять содержимое (или его хэш) вместе с результатом, а на повтор — проверять соответствие.
Дедупликация: как именно «не выполнять дважды»
Модель хранения
На сервере нужен механизм, который свяжет идемпотентный ключ с результатом операции.
Базовый вариант — таблица:
idempotency_keyuser_id(или tenant)keyrequest_hashstatus(например:processing,succeeded,failed)response_payload(тело ответа или ссылка на него)response_status(HTTP статус)created_at,expires_at
Один из нюансов: вы хотите гарантировать, что при конкурентных запросах один обработчик «выиграет», а остальные получат либо уже готовый ответ, либо корректное сообщение о том, что обработка ещё идёт.
Блокировки и уникальные ограничения
Самый практичный паттерн — использовать уникальный индекс на (user_id, key):
- При первом запросе создаёте запись.
- При повторе получаете запись и возвращаете сохранённый результат.
- При конкурентных запросах один сможет успешно вставить запись, остальные увидят, что она уже существует.
В SQL это часто реализуют через транзакции и INSERT ... ON CONFLICT.
Пример на SQL (псевдо-реалистичный)
-- Уникальность: ключ идемпотентности внутри контекста пользователя/тенанта
CREATE UNIQUE INDEX ux_idempotency_user_key
ON idempotency_requests (user_id, idempotency_key);
При обработке:
- Считаете
request_hash(например, SHA-256 от нормализованного тела). - Пытаетесь создать запись со статусом
processing. - Если создание прошло — выполняете операцию.
- Если создание не прошло (ключ уже есть) — возвращаете результат из записи.
Паттерн «одна попытка выигрывает»: кодовый скелет
Рассмотрим пример на Node.js/TypeScript (логика схематична, но рабочие идеи сохраняются). Допустим, у нас есть таблица idempotency_requests и функция db.
Схема данных (упрощённо)
CREATE TABLE idempotency_requests (
  idempotency_id BIGSERIAL PRIMARY KEY,
  user_id TEXT NOT NULL,
  idempotency_key TEXT NOT NULL,
  request_hash TEXT NOT NULL,
  status TEXT NOT NULL, -- processing|succeeded|failed
  response_status INT,
  response_body JSONB,
  error_code TEXT,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  expires_at TIMESTAMPTZ NOT NULL,
  UNIQUE (user_id, idempotency_key)
);
Обработчик запроса
import crypto from "crypto";

function sha256(input: string) {
  return crypto.createHash("sha256").update(input).digest("hex");
}

// Нормализуйте тело перед хэшем, иначе одинаковые запросы могут иметь разный порядок полей
function normalizeBody(body: any): string {
  return JSON.stringify(body, Object.keys(body).sort());
}

async function handleCreateOrder(req: any, userId: string) {
  const key = req.headers["idempotency-key"];
  if (!key) {
    // Для бизнес-операций, которые должны быть идемпотентными, ключ лучше требовать.
    // Если ключ отсутствует — решайте политику отдельно.
    throw new Error("Missing Idempotency-Key");
  }

  const requestHash = sha256(normalizeBody(req.body));
  const expiresAt = new Date(Date.now() + 24 * 60 * 60 * 1000); // 24 часа, как пример

  // Попытка "вставить как processing"
  const inserted = await db.idempotency_requests.insertOnConflictDoNothing({
    user_id: userId,
    idempotency_key: key,
    request_hash: requestHash,
    status: "processing",
    expires_at: expiresAt,
  });

  if (inserted) {
    // Мы победили гонку: реально выполняем бизнес-операцию
    try {
      const order = await domain.createOrder(req.body, userId);

      // Сохраняем ответ
      await db.idempotency_requests.updateByUniqueKey(
        { user_id: userId, idempotency_key: key },
        {
          status: "succeeded",
          response_status: 201,
          response_body: { orderId: order.id },
          error_code: null,
        }
      );

      return { status: 201, body: { orderId: order.id } };
    } catch (err: any) {
      // Сохраняем ошибку (важно: что именно вернём на повторе)
      await db.idempotency_requests.updateByUniqueKey(
        { user_id: userId, idempotency_key: key },
        {
          status: "failed",
          response_status: 500,
          response_body: { message: "Internal error" },
          error_code: "INTERNAL_ERROR",
        }
      );

      // Ретрай на клиенте должен либо повторно вернуть ту же ошибку,
      // либо (если ошибка временная) клиент может получить подсказку.
      throw err;
    }
  } else {
    // Ключ уже был использован: возвращаем ранее сохранённый результат
    const row = await db.idempotency_requests.findByUniqueKey({ user_id: userId, idempotency_key: key });

    if (!row) {
      // Непредвиденная ситуация: повтор без записи. Неплохо бы залогировать.
      throw new Error("Idempotency record not found");
    }

    // Проверка, что запрос действительно тот же
    if (row.request_hash !== requestHash) {
      // Клиент переиспользовал ключ, но изменил payload: конфликт семантики.
      return {
        status: 409,
        body: { message: "Idempotency-Key reused with different request body" },
      };
    }

    if (row.status === "processing") {
      // Варианты:
      // 1) Подождать (короткий sleep + повтор чтения)
      // 2) Вернуть 409/425 или 202 с понятным сообщением
      // Для API чаще выбирают 409 или 425 Too Early.
      return {
        status: 425,
        body: { message: "Request is being processed, retry later" },
      };
    }

    if (row.status === "succeeded") {
      return { status: row.response_status, body: row.response_body };
    }

    if (row.status === "failed") {
      // Возвращаем ту же ошибку, чтобы клиент был детерминирован
      return { status: row.response_status, body: row.response_body };
    }

    throw new Error("Unknown idempotency status");
  }
}
Ключевой момент: даже ошибка должна быть идемпотентной с точки зрения повтора. Клиент ретраит — он должен получать согласованный результат и не провоцировать вторичное выполнение бизнес-операции.
Дедупликация и ретраи: как не устроить «двойную боль»
Разделяйте ошибки на классы
Не все ошибки одинаковы.
-
Временные (network glitch, 503, deadlock, rate limiting в определённых условиях)
→ клиент может ретраить. Но ваш бэкенд при идемпотентности должен избежать повторного выполнения. При этом можно считать допустимым, что результат останется тем же (например, всё равно не удалось). -
Постоянные (валидация, 400, 409 по бизнес-правилам)
→ ретрай обычно бесполезен, клиент должен получить ту же ошибку. Идемпотентность здесь важна, чтобы не получить двойной эффект. -
Неизвестные / системные (500)
→ особенно важно сохранять итог: если операция успела частично выполниться, вы хотите зафиксировать, что именно было сделано, либо откатить транзакцию.
Схемы ошибок: что возвращать при повторе
Есть несколько тонких мест:
- Если первый запрос ещё обрабатывается (
processing), повтор может прийти до фиксации.
Возврат425 Too Early(или409 Conflictс понятным сообщением) обычно лучше, чем выполнение второй ветки. - Если первый запрос завершился ошибкой, повтор должен вернуть ту же ошибку (или эквивалент), иначе клиент получит недетерминированное поведение:
- иногда он увидит 500,
- иногда — 200,
- иногда — другое.
- Если ошибка была временной, но первый запрос успел записать состояние
failed, клиент, ретрая с тем же ключом, не сможет добиться повторного выполнения, потому что вы зафиксировали результат ошибки. Это конфликт бизнес-намерений: клиент хотел повторить.
Как решить? Варианты:
- Не фиксировать временные ошибки в статус
failedокончательно, а хранитьprocessingдольше или отдельный статусretryable_failed. - Разрешать клиенту менять ключ при ретраях для временных ошибок. Но это требует дисциплины на клиентах.
- Хранить детали ошибки и политику: например,
failedдля постоянных, ноretryableдля временных с возможностью повторного исполнения через таймер/окно.
На практике часто делают следующее:
- временные ошибки фиксируются, но с маркировкой
retryable, - повтор с тем же ключом в пределах «окна допустимых повторов» возвращает тот же статус без повторного эффекта,
- а после истечения окна политика меняется (либо ключ надо обновить, либо сервер разрешает повторную попытку).
Главное — документировать поведение, чтобы клиент понимал, что делать.
Нормализация запроса и хэш: предотвращаем ложные конфликты
Проверка request_hash полезна, но вызывает проблемы:
- JSON в разных клиентах может иметь разный порядок полей.
- Поля могут содержать отличающиеся, но не влияющие на смысл метаданные.
Поэтому важно:
- Нормализовать JSON перед хэшем (например, сортировать ключи).
- Рассмотреть что именно входит в семантику:
- если есть незначимые поля (например,
clientTimestamp), их можно исключить из хэша; - если поля влияют на результат — их нужно включить.
- если есть незначимые поля (например,
Если вы включаете всё подряд, вы получите сценарии, когда клиент «тот же запрос» считает тем же, а сервер — отличным, и вернёт 409.
Срок хранения ключей: компромисс между безопасностью и стоимостью
Идемпотентность почти всегда требует хранения соответствия ключ → результат, иначе при повторе вы не сможете вернуть консистентный ответ.
Но хранить бессрочно дорого. Поэтому вводят expires_at:
- типичная практика: от нескольких минут до суток.
- зависит от SLA ретраев клиентов и вероятности, что ретрай придёт «позже» таймаута.
Подводный камень: если клиент ретраит позже, чем истек срок хранения, он получит повторную обработку как новый запрос — и бизнес может задублироваться.
Решения:
- увеличивать TTL для критичных операций (платежи — особенно);
- хранить в «горячем» хранилище дольше, а потом переносить в архив/сжатый вид;
- документировать клиентам правила: при истечении ключа генерация должна быть новой.
Конкурентность: две попытки одновременно и гонки записи
Самые частые ошибки в реализации идемпотентности:
- нет уникального ограничения → два воркера одновременно выполняют бизнес-операцию;
- запись создаётся, но результат не сохраняется атомарно → повтор видит
processingвечность; - статус обновляется «в два шага» без транзакции → клиент может поймать промежуточное состояние.
Рекомендации:
- сделать уникальный индекс;
- оборачивать запись/обновление в транзакцию или использовать атомарные операции;
- тщательно думать о таймауте обработки: что делать, если воркер упал и запись осталась
processing?
Режим зависшего processing
Если процесс упал после создания записи, запись может остаться в processing.
Варианты:
- периодический воркер переводит
processingвfailedпо тайм-ауту; - либо клиенты при
425 Too Earlyретраят, но вы должны гарантировать, что зависшее состояние не длится бесконечно.
Когда идемпотентность особенно важна
Список операций, где дубль запроса часто критичен:
- создание заказов/заявок с биллингом;
- списание средств / выпуск транзакций;
- начисления бонусов;
- отправка писем/смс (в идеале — через outbox + идемпотентные события