Пишем надёжный поиск: индексы, ранжирование и пагинация без сюрпризов
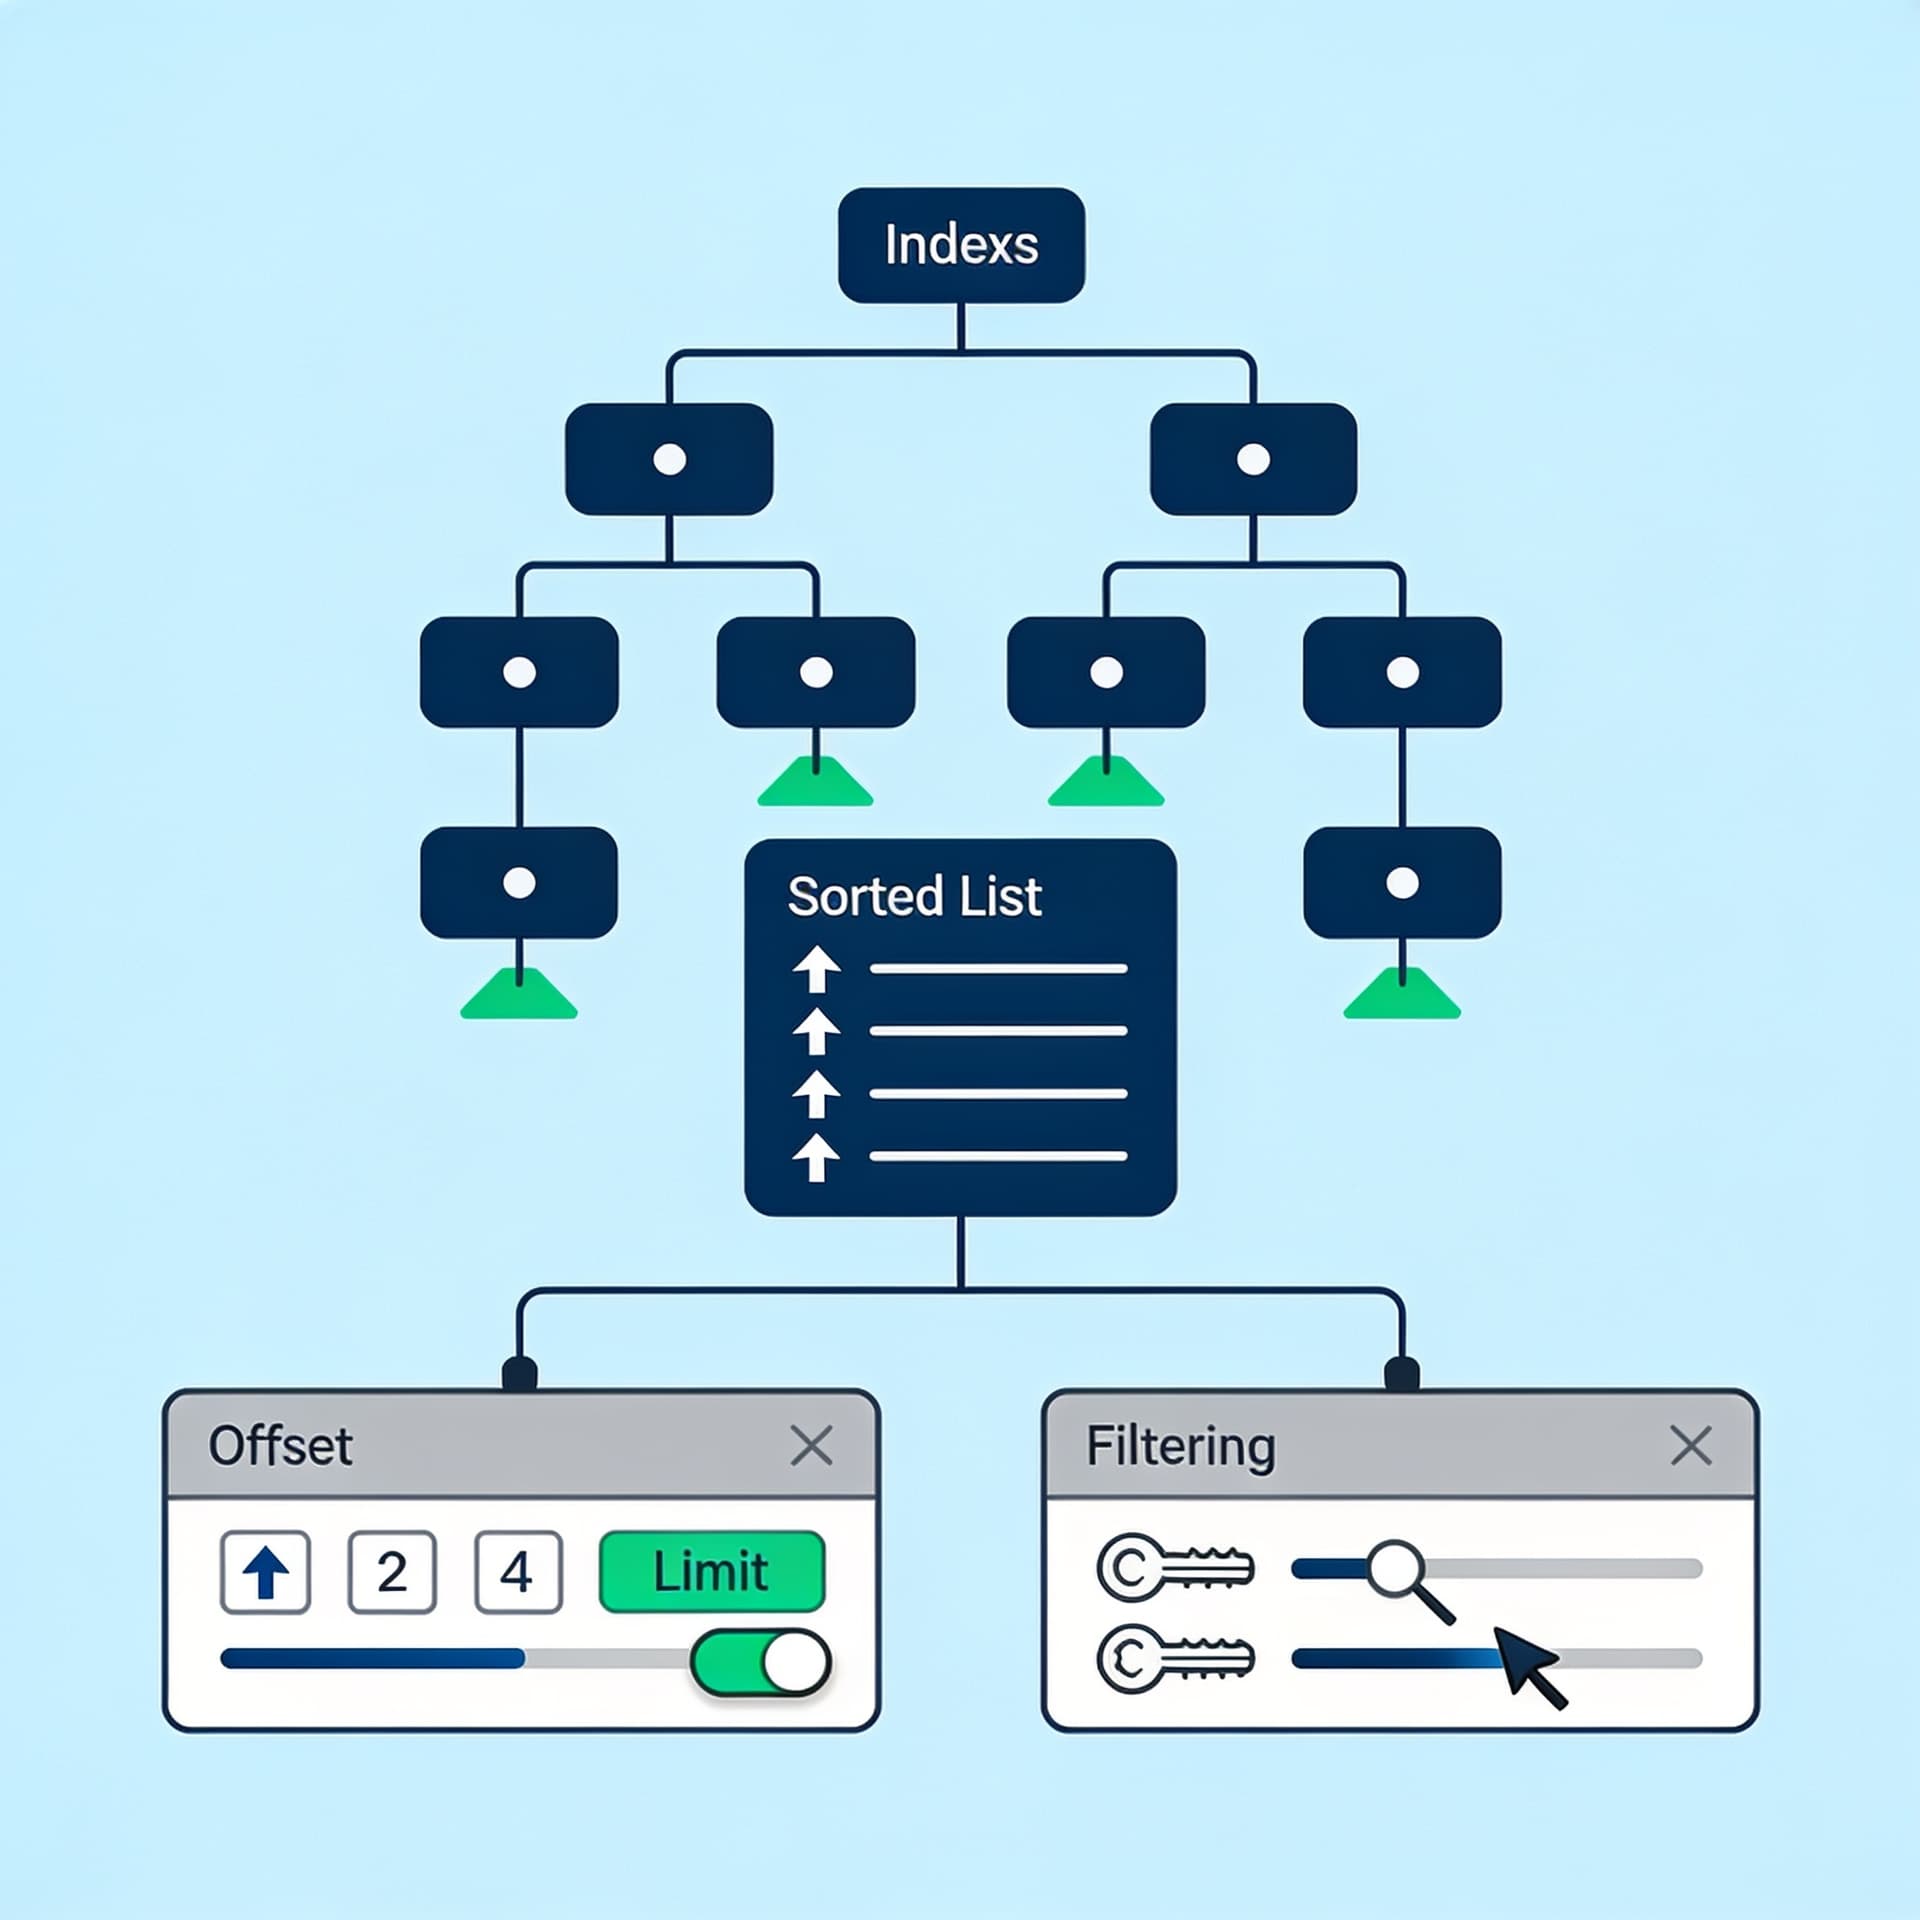
Разберём, как организовать фильтрацию и сортировку так, чтобы результаты были стабильными. Сравним offset/limit и keyset pagination и объясним влияние индексов.
Содержание
Стабильный поиск — это не только про «показывать быстро». Это про предсказуемость: один и тот же пользовательский запрос и одна и та же сортировка должны приводить к ожидаемому набору результатов, а пагинация — не «скакать» между страницами при параллельных изменениях в данных. На практике почти все неприятные сюрпризы (дубликаты, пропуски, плавающий порядок) возникают на стыке трёх тем: индексы, ранжирование и пагинация.
В этой статье разберём, как организовать фильтрацию и сортировку так, чтобы выдача была устойчивой. Сравним классическую пагинацию OFFSET/LIMIT и keyset pagination (pagination по ключу), обсудим, как на это влияет наличие и форма индексов, и покажем рабочие примеры SQL. Материал ориентирован на реляционные базы (в первую очередь PostgreSQL, но логика применима и к другим системам с SQL).
Что ломает стабильность: типовой набор проблем
Представьте: вы сортируете список статей по релевантности и выводите страницы по 20 элементов. И вдруг пользователь жалуется: «На второй странице какие-то статьи повторяются, а одна и вовсе исчезла». Как правило, это не «баг ранжирования», а следствие:
-
Нестабильного порядка сортировки.
Если вORDER BYесть неуникальные поля (например,scoreилиcreated_at, которые совпадают у разных строк), СУБД может выбрать произвольный порядок среди равнозначных. Без доп. tie-breaker порядок «плавает». -
Пагинации
OFFSET/LIMITна изменяющемся наборе.
При вставках/удалениях между запросами смещениеOFFSETбольше не соответствует той же «границе» в наборе строк. Итог: дубликаты и пропуски. -
Сортировки, которые не поддерживаются индексами.
Если запрос вынужден сортировать «на лету» (external sort), то порядок может отличаться из-за параллельности или изменившегося плана выполнения, а производительность резко падает на глубоких страницах. -
Фильтрации и ранжирования, которые меняют порядок в зависимости от контекста.
Например, вы используете функции ранжирования или подтягиваете атрибуты из других таблиц. Малейшие изменения в данных или статистике оптимизатора способны менять план и, в отдельных случаях, поведение «равных» строк.
Вывод: надёжность — это дизайн запроса и пагинации, а не только «правильные SELECT».
Дизайн стабильного ранжирования и сортировки
Ранжирование ≠ сортировка, но они должны сходиться
Даже если вы используете сложный score (BM25, персонализация, «умность»), в конечном итоге всё сводится к ORDER BY .... Для стабильности критично:
- Ранжирование должно порождать сортировку.
- Сортировка должна быть детерминированной (детерминированный tie-breaker).
Типовой паттерн для детерминированности:
- Основной ключ: релевантность/скор (неуникальный)
- Вторичный ключ: время/ID (уникальный или близкий к уникальному)
- Финальный tie-breaker: уникальный идентификатор строки
Например:
SELECT
  a.id,
  a.title,
  a.created_at,
  -- допустим, score уже посчитан
  r.score
FROM articles a
JOIN article_rank r ON r.article_id = a.id
WHERE a.status = 'published'
ORDER BY
  r.score DESC,
  a.created_at DESC,
  a.id DESC
LIMIT 20 OFFSET 0;
a.id делает порядок полностью детерминированным среди всех «равных» по score и created_at. Это не «красота», а базовая гарантия.
Если у вас нет уникального поля для tie-breaker — заведите его. Почти всегда есть primary key, который и должен быть финальным ключом сортировки.
Ранжирование на стороне SQL: осторожно с неоднозначностью
Если score вычисляется функцией, важно понимать:
- функция должна быть детерминированной (одни и те же входы → одинаковый результат);
- используемые данные не должны приводить к «дрейфу» при параллельных обновлениях, иначе ранжирование меняется между страницами.
Часто помогает концепция: считать score «на момент запроса» или оперировать материализованными данными. Если вам важна строгая повторяемость, без варианта «snapshot» на уровне транзакции или стабилизации индексов/материализаций может быть трудно добиться 100% консистентности для всех сценариев.
Пагинация: OFFSET/LIMIT против keyset pagination
OFFSET/LIMIT: просто, но нестабильно на изменениях
Классический подход выглядит так:
SELECT ...
FROM ...
WHERE ...
ORDER BY ...
LIMIT :page_size
OFFSET :offset;
Проблемы OFFSET/LIMIT:
- Производительность: на больших
offsetбаза фактически «пролистывает» много строк, даже если отдаёт только последниеLIMIT. Это может приводить к линейному росту времени ответа. - Консистентность: при изменениях данных между запросами (добавление/удаление) граница страницы смещается — результат может «плыть».
Даже если порядок детерминирован, OFFSET привязан к позиции в текущем наборе, а не к «логической границе сортировки».
Когда OFFSET/LIMIT приемлем:
- список почти не меняется;
- вы допускаете eventual consistency в навигации страниц;
- страницы небольшие, а глубина пагинации ограничена;
- вы показываете «почти стабильный» результат, а не «строго тот же».
Keyset pagination: стабильная граница и естественная работа с индексами
Keyset pagination (также известна как «seek method») использует не число пропущенных строк, а последний просмотренный ключ сортировки. Тогда следующая страница строится через условие вида:
- для сортировки по убыванию:
(<key), для возрастания:(>key)— с учётом всех полей сортировки и tie-breaker.
Предположим, вы сортируете по:
score DESCcreated_at DESCid DESC
Тогда первая страница — обычный запрос с LIMIT. Следующие — с фильтром по трём ключам.
Пример для второй страницы (когда пользователь передал курсор последнего элемента первой страницы):
-- курсор пришёл от клиента:
-- last_score, last_created_at, last_id
SELECT
  a.id, a.title, a.created_at, r.score
FROM articles a
JOIN article_rank r ON r.article_id = a.id
WHERE a.status = 'published'
  AND (
    r.score <  :last_score
    OR (r.score = :last_score AND a.created_at < :last_created_at)
    OR (r.score = :last_score AND a.created_at = :last_created_at AND a.id < :last_id)
  )
ORDER BY
  r.score DESC,
  a.created_at DESC,
  a.id DESC
LIMIT :page_size;
Ключевая идея:
- Условие «пересекается» с вашим
ORDER BY, чтобы не пропустить элементы и не повторить их. - Благодаря tie-breaker
idкурсор становится однозначным.
Важный нюанс: составной курсор
Если сортировка многополевая, курсор тоже должен включать все поля сортировки (и в правильном порядке/с направлением). Иначе вы теряете корректность.
Ещё один нюанс: строгая работа с направлением сортировки
Направление (ASC/DESC) определяет оператор сравнения (> или <). Ошибка в одном поле ломает границы. Поэтому, если вы меняете сортировку в UI, курсор и SQL должны генерироваться соответствующим образом.
Индексы: как они влияют на ранжирование, сортировку и пагинацию
1) Индекс поддерживает сортировку только если он соответствует ORDER BY
Если вы делаете ORDER BY score DESC, created_at DESC, id DESC, то идеальная ситуация — индекс, который начинается с этих же полей в том же порядке и направлениях (насколько поддерживается СУБД).
В PostgreSQL синтаксис индекса обычно такой:
CREATE INDEX idx_articles_rank_order
ON article_rank (score DESC, article_id) ;
Но тут есть тонкость: article_rank — отдельная таблица, а сортировка по created_at находится в articles. Поэтому один индекс редко покрывает всё сразу. Часто приходится:
- либо хранить
created_atв той же таблице ранжирования (денормализация или материализация), - либо использовать индексы, которые ускоряют фильтрацию, а сортировку — комбинировать/дотягивать.
Практическая стратегия для надёжности и производительности:
- делайте так, чтобы часть сортировки была в одной таблице, а join не ломал порядок;
- храните tie-breaker (например,
id) там же, где строится порядок, чтобы условие keyset могло эффективно использовать индекс.
2) Keyset pagination сильнее «завязана» на индексы
OFFSET можно хотя бы в теории обслужить планом с LIMIT и частичным обходом, но часто всё равно приходится «прошивать» множество строк. Keyset метод превращает задачу в «дай всё меньше/больше границы» — это уже типичная область для B-tree индексов.
То есть ключевой выигрыш keyset обычно не только в консистентности, но и в том, что СУБД может:
- быстро найти первую запись после курсора,
- и затем последовательно прочитать
LIMITзаписей.
3) Фильтрация должна быть частью индексной стратегии
Если у вас фильтр по status='published', это влияет на селективность. Индекс на status или составной индекс с status часто сокращает область данных, по которой делается сортировка.
Например, если сортировка делается по полям из articles, индекс может выглядеть так:
CREATE INDEX idx_articles_published_order
ON articles (status, created_at DESC, id DESC);
Но если сортировка по score хранится в article_rank, то «идеальный» индекс будет другим. Если вы допускаете материализацию score (например, в view/таблице), можно добиться индекса «всё в одном».
Как собрать запрос так, чтобы план был предсказуемым
Шаг 1. Делайте порядок детерминированным
Мы уже говорили про tie-breaker. Здесь правило жёсткое: всегда добавляйте уникальный ключ в конец ORDER BY.
Шаг 2. Совместите фильтры и сортировку логически
Если UI позволяет фильтровать по категориям/атрибутам, подумайте о составных индексах под самые частые запросы. В идеале:
- индекс покрывает
WHERE(или хотя бы сужает), - дальше поддерживает
ORDER BY, - и уже затем
LIMIT.
Шаг 3. Для keyset используйте «полный» курсор из ключей сортировки
Постройте WHERE таким образом, чтобы он продолжал ваш ORDER BY. Это условие выглядит громоздко, но оно механическое: лексикографическое сравнение составного ключа.
Шаг 4. Проверьте планы
В PostgreSQL полезны EXPLAIN (ANALYZE, BUFFERS) и проверка, используется ли нужный индекс и выполняется ли сортировка явно. Если появляется Sort поверх большого набора — есть повод пересмотреть структуру индексов или модель данных.
Практические сценарии: как меняется SQL и индексы
Сценарий A: сортировка только по полям таблицы (без сложного score)
Допустим, у вас есть таблица articles:
statuscreated_atid(PK)
Запрос:
- фильтр
status='published' - сортировка
created_at DESC, id DESC
Тогда keyset будет выглядеть естественно.
Keyset для следующей страницы:
-- курсор: last_created_at, last_id
SELECT id, title, created_at
FROM articles
WHERE status = 'published'
  AND (
    created_at <  :last_created_at
    OR (created_at = :last_created_at AND id < :last_id)
  )
ORDER BY created_at DESC, id DESC
LIMIT :page_size;
И индекс:
CREATE INDEX idx_articles_status_created
ON articles (status, created_at DESC, id DESC);
Этот набор даёт:
- узкое сканирование по
status, - последовательный проход по индексному ключу,
- корректную навигацию курсором.
Сценарий B: сортировка по score из связанной таблицы
Предположим, score хранится в article_rank, а created_at — в articles.
Схема:
article_rank(article_id PK/FK, score)articles(id PK, status, created_at)
Проблема: составной порядок затрагивает две таблицы. Индекс на article_rank(score, article_id) не знает про created_at.
Что можно сделать:
-
Материализовать
created_atвarticle_rank(или хранить его дубликат) — если это допустимо по обновлениям. Тогда курсор может строиться только по полям ранжирования. -
Делать keyset по одному ключу из одной таблицы. Например, сортировать только по
score DESC, article_id DESC(гдеarticle_idуникален и tie-breaker). Если бизнес-договорённость позволяет — это упрощает всё. -
Пойти на компромисс с созданием «правильного» индекса для join-плана, но это зависит от конкретной базы и плана оптимизатора. Надёжность решения будет ниже.
Пример keyset, если вы решаете сортировать по score и id, игнорируя created_at как часть порядка:
-- курсор: last_score, last_id (id = articles.id)
SELECT a.id, a.title, a.created_at, r.score
FROM article_rank r
JOIN articles a ON a.id = r.article_id
WHERE a.status = 'published'
  AND (
    r.score < :last_score
    OR (r.score = :last_score AND a.id < :last_id)
  )
ORDER BY
  r.score DESC,
  a.id DESC
LIMIT :page_size;
Индекс на article_rank:
CREATE INDEX idx_rank_score_article
ON article_rank (score DESC, article_id DESC);
Дальше join подтянет created_at для вывода, но порядок уже определён индексом ранжирования и tie-breaker — article_id.
Сценарий C: когда релевантность меняется во времени
Если ваш score пересчитывается (например, на основе действий пользователей), то курсор будет корректен «относительно текущего состояния». Но между первой и второй страницей score может поменяться — и вы снова получите ощущение «прыжков», хотя SQL корректен.
На практике выбирают компромисс:
- либо фиксируют snapshot на уровне транзакции/временной метки (если бизнес позволяет),
- либо принимают, что это «динамическая витрина» и делают UI, который явно показывает актуальность.
Технически можно сделать «consistent read» на уровне транзакции (в PostgreSQL с REPEATABLE READ), но удерживать транзакции слишком долго часто нельзя.
OFFSET/LIMIT и как минимизировать сюрпризы
Если вы по какой-то причине вынуждены использовать OFFSET/LIMIT (например, жесткая поддержка SEO, исторические ограничения, простая модель интерфейса), можно снизить вероятность проблем:
-
Стабилизируйте
ORDER BYtie-breaker.
Это обязательно: без него дубликаты и пропуски могут быть даже при почти неизменных данных. -
Ограничьте глубину пагинации.
Чем большеOFFSET, тем больше риск и затратность. Часто разумная политика: первые N страниц —OFFSET, дальше — переключать UI на курсоры. -
Используйте транзакцию или snapshot там, где это уместно.
Для внутреннего админ-интерфейса можно держать транзакцию на короткое время. Для публичной выдачи — обычно выбирают keyset.
Практический шаблон: генерация keyset-условия под составной ORDER BY
Чтобы избежать ошибок, удобно описать сортировку как список ключей и затем механически построить условие для keyset. Ниже — пример того, как в SQL будет выглядеть лексикографическое сравнение для DESC, DESC, DESC:
-- ORDER BY: k1 DESC, k2 DESC, k3 DESC
-- курсор: last_k1, last_k2, last_k3
WHERE
  k1 < last_k1
  OR (k1 = last_k1 AND k2 < last_k2)
  OR (k1 = last_k1 AND k2 = last_k2 AND k3 < last_k3)
Для ASC вместо < будет >.
Это важно: keyset pagination — не «магия», а аккуратная работа с составным ключом. Именно поэтому tie-breaker в конце жизненно нужен: иначе сравнение будет неполным.
Отдельно про «поиск» vs «фильтрацию»
В статье мы говорим про стабильную выдачу для списка. Но «поиск» в интерфейсе часто смешивает:
- полнотекстовый поиск (TSVEC/внешний индекс),
- фильтрацию по полям,
- сортировку