Async-очереди и backpressure: как не убить сервис нагрузкой
Объясним, как выбирать размеры очередей, где ставить ограничители и как реагировать на переполнение. Разберём паттерны consumer-producer и корректное завершение фоновых задач.
Содержание
Высоконагруженные сервисы редко «умирают» внезапно. Обычно процесс похож на медленную деградацию: растёт задержка, затем память, затем сеть, затем очередь переполняется, а вместе с ней — пул потоков/ивентов и всё остальное. На практике это почти всегда одна и та же проблема: мы разрешаем системе накапливать работу бесконечно долго, вместо того чтобы ограничивать скорость и делать backpressure частью дизайна.
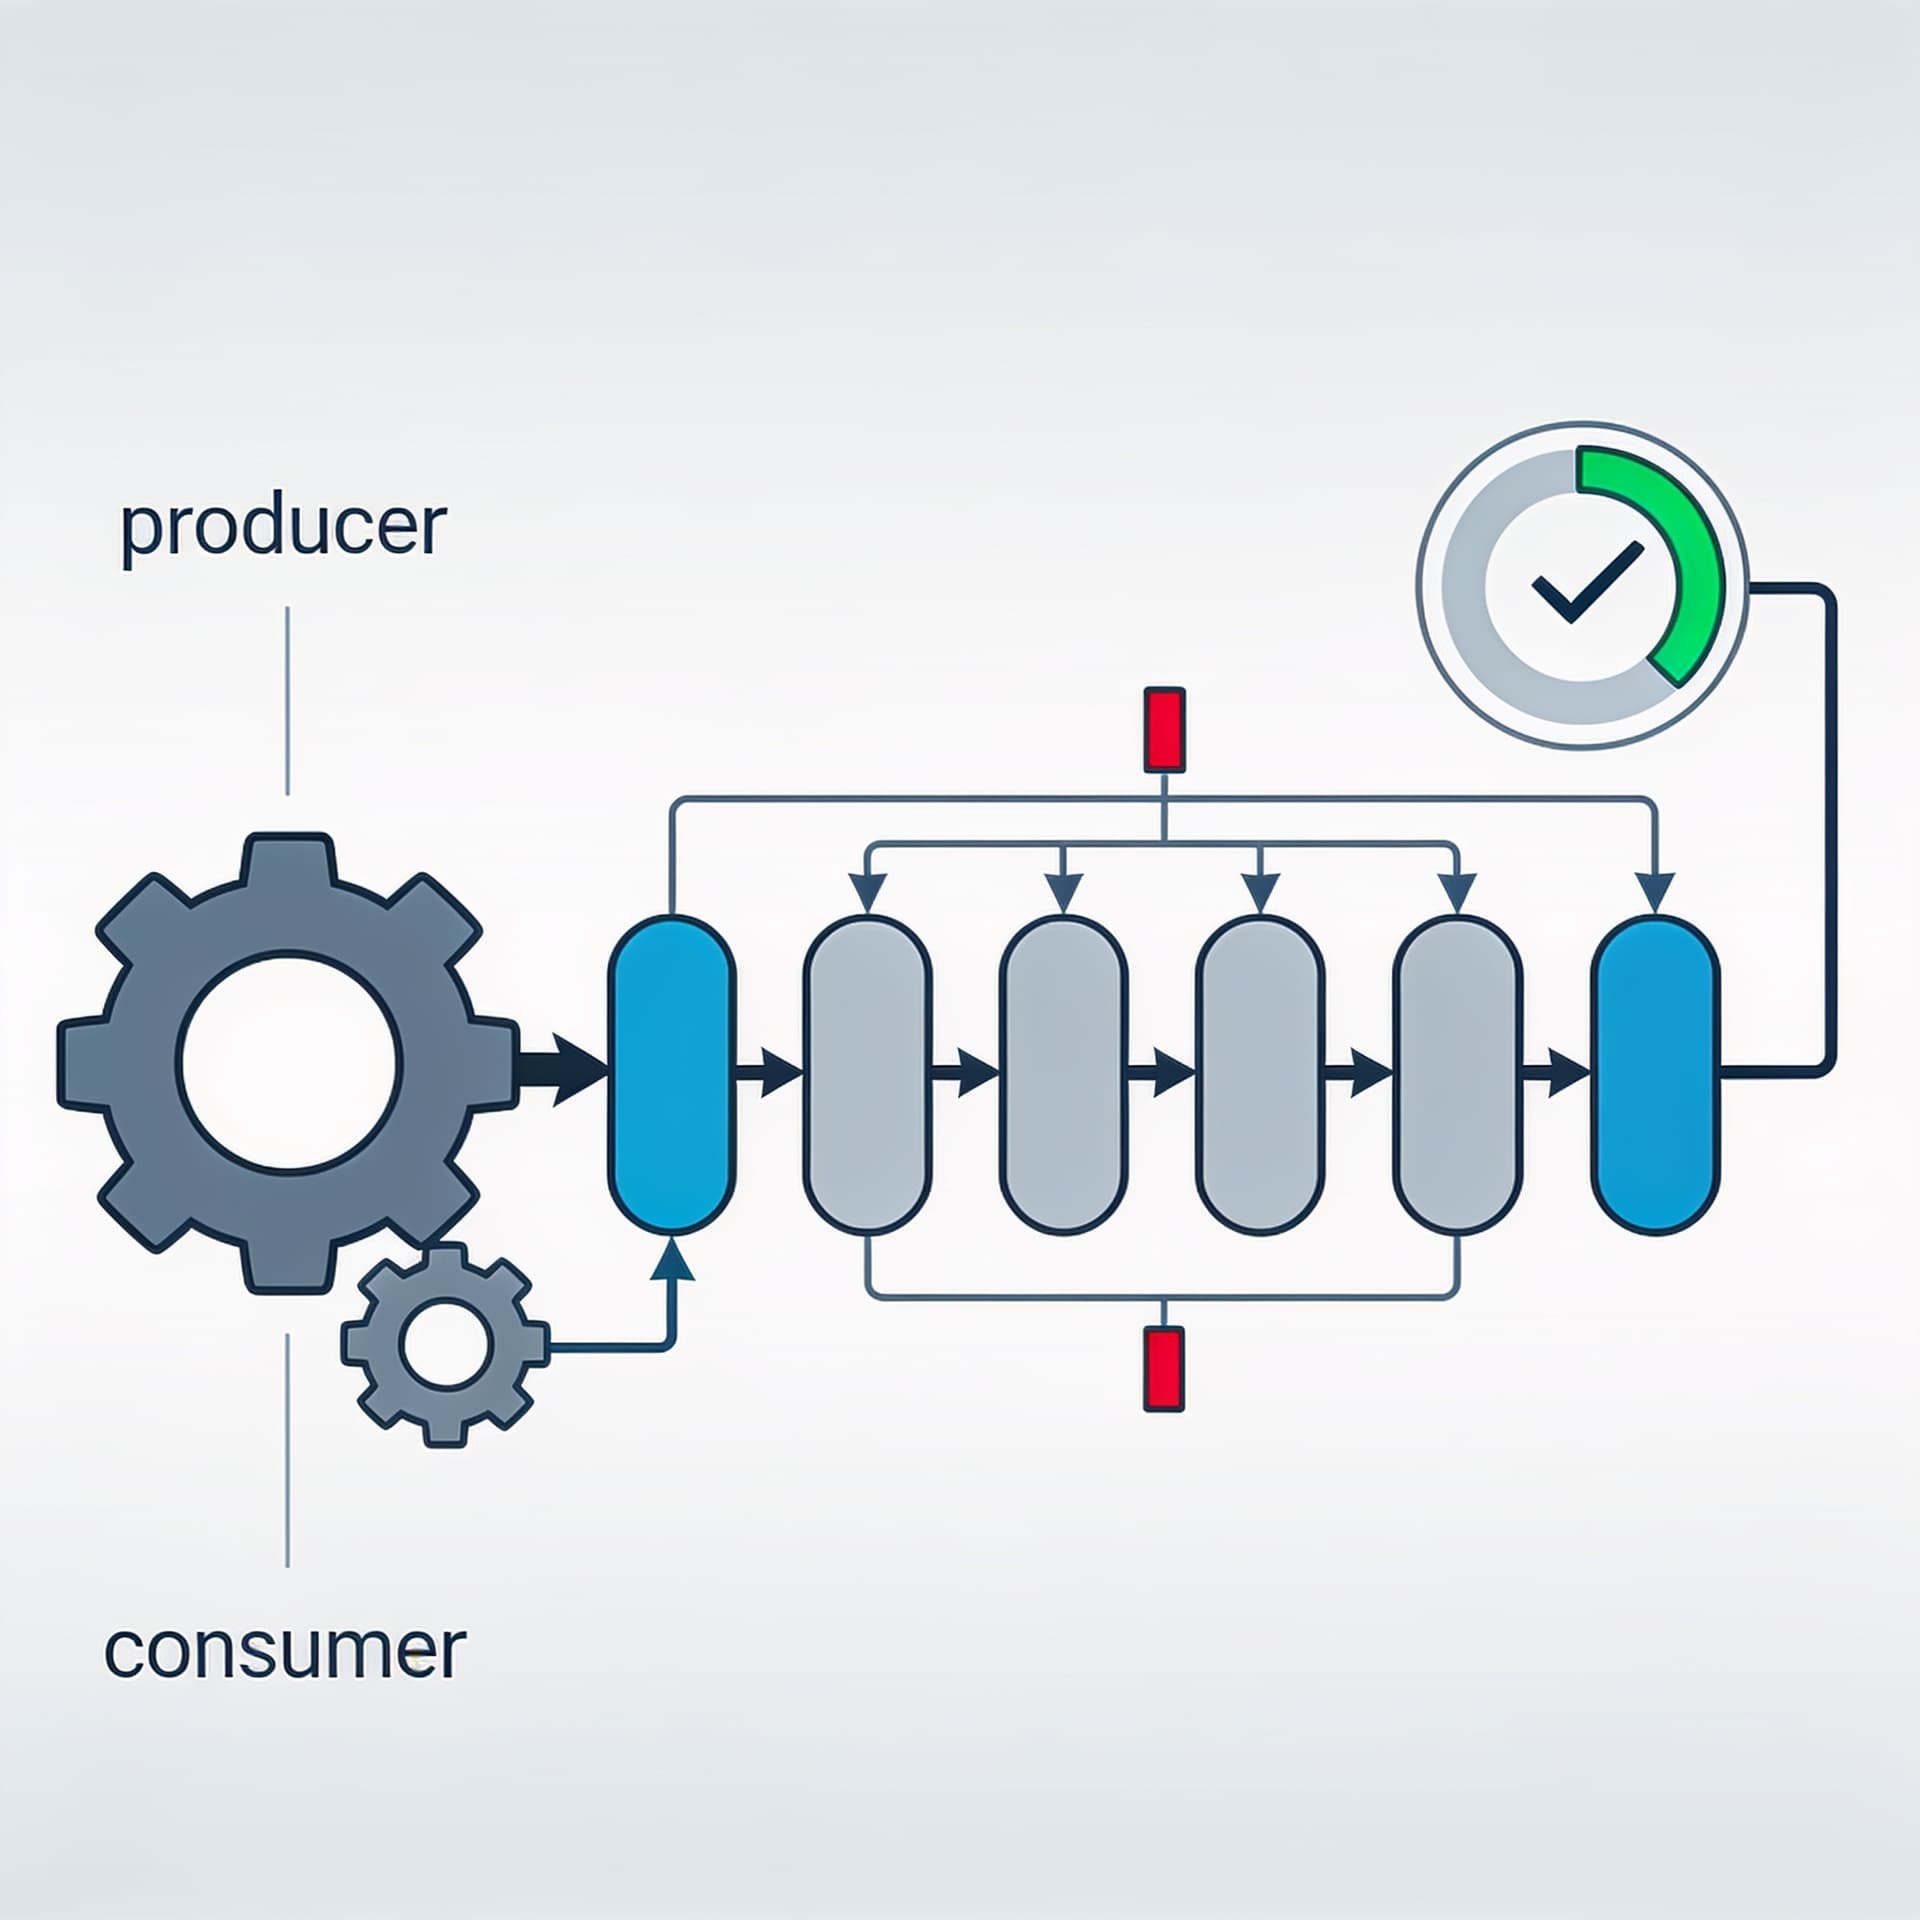
Async-очереди — один из самых популярных способов организовать конвейеры обработки: producer складывает задачи, consumer их обрабатывает. Но если не задать границы, такая модель превращается в «склад», который рано или поздно заполняет RAM. Если задать границы правильно — можно удерживать стабильность по памяти и задержке даже при пиках.
Ниже — практический разбор того, как выбирать размеры очередей, где ставить ограничители, как реагировать на переполнение, и как корректно завершать фоновые задачи. Будем говорить об общих паттернах (producer–consumer, ограниченные очереди, отмена/дренаж) и о конкретных подходах, которые применимы в разных async-стэках. В конце — честные рекомендации по построению отказоустойчивой схемы и один органичный совет, где можно глубже разобраться: курс.
Почему «async + очередь» не спасает от перегрузки
Асинхронность сама по себе не гарантирует устойчивость. Она лишь позволяет не блокировать поток/ивент-цикл на ожидании. Очередь же обычно скрывает проблему: producer может продолжать класть сообщения, пока очередь не закончится. Если очередь не ограничена — она будет расти, пока не упадёт процесс из-за памяти, либо пока GC не начнёт «съедать» CPU, либо пока не начнут отказывать внешние компоненты.
Есть два частых сценария, которые маскируют проблему:
-
Пиковая нагрузка на producer
Producer получает запросы быстрее, чем consumer успевает обработать. Очередь начинает раздуваться. -
Непредсказуемая задержка в consumer
Например, downstream (БД/HTTP/gRPC) стал отвечать медленнее из‑за временных проблем. consumer начинает отставать, и очередь начинает расти «по инерции».
Чтобы не убить сервис, нужно:
- ограничить накопление (размер/ёмкость очереди);
- применить backpressure (сигнал producer’у, что пора замедлиться);
- определить политику при переполнении (что делать с задачами);
- корректно завершать фоновые воркеры, чтобы не оставлять «висящие» задачи и не терять целостность.
Базовый паттерн producer–consumer с ограничением
Очередь как буфер с конечной ёмкостью
В идеале модель должна быть такой: очередь фиксированной ёмкости становится контрактом между скоростью поступления и скоростью обработки. Вся система рассчитывается с учётом того, что buffer не бесконечен.
Типичный контракт:
- producer кладёт задачу;
- если очередь свободна — задача принимается;
- если очередь заполнена — применяется backpressure или политика переполнения.
В асинхронных средах это обычно реализуется ограниченной очередью (bounded queue), где put либо блокируется (ожидает место), либо сразу возвращает ошибку/исключение в зависимости от реализации.
Пример на Python (asyncio): bounded queue + потребители
Покажем каркас. Он не привязан к конкретной инфраструктуре, но отражает суть:
import asyncio
import contextlib
from dataclasses import dataclass
from typing import Optional

@dataclass
class Job:
    job_id: str
    payload: str

async def worker(name: str, queue: asyncio.Queue[Job], stop: asyncio.Event):
    while True:
        if stop.is_set() and queue.empty():
            return

        try:
            job = await asyncio.wait_for(queue.get(), timeout=0.5)
        except asyncio.TimeoutError:
            continue

        try:
            # Основная обработка
            await asyncio.sleep(0.05)  # имитация IO
        finally:
            queue.task_done()

async def main():
    capacity = 1000
    queue: asyncio.Queue[Job] = asyncio.Queue(maxsize=capacity)
    stop = asyncio.Event()

    workers = [asyncio.create_task(worker(f"w{i}", queue, stop)) for i in range(4)]

    async def producer(n: int):
        for i in range(n):
            job = Job(job_id=str(i), payload="data")

            # Вариант 1: producer ждёт места в очереди (backpressure через ожидание)
            await queue.put(job)

    prod_task = asyncio.create_task(producer(5000))

    await prod_task
    # Инициируем завершение: дождаться обработки оставшегося
    stop.set()

    await queue.join()  # ждём task_done для всех обработанных
    for t in workers:
        t.cancel()
        with contextlib.suppress(asyncio.CancelledError):
            await t

asyncio.run(main())
Ключевые моменты:
maxsizeзадаёт границу накопления.await queue.put(job)демонстрирует «жёсткий» backpressure: producer замедляется, пока нет места.queue.task_done()иqueue.join()— корректное ожидание дренажа очереди при завершении.
В других языках/фреймворках аналогичные идеи реализуются через ограниченные каналы/очереди и механизмы отмены.
Backpressure: где он должен появляться в системе
Backpressure бывает разных типов
Backpressure — это не одно действие, а набор решений на разных границах системы:
-
Синхронный backpressure (producer ждёт)
Producer не может записать в очередь — он блокируется/ожидает. Это просто, но влияет на время ответа клиентам и может накапливать задержки на внешнем уровне. -
Асинхронный backpressure (producer получает сигнал)
Например, producer может возвращать пользователю «сервис перегружен», ставить задачу в другой механизм, или планировать retry. -
Dropping/backpressure на уровне политики
Пример: «последнее сообщение важнее всех предыдущих» или «не критичные события можно выбросить». Тогда вместо ожидания используется ограничение с drop. -
Rate limiting/Token bucket
Часто полезно ограничить не только буфер, но и скорость поступления до того, как данные попадут в очередь. Иначе вы начнёте «тушить» пожары ожиданием, а ресурсы всё равно будут потребляться.
Где ставить ограничители
Практически полезное правило: ограничители должны стоять на тех участках, где появляется нелинейное накопление.
-
У границы ingress → очередь
Если вы принимаете запросы и превращаете их в задачи, именно там должен быть bounded buffer или ограничение скорости. Иначе backlog переедет дальше по стеку. -
У границы между разными стадиями конвейера
Если pipeline состоит из нескольких очередей (например, parse → enrich → persist), то ограничивать нужно каждую стадию или как минимум ключевой буфер между стадиями. Одна очередь без ограничений «распакует» нагрузку в следующую часть. -
У внешних вызовов downstream
Иногда consumer «залипает» на IO: не только скорость важна, но и контроль параллелизма к БД/HTTP. Даже при корректной очереди без лимита конкуренции вы получите лавинообразные таймауты.
Разница между «ограничить очередь» и «ограничить работу»
Очередь ограничивает количество задач, но не всегда — стоимость задач. Если в очереди задачи разной тяжести, одна «тяжёлая» задача может заблокировать общий прогресс.
Поэтому в продакшене часто добавляют:
- сегментацию очередей по типу/стоимости;
- отдельные воркеры и лимиты на дорогие операции;
- или хотя бы измерение и нормирование времени обработки для принятия решений о переполнении.
Как выбирать размер очереди (и почему «побольше» — плохая идея)
Очередь — это не запас на случай; это инструмент управления задержкой
Размер очереди N определяет:
- максимальную задержку ожидания при пике (в среднем зависит от нагрузки и числа consumer’ов);
- максимальную память/ресурсы, которые вы готовы выделить под backlog;
- насколько быстро вы заметите проблемы (чем меньше очередь, тем быстрее сработает backpressure и станет видно, что система не справляется).
Если вы ставите очередь огромной, вы покупаете задержку вместо отказа. Это может быть допустимо для не критичных задач, но для запросов, которые должны отвечать быстро, огромная очередь просто превращает проблему в UX/SLI-катастрофу.
Математика на уровне здравого смысла
Упрощённо оцените:
λ— входящая интенсивность задач (jobs/s) в пике;μ— эффективная скорость обработки одним воркером (jobs/s);k— число consumer’ов.
Тогда системная производительность ≈ k * μ. Если λ > k * μ, очередь будет расти, пока не сработает ограничение или не начнётся drop/отказ.
Если λ < k * μ но бывают пики на короткое время, очередь помогает сгладить кратковременные всплески.
Практический подход:
- Определите целевой потолок задержки ожидания
T_target(например, «в среднем не более 200 мс», «никогда не более 2 сек»). - Приблизительно оцените среднюю скорость обработки в этот момент.
- Переведите в объём:
N ≈ (λ_peak - λ_avg) * T_target(в упрощении).
Точная формула зависит от распределений и числа воркеров, но смысл такой: очередь должна покрывать разницу на нужный интервал, а не бесконечно.
Учитывайте стоимость задач и размер payload
Чтобы оценить память, важно знать не только N, но и:
- средний размер
Job(включая ссылки/буферы); - накладные расходы на метаданные;
- удержание payload в памяти до обработки (например, если задача содержит весь документ, а не только ключ).
Если payload крупный, то даже N=1000 может быть слишком много. Тогда стоит:
- хранить крупные данные в хранилище (S3/Blob/DB) и класть в очередь только ссылку/ID;
- добавлять компрессию/серилизацию с контролем размера;
- снижать maxsize или вводить separate queues.
Отдельный нюанс: время обработки может быть распределено
Если обработка имеет тяжёлые хвосты (p95/p99 сильно больше p50), то очередь «застревает» сильнее, чем ожидается. Поэтому оценку μ лучше брать по консервативным метрикам:
μ_effпо p95 времени обработки (условно:1 / time_p95);- или добавлять запас.
Реакция на переполнение: пять рабочих политик
Когда очередь заполнена, у вас есть несколько вариантов. Выбор зависит от типа задач и требований к доставке.
1) Блокировать producer (ждать места)
Плюсы:
- простая модель;
- задания не теряются;
- естественная backpressure.
Минусы:
- возрастает время ответа клиентам на ingress;
- при синхронных ожиданиях в web-слое можно получить каскадное истощение (вся web-пул потоков начинает ждать очереди);
- можно усилить тайм-ауты upstream.
Когда подходит:
Когда входящие запросы могут ждать (например, внутренние batch-команды) и когда важно не терять работу.
2) Отказывать/возвращать ошибку (fail fast)
Плюсы:
- быстрый сигнал системам-поставщикам;
- меньше накопление.
Минусы:
- часть задач теряется, если поставщик не умеет retry;
- нужно определить контракт ошибки (что считать retryable).
Когда подходит:
Когда сервис должен сохранять SLA по latency и внешняя система умеет повторять.
3) Drop с приоритетом (выкинуть низкоприоритетное)
Плюсы:
- защищает ресурсы;
- сохраняет важное.
Минусы:
- нужна семантика приоритетов;
- риск несогласованности при выбрасывании ключевых событий.
Когда подходит:
Например, при обработке событий телеметрии/аналитики, когда важна «приблизительная актуальность».
4) Drop «старьё» или «последнее выигрывает»
Плюсы:
- стабильно по памяти;
- хорошо для сценариев «состояние» вместо «история».
Минусы:
- не подойдёт для транзакционной работы (команды должны быть выполнены по порядку).
Когда подходит:
UI-снимки, обновления конфигураций, кеш-валидность.
5) Вынести в долговременную очередь (spillover)
Иногда лучше не отказываться, а переключаться на внешнюю устойчивую очередь/хранилище: дисковая очередь, Kafka, SQS, DLQ и т.п.
Плюсы:
- сохраняется доставка при длительных перегрузках;
- можно разгружать RAM.
Минусы:
- усложнение архитектуры;
- рост стоимости и задержки из-за второй очереди.
Когда подходит:
Когда критично не терять задачи и при этом внутренний буфер должен быть защищён.
Где ставить обработчик переполнения: не «где получится», а где есть контракт
Самая частая ошибка — надеяться, что очередь сама «спасёт». Но спасёт только то место, где вы принимаете решение при переполнении.
Хороший практический ориентир:
- решение о переполнении должно быть в точке, которая знает семантику задачи и контракт с caller’ом (например, REST endpoint).
- если ваша архитектура конвейерная, то переполнение может случиться на каждой границе — и решения там тоже разные (где-то можно ждать, где-то нужно drop).
Пример: drop с метрикой вместо блокировки
В Python это можно приблизить так: попытаться put_nowait, а при ошибке — выполнить политику. Встроенная реализация зависит от фреймворка, но идея универсальна.
import asyncio
import logging

log = logging.getLogger(__name__)

async def producer_with_drop(queue: asyncio.Queue, job, on_drop):
    try:
        queue.put_nowait(job)  # не ждём
    except asyncio.QueueFull:
        await on_drop(job)
        log.warning("Queue full, dropped job_id=%s", getattr(job, "job_id", None))
on_drop может:
- записать в DLQ;
- увеличить счётчик метрик;
- отправить в альтернативную обработку.
Корректное завершение фоновых задач: как не оставить «полумёртвый» сервис
Перезапуск, масштабирование и деплой — это неизбежная часть жизни сервиса. Если при завершении воркеры обрываются без дренажа, вы получаете:
- потери задач;
- дубли (если producer будет retry);
- зависания (если join/cancel сделаны неверно);
- неконсистентность, если задача должна быть выполнена атомарно.
Семантика завершения: три фазы
Практически удобно разделить остановку на этапы:
-
Stop accepting new work
Прекратить ingress новых задач (или перестать создавать новые job в очереди). -
Drain queue
Дать воркерам дообработать то, что уже в очереди. -
Stop workers with timeout
После окончания ожидания — отменить воркеры, если они не завершились. Лучше завершать с таймаутом, чтобы процесс не висел бесконечно.
Два подхода к остановке воркеров
-
По сигналу + проверка очереди
В воркере естьstop_event, и он завершает цикл, когда stop включён и очередь пуста (пример выше). -
Передать “sentinel” (ядовитые пилюли)
Добавить в очередь специальные маркеры, которые воркеры обработают и выйдут.
Sentinel-подход хорош, когда вы точно знаете число consumer’ов и не хотите тратить CPU на polling.
Пример с sentinel и ограничением на ожидание
import asyncio
import contextlib

SENTINEL = object()

async def worker(queue: asyncio.Queue, wid: int):
    while True:
        item = await queue.get()
        try:
            if item is SENTINEL:
                return
            await asyncio.sleep(0.05)  # обработка
        finally:
            queue.task_done()

async def shutdown(queue: asyncio.Queue, workers, timeout=5):
    # 1) стоп новых задач — это на уровне ingress, здесь лишь пример
    # 2) отправляем sentinel’ы
    for _ in workers:
        await queue.put(SENTINEL)

    # 3) ждём, пока воркеры обработают
    try:
        await asyncio.wait_for(queue.join(), timeout=timeout)
    finally:
        for t in workers:
            t.cancel()
            with contextlib.suppress(asyncio.CancelledError):
                await t
Важный момент: sentinel’ы увеличивают количество элементов в очереди. Поэтому sentinel должен быть частью логики ёмкости и завершения. Если queue maxsize слишком мал, вы можете сами не иметь возможности добавить sentinel’ы — тогда остановка тоже будет сломана. Вывод: ограниченная очередь требует продуманного shutdown.
Отмена vs обработка: уважайте идемпотентность
Если воркер отменяется во время обработки задачи, поведение зависит от того, обработ