Планирование оптимизаций: почему ваше узкое место — не тот слой (CPU, IO, сеть, БД)
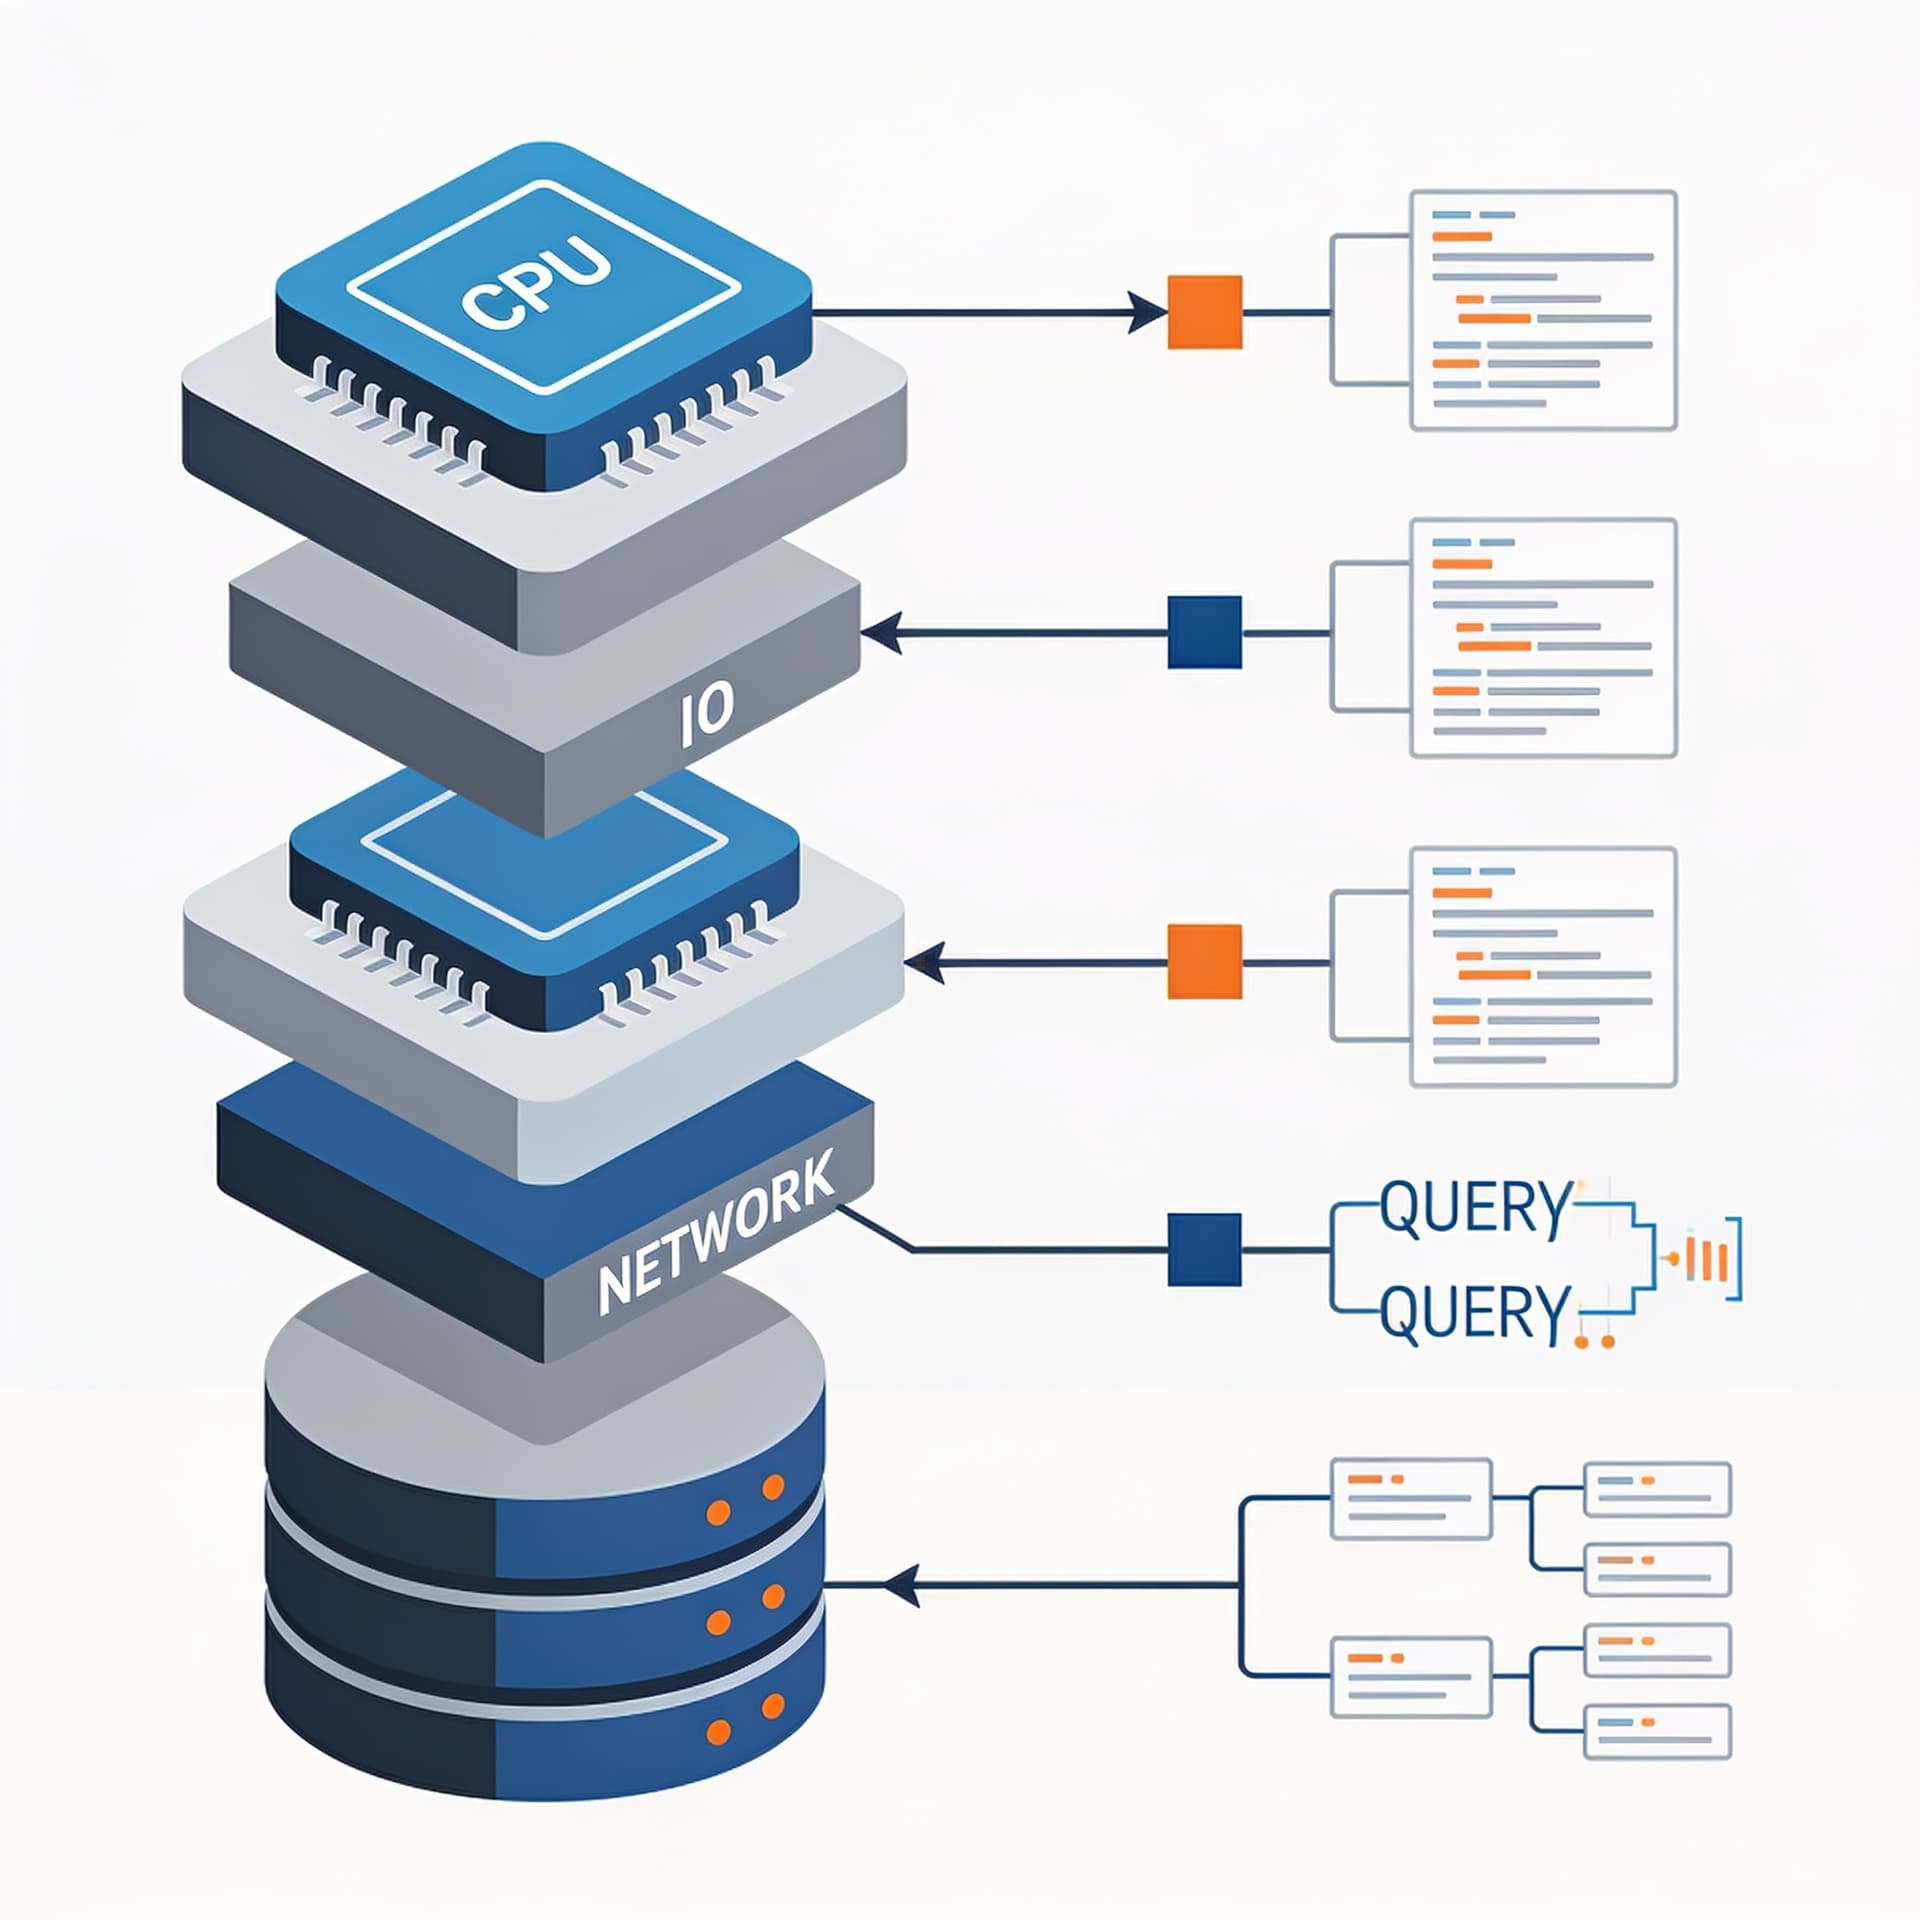
На чек-листе научимся диагностировать проблему по профилированию и метрикам: от логов и трейсинга до планов запросов.
Содержание
Оптимизация системы почти никогда не начинается с «докрутим параметр X». Начинается она с ответа на простой вопрос: где именно теряется время и почему. Проблема в том, что в современных приложениях задержки распределены по стеку — CPU, диску (IO), сети, очередям, БД и даже в самой логике приложения. И почти всегда команда оптимизирует не то место: ускоряет CPU, когда узкое место — блокировка на диске; добавляет индексы, когда причина — сетевые таймауты; переписывает запрос, когда проблема — в пуле соединений или в неоптимальной сериализации данных.
В этой статье разберём планирование оптимизаций как дисциплину: от гипотезы к измерению, от измерения к подтверждению. На чек-листе научимся диагностировать проблему по профилированию и метрикам — от логов и трейсинга до планов запросов — и отдельно разберём, как отличить «симптомы» от «узких мест».
Когда кажется, что узкое место в одном слое, а на деле — в другом
Типичный сценарий выглядит так:
- Пользователи жалуются на медленные ответы.
- Логи показывают «долгие запросы к БД».
- На CPU всё выглядит не так уж плохо, сеть тоже не выглядит катастрофической.
- Вывод: «надо оптимизировать БД/запросы».
Но это слишком линейная картина. В реальности задержка может приходить «снаружи»:
- Блокировки в БД могут быть вызваны тем, что приложение держит транзакции дольше из‑за ожидания данных на IO.
- Долгие запросы могут быть не из‑за SQL, а из‑за насыщения пула соединений: запросы стоят в очереди, и время «запроса» увеличивается, хотя сам SQL выполняется быстро.
- Время ответа может «накапливаться» на сетевом уровне, а в приложении это проявляется как долгий HTTP/DB call.
- CPU может быть не главным ограничением, но всё равно выглядеть «высоким», если есть активное спин-ожидание, частые сериализации, GC/аллокатор или частые ретраи.
Именно поэтому оптимизации нужно планировать так, чтобы проверять предположения последовательно и измеримо.
С чего начать: сбор контекста и постановка гипотез
Прежде чем запускать профайлер или копаться в планах запросов, ответьте на вопросы, которые сильно экономят время:
Какие пользователи и операции затронуты?
Разделите нагрузку на:
- endpoints/handlers,
- типы операций (чтение/запись, search, checkout, autocomplete),
- tenant/пользовательские сегменты,
- регионы (если у вас геораспределение),
- типы данных (например, «длинные» записи).
Это нужно, чтобы понять: узкое место одно на весь сервис или ограничено конкретным маршрутом.
Как выглядит проблема: latency, throughput или errors?
- Если падает throughput при том же latency — может быть блокировка/очереди/ограничение ресурсов.
- Если latency растёт при том же throughput — возможно, вы попали в насыщение какого-то звена.
- Если растут errors/таймауты — тогда узкое место может быть в сети, пуле, ретраях или в лимитах upstream.
Нужен «срез» по времени
Убедитесь, что вы понимаете, когда началось ухудшение: после релиза, после изменения конфигурации, после нагрузки, после сбоя инфраструктуры (DNS, балансировщик, диски, node pressure).
Практически это означает: смотрите метрики вокруг события и ищите корреляции.
Чек-лист диагностики по слоям: как выявить настоящее узкое место
Ниже — практичный чек-лист, который помогает быстро отсеять неверные гипотезы. Он не заменяет профиль и дебаг, но задаёт правильный порядок действий.
Шаг 1. Сначала — распределение задержек, а не среднее
Среднее время ответа часто «маскирует» проблему. Смотрите:
- p50/p90/p95/p99 latency,
- длительность отдельных стадий (DB call, внешние HTTP, сериализация, очереди),
- размер очередей (например, consumer lag),
- количество таймаутов и ретраев.
Сигналы:
- Рост p99 при стабильном p50 часто указывает на редкие сбои (GC, сетевые задержки, lock contention, периодические паузы, всплески нагрузки на БД).
- Рост p90/p95 вместе с CPU и ростом контекстных переключений — вероятно, CPU/планировщик/GC.
- Рост p90 вместе с увеличением очередей на уровне приложения — почти наверняка ожидание (пул, блокировки, IO).
Шаг 2. Логи: корреляция «время началось/время закончилось»
Логи полезны, если вы умеете читать их правильно:
- ищите разницу между временем запроса и временем выполнения (если есть отдельные поля),
- отделяйте «время ожидания в очереди» от «время обработки»,
- смотрите на таймауты, ошибки подключения, повторные попытки.
Хорошая практика: в логах иметь request_id/trace_id и фиксировать длительность ключевых участков.
Частая ошибка: смотреть только на «долгий SQL» как на причину. На практике SQL может быть быстрым, но запрос ждал доступ к соединению или ждал освобождения блокировки.
Шаг 3. Трейсинг (OpenTelemetry, Jaeger, Zipkin): разложение по span’ам
Трейсинг отвечает на вопрос «куда ушло время» на уровне транзакции.
Минимальный набор для диагностики:
- span для входящего запроса,
- span для каждого внешнего вызова (HTTP/gRPC),
- span для БД (включая ожидание, если инструмент позволяет),
- span для операций очередей/воркеров.
Что проверять:
- где растёт «сам span»,
- где растёт «waiting/queueing» (если есть),
- какие зависимости доминируют по длительности.
Если вы видите, что доминирует span «DB query», но в БД нет соответствующего роста CPU/IO — это повод проверить пул соединений, транзакции, блокировки и сетевые задержки до БД.
Шаг 4. Метрики приложения: пул, очереди, GC, thread contention
На стороне приложения обычно есть то, что напрямую указывает на узкое место:
- размер пула соединений к БД и процент «в ожидании»,
- время ожидания в acquire/borrow (если есть метрики),
- количество активных потоков/горутин и их время ожидания,
- GC (частота и длительность пауз),
- метрики времени на сериализацию/десериализацию,
- размер внутренних очередей (например, для асинхронных задач).
Типичная находка:
- DB pool saturation → рост latency без роста CPU в приложении, и «DB call» выглядит долгим (потому что он включает waiting за соединение).
Шаг 5. CPU: не просто «процент», а контекст и профилирование
Высокий CPU — не всегда узкое место. Важно понять:
- сколько CPU тратится на полезную работу,
- насколько много времени на ожидание (системные вызовы, блокировки),
- есть ли горячие функции/аллоки/GC pressure.
Используйте:
- sampling profiler (py-spy, pprof, async-profiler, perf),
- инструментирование hot paths,
- анализ аллокаций (в языках с GC).
Показатели:
- если CPU высок, а throughput не растёт — возможны бесконечные циклы, ретраи, lock contention;
- если CPU низкий, но latency высокий — вероятно, ожидание IO/сети/блокировок/очередей.
Шаг 6. IO (диск): latency по операциям и время ожидания syscalls
На уровне хоста/контейнера смотрите:
- iowait (если релевантно),
- latency диска (blk latency),
- throughput диска,
- метрики файловой системы (если сервис пишет логи/файлы),
- page cache, dirty pages (для некоторых сценариев).
Но важно: в приложении это может проявляться не как «IO wait растёт», а как:
- рост времени чтения/записи (системные метрики),
- рост задержек при загрузке ресурсов,
- рост времени на создание/парсинг больших файлов.
Подводный камень: если вы используете сеть и диск как отдельные сущности (например, S3/Blob storage), IO на диске может быть не проблемой — проблема в задержках внешнего хранилища.
Шаг 7. Сеть: RTT, потери пакетов, DNS, TLS, балансировщик
Для сети важны не «сетевые графики вообще», а конкретные признаки:
- рост времени на connect/handshake (TLS),
- рост ретраев,
- таймауты на уровне клиента,
- ошибки DNS resolution (NXDOMAIN, SERVFAIL),
- разрывы соединений и повторные handshakes.
Проверки:
- пинги/трассировка (traceroute) редко дают точный диагноз в микросервисах, лучше ориентироваться на наблюдаемость:
- netstat/ss для состояний сокетов,
- метрики клиента (время resolve/connect/write/read),
- packet loss (на уровне инфраструктуры, если доступно).
Сигнал: рост «вызовов к внешним сервисам» при отсутствии роста на БД/CPU часто означает сеть или upstream.
Шаг 8. БД: отличайте время выполнения SQL от времени ожидания
БД — не только «планы запросов». Вы должны различать:
- CPU/IO в самой БД,
- ожидания блокировок,
- ожидания ресурсов,
- очереди на уровне соединений,
- contention на конкретных объектах (таблицы/индексы).
Сначала посмотрите общие метрики БД:
- active sessions,
- lock waits,
- cache hit ratio,
- IO read/write latency,
- репликация (если используется),
- изменения в схеме/статистика.
Затем — конкретный запрос:
- план (EXPLAIN / EXPLAIN ANALYZE),
- оценка vs фактические ряды,
- использование индексов,
- операции sort/hash/merge,
- влияние параметров (план-параметры, bind values).
Типовые «ложные победы»: как команды оптимизируют не тот слой
Ложная победа №1: «Мы увеличили пул — значит стало лучше»
Увеличение пула соединений к БД может:
- снизить ожидание acquire,
- но усилить нагрузку на БД и тем самым сделать latency хуже на p99.
Если БД уже на пределе по lock/IO, «в очереди было меньше» — может смениться на «запросы стали ждать блокировок дольше» или «пошла деградация по реплике».
Ложная победа №2: «Сделаем кэш»
Кэш помогает, но не если узкое место — IO на БД, lock contention или сеть между сервисами. Иногда кэш лишь уменьшает число запросов, но добавляет:
- задержку на сериализацию ключей,
- сетевой вызов к Redis,
- проблемы с консистентностью/инвалидацией.
Диагностика должна показать, что выигрывает именно критическая стадия.
Ложная победа №3: «Профилировщик показал, что горячая функция — X»
Профилирование без корреляции с трассами часто приводит к оптимизации CPU, когда на самом деле узкое место — ожидание. Например, вы оптимизировали сериализацию, а задержка растёт из‑за медленных запросов к БД и очередей на соединения.
Поэтому порядок: трейсинг → метрики узких мест → профайлинг внутри ограниченного этапа.
Практика: мини-схема расследования по наблюдаемости
Представим, что вы анализируете инцидент «сервис стал отвечать дольше».
1) Начните с трасс: где увеличилась длительность
Вы смотрите верхнеуровневые span’ы:
- Handler: 120ms → 600ms
- DB span: 20ms → 500ms
- HTTP upstream: 10ms → 20ms
- Serialization: 5ms → 5ms
Вопрос: DB span включает только выполнение SQL или ещё и waiting? Если инструментизация включает время waiting в acquire — это критично.
2) Смотрите метрики пула и очередей
Если pool_wait увеличился с 0 до 450ms — узкое место в коннект-синхронизации. Следующий шаг: понять причину насыщения пула:
- утечки соединений (не освобождаются),
- слишком долгие транзакции,
- слишком высокая параллельность в рамках одного сервиса,
- ошибочная повторная попытка запроса при временных ошибках.
3) Только затем — EXPLAIN ANALYZE и анализ запросов
Если pool_wait не растёт, а «сам SQL» вырос — смотрите план. Если же SQL «быстрый», а длительность определяется ожиданием блокировок/IO в БД — приоритизируйте lock/IO диагностику.
Код и примеры: как извлечь планы запросов и связать их с профилированием
Ниже — несколько практических техник, которые часто применяются при расследовании.
Пример 1: PostgreSQL — EXPLAIN ANALYZE для подтверждения гипотезы по индексу
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT *
FROM orders
WHERE customer_id = $1
  AND created_at >= $2
ORDER BY created_at DESC
LIMIT 50;
Что смотреть в выводе:
Index ScanvsSeq Scan- количество
rows(estimated vs actual) Sort Methodи размер сортировкиBuffers: shared hit/read— если read растёт, возможно, нет нужного индекса/кэшаPlanning Timeобычно мало влияет на p99, но помогает понять, не происходит ли слишком много тяжёлого планирования
Если вы видите Seq Scan при миллионах строк — гипотеза «индекс поможет» может быть верной. Но важно: если Seq Scan выполняется быстро из-за лимитов или малого набора — индекса может и не понадобиться.
Пример 2: быстро собрать профилирование горячих мест (Python)
Допустим, вы подозреваете CPU. Сsampling профайлером можно быстро увидеть, где уходит время, но всегда сверяйте с трассами.
py-spy top --pid <PID> --rate 100
Или сохранить снапшот:
py-spy record -o profile.svg --pid <PID>
Дальше сопоставляете: если hot function — парсинг JSON, а трасс показывает, что задержка растёт в DB span, то оптимизация парсинга может не решить проблему.
Пример 3: собрать timing по этапам на приложении (общее правило)
Для диагностики полезно фиксировать длительность стадий. Например, в псевдокоде:
const start = Date.now();

const dbStart = Date.now();
const rows = await db.query(sql, params);
const dbTime = Date.now() - dbStart;

const handlerTime = Date.now() - start;

logger.info({
  trace_id: traceId,
  handler_time_ms: handlerTime,
  db_time_ms: dbTime,
});
Если handler_time вырос, а db_time нет — проблема не в БД. Если db_time вырос — дальше нужно понять, включает ли он waiting (очередь пула) или только execution.
Как планировать оптимизации: от гипотезы к измеримому эффекту
Оптимизации без планирования обычно превращаются в набор «ручных правок». Чтобы избежать хаоса, следуйте логике:
1) Для каждого слоя сформируйте проверяемую гипотезу
Пример формата:
- Гипотеза A (пул): latency выросла из-за насыщения соединений; waiting_time увеличился.
- Гипотеза B (БД): конкретный запрос деградировал; EXPLAIN показывает рост actual rows, смену плана или рост IO read.
- Гипотеза C (сеть): выросли connect/read в клиенте; появились таймауты TLS/HTTP.
2) Определите метрику успеха на уровне SLO/сигнала
Не «стало быстрее», а, например:
- p95 latency для endpoint X снизить на 30% за 1-2 релиза,
- уменьшить pool_wait на 80%,
- снизить lock wait time в БД,
- уменьшить количество ретраев/таймаутов.
3) Ограничьте поверхность изменений
Если вы параллельно:
- меняете индексы,
- пересобираете сервис,
- меняете конфиг пула,
- включаете кэш, то вы не сможете понять, что именно дало эффект.
Оптимизация должна быть итеративной: одно изменение — один наблюдаемый эффект (или хотя бы одна доминирующая гипотеза).
4) Учитывайте стоимость
Оптимизация одного слоя может перенести нагрузку в другой:
- индекс ускоряет выборку, но замедляет запись и увеличивает размер.
- увеличение параллелизма ускоряет throughput, но усиливает contention.
- кэш снижает нагрузку на БД, но добавляет сеть и инвалидацию.
От логов и трейсинга к планам запросов: единая картина стека
В хорошем расследовании у вас есть «мост» между уровнями:
- Логи/трейсы показывают, где растёт время (в span).
- Метрики приложения