Производительность FastAPI: от медленных сериализаций до правильных типов ответов
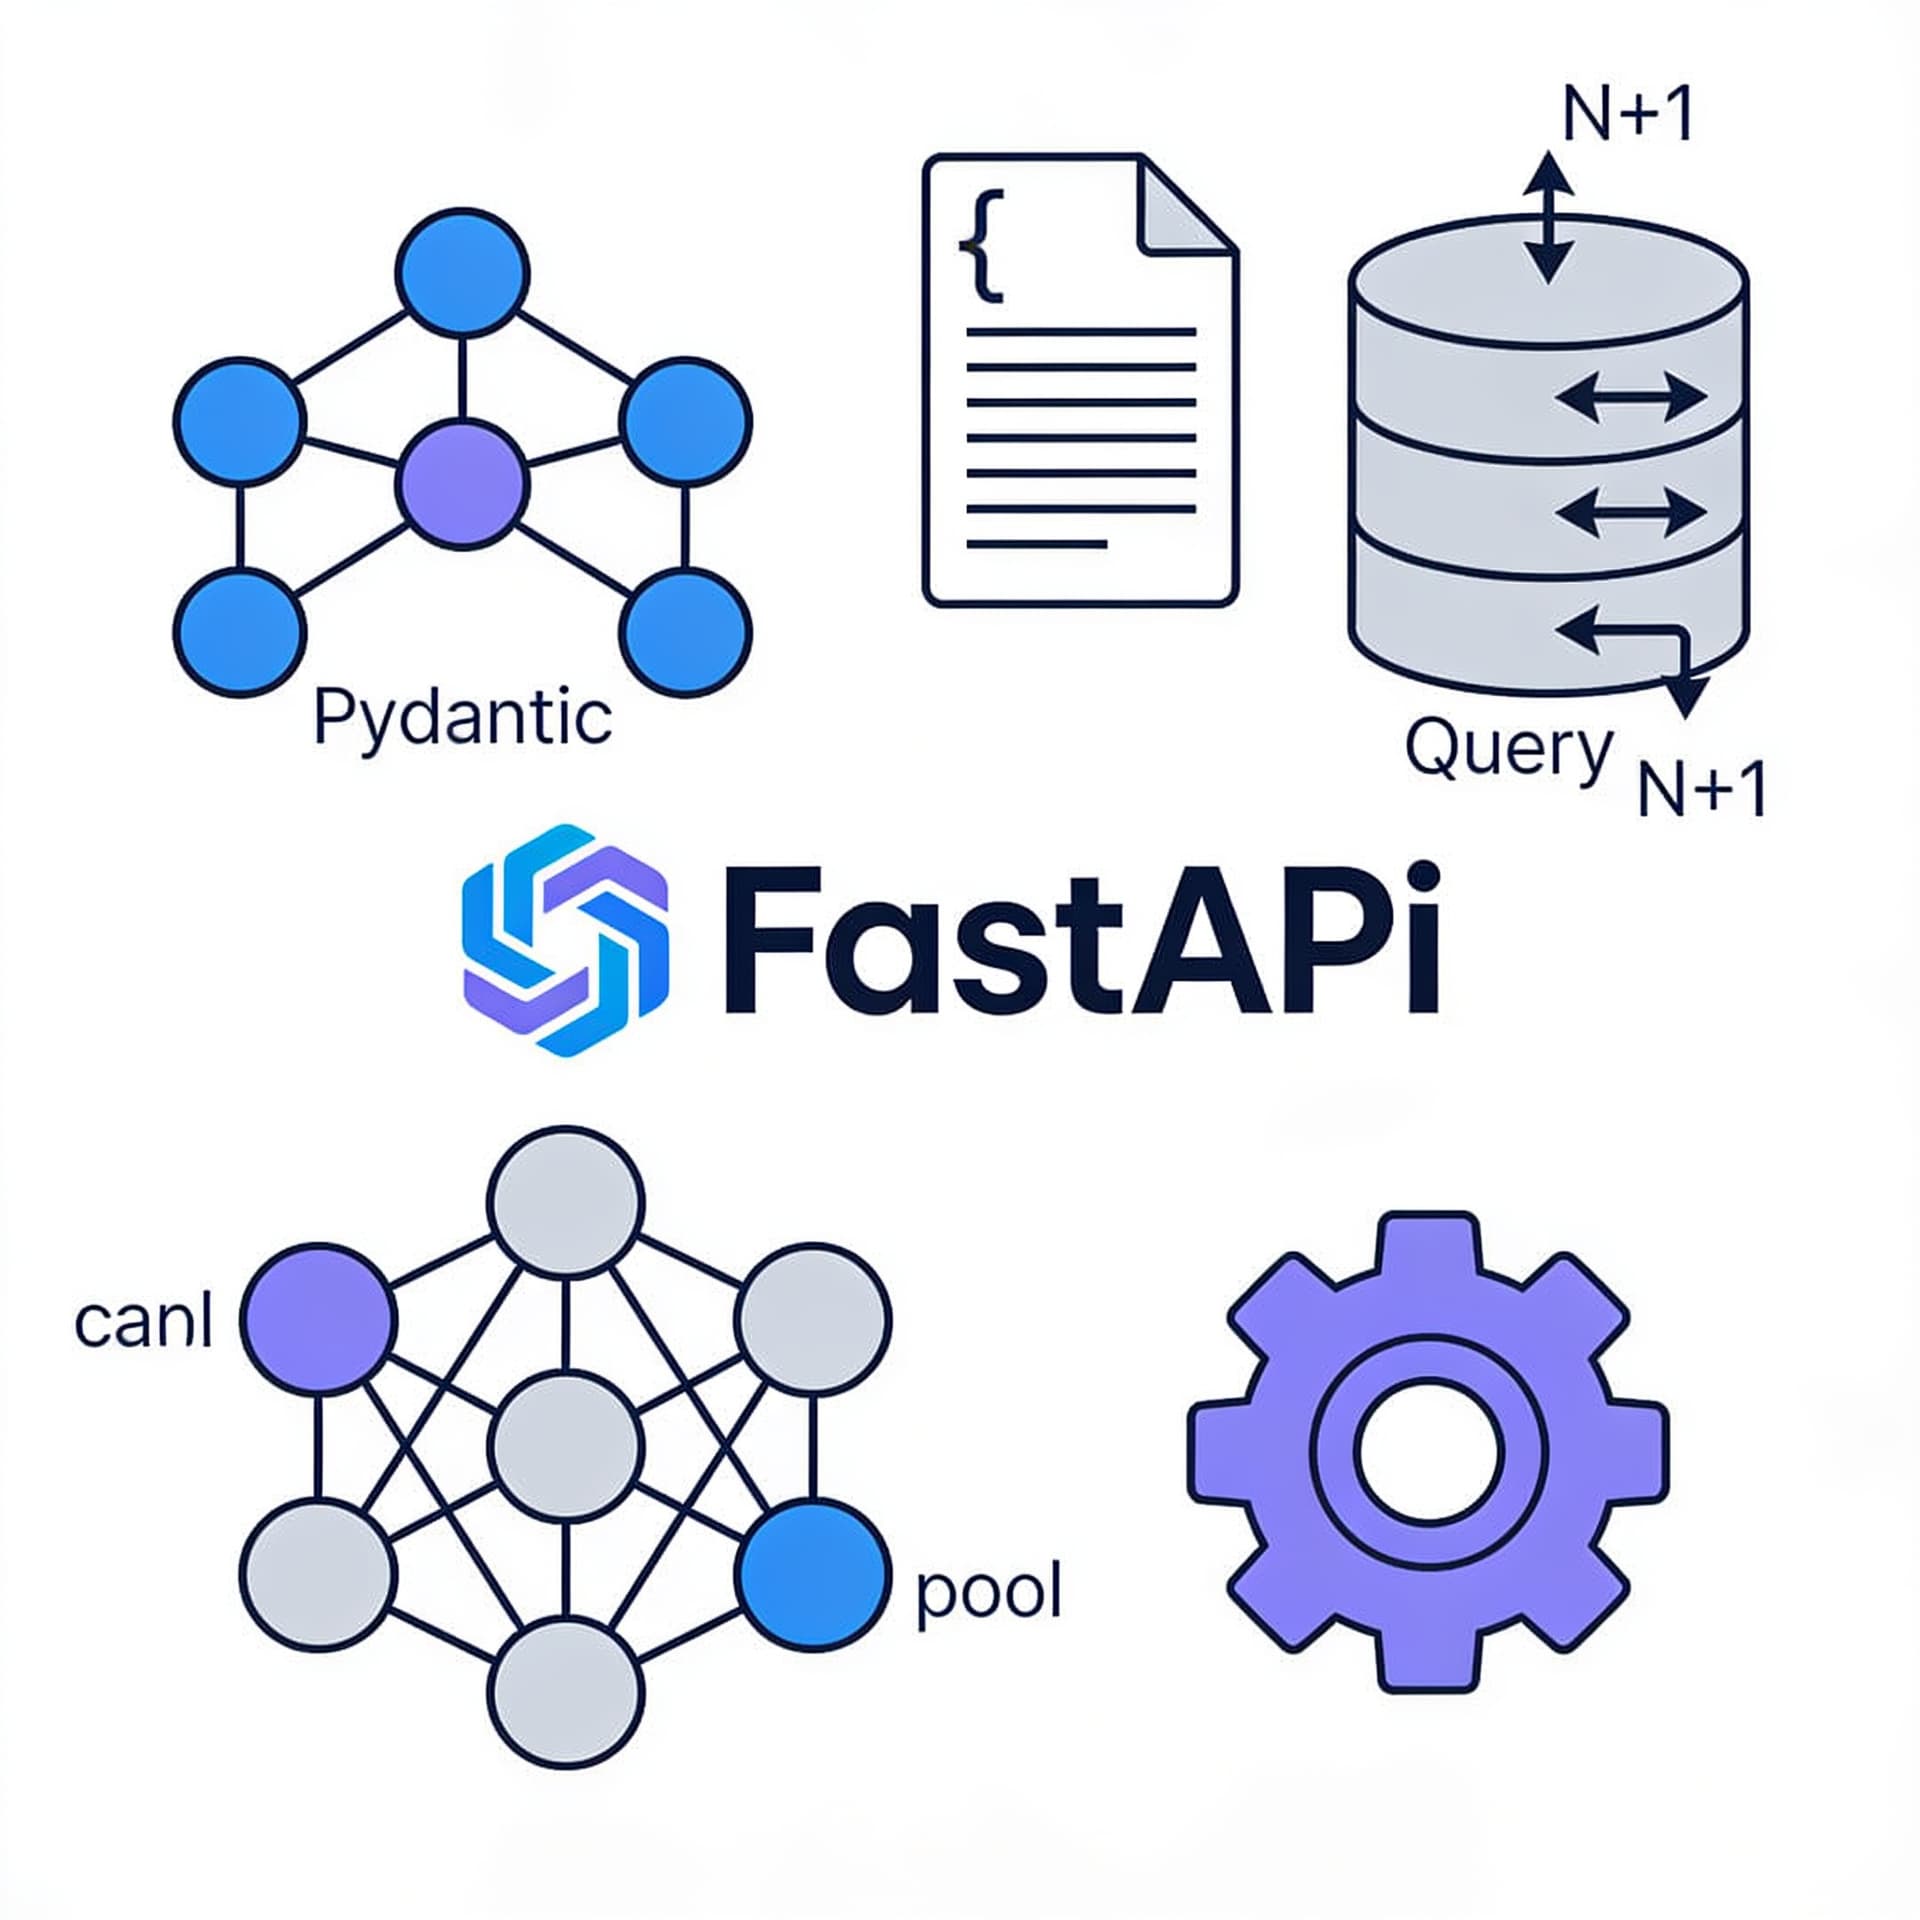
Разберём, где теряется время в веб-приложении: Pydantic, JSON-обвязка, N+1, пул соединений и настройки сервера.
Содержание
FastAPI часто воспринимают как «быстрый фреймворк», и в целом это справедливо: он построен на Starlette и ASGI, а значительная часть пути обработки запроса — на стороне Python-кода и механизмов сериализации. Но в реальных сервисах скорость легко деградирует по причинам, которые не имеют отношения к «выбранному фреймворку». На практике узкие места почти всегда находятся в одном из слоёв:
- сериализация и валидация на Pydantic;
- JSON-обвязка и форматирование ответов;
- проблемы модели доступа к данным (N+1 запросов);
- работа с БД: пул соединений, настройки транзакций, тип драйвера;
- серверная часть: настройки Uvicorn/Gunicorn/worker’ов, ограничение конкуренции, keep-alive.
В этой статье разберём, как системно найти причину замедления и что делать, чтобы FastAPI-сервис перестал терять время на «лишнюю работу». Будем говорить не общими фразами, а о конкретных механизмах: что именно делает Pydantic, почему иногда «хороший» код становится медленным, как правильно выбирать типы ответов и как настроить инфраструктуру.
1) Где реально тратится время в FastAPI
1.1 Разделим обработку запроса на этапы
Чтобы не гадать, полезно мысленно разложить обработку запроса:
- ASGI слой принимает запрос.
- Зависимости FastAPI выполняют подготовку данных (dependency injection).
- Request body парсится (если есть).
- Валидация входных данных и построение моделей Pydantic.
- Ваш обработчик выполняет бизнес-логику: запросы к БД/внешним сервисам.
- Результат оборачивается в модель ответа и сериализуется в JSON.
- Тело ответа кодируется и отправляется клиенту.
Когда сервис медленный «в целом», обычно виноваты этапы 5–6 (данные и сериализация). Но бывает и серверная часть: неправильное число worker’ов, слишком маленький пул, отсутствие лимитов на конкурентность.
1.2 Быстрый способ диагностики: измеряйте по стадиям
В Python без профилировщика легко «улететь» в предположения. Рекомендуемый минимум:
- логировать длительность эндпоинта целиком;
- отдельно замерять время запроса к БД и время сериализации ответа (если есть возможность);
- использовать системный профайлер для подтверждения (например,
py-spyилиyappi).
Для практического ориентира: если большая часть времени уходит на CPU и JSON/валидацию — оптимизировать надо именно их. Если время уходит на ожидание I/O (БД/HTTP) — ищите N+1, пул, таймауты, индексацию и конкуренцию.
2) Сериализация Pydantic: почему «модели» могут быть медленными
2.1 Pydantic строит и валидирует, даже когда это не нужно
У Pydantic есть две связанные, но разные задачи:
- валидация: проверка входных данных (и построение модели);
- сериализация: преобразование модели в словарь/JSON.
На выходе FastAPI обычно сериализует объект ответа. Если вы возвращаете Pydantic-модель, она уже построена, но сериализация и проход по структуре всё равно требует времени. Если же вы возвращаете «сырой» dict со сложными вложенными объектами, FastAPI может начать преобразования и/или валидацию по схеме ответа (в зависимости от того, как вы объявили response_model).
Типовая ошибка: объявить response_model=HugeModel и возвращать большой граф объектов (списки вложенных моделей, дополнительные вычисления). Даже если бизнес-логика быстрая, сериализация становится доминирующей.
2.2 Слишком большие ответы и лишние поля
Чем больше данных, тем выше цена:
- больше обходов по структуре;
- больше памяти и аллокаций;
- больше работы JSON кодировщика.
Проверьте:
- реальные поля, которые клиенту нужны;
- возможность выделить «лёгкий» эндпоинт с меньшим набором полей;
- использование
exclude/includeна уровне сериализации (или на уровне модели черезmodel_config).
Например, в Pydantic v2 можно уменьшить данные так:
from pydantic import BaseModel, ConfigDict

class UserOut(BaseModel):
    id: int
    email: str
    # тяжёлые/неиспользуемые поля можно исключить по умолчанию

    model_config = ConfigDict(
        ser_json_exclude_none=True,
    )
А дальше — аккуратно выбирать, что именно сериализовать.
2.3 response_model и «двойная работа»
Очень распространённый сценарий:
- вы вручную строите Pydantic-объект в эндпоинте;
- одновременно объявляете
response_model, и FastAPI снова пытается привести/проверить ответ.
В идеале ответ должен либо уже соответствовать модели, либо быть «сырой» структурой, которую FastAPI быстро обернёт один раз. На практике легко получить двойной проход.
Совет: если вы уже возвращаете корректный объект Pydantic и не хотите повторной проверки, добивайтесь согласованности схем. В ряде случаев — возвращайте модель и убирайте response_model (или используйте явный тип возврата), но это зависит от вашего стиля и требований к документации.
2.4 Нюанс Pydantic v2: сериализация может быть быстрее, но есть ловушки
Pydantic v2 улучшил производительность, но «быстрее» ≠ «бесплатно». Ловушки обычно такие:
- вложенные модели, каждая из которых требует сериализации;
- поля с пользовательскими сериализаторами (
field_serializer/model_serializer) — иногда они удобны, но часто добавляют Python-код в горячий путь; - принудительное преобразование типов (например,
Decimalи даты) в каждый ответ.
Если вы видите в профиле долю времени именно в сериализаторе — оптимизируйте схемы (и, по возможности, переносите преобразования ближе к источнику данных).
3) JSON-обвязка: почему «просто JSON» тоже стоит денег
3.1 Кодировщик JSON и размер документа
Даже если сериализация моделей оптимизирована, остаётся этап:
- кодирование в JSON строку;
- отправка по сети.
У JSON есть минимум работы по:
- экранированию;
- преобразованию типов (особенно нестандартных);
- формированию строк.
Если вы возвращаете большие массивы или поля с большой вложенностью, скорость начнёт упираться в CPU и в аллокации.
Практический подход:
- уменьшайте объём ответа (см. предыдущий раздел);
- рассматривайте пагинацию;
- избегайте сериализации «полного объекта» для списка, где нужен только summary.
3.2 Streaming и когда он действительно нужен
Если ответ большой (например, выгрузка), «держать всё в памяти» не всегда разумно. Тогда лучше использовать streaming: StreamingResponse или отправку чанками.
Пример для сценария «объёмный JSON» (упрощённо):
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import json
from typing import Iterable

app = FastAPI()

def iter_users() -> Iterable[dict]:
    # генератор данных (идеально — из БД постранично)
    for i in range(10_000):
        yield {"id": i, "name": f"user{i}"}

@app.get("/users/stream")
def users_stream():
    def gen():
        yield "["
        first = True
        for item in iter_users():
            if not first:
                yield ","
            else:
                first = False
            yield json.dumps(item, ensure_ascii=False)
        yield "]"

    return StreamingResponse(gen(), media_type="application/json; charset=utf-8")
Streaming — не «ускоритель любой ценой», но он:
- снижает пиковое потребление памяти;
- иногда помогает начать отдавать клиенту раньше.
Но важно: сериализация всё равно занимает время; просто вы не заставляете сервис сначала построить огромную строку.
4) N+1 и данные: самая частая причина «медленного FastAPI»
4.1 Что такое N+1 в API-контексте
N+1 — это паттерн, когда:
- вы выполняете 1 запрос, чтобы получить список сущностей (N),
- а затем делаете N дополнительных запросов, чтобы получить связанные данные.
Для веба это почти идеальный рецепт медленного ответа: даже при быстрых запросах к БД количество round-trip’ов растёт линейно.
Пример: список пользователей и их адреса. Если код выглядит как «получить пользователей — для каждого запросить адрес», то получите N+1.
4.2 Как диагностировать N+1
Диагностировать можно несколькими путями:
- включить логирование запросов к БД и посмотреть количество запросов на один HTTP-запрос;
- использовать профилировщик, который покажет много одинаковых вызовов репозитория;
- проверить профилирование на уровне SQL: если на запрос уходит сотни запросов — это оно.
4.3 Как исправлять: eager loading, join, батчи
В зависимости от ORM (SQLAlchemy/asyncpg, Tortoise, Django ORM и т.д.) методы отличаются, но идеи одинаковы:
- eager loading: загрузить связи заранее одним (или небольшим числом) запросов;
- join: получать данные плоско и затем маппить;
- батчинг: вместо N отдельных запросов делать запросы вида
WHERE id IN (...).
В SQLAlchemy (пример концептуальный, без привязки к конкретной схеме):
from sqlalchemy import select
from sqlalchemy.orm import joinedload

# предположим: User -> addresses (один ко многим)
stmt = (
    select(User)
    .options(joinedload(User.addresses))
)
Смысл: заменить N запросов на 1 (или несколько контролируемых).
5) Пул соединений и работа с БД/HTTP-клиентами
5.1 Пул — это не просто «чтобы быстрее»
Пул соединений регулирует:
- количество одновременных соединений к БД;
- ожидание при нехватке соединений;
- нагрузку на БД (и её возможность обслуживать конкурентные запросы).
Если пул слишком мал, запросы к БД будут стоять в очереди — API будет медленным, даже если SQL быстрый.
Если пул слишком велик, вы рискуете:
- перегрузить БД;
- получить рост латентности из-за контеншна;
- упереться в лимиты сервера или сети.
5.2 Признаки проблем с пулом
Типовые симптомы:
- в профиле много времени уходит на await в драйвере БД, но SQL сам по себе быстрый;
- растёт время ответа при увеличении нагрузки (а не только средняя задержка);
- сервер показывает «пилу» по времени: запросы иногда быстрые, иногда очередь.
5.3 Async-драйверы: важно, что вы используете
В FastAPI с async-эндпоинтами вы обычно используете async-драйверы (asyncpg, SQLAlchemy async, etc.). Если где-то проскакивает синхронная БД/блокирующие вызовы — вы «блокируете» event loop и получаете каскад задержек.
Поэтому:
- следите, чтобы I/O были async;
- не выполняйте тяжёлую работу в event loop (расчёты выносите в воркеры/фоновые потоки).
5.4 Таймауты и ретраи: осторожно
Слишком агрессивные таймауты приводят к лишним ошибкам и ретраям (которые сами по себе создают нагрузку). Слишком большие — замораживают ресурсы и увеличивают среднюю задержку.
Для производительности лучше:
- нормализовать таймауты на уровне клиента и сервера;
- предусмотреть circuit breaker или хотя бы ограничение ретраев.
6) Правильные типы ответов в FastAPI: меньше преобразований — меньше времени
6.1 Зачем вообще говорить о типах ответов
Потому что в FastAPI типы напрямую влияют на то, как фреймворк сериализует данные, как валидирует их под response_model и какие преобразования выполняет.
Например:
dictи простые типы: сериализация предсказуемая.- Pydantic-модели: сериализация обычно тоже предсказуемая, но зависит от размера и настроек.
Response/JSONResponseс уже готовым JSON: меньше работы, если вы действительно контролируете сериализацию.bytes/StreamingResponse: другой путь обработки.
6.2 Когда выгодно возвращать Response, а не модель
Если вы по какой-то причине уже подготовили JSON (например, кешированный ответ в виде строки), можно вернуть готовое тело через Response или JSONResponse.
Пример: кеш на стороне приложения хранит готовый JSON:
from fastapi import FastAPI, Response
import orjson

app = FastAPI()

@app.get("/cached")
async def cached():
    # допустим, этот JSON вы получили из кеша как строку/байты
    data = {"ok": True, "items": list(range(100))}
    body = orjson.dumps(data)  # bytes

    return Response(content=body, media_type="application/json")
Это убирает лишний проход «модель -> dict -> json string», оставляя только тот вариант, который вы контролируете.
Важно: это имеет смысл только если у вас действительно есть основание не использовать обычный механизм сериализации. Иначе вы просто дублируете работу.
6.3 Custom JSON: где оптимизация может быть реальной
FastAPI/Starlette используют стандартный json.dumps через Starlette JSONResponse. Для части систем можно переключить сериализацию на более быстрые библиотеки (например, orjson). Но в этом месте важно не создать несовместимость по форматам.
Один из подходов — глобально настроить класс ответа или возвращать готовые bytes (см. предыдущий пример). Это даёт максимальный контроль и минимизирует сюрпризы.
7) Настройки сервера: Uvicorn/Gunicorn, workers, concurrency
7.1 Почему серверные настройки влияют на «FastAPI скорость»
Даже идеальная оптимизация кода может не дать эффекта, если:
- выбран неправильный режим запуска;
- слишком мало workers;
- неправильно выставлена очередь соединений;
- event loop перегружен CPU-bound задачами.
FastAPI как ASGI-приложение обслуживает множество конкурентных запросов в рамках event loop, но CPU-bound участки всё равно будут тормозить.
7.2 Uvicorn: основные параметры, которые стоит проверить
Обычно смотрят на:
--workers: количество процессов (для CPU-bound частично помогает);--limit-concurrency: ограничение числа одновременных обработок (полезно для защиты от перегрузок);--backlog: очередь входящих соединений;- keep-alive и таймауты HTTP.
Если вы видите, что при росте нагрузки latency растёт лавинообразно — вероятно, вы упираетесь не в код сериализации, а в насыщение ресурсов.
7.3 Gunicorn + Uvicorn workers
При запуске в production часто используют Gunicorn с Uvicorn workers. Тогда важно корректно подобрать:
- число worker’ов (обычно зависит от CPU и профиля нагрузки);
- настройки timeout’ов;
- модель логики (preload, reload — аккуратно).
Ключевой принцип: подбирайте worker’ы под реальные узкие места. Если у вас чистый I/O, иногда лучше больше конкуренции в одном процессе. Если же много сериализации/валидации/CPU-работы — больше процессов может помочь.
8) Системный чек-лист производительности: от гипотез к исправлениям
8.1 Сначала — измерьте и выделите доминирующую стадию
Без профилирования вы рискуете оптимизировать не то. Сделайте порядок:
- Снять метрики: p50/p95/p99 latency, error rate, throughput.
- На уровне APM/логов понять распределение времени: app time vs DB time.
- При необходимости — локальный профайлинг эндпоинта под нагрузкой.
8.2 Типовые «быстрые победы»
- Уменьшить размер ответа: пагинация, exclude полей, отдельные схемы для списка.
- Убрать N+1: eager loading/join/batch.
- Проверить пул: не хватает соединений или, наоборот, перегружаем БД.
- Убедиться, что нет синхронного блокирующего I/O внутри async.
- Рассмотреть streaming для очень больших ответов.
8.3 Неочевидные проблемы, которые встречаются регулярно
- Пользовательские сериализаторы на горячем пути (медленные форматирования).
- Двойная валидация/преобразования из-за несовпадения
response_modelи возвращаемых объектов. - Отсутствие лимитов на конкуренцию: сервис начинает «сам себя душить».
- Недостаточное количество worker’ов/неудачная конфигурация очередей.
- Отсутствие таймаутов: один зависший внешний сервис «забивает» ресурсы.
9) Практический пример: как поменять модель ответа и сократить время
Рассмотрим условный кейс: эндпоинт возвращает список сущностей, а схема ответа включает поля, которые вычисляются на лету или содержат вложенные модели.
9.1 Было: большая схема и вложенные модели
from fastapi import FastAPI
from pydantic import BaseModel
from typing import List

app = FastAPI()

class ItemOut(BaseModel):
    id: int