FastAPI и фоновые задачи: когда лучше использовать BackgroundTasks, а когда очередь
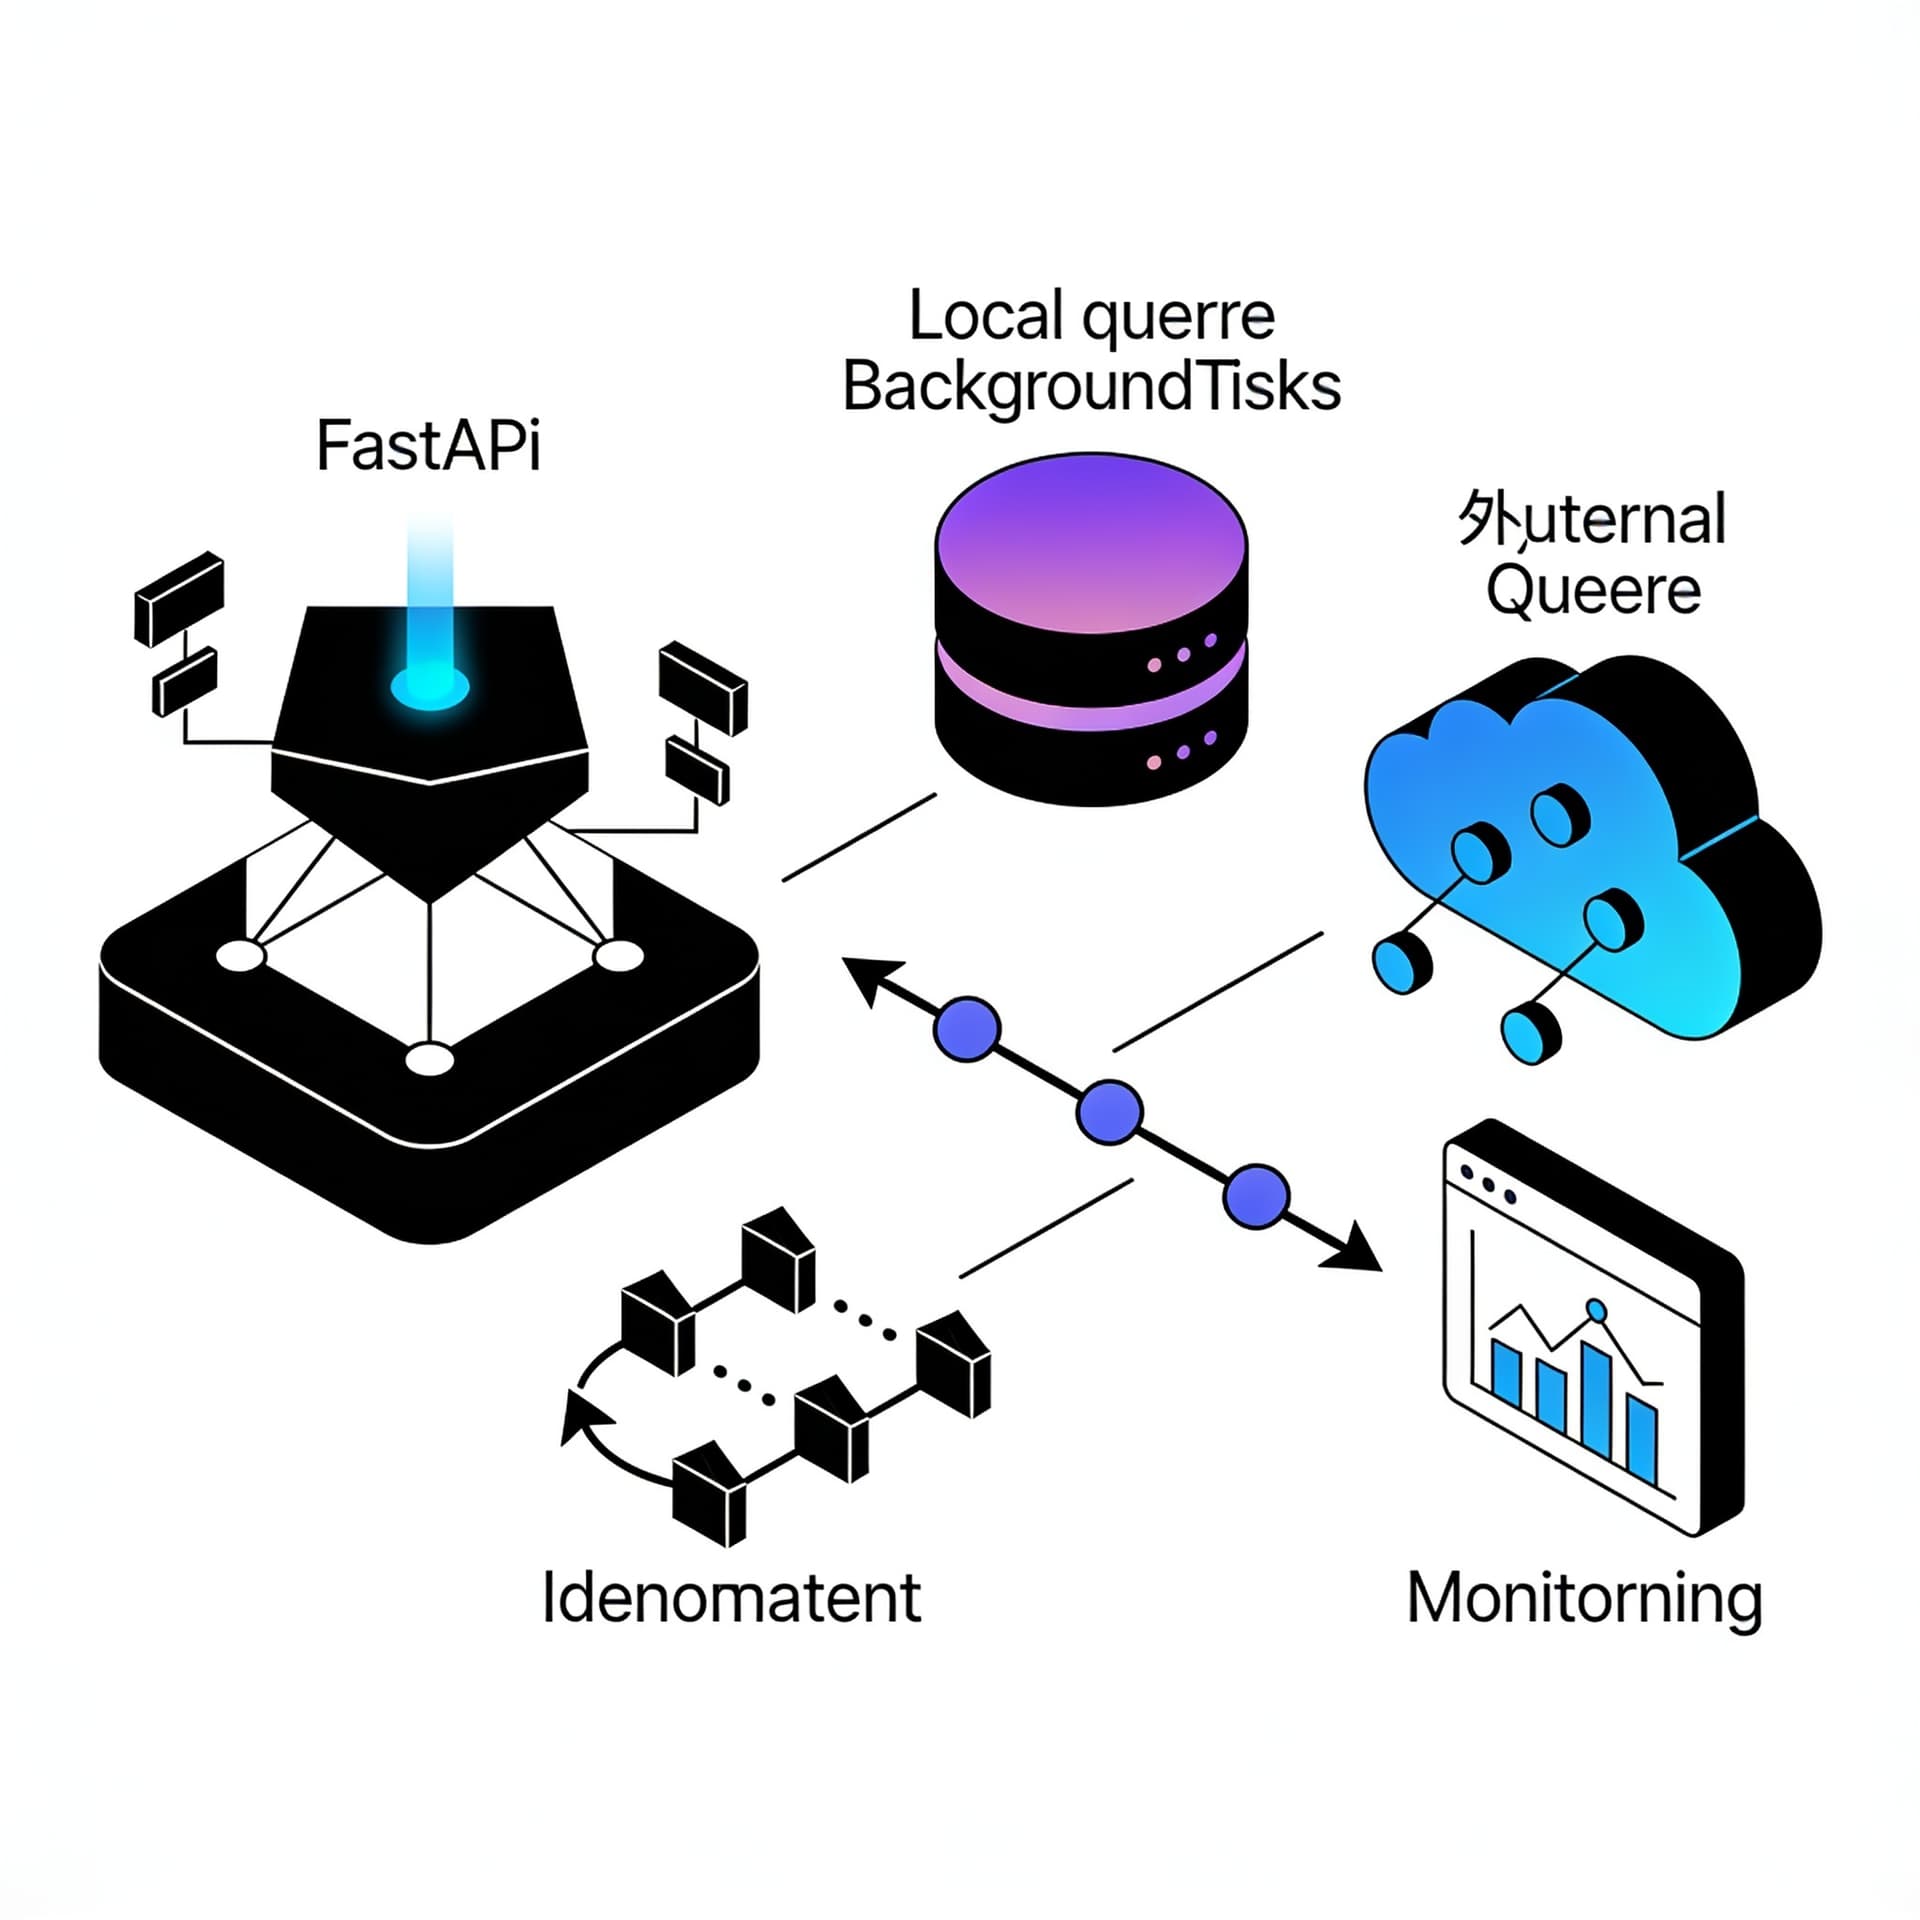
Поймём различия между синхронной обработкой, BackgroundTasks и внешними очередями. Разберём idempotency, ретраи и мониторинг фоновых процессов.
Содержание
Фоновые задачи в веб-приложениях — это не «магия, чтобы ускорить ответ», а инженерное решение с конкретными ограничениями. В FastAPI есть несколько путей: встроенный механизм BackgroundTasks, запуск отдельных процессов/воркеров на той же машине, и (самый надёжный в проде) — внешние очереди с системой ретраев, мониторинга и идемпотентности.
Цель этой статьи — разложить по полочкам различия между синхронной обработкой, BackgroundTasks и внешними очередями, а также показать, как правильно думать об idempotency, retry и наблюдаемости (monitoring). Примеры будут на FastAPI и Python, но выводы универсальны для большинства фреймворков.
1. Три модели обработки: синхронно, BackgroundTasks и очередь
1.1 Синхронная обработка: «ответ только после всего»
Самая простая модель — обработать запрос полностью внутри обработчика и вернуть ответ в конце. Это означает:
- клиент получает результат только после завершения всей работы;
- транзакции и ошибки проще: всё в одном контуре;
- но падает latency: долгие операции удерживают воркер сервера (например, Uvicorn/Gunicorn worker).
Синхронный вариант подходит, если фон — это максимум «несколько десятков миллисекунд» и нет риска таймаутов.
Типичный пример: запись в БД, небольшая вычислительная логика, быстрая валидация.
1.2 BackgroundTasks: «вернём ответ, а остальное сделаем после»
BackgroundTasks в FastAPI — это механизм, который планирует выполнение функции после отправки ответа клиенту. Важно понимать модель исполнения:
- Функция добавляется в очередь выполнения внутри того же процесса/воркера.
- Она выполняется уже после того, как HTTP-ответ подготовлен.
- Если ваш воркер перегружен, фоновые задачи будут ждать своей очереди на выполнение.
- Если процесс завершится (crash/deploy), незавершённые фоновые задачи пропадут.
BackgroundTasks удобно использовать для задач, которые:
- не критичны по надёжности (или можно повторять),
- короткие по времени,
- не требуют гарантированного «хотя бы один раз» или «строго один раз»,
- не должны выполняться независимо от HTTP-контекста.
1.3 Внешняя очередь: «долгая работа живёт отдельно от API»
Внешняя очередь (например, Celery+Redis/RabbitMQ, RQ, Dramatiq, Kafka и т.д.) делает обработку асинхронной в другой логике:
- API быстро принимает запрос, валидирует вход и кладёт задачу в брокер.
- Отдельные воркеры (consumer’ы) забирают задачи и выполняют их.
- Брокер обеспечивает буферизацию, повторную доставку (при необходимости), ретраи и т.п.
- Вы можете масштабировать воркеры независимо от API.
Это выбор, когда фоновые задачи:
- длительные,
- критичны по надёжности,
- требуют ретраев с backoff,
- должны иметь мониторинг (сколько задач в очереди, сколько ошибок, latency обработки),
- могут выполняться многократно без «двойных» эффектов (через idempotency).
2. Код: как выглядит каждый подход в FastAPI
2.1 Синхронный обработчик
from fastapi import FastAPI
import time

app = FastAPI()

@app.post("/sync")
def sync_work(payload: dict):
    # имитация долгой операции
    time.sleep(3)
    return {"status": "done", "echo": payload}
Минусы: запрос будет висеть, и клиент получит ответ только через ~3 секунды.
2.2 BackgroundTasks: ответ раньше, фон — позже (в том же воркере)
from fastapi import FastAPI, BackgroundTasks
import time

app = FastAPI()

def background_work(payload: dict):
    # в реальности здесь может быть отправка письма, запись файла, обновление кэша и т.п.
    time.sleep(3)

@app.post("/bg")
def bg_tasks(payload: dict, background_tasks: BackgroundTasks):
    background_tasks.add_task(background_work, payload)
    return {"status": "accepted"}
Ключевое замечание: это «accepted», а не «processed». Клиент не должен считать, что операция гарантированно завершилась.
2.3 Внешняя очередь (пример на Celery-стиле)
Ниже — упрощённый каркас (без подстройки под конкретный брокер), чтобы показать архитектуру.
# tasks.py
from celery import Celery

celery_app = Celery(
    "tasks",
    broker="redis://localhost:6379/0",
    backend="redis://localhost:6379/1",
)

@celery_app.task(bind=True, autoretry_for=(Exception,), retry_backoff=True, max_retries=5)
def do_heavy_work(self, payload: dict, request_id: str):
    # В реальной системе здесь должна быть идемпотентность по request_id
    # и логирование/метрики
    return {"result": f"ok for {request_id}"}
# main.py
from fastapi import FastAPI
from tasks import do_heavy_work

app = FastAPI()

@app.post("/queue")
def queue(payload: dict):
    request_id = payload.get("request_id")  # лучше формировать сервером/контрактом
    async_result = do_heavy_work.delay(payload, request_id=request_id)
    return {"status": "queued", "task_id": async_result.id}
Теперь фон живёт независимо от HTTP. API не зависит от времени выполнения. Ретраи и наблюдаемость решаются на уровне брокер/воркер/таски.
3. Главная инженерная тема: идемпотентность (idempotency)
3.1 Почему идемпотентность нужна почти всегда
Идемпотентность — это способность обработчика многократно получать один и тот же «логический запрос» и давать одинаковый результат без побочных эффектов (или с корректной дедупликацией).
Причины, почему она критична:
- ретраи почти всегда приводят к повторной обработке;
- клиент может повторить запрос из-за таймаута, а сервер уже начал выполнение;
- при очередях есть сценарии «at-least-once» (минимум один раз), когда одна задача может быть доставлена повторно;
- даже
BackgroundTasksможет привести к повторным вызовам в нестандартных сценариях (например, при реконнекте с внешней системой вы захотите повторять).
Практическая формулировка: вы должны иметь идентификатор операции (например, request_id), и хранить состояние так, чтобы повтор не дублировал записи/уведомления/выставления счетов.
3.2 Две стратегии идемпотентности
Стратегия A: idempotency key + уникальность в БД
Например, вы создаёте запись в таблице операций с уникальным ключом request_id. Если запись уже есть — возвращаете результат/статус вместо повторной работы.
Схема таблицы:
request_id(unique)status(pending/succeeded/failed)result_payload(опционально)created_at,updated_at
Пример кода (упрощённо):
from sqlalchemy import Column, String, DateTime, Enum
from sqlalchemy.dialects.postgresql import UUID
from sqlalchemy.ext.declarative import declarative_base

Base = declarative_base()

class Operation(Base):
    __tablename__ = "operations"
    request_id = Column(String, primary_key=True)  # или UUID
    status = Column(String, nullable=False, default="pending")
В воркере/фоне:
- пытаемся вставить
Operation(request_id=...); - если уникальный конфликт — значит операция уже выполнялась/выполняется;
- решаем, что делать (не выполнять, либо проверить статус и продолжить по контракту).
Стратегия B: дедупликация по внешнему ключу (например, payment_id)
Если вы взаимодействуете с внешней системой, у неё часто есть свой idempotency key или transaction id. Тогда вы можете опираться на него: повторная отправка не создаст дубликат в платёжной системе.
3.3 Где идемпотентность особенно важна
- отправка email/SMS (иначе получатель увидит дубликаты);
- операции, меняющие внешний мир: платежи, резервирование, отмена заказа;
- запись файлов с публичной ссылкой (нельзя «перезаписать» по повтору иначе, чем ожидается).
4. Ретраи (retry): как не превратить систему в генератор проблем
4.1 Типы ошибок: retryable и non-retryable
Не все ошибки одинаковы.
- Retryable: временная недоступность (500, network timeout, 429 rate limit), временные ошибки внешних сервисов.
- Non-retryable: валидационные ошибки, некорректные входные данные, 4xx от внешнего сервиса, если это «постоянная» проблема.
Ключевой принцип: ретраи должны быть управляемыми и не должны слепо повторять всё подряд.
4.2 Внешняя очередь облегчает ретраи, но не отменяет корректность
В очередях вы обычно настраиваете:
- максимальное число попыток;
- backoff (увеличение паузы между попытками);
- условия ретрая.
Но даже при «идеальных» настройках ретраи остаются частью распределённой системы: доставка может повторяться, а обработчик может завершиться частично. Значит, идемпотентность — всё равно нужна.
4.3 Ретраи в BackgroundTasks: почти всегда слабое место
BackgroundTasks не предоставляет стандартного, хорошо изолированного retry-цикла уровня очереди. Вы можете поймать исключение и повторить внутри функции, но:
- нет единого централизованного учёта попыток;
- сложно обеспечить backoff и прекращение;
- при рестарте процесса задача исчезнет.
Можно, конечно, написать «самодельный ретрай», но тогда вы по сути делаете мини-очередь внутри API. Если это становится регулярной задачей — пора к внешней очереди.
5. Мониторинг и наблюдаемость (monitoring): как понять, что фон реально работает
5.1 Что мониторить в каждой модели
Синхронно
- latency и error rate HTTP endpoints;
- таймауты на стороне клиентов и прокси;
- среднее/перцентильное время ответа.
BackgroundTasks
- latency на выполнение задач внутри воркера (сложно: HTTP middleware не знает о дальнейшей работе);
- количество исключений в background-логах;
- корреляция «какой запрос породил какую задачу».
BackgroundTasks обычно тяжело наблюдать системно: без отдельной метрики/таблицы состояния вы будете «догадываться» по логам.
Очередь
- длина очереди (backlog);
- скорость обработки (throughput);
- число успешных/ошибочных попыток;
- задержки (time in queue, job runtime);
- DLQ/parking lot (куда уходят задачи после N попыток);
- трассировка по request_id/task_id.
5.2 Корреляция задач: request_id как «сквозной идентификатор»
Независимо от механизма фона, полезная практика:
- На входе генерируйте/принимайте
request_id. - Прокидывайте его в фон.
- Логируйте
request_idво всех этапах (API → очередь → воркер → внешние вызовы).
В распределённых системах это даёт возможность собрать полную картину в лог-агрегаторе.
5.3 Таймауты: кто кого ждёт
Проблема не только в том, что задачи «дольше». Это вопрос таймаутов:
- HTTP proxy (nginx, ingress) имеет свои таймауты;
- время жизни запроса ограничено клиентом;
- в очередях — таймауты обработки и visibility timeout (у некоторых брокеров);
- воркер может быть остановлен во время деплоя.
Поэтому:
- в
BackgroundTasksфон почти всегда должен быть «коротким»; - в очередях — фон должен выдерживать повторную обработку и иметь state.
6. Практическое правило выбора: когда BackgroundTasks, а когда очередь
6.1 Когда BackgroundTasks — нормальный выбор
Используйте BackgroundTasks, если одновременно выполняются условия:
- задача короткая (примерно до нескольких секунд, а лучше меньше);
- вы не обязаны гарантировать выполнение при падении процесса;
- допустимы ретраи «внутри» с минимальной сложностью (и вы готовы к тому, что они не централизованы);
- нет строгих требований к мониторингу и SLA по фоновой обработке;
- операция по смыслу не критична к дубликатам (или у вас есть лёгкая идемпотентность).
Примеры:
- обновление простого кэша (всё равно можно перезаписать);
- очистка временных данных без строгих гарантий;
- асинхронная запись в аналитический лог, если дубли приемлемы или есть дедуп.
6.2 Когда точно стоит очередь
Очередь предпочтительнее, если:
- задача долгоживущая: десятки секунд, минуты, часы;
- нужна надёжность: не терять задачи и иметь гарантированный повтор;
- у вас есть SLA по завершению фоновой обработки;
- важна наблюдаемость и управляемость ретраев;
- фон влияет на деньги/заказы/внешние системы;
- есть вероятность дубликатов (и вы готовы их правильно обрабатывать через идемпотентность).
Примеры:
- отправка документов/генерация отчётов;
- интеграции с внешними сервисами (CRM, биллинг, доставка);
- обработка событий (event-driven) и построение консистентности;
- операции, которые требуют корректного состояния и статусов.
6.3 Архитектурный компромисс: гибридный подход
В реальных проектах часто смешивают:
BackgroundTasks— для «легковесных» операций сразу после ответа;- очередь — для «тяжёлых» этапов с гарантией;
- синхронно — для критичных проверок и быстрых шагов.
Например, API:
- валидирует и пишет в БД (с идемпотентностью);
- возвращает
202 Accepted; - запускает очередь для длительного этапа;
- опционально через
BackgroundTasksделает «косметику» (например, слать уведомление о принятии — если это не критично).
7. Typичные ошибки и подводные камни
7.1 «BackgroundTasks ускорит всё» — нет
BackgroundTasks снижает latency ответа HTTP, но не уменьшает общую нагрузку CPU/IO. Если фоновые задачи тяжёлые, они просто переносят нагрузку в ту же зону риска: ваш воркер начинает захлёбываться.
Результат:
- очередь задач внутри воркера растёт;
- увеличивается время выполнения фона;
- API начинает тормозить и по «основным» запросам.
7.2 Отсутствие статуса: «когда клиенту сказать, что всё готово?»
Если клиенту важно узнать результат, у вас должен быть механизм:
- polling статуса по
request_id; - webhook callback;
- или выдача task_id и endpoint/consumer для получения статуса.
Без этого «accepted» превращается в обещание без данных.
7.3 Неопределённый контракт идемпотентности
Если вы не закрепили, что request_id обязателен и как он формируется, ретраи и повторы клиентов приведут к дублям.
Надёжный контракт обычно такой:
- входной API принимает
Idempotency-Key(или полеrequest_id); - сервер гарантирует уникальность по этому ключу на уровне бизнес-операции;
- если повтор — возвращается тот же outcome (или статус/ошибка).
7.4 Слепые ретраи без категории ошибок
Если ретраить всё подряд, можно:
- DDoS-ить внешний сервис при его даунтайме;
- зациклиться на некорректных входных данных;
- раздувать очередь и стоимость обработки.
Ретраи должны быть с классификацией ошибок и лимитами.
7.5 Отсутствие DLQ/парковки для очередей
Нужен «конечный» сценарий, когда задача продолжает падать. Иначе вы получите бесконечные попытки или скрытые потери. DLQ (dead-letter queue) позволяет:
- анализировать систематические ошибки;
- вручную переобрабатывать;
- ставить алерты.
8. Рекомендации по реализации: чек-лист
8.1 Для BackgroundTasks
- Делайте задачу короткой.
- Логируйте исключения (и добавляйте корреляцию по request_id).
- Сразу определите, допускается ли потеря при рестарте.
- Если задача влияет на бизнес — добавьте идемпотентность (хотя бы минимальную) на уровне БД.
- Не рассчитывайте на централизованный retry — внедряйте только если уверены, что это оправдано.
8.2 Для очереди
- Обязательный идемпотентный ключ (request_id / business_key).
- Нормальные ретраи с backoff, лимитами и классификацией ошибок.
- Мониторинг: очереди, runtime, ошибки, time-in-queue.
- DLQ и стратегия обработки «вечных» ошибок.
- Сквозные логи и трассировка.
9. Где тут FastAPI в общем смысле
FastAPI — это слой HTTP и вали