FastAPI и фоновые задачи: очередь vs BackgroundTasks, idempotency и обработка ретраев

На примерах объясним, когда достаточно BackgroundTasks, а когда нужна отдельная очередь/воркер. Разберём, как обеспечить воспроизводимость выполнения, безопасные ретраи и корректные статусы задач в API.
Содержание
Фоновые задачи в веб‑сервисах — это место, где сходятся производительность, надёжность и корректность бизнес‑логики. В экосистеме FastAPI есть два популярных подхода:
BackgroundTasks— простой механизм “досчитать после ответа”, удобно для лёгких задач.- Отдельная очередь + воркер (Celery/RQ/Arq/Kafka/SQS и т. п.) — для задач, которым важны гарантии доставки, ретраи, порядок, изоляция и управление жизненным циклом.
В этой статье разберём, когда достаточно BackgroundTasks, а когда нужна полноценная очередь/воркер, и как на практике выстроить idempotency, корректные ретраи и согласованные статусы в API. Будем опираться на типичные провалы в продакшене: “забыли, что воркер перезапускается”, “ретрай вызвал действие дважды”, “пользователь получил 200, хотя задача умерла”.
Что именно означает “фоновые задачи” в FastAPI
В FastAPI фоновые задачи — это функции, которые запускаются после формирования HTTP‑ответа. Это означает:
- клиент получает ответ, не дожидаясь выполнения задачи;
- код выполняется в том же процессе/контексте, где запустился запрос (в зависимости от сервера и настроек);
- нет “нативного” механизма сохранения состояния задачи и повторов на уровне инфраструктуры (хотя можно дополнять).
У BackgroundTasks есть ценность: он резко снижает “болт времени” для задач, которым не требуется строгая надёжность. Но он не заменяет очередь, если вам нужны устойчивость к сбоям, наблюдаемость и контроль повторов.
Когда достаточно BackgroundTasks
Лёгкие задачи с низкой критичностью
BackgroundTasks часто подходит для:
- отправки уведомлений, которые не должны блокировать запрос (при этом допускается потеря или повтор с минимальным риском);
- логирования/аудита “best effort”;
- чисток кэша по таймеру после обновлений (если последствия не катастрофичны);
- генерации не критичных артефактов (например, превью, если они пересоздаются позже).
Небольшая длительность и предсказуемость
Обычно фоновые функции должны быть короткими: условно секунды, а не минуты. Если задача может быть долгой, вы рискуете упереться в ресурсы воркеров приложения. Кроме того, при неудачах вы часто не сможете дать пользователю корректный статус “в процессе/успешно/ошибка”.
Отсутствие строгих гарантий и ретраев “по соглашению”
Если вы готовы договориться с бизнесом, что сбой фоновой задачи не влияет на целостность данных или может быть компенсирован другой операцией, BackgroundTasks может быть разумной отправной точкой.
База: пример с отправкой письма
from fastapi import FastAPI, BackgroundTasks

app = FastAPI()

def send_email(email: str, subject: str) -> None:
    # Имитация: здесь мог бы быть SMTP/провайдер
    print(f"Sending to {email}: {subject}")

@app.post("/notify")
def notify(payload: dict, background_tasks: BackgroundTasks):
    email = payload["email"]
    subject = payload.get("subject", "Hello")
    background_tasks.add_task(send_email, email, subject)
    return {"status": "queued_for_background", "email": email}
Важно: этот код не гарантирует, что send_email выполнится до конца во всех сценариях (рестарт процесса, падение контейнера, ошибки в серверных потоках). И это ключевой критерий.
Когда нужна очередь и воркер
Любая работа, где “не должно потеряться” — значит очередь
Если после запроса вы хотите:
- гарантировать выполнение или хотя бы детерминированное управление ретраями;
- сохранять состояние задачи (pending/running/succeeded/failed);
- переживать рестарты приложения;
- иметь централизованный мониторинг и rate limit;
- выполнять задачи независимо от веб‑воркеров;
то нужен внешний исполнитель: очередь + воркер.
Задачи с ретраями и контролем ошибок
В очередях ретраи — это не “try/except и ещё раз”, а системная функция с политикой:
- экспоненциальная задержка,
- ограничение числа попыток,
- dead-letter queue (DLQ) / запись в “ошибочные”,
- классификация ошибок (retryable vs fatal).
Детерминированность и idempotency на инфраструктурном уровне
В очередной системе вы можете:
- строить idempotency ключи и хранить результат;
- делать “at least once” предсказуемым (и безопасным);
- реализовать корреляцию между HTTP‑запросом и задачей.
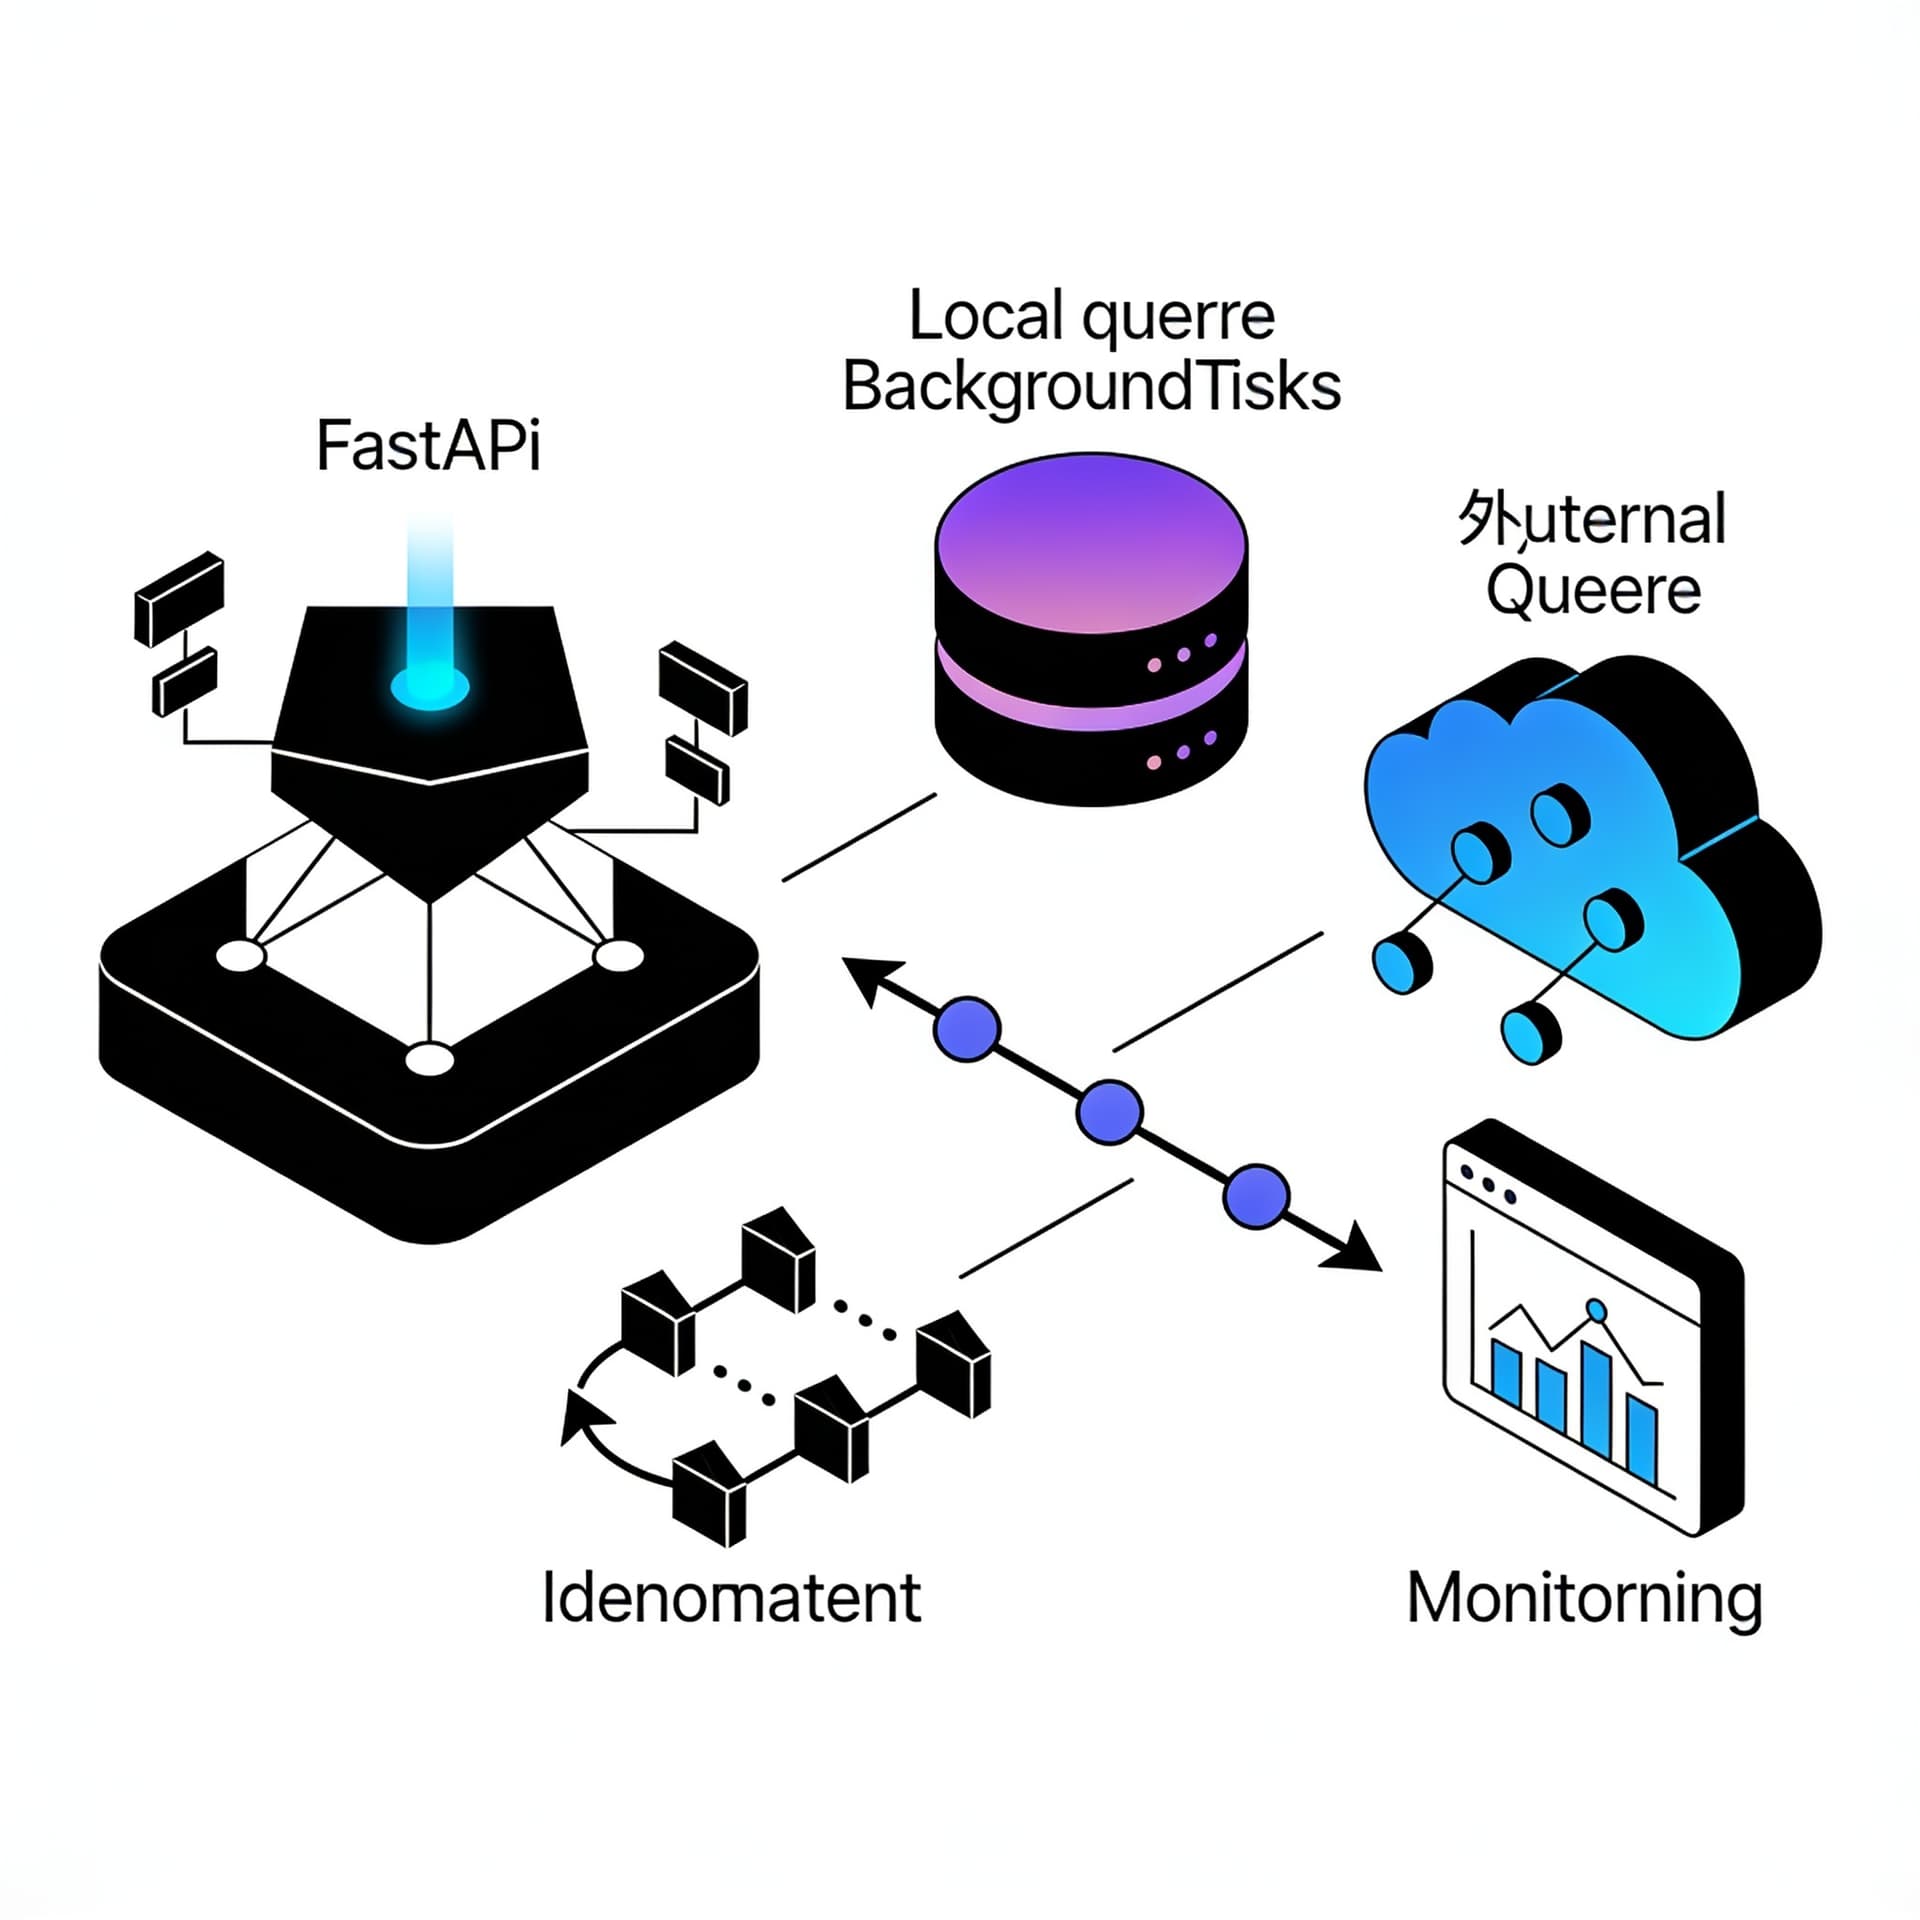
Architecture: “фоновые” задачи как контракт между API и исполнителем
Перед тем как выбирать механизм, стоит разделить ответственность:
- API принимает запрос, валидирует вход, создаёт запись о задаче/транзакции, возвращает корреляционный идентификатор.
- Исполнитель выполняет работу асинхронно.
- Хранилище (БД/Redis) хранит состояние, результаты и idempotency.
Даже если вы выбрали BackgroundTasks, полезно мыслить так: вы должны понимать, где хранится статус и как пользователю/клиенту узнать реальный результат.
Риски BackgroundTasks: почему “200 OK” может быть неверным
Самая частая проблема в продакшене выглядит так:
- клиент делает POST
/orders/123/export - сервер возвращает
200 OKбыстро - затем фоновой функции не хватает данных/токена/соединения
- задача падает, но никакого статуса пользователь не увидит
С BackgroundTasks вы можете поймать исключение внутри фоновой функции и логировать, но:
- клиенту негде “проверить”;
- невозможно надёжно ретраить без внешнего хранилища;
- ретраи могут снова создать side effects без idempotency.
Поэтому, если интерфейс продукта подразумевает “заказ экспортируется” и клиент ждёт предсказуемое завершение — очередь и статусы становятся обязательными элементами дизайна.
Idempotency: как сделать ретраи безопасными
Idempotency нужна по двум причинам:
- Вы часто получаете ретраи на уровне сети/клиента/прокси/таймаутов.
- Вы почти неизбежно сделаете ретрай фоновой операции при ошибках (иначе надёжность низкая).
Если операция не идемпотентна, ретраи порождают дубликаты: повторно создаются записи, отправляются сообщения дважды, списываются деньги второй раз.
Терминологическая рамка
- Idempotent request: повторный HTTP‑запрос с тем же идемпотентным ключом не вызывает повторного эффекта.
- Idempotent operation: выполнение фоновой задачи с тем же ключом не меняет состояние более одного раза.
В практической архитектуре вы обычно добиваетесь идемпотентности “по ключу” на стороне БД.
Практический паттерн: idempotency_key + уникальность в БД
Допустим, вы запускаете задачу “создать экспорт”. У вас есть таблица exports с полем idempotency_key, где стоит уникальное ограничение.
-- пример на PostgreSQL
create table export_jobs (
  id bigserial primary key,
  user_id bigint not null,
  idempotency_key text not null unique,
  status text not null default 'pending',
  result_url text,
  last_error text,
  created_at timestamptz not null default now(),
  updated_at timestamptz not null default now()
);
Ключ — это то, что задаёт клиент или сервер, но должно быть однозначным для конкретного намерения.
BackgroundTasks + idempotency: возможно, но с оговорками
Можно сделать BackgroundTasks, но тогда вам всё равно понадобится хранилище статуса, иначе вы не сможете обеспечить воспроизводимость и ретраи.
Минимальный каркас: API создаёт job в БД, возвращает job_id, а фоновой функции нужно:
- прочитать job,
- выполнить работу,
- записать результат,
- в случае ошибки — обновить статус.
Пример с “безопасной” логикой на уровне записи (упрощённо).
from fastapi import FastAPI, BackgroundTasks, HTTPException
from pydantic import BaseModel
import uuid

app = FastAPI()

# Допустим, есть слой репозитория, который работает с БД
# и гарантирует уникальность idempotency_key.

class CreateExport(BaseModel):
    user_id: int
    payload: dict
    idempotency_key: str | None = None

def do_export(job_id: int) -> None:
    """
    Фоновой функции нужна идемпотентность на уровне БД:
    - если статус уже succeeded, не пересоздаём результат
    - при ретраях — либо фиксируем попытки, либо проверяем наличие result_url
    """
    # pseudo: job = repo.get(job_id)
    # if job.status == "succeeded": return
    # try:
    #   url = generate_export(...)
    #   repo.succeed(job_id, url)
    # except RetryableError as e:
    #   repo.fail_retry(job_id, str(e))
    # except Exception as e:
    #   repo.fail_fatal(job_id, str(e))
    pass

@app.post("/exports")
def create_export(req: CreateExport, background_tasks: BackgroundTasks):
    idem_key = req.idempotency_key or str(uuid.uuid4())

    # pseudo: job = repo.create_export_job_if_not_exists(req.user_id, idem_key)
    # если запись уже есть и статус succeeded — можно вернуть её
    # если job уже running — возвращаем существующий job_id

    job_id = 1  # заглушка
    background_tasks.add_task(do_export, job_id)

    return {"job_id": job_id, "idempotency_key": idem_key}
Это показывает важное: даже с BackgroundTasks вам, по сути, всё равно нужны:
- состояние job в БД;
- логика “что делать при повторном запуске”;
- различение retryable и fatal ошибок.
Разница лишь в том, что инфраструктура ретраев/очереди у вас отсутствует. Следовательно, если вы хотите надёжность как в очередях — вам придётся реализовать её вручную (что обычно и приводит к очередям).
Очередь как способ обеспечить воспроизводимость выполнения
Под воспроизводимостью здесь стоит понимать не “магическое повторение”, а предсказуемый эффект:
- задачу можно повторно поставить в очередь;
- повторение безопасно из-за idempotency;
- при сбоях есть политика ретраев и понятный конечный статус.
В очередь удобно положить команду:
job_typejob_id(сущность в БД)idempotency_key- данные для выполнения
- контекст (например, пользователя)
Воркер при старте:
- Проверяет текущий статус job.
- Выполняет действие.
- Обновляет статус в БД.
- При retryable ошибке — увеличивает счётчик попыток и планирует повтор.
Правильные ретраи: классы ошибок и ограничение попыток
Ключевой принцип: не все ошибки одинаковы.
retryable— временные: таймауты, временная недоступность внешнего API, deadlock, сетевые проблемы.fatal— логические: неверные данные, нарушенные инварианты, 4xx от внешнего API (часто), отсутствие нужных прав.
Ошибки и решения
В ретраях важны три вещи:
- Сколько раз пытаться (например, максимум 5 попыток).
- С какой задержкой (экспонента + джиттер).
- Когда прекращать и переводить в
failed.
Пример схемы статусов:
pending— задача созданаrunning— воркер взял в работуsucceeded— выполненоfailed— окончательно не удалосьretrying— промежуточно (опционально; иногда проще хранитьattemptsиnext_retry_at)
Контракт API: статусы, которые не врут
Если вы даёте клиенту возможность “проверить результат”, API должно быть согласованным.
Рекомендуемый дизайн:
- POST
/exportsвозвращаетjob_idи текущийstatus(илиaccepted). - GET
/exports/{job_id}возвращаетstatus,result_url(еслиsucceeded),error(еслиfailed), метаданные попыток.
Пример API-эндпойнтов со статусовкой
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI()

class ExportStatus(BaseModel):
    job_id: int
    status: str
    attempts: int
    result_url: str | None = None
    last_error: str | None = None

@app.get("/exports/{job_id}", response_model=ExportStatus)
def get_export(job_id: int):
    # pseudo: job = repo.get_export_job(job_id)
    job = {
        "job_id": job_id,
        "status": "running",
        "attempts": 1,
        "result_url": None,
        "last_error": None,
    }
    if not job:
        raise HTTPException(status_code=404, detail="Job not found")
    return job
Если вы возвращаете от POST “успешно” только потому что поставили задачу — используйте 202 Accepted или состояние pending/running, а не “успешно”.
Обеспечение воспроизводимости: “один job — один эффект”
В очередях распространённая проблема: воркер может обработать задачу повторно при ретраях на уровне очереди. Это приводит к “at-least-once delivery”, то есть возможны дубликаты обработок.
Решение — идемпотентность на стороне эффекта.
Паттерн:
- хранить
job.statusиresult_url; - делать проверку “если job уже succeeded — не выполнять заново”;
- использовать
idempotency_keyили “уникальность по доменной сущности”.
Например, “создать запись в таблице результатов” может иметь unique constraint по job_id или business_key.
Ретраи и дубликаты: пример безопасной реализации на уровне БД
Допустим, задача “выполнить оплату” должна записать транзакцию. Тогда уникальность по payment_id и идемпотентность по idempotency_key спасают от двойного списания.
Схема:
- таблица
paymentsхранитidempotency_keyunique. - воркер сначала пытается создать запись:
- если уже существует — считать, что обработка уже выполнена, и не выполнять внешнее списание ещё раз.
Псевдокод (без конкретной библиотеки):
def handle_payment(job_id: int):
    job = repo.get_job(job_id)
    if job.status == "succeeded":
        return

    # Сначала — попытка "зарегистрировать" результат
    # Если запись уже создана, это означает повтор выполнения — выходим.
    created = repo.insert_payment_record_if_absent(job.idempotency_key, job.user_id, job.payload)
    if not created:
        repo.mark_succeeded_from_existing(job_id)
        return

    # Далее — внешний сайд-эффект
    repo.call_payment_provider(...)

    repo.mark_succeeded(job_id)
Это и есть практическая “воспроизводимость”: повтор обработки не порождает новый сайд‑эффект.
BackgroundTasks vs очередь: сводная таблица выбора
| Критерий | BackgroundTasks | Очередь + воркер |
|---|---|---|
| Гарантия выполнения | низкая/зависит от процесса | выше (при корректной настройке) |
| Переживание рестартов | нет | да |
| Ретраи | вручную, часто проблемно | встроенные политики |
| Статусы и наблюдаемость | придётся реализовать самому | обычно проще и стандартнее |
| Изоляция нагрузки | слабая | сильнее (воркер отдельно) |
| Idempotency | нужна всё равно для надёжности | нужна всё равно (для at-least-once), но проще системно |
| Время выполнения | лучше короткие задачи | любые (при очереди) |
Если ваши задачи “короткие и не критичные”, а интерфейс продукта не требует сложных статусов — BackgroundTasks может быть нормальным. Если вы всерьёз хотите ретраи, корректные статусы и надёжность — очередь.
Типичные ошибки и подводные камни
Ошибка 1. “BackgroundTasks решает всё асинхронно”
На самом деле BackgroundTasks остаётся внутри веб‑процесса. При масштабировании вы получаете нюансы: количество воркеров Uvicorn/Gunicorn, количество потоков, поведение при рестартах.
Ошибка 2. Ретраи без идемпотентности
Если повторный запуск выполняет side effects напрямую — дубликаты неизбежны. Даже при очереди без idempotency вы столкнётесь с тем же классом проблем.
Ошибка 3. Нет различия retryable/fatal
Вы либо бесполезно спамите внешние сервисы, либо прекращаете ретраи там, где нужно продолжать. Лучше заранее описать категории ошибок.
Ошибка 4. API “врет” клиенту
Возврат “успеха” после постановки задачи без гарантий — рецепт для конфликтов ожиданий. Используйте понятные статусы и 202 Accepted при асинхронной природе.
Ошибка 5. Отсутствие корреляции (job_id / request_id)
Если