Работа с Gantt-логикой задач: как проектировать дедлайны, ретраи и ограничения в асинхронных сервисах
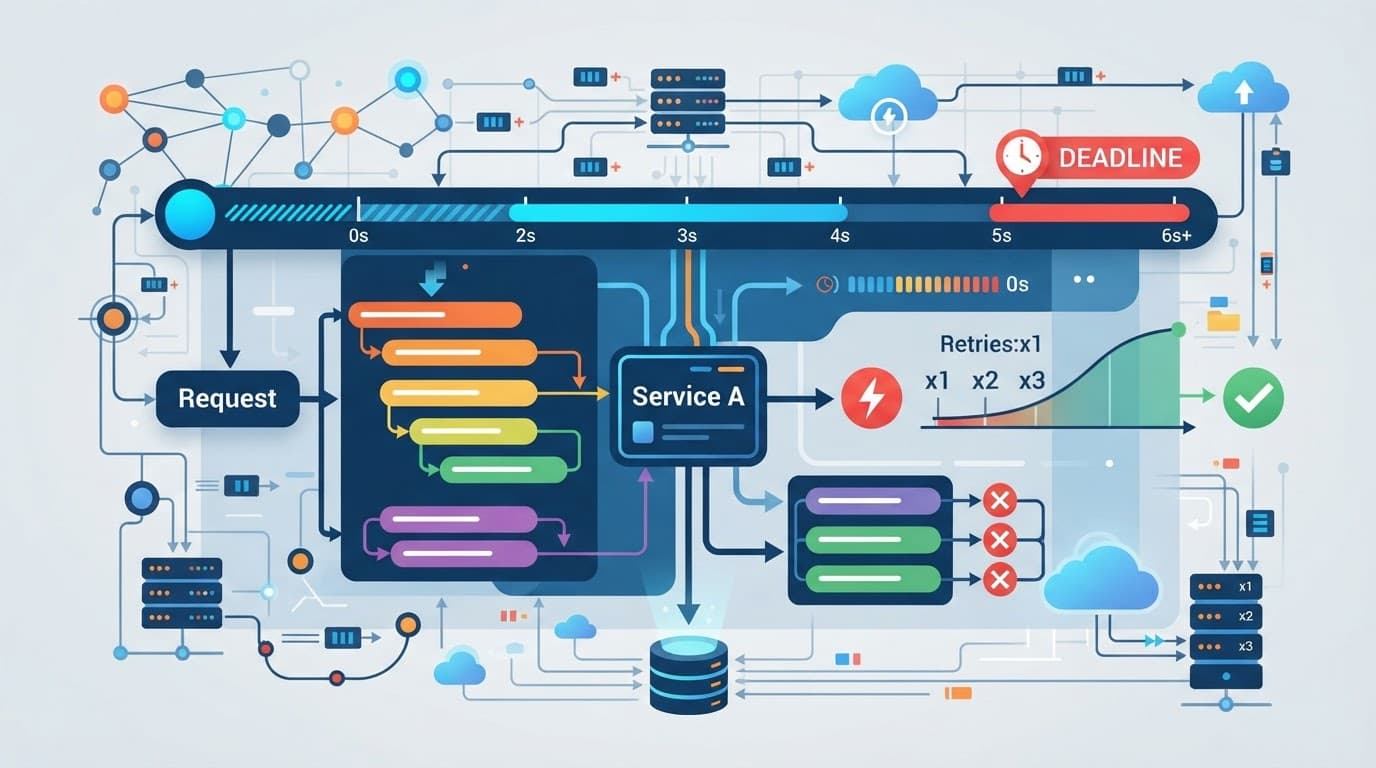
Покажем практический шаблон управления временем выполнения: дедлайн на весь запрос, отмена вложенных задач, ретраи с backoff и защита от каскадных зависаний при сетевых ошибках.
Содержание
Проектирование времени выполнения в асинхронных сервисах — это не про «поставить timeout и забыть». Это инженерная дисциплина: нужно задать правила того, сколько времени задача может потратить, как она должна реагировать на ошибки, когда и как отменять вложенные операции, и как предотвратить каскадные зависания в системах с высокой конкуренцией.
Под “Gantt-логикой” в этой статье я буду понимать подход, при котором мы мысленно проектируем граф выполнения задач: есть вершины (операции), есть зависимости, есть коридоры времени (окна выполнения), и есть глобальные ограничения (дедлайн на весь запрос). Такой граф полезно рассматривать и в синхронном мире — просто там проще «утонуть» в блокировках, а в асинхронном мире чаще ломается отмена, ретраи и повторное использование ресурсов.
Ниже — практический шаблон, который можно адаптировать под любой стек: дедлайн на весь запрос, отмена вложенных задач, ретраи с backoff и защита от каскадных зависаний при сетевых ошибках.
Почему “timeout” по месту недостаточен
На практике большинство “инцидентов с временем” выглядят так:
- Вы ставите
timeoutна отдельный сетевой вызов. - Но внутри этого вызова может быть серия зависимых операций (например, чтение индекса → запрос данных → загрузка схемы).
- Ретрай на каждый шаг умножает задержки.
- Вложенные корутины/воркеры не получают сигнал отмены, продолжают работать после истечения дедлайна верхнего запроса.
- Ресурсы (соединения, потоки, воркеры) удерживаются дольше, чем рассчитано, и система начинает “задыхаться” — уже не из-за одного запроса, а из-за очередей и давления на инфраструктуру.
В результате “локальные” таймауты не создают гарантии глобального бюджета времени. Вам нужен механизм, который:
- задаёт дедлайн на уровень запроса (или транзакции);
- обеспечивает распространение отмены во все вложенные операции;
- ограничивает ретраи так, чтобы суммарное ожидание не выходило за рамки бюджета;
- защищает систему от каскадных зависаний (когда таймауты не срабатывают вовремя или ретраи складываются в очередь).
Базовые принципы проектирования временных ограничений
Дедлайн на весь запрос — единый источник правды
Лучший практический подход: дедлайн вычисляется один раз в начале обработки входящего запроса (HTTP/gRPC/message), и дальше каждая операция сравнивает “текущее время” с этим дедлайном.
Это даёт несколько преимуществ:
- вы получаете предсказуемость суммарного времени выполнения;
- можно корректно ограничить число ретраев;
- отмена становится механической: “если дедлайн истёк — задача должна остановиться”.
Отмена вложенных задач должна быть структурной
Важно не просто отменить верхнюю корутину/фьючер, а гарантировать, что вложенные задачи тоже получают сигнал и корректно прекращают работу. В терминах современных асинхронных фреймворков это обычно означает “structured concurrency”: дочерние задачи живут строго внутри родительской области и автоматически завершаются при отмене родителя.
Если вы используете ручное порождение задач (например, в фоне), нужен явный механизм: передавать в дочерние задачи общий токен отмены или дедлайн.
Ретраи — только с учётом оставшегося бюджета
Ретрай без учета дедлайна — один из наиболее распространённых источников “таймаутов, которые никогда не кончаются”. Правило: после каждой неудачи мы пересчитываем оставшееся время и либо делаем следующую попытку, либо выходим.
Кроме того, ретраям нужна стратегия:
- backoff (экспоненциальный, иногда с полиномом);
- jitter (случайность), чтобы не синхронизировать ретраи на множестве клиентов;
- ограничение по типам ошибок (retryable vs non-retryable);
- лимит попыток и/или лимит суммарного времени.
Защита от каскадных зависаний: таймауты должны гарантировать освобождение ресурсов
Даже если дедлайн работает, вы можете столкнуться с зависанием на сетевом уровне: соединения, DNS, прокси, чтение тела, ожидание коннектов. Поэтому таймауты должны быть везде, где есть ожидание:
- connect timeout;
- request/response timeout;
- чтение/потоковая обработка.
Но не обязательно выставлять “везде” одинаковое число — достаточно гарантировать, что каждый этап не переживёт общий дедлайн.
Практический шаблон: “DeadlineContext” и контролируемые попытки
Ниже приведён пример на языке Python (asyncio), который хорошо иллюстрирует идею. Его можно перенести в другие экосистемы (Node.js, Go, Java) — смысл останется тем же.
Интерфейс контекста: дедлайн, отмена, оставшееся время
Идея: объект контекста хранит:
deadline(timestamp в монотонном времени),cancel_event(сигнал структурной отмены),- методы
time_left()иcheck().
import asyncio
import time
import random
from dataclasses import dataclass

@dataclass
class DeadlineContext:
    deadline_monotonic: float
    cancel_event: asyncio.Event

    def time_left(self) -> float:
        return self.deadline_monotonic - time.monotonic()

    def expired(self) -> bool:
        return self.time_left() <= 0

    def check(self) -> None:
        if self.cancel_event.is_set() or self.expired():
            raise asyncio.CancelledError("Operation cancelled or deadline exceeded.")
Обёртка сетевого вызова с “привязкой” таймаута к дедлайну
Если у вас есть HTTP-клиент, gRPC stub или любой async-transport, задача — всегда выставлять таймауты на основе оставшегося времени.
Пример ниже использует asyncio.wait_for как абстракцию.
async def with_deadline(ctx: DeadlineContext, coro, *, min_timeout: float = 0.01):
    """
    Ограничивает ожидание временем, оставшимся до дедлайна.
    min_timeout нужен, чтобы wait_for не получал нулевой/отрицательный таймаут.
    """
    ctx.check()
    remaining = ctx.time_left()
    if remaining <= 0:
        raise asyncio.CancelledError("Deadline exceeded before starting operation.")

    timeout = max(min_timeout, remaining)
    return await asyncio.wait_for(coro, timeout=timeout)
Ретраи с backoff и учетом дедлайна
Ключевой момент: после каждой неудачи мы проверяем, не истёк ли дедлайн, и только затем планируем next attempt.
Также — jitter, чтобы не получить “волны” синхронных ретраев.
class RetryableError(Exception):
    pass

class NonRetryableError(Exception):
    pass

def is_retryable(exc: Exception) -> bool:
    # Практически: сопоставьте с кодами ошибок транспорта/HTTP/статуса.
    return isinstance(exc, RetryableError)

async def retry_with_backoff(
    ctx: DeadlineContext,
    func,
    *,
    max_attempts: int = 5,
    base_delay: float = 0.2,
    max_delay: float = 2.0,
):
    attempt = 0
    last_exc = None

    while attempt < max_attempts:
        ctx.check()
        try:
            return await func()
        except Exception as exc:
            last_exc = exc
            if not is_retryable(exc):
                raise
            attempt += 1

            # Если дедлайн уже истёк или попыток слишком мало — выходим
            if ctx.expired():
                raise asyncio.CancelledError("Deadline exceeded during retries.") from exc

            # Оценим задержку и убедимся, что она поместится в оставшееся время
            # Экспоненциальный backoff + jitter
            delay = min(max_delay, base_delay * (2 ** (attempt - 1)))
            delay = delay * random.uniform(0.5, 1.5)

            remaining = ctx.time_left()
            if delay > remaining:
                raise asyncio.CancelledError(
                    f"Not enough time left for another retry (delay={delay:.3f}, remaining={remaining:.3f})."
                ) from exc

            # Подождать с возможностью отмены
            try:
                await asyncio.wait_for(ctx.cancel_event.wait(), timeout=delay)
                # Если отменили — прервём
                raise asyncio.CancelledError("Cancelled during backoff sleep.")
            except asyncio.TimeoutError:
                # нормально, ждём окончание backoff
                continue

    # если попытки закончились
    raise last_exc
Отмена вложенных задач: единый cancel_event и структурная область
Чтобы отмена была корректной, нужно обеспечить, что:
- дочерние задачи создаются в рамках одной области (обычно через
TaskGroupили аналог), - и при отмене/истечении дедлайна
cancel_eventвыставляется, - дочерние операции регулярно вызывают
ctx.check()или чувствительны к отмене транспортом/таймаутами.
В Python 3.11+ есть asyncio.TaskGroup, в упрощённом виде:
async def handle_request():
    cancel_event = asyncio.Event()
    deadline = time.monotonic() + 3.0  # допустим, 3 секунды на весь запрос
    ctx = DeadlineContext(deadline_monotonic=deadline, cancel_event=cancel_event)

    async def child_op(name: str):
        async def operation():
            # Имитация сетевой операции, которая может зависнуть
            await asyncio.sleep(0.3)
            return f"{name} ok"

        return await retry_with_backoff(
            ctx,
            lambda: with_deadline(ctx, operation()),
            max_attempts=4
        )

    try:
        async with asyncio.TaskGroup() as tg:
            t1 = tg.create_task(child_op("A"))
            t2 = tg.create_task(child_op("B"))
            # TaskGroup сам дождётся завершения обоих,
            # а при исключении отменит остальные (в зависимости от сценария).
            # Дополнительно можно проверить дедлайн:
            await asyncio.sleep(0)  # точка для событийного цикла
        # результаты t1/t2 в реальности берутся иначе, но ключ — в принципе
    except (asyncio.CancelledError, Exception):
        # выставляем cancel, чтобы остановить backoff sleep и все future операции
        cancel_event.set()
        raise
В реальном коде вы, вероятно, будете собирать результаты задач через ссылки на tasks, а при исключениях — аккуратно различать “отмена” и “ошибка”.
Как это выглядит в архитектуре: “budget как ресурс”
Чтобы это стало рабочим шаблоном, его нужно встроить в жизненный цикл запроса.
Где вычислять дедлайн
Практически дедлайн вычисляют на границе системы:
- для HTTP: на входе в handler, учитывая timeout от клиента/балансера;
- для gRPC: на основе
deadlineв metadata/headers; - для очередей: на основе
visibility timeout, “max processing time” и т.п.
Если вы проходите через несколько сервисов, важно не “рассчитывать дедлайн заново” бесконечно. Обычно делается так:
- В первом сервисе дедлайн определяется из SLA/конфига (например, 2.5s).
- Дедлайн передаётся дальше (например, как unix timestamp или “remaining millis”).
- Каждый следующий сервис пересчитывает
remaining = remote_deadline - now.
Если вы каждый раз задаёте новый таймаут “по вкусу” — итоговый бюджет станет непредсказуемым.
Как управлять ретраями между слоями
Самая частая ошибка — когда ретраи делаются одновременно на разных уровнях:
- клиент ретраит HTTP,
- reverse proxy ретраит upstream,
- сервис ретраит граничный вызов,
- внутри сервис ещё делает ретраи на чтение.
Суммарно это превращается в “набор вложенных циклов”, которые могут легко нарушить дедлайн, вызвать лавину нагрузки и замедлить recovery.
Правило: определите один уровень как “главный” для ретраев или строго ограничьте их. В терминах SRE это похоже на настройку “retry budget”.
Ретраи должны различать ошибки
Не каждую ошибку стоит ретраить:
ECONNRESET, временная недоступность, 502/503 иногда retryable.- 400/401/403 обычно non-retryable (скорее всего, ошибка запроса).
- 404 — тоже, если вы не знаете, что ресурс может появиться позже (но для этого нужен другой механизм, например eventual consistency).
Если вы ретраите всё подряд, вы превращаете дедлайн в “вежливое ожидание” гарантированной ошибки.
Подводные камни и типичные ошибки
1) “Timeout только на connect” не гарантирует освобождение
Даже при connect timeout запрос может зависнуть на чтении тела. В коде всегда отделяйте этапы, где возможна пауза:
- connect / TLS handshake / отправка запроса / чтение ответа / декодирование / обработка потокового ответа.
Если у вас streaming — особенно важно: дедлайн должен прерывать чтение, а не только ожидание первого байта.
2) Ретраи без jitter создают синхронные пики нагрузки
Синхронные ретраи приводят к эффекту thundering herd: все клиенты делают повтор ровно в одинаковое время. Jitter ломает синхронизацию.
3) Неправильная отмена: “фоновые задачи” продолжают жить
Если вы делаете “fire-and-forget” задачи без привязки к контексту дедлайна, они могут:
- удерживать соединения/память,
- продолжать ретраи,
- занимать воркеры,
- усугублять нагрузку после отмены запроса.
Решение: фоновые задачи либо отменяются вместе с запросом, либо должны быть персистентными с собственной семантикой (например, отдельные workflow/очереди).
4) Суммарный бюджет “съедается” на backoff
Даже с ограничением числа попыток проблема может остаться: backoff может занять больше времени, чем допустимо. Поэтому backoff нужно “проверять на влезаемость” в оставшийся бюджет — это то, что делает delay > remaining -> Cancel.
5) Task cancellation “не доходит” до IO
В разных клиентах отмена может вести себя по-разному:
- некоторые операции поддерживают cancel токен,
- другие требуют закрытия соединения,
- третьи не прерываются корректно, пока не дочитают тело.
Это нужно учитывать на уровне интеграции: иногда лучший “жёсткий” механизм — выставлять таймауты в transport и/или закрывать response object при отмене.
Инструментирование: как понять, что дедлайн реально работает
Даже хороший код может вести себя иначе в проде из-за клиентских библиотек. Поэтому важно логирование на уровне контекста:
- дедлайн (абсолютный timestamp или оставшееся время на старте попытки),
- номер попытки,
- тип ошибки и классификация retryable,
- причина остановки (deadline exceeded / cancelled / attempts exhausted / non-retryable).
Пример структуры логов (без привязки к библиотекам):
request_id,deadline_ms,attempt,remaining_ms,error_class,decision=retry|stop.
На графиках SLO/SLA вы должны видеть, что:
- доля
deadline exceededуменьшается при исправлениях; - ретраи не “раздуваются” бесконтрольно;
- растёт доля быстрых отказов при ошибках non-retryable.
Расширение шаблона: несколько параллельных шагов в одном дедлайне
Частый кейс: в одном запросе нужно выполнить несколько независимых вызовов параллельно (например, получить профиль и настройки), а затем агрегировать результат.
Здесь логика такая:
- общий дедлайн единый;
- каждый параллельный шаг использует
with_deadline(ctx, ...); - при отмене/ошибке шага остальным задачам также нужно корректно остановиться (иначе вы потеряете смысл параллелизма).
Если вы параллелите шаги, но не обеспечиваете “отмена в случае дедлайна/ошибки”, то система продолжит тратить время на операции, которые уже не нужны (и это прямой путь к лишним затратам и нагрузке).
Практический чек-лист для проектирования “временной Gantt-логики”
Перед тем как фиксировать архитектуру, ответьте на вопросы:
- Есть ли единый дедлайн на весь запрос? (и передаётся ли он дальше между сервисами)
- Как отмена распространяется на вложенные задачи? (структурная отмена или единый cancel_event)
- Таймауты каждого IO-шага ограничены оставшимся бюджетом?
- Ретраи учитывают дедлайн и оставшееся время?
- Есть ли jitter в backoff?
- Есть ли классификация retryable/non-retryable?
- Есть ли защиты от “вложенных ретраев” на разных слоях?
- Фиксируется ли в логах решение о ретраях и причина остановки?
- Проверено ли поведение отмены на реальном клиенте транспортного слоя?
Вывод
Хорошая “Gantt-логика” задач в асинхронных сервисах — это способ превратить время выполнения из хаотичного набора локальных таймаутов в управляемый бюджет, который:
- задаётся дедлайном на весь запрос;
- структурно распространяет отмену на вложенные операции;
- ограничивает ретраи backoff’ом с учетом оставшегося времени;
- предотвращает каскадные зависания и лавинообразные ретраи при сетевых сбоях.
Если хотите углубить тему системно (в том числе через призму архитектуры асинхронного выполнения, проектирования отказоустойчивости и практики обработки ошибок), полезным ориентиром может быть курс по теме — например, материал, подобный /course/ (его стоит подбирать под ваш стек и контекст, а не как универсальную таблетку).
В любом случае, ключевой навык остаётся один: проектировать не “таймауты”, а граф решений по времени — от дедлайна до отмены, от ретраев до освобождения ресурсов.