Как устроен GIL в Python: что он ограничивает и как это влияет на реальный код
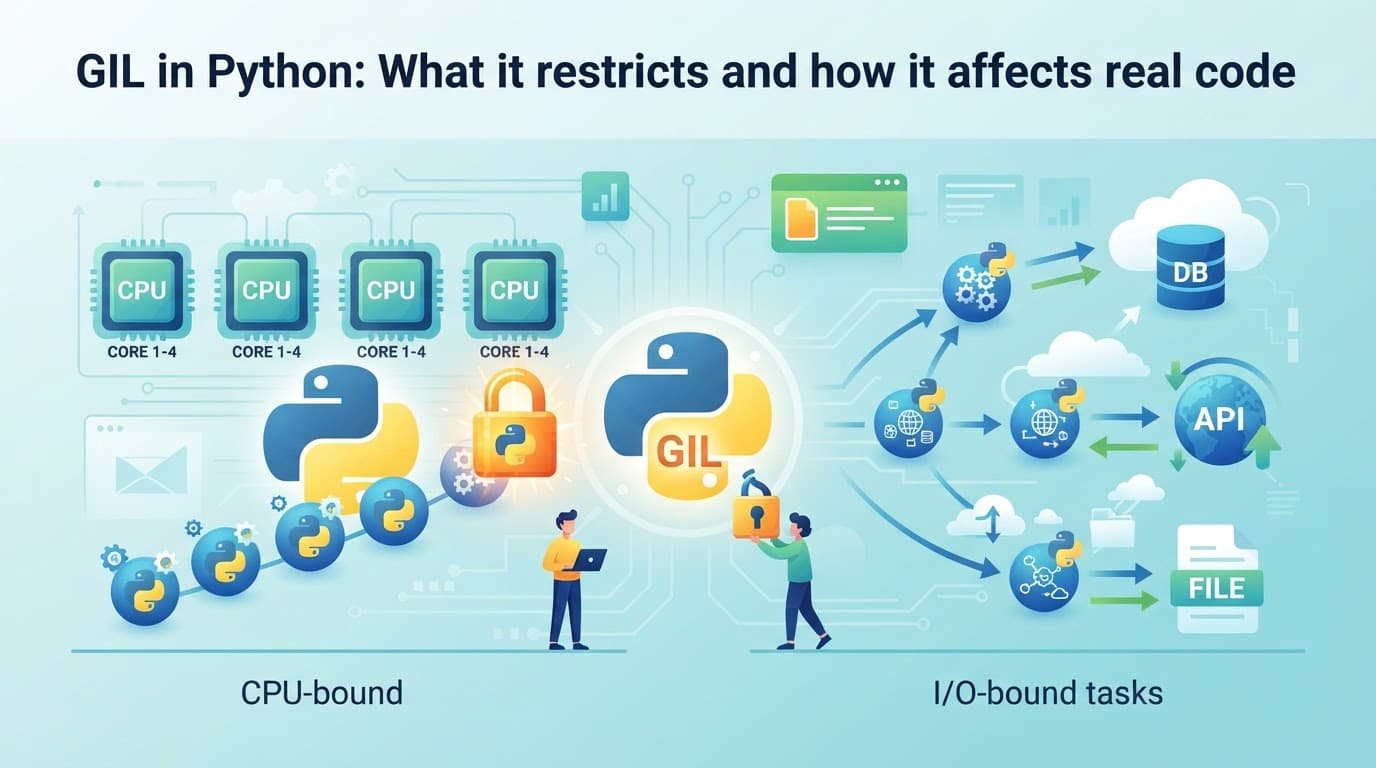
Разберём, почему GIL мешает CPU-bound потокам, а для IO-bound иногда всё “выглядит как будто работает”. Поймём, когда выбирать потоки, процессы и asyncio, и как измерить эффект на вашей задаче.
Содержание
GIL (Global Interpreter Lock) — одна из тех тем, о которые годами ломают копья: одни считают его «тормозом», другие — прагматичной инженерной деталью, которая упрощает реализацию интерпретатора и защищает от сложностей управления памятью и объектов. Важно другое: GIL не просто «существует», он прямо влияет на то, как Python ведёт себя в многопоточности, особенно на задачах, упирающихся в CPU (CPU-bound). А на задачах, где большую часть времени занимает ожидание (IO-bound), эффект может быть менее заметным — и даже создавать иллюзию, что «потоки ускоряют».
В этой статье разберём, как именно устроен GIL на уровне концепции, что именно он ограничивает, почему иногда потоки «кажутся» полезными, и как на практике выбирать между потоками, процессами и asyncio. Закроем всё измерениями: как проверить, что именно ограничивает вашу конкретную программу, и как интерпретировать результаты.
Что такое GIL и зачем он нужен
GIL в терминах модели исполнения
CPython — стандартная реализация Python — имеет интерпретаторный цикл, который исполняет байткод. Чтобы обеспечить корректность работы с объектами языка (с их внутренними структурами) CPython долгое время использовал GIL: это взаимное исключение, которое гарантирует, что в один момент времени выполняется код интерпретатора (точнее — выполняются операции байткода) только в одном потоке.
Если упростить:
- Поток может «взять» GIL и начать исполнять байткод.
- Пока GIL удерживается, другие потоки не могут выполнять байткод (хотя их можно планировать ОС и они могут «ждать»).
- Иногда интерпретатор отпускает GIL, чтобы дать шанс другим потокам или обработать системные события.
Что GIL защищает на практике
GIL тесно связан с тем, что в CPython управление состоянием объектов и внутренними структурами интерпретатора в значительной степени не рассчитано на одновременное выполнение нескольких потоков интерпретатором. Исторически GIL облегчал:
- обеспечение потокобезопасности структур интерпретатора без сложного гранулированного locking на уровне каждого объекта;
- предсказуемость и стабильность производительности интерпретатора.
Но ключевая мысль: даже если в вашем коде нет разделяемых структур данных, GIL ограничивает не «данные», а сам факт выполнения байткода.
Что GIL ограничивает именно в CPU-bound задачах
Почему CPU-bound в потоках почти не ускоряется
CPU-bound задача — это вычисления, где поток большую часть времени проводит, исполняя байткод и/или вычисляя в Python-коде. Например:
- обработка больших массивов чисел на чистом Python;
- парсинг/преобразования в циклах на Python-уровне;
- сериализация/десериализация на стороне Python без освобождения GIL;
- любые циклы, где 100% времени — выполнение кода интерпретатора.
В такой ситуации:
- Поток берёт GIL.
- Исполняет вычисления.
- Другие потоки остаются «в ожидании», потому что GIL занят.
- Если интерпретатор периодически отдаёт GIL, то переключения происходят ценой overhead, но параллельной работы на нескольких ядрах не возникает.
Итог: вы почти наверняка увидите, что производительность не растёт пропорционально количеству потоков. Иногда она даже падает из‑за переключений и накладных расходов планирования.
Формула эффекта (интуитивная)
Представьте, что из времени выполнения вашей задачи:
T1— часть, где выполняется байткод (удерживается GIL),Trelease— часть, где GIL может быть отпущен (например, при некоторых блокирующих системных вызовах или в C-коде, который явно отпускает GIL),Toverhead— накладные расходы планирования потоков.
Для CPU-bound обычно T1 близко к общему времени, а Trelease и Toverhead — малая доля. Поэтому увеличение потоков не даёт прироста.
Когда потоки “работают”: IO-bound и освобождение GIL
Две разные причины «почему кажется, что работает»
IO-bound задачи часто состоят из работы двух типов:
- ожидание ввода-вывода (сеть, диск, сокеты, таймеры);
- небольшие вычисления для обработки полученных данных.
На ожиданиях ОС поток обычно блокируется в системном вызове. Пока поток ждёт, интерпретатор может:
- не удерживать GIL дольше, чем нужно;
- переключиться на другой поток, который тоже может ждать или обрабатывать данные.
Важный нюанс: освобождение GIL происходит не «магически» из-за того, что у вас I/O. Скорее, CPython/библиотеки реализуют ожидания через системные вызовы, а некоторые C-расширения явно отпускают GIL на время долгих операций. В таких случаях один поток может ждать сеть, второй в это время взять GIL и обработать данные.
Почему иногда потоки дают почти линейный рост
Если ваша программа:
- значительную часть времени проводит в ожидании I/O,
- и на это время GIL реально отпускается (или выполнение байткода в этот момент не требуется),
то потоки могут масштабироваться до разумного предела (например, ограниченного каналом/лимитом файловых дескрипторов/конкуренцией к ресурсу).
Но есть подводный камень: «кажется, что ускорилось» часто потому что вы скрыли латентность (latency) I/O, а не потому что CPython начал выполнять CPU вычисления параллельно.
Почему измерения важнее убеждений: GIL не виден “на глаз”
Одна из самых частых ошибок при разговоре о GIL — подменять анализ вопросом «потоки ускоряют?» вместо вопроса «какая доля времени уходит на байткод и удержание GIL?».
Проблема в том, что:
- профиль по времени выполнения легко вводит в заблуждение без понимания того, что именно происходит под капотом;
- библиотека может выполнять тяжёлую работу в C и при этом освобождать GIL;
- ваша CPU-bound часть может быть не в Python-циклами, а в вызовах в C-расширения (где поведение другое).
Поэтому дальше — практический подход к измерению.
Потоки, процессы и asyncio: как выбирать с учётом ограничений
Потоки (threading): когда они уместны
Выбирайте потоки, если:
- задача преимущественно IO-bound;
- или ваша тяжелая часть вызывает C-код, который освобождает GIL (что часто бывает в числовых библиотеках, некоторых оптимизированных пакетах, файловых/сетевых стэках);
- вам нужна простая модель параллельности без полноценного межпроцессного взаимодействия.
Типичные примеры:
- загрузка/обработка множества HTTP-запросов;
- конкурентная работа с несколькими сокетами;
- параллельная запись/чтение из диска, если библиотека и драйверы позволяют скрывать задержки.
Процессы (multiprocessing): когда нужно CPU
Если задача CPU-bound на уровне Python-байткода, то процессы обычно выигрывают, потому что у каждого процесса свой интерпретатор и свой GIL. Вы получаете реальный параллелизм по ядрам.
Выбирайте multiprocessing, если:
- вычисления происходят на Python-уровне и реально занимают CPU;
- вам нужно масштабирование на несколько ядер;
- вы готовы принять накладные расходы межпроцессного взаимодействия и сериализации данных.
Подводные камни:
- стоимость передачи данных между процессами (pickle/IPC);
- рост памяти (каждый процесс имеет отдельное пространство);
- сложность отладки и управления жизненным циклом.
asyncio: когда нужна большая конкуруентность без потоков
asyncio — это не «магия для CPU», это модель кооперативной конкуренции для I/O.
Выбирайте asyncio, если:
- у вас много одновременных ожиданий (сеть, таймеры, очереди, async-IO библиотеки);
- CPU-работа минимальна или умеет эффективно освобождать управление (например, кусочками с
await, либо вынесена в отдельные worker-процессы/потоки).
Ключевой принцип: если внутри async-функции вы делаете долгие CPU вычисления без await, вы блокируете event loop и вся «конкурентность» превращается в последовательность.
Обычно в реальных проектах сочетают:
- asyncio для I/O,
- и либо процессы/пулы для CPU-bound,
- либо оптимизированные библиотеки для тяжелых вычислений в C.
Наглядные эксперименты: как увидеть эффект GIL на вашем коде
Эксперимент 1: CPU-bound на чистом Python
Рассмотрим простую вычислительную функцию. Это не «лучший способ считать», это способ сделать CPU-bound задачу на Python-байткоде.
import time

def cpu_work(n: int) -> int:
    s = 0
    for i in range(n):
        s += (i * i) % 97
    return s

def run_single(tasks, n):
    t0 = time.perf_counter()
    results = [cpu_work(n) for _ in range(tasks)]
    dt = time.perf_counter() - t0
    return dt, results

if __name__ == "__main__":
    dt, _ = run_single(tasks=4, n=5_000_00)
    print(f"single-process time: {dt:.3f}s")
Теперь сравним потоки (threading) и процессы (multiprocessing). Для потоков:
from concurrent.futures import ThreadPoolExecutor
import time

def run_threads(workers, tasks, n):
    t0 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=workers) as ex:
        results = list(ex.map(lambda _: cpu_work(n), range(tasks)))
    dt = time.perf_counter() - t0
    return dt, results
Для процессов:
from concurrent.futures import ProcessPoolExecutor
import time
import os

def cpu_work_wrapper(n):
    return cpu_work(n)

def run_processes(workers, tasks, n):
    t0 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=workers) as ex:
        results = list(ex.map(cpu_work_wrapper, [n] * tasks))
    dt = time.perf_counter() - t0
    return dt, results
Ожидаемая картина:
- threads: близко к single-process (иногда чуть хуже);
- processes: рост примерно с числом ядер до момента, когда ресурсы (CPU/память) начнут упираться и станет доминировать overhead.
Важно: абсолютные цифры зависят от размера n, количества задач и конкретной машины, но качественный тренд для CPU-bound на чистом Python обычно стабилен.
Эксперимент 2: IO-bound с ожиданием
Теперь задача, где поток большую часть времени «спит» на I/O. Условно — чтение из сети. Для демонстрации используем time.sleep как имитацию блокировки:
import time

def io_work(delay: float) -> int:
    time.sleep(delay)
    return 1
Последовательный запуск:
from concurrent.futures import ThreadPoolExecutor
import time

def run_sequential(tasks, delay):
    t0 = time.perf_counter()
    results = [io_work(delay) for _ in range(tasks)]
    dt = time.perf_counter() - t0
    return dt, results
Потоки:
def run_threads_io(workers, tasks, delay):
    t0 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=workers) as ex:
        results = list(ex.map(lambda _: io_work(delay), range(tasks)))
    dt = time.perf_counter() - t0
    return dt, results
Обычно потоки дадут заметный выигрыш, потому что параллелизм здесь про ожидание, а не про вычисления.
Но реальная проверка должна быть с настоящим I/O и вашими библиотеками: некоторые операции могут не отпускать GIL так, как ожидается, либо сериализация/обработка данных начнет доминировать.
Типичные подводные камни в реальном коде
1) “Я использую потоки — значит ускорится”
Не всегда. Если внутри потоков — CPU-bound байткод, GIL превратит потоки в «очередь переключений».
2) “У меня I/O, значит потоки всегда лучше”
Тоже нет. Если вы после I/O делаете тяжёлые преобразования на Python-уровне, они начнут конкурировать за GIL и съедят выигрыш.
3) CPU-bound прячется в неожиданном месте
Часто CPU растёт в:
- декодировании/парсинге,
- сериализации JSON,
- сжатии/распаковке,
- построении больших структур данных.
Даже если сетевое получение медленное, вы можете упрётся в обработку.
4) asyncio + CPU без await = блокировка event loop
Если в async-обработчике вы делаете длительный CPU расчёт, другие корутины будут простаивать. В таком случае:
- выносят CPU в процессы/пул потоков,
- либо используют оптимизированные библиотеки, которые выполняют работу в C и могут освобождать GIL.
5) Переоценка числа потоков
Потоки — это не бесплатный ресурс. Слишком много потоков:
- усиливают contention за GIL,
- создают overhead переключений,
- увеличивают давление на планировщик ОС.
В IO-bound кейсах число потоков часто ограничивают практическими лимитами: размер пула, лимиты соединений, пропускная способность сети/диска.
Практическая стратегия: от “гипотезы” к решению
Шаг 1. Разделите задачу на фазы
В вашем пайплайне примерно так:
- ожидание (I/O),
- обработка (CPU),
- упаковка/распаковка данных (часто и CPU, и память),
- запись результата (I/O).
Дальше вам нужно оценить, где доминирует время.
Шаг 2. Профилирование, а не только тайминги
Минимально полезно:
- измерить wall-clock время,
- посмотреть CPU time (например, через системные инструменты),
- при необходимости — включить профайлер (cProfile/py-spy/scalene) и посмотреть горячие места.
Если горячие функции — циклы на Python, то почти наверняка потоки не дадут масштабирования.
Шаг 3. Сценарии сравнения
Проведите A/B:
- single-thread/single-process baseline;
- threads (несколько десятков) для I/O-сценария;
- processes (по числу ядер) для CPU-сценария;
- asyncio (для I/O с корутинами) и добавьте отдельный канал для CPU (process pool).
Не пытайтесь выбрать решение «по ощущению». Лучше сравнить 2–3 варианта на репрезентативных данных.
Шаг 4. Учитывайте стоимость обмена данными
В multiprocessing часто основной «скрытый» расход — сериализация. Если у вас большие объекты, возможно выгоднее:
- уменьшить размер пересылаемых данных,
- использовать shared memory (где применимо),
- перенести обработку ближе к данным,
- или перейти на thread pool там, где тяжелое ядро выполняется в C и GIL отпускается.
Как мягко применить GIL-ориентированное решение на вашем коде
Если вы пишете сетевой парсер/агрегатор
Частый паттерн:
- asyncio для одновременных запросов,
- отдельные worker’ы (процессы) для тяжелого парсинга/обработки,
- или использование быстрых библиотек (ujson/orjson, lxml с правильными режимами и т.п., если они выполняют работу в C).
Если вы делаете ETL на больших данных
- Чистый Python CPU-bound циклы: скорее процессы или внешние оптимизации (векторизация/NumPy/Numba/Cython).
- Смешанные этапы: архитектурно разнесите I/O и CPU по разным слоям: асинхронный сбор входных данных и параллельная обработка на worker-пуле.
Если вы делаете “быстрый прототип на потоках”
Прототип можно. Но если цель — реальное ускорение, заранее заложите возможность смены реализации:
- тестируйте на CPU-bound нагрузках,
- не полагайтесь на то, что «потоки просто помогут».
Где GIL не является проблемой (и почему об этом важно помнить)
GIL — не универсальная причина медленности. Он ограничивает параллельное выполнение байткода в CPython. Но реальная программа может оказаться:
- не CPU-bound в Python-уровне,
- или большую часть времени проводить в C-коде библиотек,
- или быть ограниченной внешними ресурсами: сеть, диск, база данных.
Тогда потоки/asyncio действительно дают прирост, и GIL становится «не самым узким местом». Именно поэтому важно измерять конкретную задачу.
Выводы
GIL в CPython ограничивает параллельное выполнение байткода в нескольких потоках одновременно. Поэтому для CPU-bound задач, где вычисления идут на Python-уровне, потоки почти всегда не ускоряют (а иногда замедляют из‑за overhead). Для IO-bound задач потоки могут выглядеть эффективными — потому что во время ожидания I/O интерпретатор и/или C-реализации библиотек могут отпускать GIL, позволяя другим потокам продвигаться.
Практический выбор выглядит так:
- Потоки — преимущественно для I/O и для случаев, где тяжёлая работа находится в C-коде и освобождает GIL.
- Процессы — если CPU-bound работа действительно выполняется на Python-байткоде и нужно масштабирование по ядрам.
- asyncio — удобная модель конкурентности для I/O; CPU-работу нужно либо оптимизировать, либо выносить в процессы/пулы.
Если хотите глубже разобраться именно в механике многопоточности/параллелизма и том, как это влияет на архитектуру Python-приложений, полезной отправной точкой может стать курс по теме, например «»: он может помочь структурировать понимание и увидеть типовые паттерны принятия решений. Но в любом случае главный инструмент остаётся один — измерять ваш код на реальной нагрузке и проверять, где именно находится узкое место.