Карта профессии: как выбрать роль в IT и не потерять фокус на старте
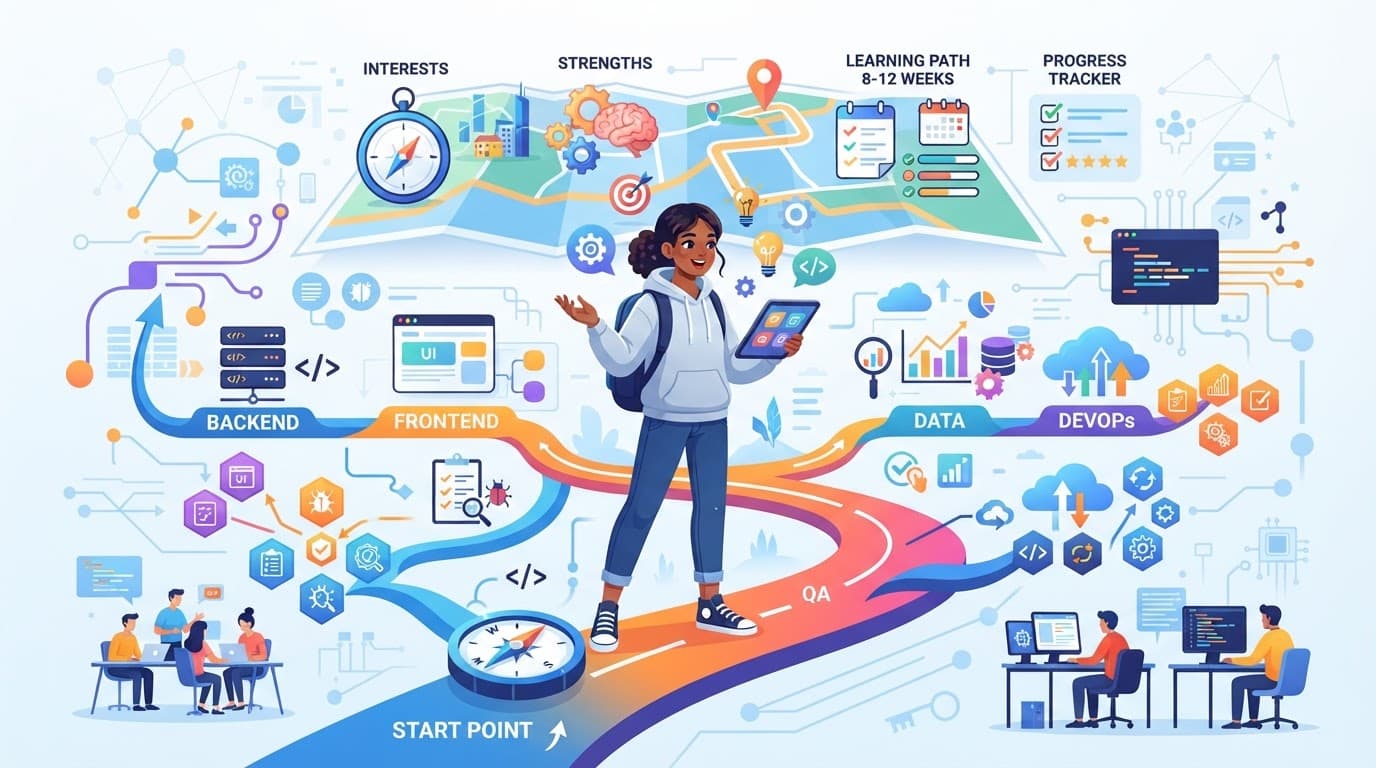
Разберём, как соотнести интересы и сильные стороны с ролями (backend, frontend, QA, data, devops) и собрать реалистичный план обучения на 8–12 недель. В статье — чек-лист критериев выбора и критерии прогресса, чтобы не распыляться.
Содержание
Выбор первой роли в IT редко бывает чисто рациональным. Обычно человек приходит с ожиданиями: «мне нравится код», «хочу работать с данными», «кажется, QA — проще начать», «DevOps звучит интересно, но непонятно». Проблема не в том, что ожидания есть — проблема в том, что их легко превратить в распыление. В результате новичок начинает учить всё подряд, а через 4–8 недель не может ответить на базовые вопросы: что именно я делаю и зачем, какой навык растёт каждую неделю, как понять, что я продвигаюсь.
Ниже — практический способ выбрать роль и собрать реалистичный план на 8–12 недель, не потеряв фокус. Мы разберём backend, frontend, QA, data и DevOps через призму интересов, сильных сторон и измеримых критериев прогресса. В конце будет чек-лист и шаблон плана, который можно адаптировать под себя.
Почему «правильная роль» — это не угадывание, а проверка гипотез
В IT карьерные треки редко выбирают один раз навсегда. Но на старте нужна точка опоры: роль, набор навыков и короткий цикл обратной связи. Это и есть «карта профессии».
Удобная логика:
- вы формируете 2–3 гипотезы роли (например, backend и QA),
- проверяете их в небольших упражнениях (мини-проекты, тесты, разбор кейсов),
- выбираете основную траекторию на 8–12 недель,
- затем корректируете курс по результатам.
Если вы пытаетесь выбрать роль «в теории», без практической проверки, план часто превращается в набор разрозненных тем. Поэтому дальше — критерии, которые помогают принимать решения с опорой на действия, а не ощущения.
Шаг 1. Соберите исходные данные: интересы, сильные стороны, ограничения
Перед тем как сравнивать роли, оцените себя по четырём категориям. Это не тест на «идеальность», а способ быстро сузить выбор.
Интерес к обратной связи: вы любите видеть результат сразу или предпочитаете глубину?
- Быстрый видимый результат чаще мотивирует в frontend и QA (работает интерфейс, тесты, отчёты о найденных проблемах).
- Глубина и структура обычно лучше ложится на backend и data (архитектура, алгоритмы, моделирование данных).
- Системность и «операции» — в DevOps (сквозной контур: конфиг → инфраструктура → деплой → мониторинг).
Тип мышления: «строить» или «ломать/проверять»
- Если вам нравится строить (логика, API, интерфейсы, модели) — вероятны backend/frontend/data.
- Если вам нравится проверять и находить сбои — QA и часть devops-подхода (инциденты, диагностика, контроль качества).
- Многие начинают с «ломать» (тестирование), а затем переходят к «строить». Это нормально.
Терпимость к неопределённости
- Data и DevOps часто требуют работы с неполными вводными: разные источники данных, зависимые сервисы, инциденты, неопределённые причины проблем.
- Backend также бывает «неясным», но чаще с более формализованным контуром (требования → API → логика → БД).
- Frontend сталкивается с неопределённостью интерфейсов и браузерных нюансов, но обычно это быстрее превращается в наблюдаемые эффекты.
Ограничения по времени и темпу
Для плана на 8–12 недель важно реалистично оценить темп:
- Если у вас 3–5 часов в неделю — выбирайте одну основную роль и не распыляйтесь на вторую.
- Если 8–12 часов — можно оставить «параллельную» ветку на уровне мини-упражнений (например, backend + базовый QA).
- Если времени мало, но есть сильная мотивация — лучше начать с той роли, где быстрее собрать «осязаемый артефакт» (работающий сервис, страница, тест-пакет).
Шаг 2. Сопоставьте роли с интересами и сильными сторонами
Ниже — краткая, но практичная «карта» ролей. Важно: цель не «угадать профессию», а понять, какая траектория даст наиболее быстрый и осмысленный рост.
Backend-разработка: когда вам нравится логика и контракт между сервисами
Что обычно делает backend:
- проектирует API (REST/GraphQL), бизнес-логику, слой доступа к данным;
- работает с БД, транзакциями, схемами данных, миграциями;
- думает об архитектуре: модули, зависимости, тестируемость.
Сильные стороны, которые помогают:
- аккуратность в структуре и типах данных;
- интерес к алгоритмам и моделированию;
- терпение к отладке и логированию.
Как понять, что вы в теме (быстрые сигналы):
- вам нравится писать обработчики запросов и видеть, что API «держит» требования;
- вы чувствуете удовольствие от рефакторинга и улучшения структуры;
- вам не страшно углубляться в БД и транзакционность.
Риск распыления: уход в «изучение всего фреймворка». На старте важнее понимать контракты и поток данных.
Frontend-разработка: когда вам нравится интерфейс и инженерия UX
Что обычно делает frontend:
- проектирует UI, состояние приложения, взаимодействие с API;
- работает с производительностью, кэшированием, обработкой ошибок;
- понимает верстку, доступность (a11y) и поведение компонентов.
Сильные стороны:
- внимательность к деталям;
- терпимость к итерациям («поправить — проверить — снова поправить»);
- интерес к визуальному результату и пользовательскому поведению.
Сигналы вовлеченности:
- хочется довести интерфейс до «как в продукте», а не просто «чтобы работало»;
- вам нравится разбираться в состояниях (loading/error/empty), сценариях;
- вы готовы наблюдать за поведением в браузере, а не только писать код.
Риск: бесконечное знакомство с библиотеками без построения собственного мини-приложения.
QA (тестирование): когда вы системно ищете ошибки и умеете формулировать проверку
Что обычно делает QA:
- проектирует тест-кейсы, проверяет функциональность и регресс;
- пишет автотесты (не всегда, но часто);
- помогает команде точнее формулировать требования.
Сильные стороны:
- критическое мышление;
- умение превращать «баг странный» в шаги воспроизведения и ожидаемый результат;
- дисциплина и внимание к сценариям.
Сигналы вовлеченности:
- вам нравится разбирать поведение системы «как продукт» — через реальные сценарии;
- вы получаете удовлетворение, когда тесты находят проблему;
- вы умеете описывать риски и покрытия.
Риск: превращение QA в «ручное тыканье». Чтобы расти, нужны измеримые проверки и автоматизация хотя бы на уровне мини-наборов.
Data (аналитика/ML-ориентированная траектория): когда вам нравится превращать данные в решения
Внутри data есть разные подроли, но на старте полезно разделять:
- аналитику (вопрос → данные → гипотеза → метрики → выводы),
- ML (данные → признаки → модель → валидация → качество).
Сильные стороны:
- интерес к статистике и оценке качества;
- аккуратность с данными (пропуски, выбросы, утечки);
- способность формулировать вопрос и проверять гипотезы.
Сигналы вовлеченности:
- вы любите заниматься предобработкой и видеть, как меняется качество;
- вам важно, почему модель так решила, а не только «точность где-то выросла»;
- вам нравится строить пайплайн от сырья до результата.
Риск: преждевременный скачок в «сложные модели» без базового качества данных и метрик.
DevOps / SRE-ориентированная траектория: когда вас тянет к надёжности систем
DevOps — не просто «уметь поставить Docker». На старте это скорее понимание того, как приложение живёт в среде:
- сборка и деплой (CI/CD),
- конфигурация,
- контейнеризация,
- мониторинг и диагностика,
- инфраструктурные практики (скейлинг, сети, секреты).
Сильные стороны:
- системное мышление;
- способность диагностировать по логам и метрикам;
- интерес к автоматизации и надёжности.
Сигналы вовлеченности:
- вы чувствуете азарт, когда находите первопричину инцидента;
- вам нравится настраивать окружение так, чтобы оно воспроизводилось;
- вы готовы учиться работе с Linux, сетью и процессами.
Риск: начать «настраивать всё подряд» без базовой цели: что деплоим, какие метрики считаем, как проверяем успех.
Шаг 3. Критерии выбора роли: чек-лист без романтики
Чтобы не потерять фокус, выбор должен быть проверяемым. Вот чек-лист. Отметьте «да/скорее да» и посмотрите, где больше совпадений.
Чек-лист критериев (scorecard)
-
Мне нравится тип результата
- API/логика → backend
- интерфейс/сценарии → frontend
- проверки/кейсы/ошибки → QA
- данные/метрики/модели → data
- деплой/надежность/диагностика → DevOps
-
Я хочу строить, а не только смотреть туториалы
- если нет, выбирайте роль с быстрым артефактом (часто frontend или QA с тестами)
- если да — можно идти в backend/data/devops
-
Я терплю «отладку»
- меньше терпения → start с роли, где проще увидеть эффект (frontend/QA)
- больше терпения → backend/data/devops
-
Мне подходит формат обучения на 8–12 недель
- если вы готовы ежедневно практиковаться — любая роль
- если нет — берите траекторию с более «коротким циклом» (мини-приложение + тесты/метрики)
-
У меня есть минимальная дисциплина
- расписание + контроль прогресса важны почти везде
- особенно в data/devops из-за объёма тем и среды
-
Я понимаю, как буду измерять успех (см. следующий раздел)
По итогам чаще всего оказывается, что «идеально» не совпадает ни с одной ролью, но одна или две наиболее близки. Их и берите на проверку.
Шаг 4. Критерии прогресса: как понять, что вы движетесь, а не имитируете обучение
Без критериев прогресса обучение легко превращается в чтение материалов. Поэтому заранее определите, что будет считаться улучшением.
Прогресс — это воспроизводимые артефакты
Выберите 3–5 метрик, которые можно повторять каждые 2 недели.
Примеры измеримых критериев:
- Backend: работает API (эндпоинты + валидация + слой данных), покрытие базовыми тестами (хотя бы unit/integration на ключевых местах).
- Frontend: отдельное мини-приложение: страницы + состояние загрузки/ошибок + интеграция с API, обработка форм, базовая производительность (например, отсутствие «лишних» перерендеров).
- QA: набор тест-кейсов для основного сценария + хотя бы 10–20 автотестов на критический поток (логин/создание записи/валидации).
- Data: воспроизводимый ноутбук/пайплайн: загрузка → очистка → признаки/модель → метрики → выводы; понимание, что ухудшает качество (утечки, дисбаланс).
- DevOps: репродуцируемый деплой: Docker/Compose → конфиги → healthcheck → логи/метрики; скрипт/процесс, который повторяет окружение на другой машине.
Прогресс — это снижение «времени на неизвестность»
Ещё один сильный индикатор: насколько быстро вы можете разобраться с проблемой.
На практике можно оценивать так:
- Сколько времени вы тратите на то, чтобы понять, почему не работает (1–2 часа / 1 день / 3 дня).
- Насколько вы научились формулировать проблему: есть ли логи, репродьюкшн, воспроизводимый пример.
Это особенно важно в devops и backend, где ошибки неочевидны.
Анти-паттерн: «я прошёл тему»
Если вы видите себя в формулировках «прошёл синтаксис», «посмотрел урок про REST», «прочитал про Docker», но нет продукта/теста/метрики — это не прогресс. Материал — средство, а не цель.
Шаг 5. Реалистичный план на 8–12 недель (под любую роль)
План лучше строить не по темам («сначала React, потом TypeScript»), а по результатам: что вы должны уметь показать в конце каждого спринта.
Ниже — универсальная структура, затем по ролям — конкретика.
Общая схема: спринты и контрольные точки
-
Недели 1–2: разведка и «каркас»
- выбрать стек (минимальный набор);
- сделать первый работоспособный артефакт;
- определить, какие данные/эндпоинты/сценарии вы будете использовать.
-
Недели 3–6: основной цикл
- реализовать ключевую функциональность;
- добавить тесты/валидации/метрики;
- оформить проект в понятный репозиторий (README, как запустить, что сделано).
-
Недели 7–10: качество и расширение
- улучшить обработку ошибок;
- добавить покрытие (тестами или валидациями);
- провести мини-«перебор гипотез» (почему не работает/как лучше).
-
Недели 11–12: стабилизация и портфолио
- доделать демонстрацию;
- написать краткий разбор решений и компромиссов;
- подготовить историю проекта (что вы делали, что узнали).
Правило фокуса: один основной трек + маленькие боковые проверки
Даже если вы не уверены между backend и QA, можно держать второй трек «в фоне»: 30–60 минут в неделю на подтверждение гипотезы. Но основной объём — в одной роли.
Роль за ролью: что учить и какие проекты делать за 8–12 недель
Ниже — практические траектории. Они не требуют «идеальной теории» в начале, но формируют инженерную привычку: сделал → проверил → улучшил.
Backend: 8–12 недель до работающего сервиса
Недели 1–2: каркас API и модель данных
Цель: поднять проект с базовым сервисом и 2–3 endpoint’ами.
- Выберите язык/стек (например, Python + FastAPI / Node.js + Express / Java + Spring — главное, чтобы вы могли быстро запускать и отлаживать).
- Создайте модель данных (например, “tasks” или “orders”).
- Реализуйте:
- create/read (POST/GET),
- базовую валидацию,
- хранение в БД (хотя бы SQLite на старте).
Пример минимального endpoint (FastAPI, Python):
from fastapi import FastAPI
from pydantic import BaseModel
import uuid

app = FastAPI()

tasks = {}

class TaskIn(BaseModel):
    title: str

class TaskOut(BaseModel):
    id: str
    title: str

@app.post("/tasks", response_model=TaskOut)
def create_task(payload: TaskIn):
    task_id = str(uuid.uuid4())
    tasks[task_id] = {"id": task_id, "title": payload.title}
    return tasks[task_id]

@app.get("/tasks/{task_id}", response_model=TaskOut)
def get_task(task_id: str):
    if task_id not in tasks:
        # в реальном проекте — HTTPException(404)
        return {"id": task_id, "title": None}
    return tasks[task_id]
На старте это может быть in-memory (как “скелет”), но к 3–4 неделе стоит перейти к реальной БД.
Недели 3–6: слой данных + интеграция + тесты
Цель: сделать CRUD полноценнее и добавить тестирование.
- Подключите БД и миграции (например, Alembic/Prisma/Migrations).
- Добавьте:
- список задач с пагинацией,
- обновление/удаление,
- ограничения (например, title length).
- Тесты:
- unit-тесты на бизнес-логику,
- минимум интеграционных тестов на endpoint’ы.
Недели 7–10: качество API и обработка ошибок
Цель: сделать сервис «производственным минимумом».
- Единый формат ошибок.
- Логирование и структура ответов.
- Простые ограничения (rate limiting опционально).
- Документация: OpenAPI/Swagger и README.
Недели 11–12: мини-презентация
Цель: подготовить портфолио и историю.
- что было сложно,
- какие компромиссы сделаны,
- как вы тестировали и какие сценарии покрыли.
Критерии прогресса (backend):
- сервис запускается одной командой,
- есть понятная модель данных,
- основные сценарии покрыты тестами,
- вы можете объяснить, почему приняли те или иные решения.
Frontend: 8–12 недель до мини-приложения с интеграцией
Недели 1–2: UI + базовая архитектура состояния
Цель: страница + форма + запрос к API.
- Выберите стек (React/Vue + TypeScript или что-то близкое).
- Сделайте приложение “Tasks”:
- список,
- форма добавления,
- обработка loading/error/empty.
Недели 3–6: интеграция и UX-сценарии
Цель: обработать реальные сценарии.
- Подружите фронт с backend/API (можно использовать mock на старте).
- Добавьте валидацию формы.
- Реализуйте optimistic update или хотя бы корректную перерисовку после POST.
Недели 7–10: качество интерфейса
Цель: уменьшить баги и повысить предсказуемость.
- Доступность базового уровня: aria-label, фокус, семантика.
- Перехват ошибок на уровне приложения.
- Мини-производительность: не перерендеривать всё без необходимости (на уровне принципов).
Недели 11–12: демонстрация
- В README опишите сценарии использования.
- Добавьте скриншоты/короткий видео-ролик.
Критерии прогресса (frontend):
- вы можете показать приложение с несколькими сценариями,
- есть обработка ошибок и пустых состояний,
- код структурирован и понятен без «магии».
QA: 8–12 недель до плана тестирования + автоматизация основного потока
Недели 1–2: понять продукт и описать тесты
Цель: сформировать тест-покрытие ядра.
- Выберите продукт/симулятор (ваш backend или готовый demo).
- Определите 5–10 ключевых пользовательских сценариев:
- создание,
- просмотр,
- обновление,
- удаление,
- валидации,
- негативные кейсы.
Сформируйте тест-кейсы в виде таблицы: предусловия → шаги → ожидаемый результат.
Недели 3–6: автотесты на критический поток
Цель: сделать хотя бы базовую автоматизацию.
Выберите инструмент (например, Playwright для UI или pytest + requests для API).
Пример: Playwright (идея — автотест сценария UI):
import { test, expect } from '@playwright/test';

test('создание задачи через форму', async ({ page }) => {
  await page.goto('http://localhost:3000');

  await page.getByLabel('Task title').fill('Написать статью');
  await page.getByRole('button', { name: 'Add' }).click();

  await expect(page.getByText('Написать статью')).toBeVisible();
});
Недели 7–10: отчётность и регресс
Цель: поднять качество процесса.
- Добавьте негативные проверки (пустое поле, слишком длинное значение).
- Зафиксируйте регресс-пакет: “smoke” (3–5 тестов) и “full” (весь набор).
Недели 11–12: портфолио
- Документ “как тестировать этот сервис” и почему именно так.
- Примеры найденных багов (если были) и что вы сделали, чтобы их воспроизвести.
Критерии прогресса (QA):
- тесты покрывают ключевые сценарии,
- вы умеете формулировать кейсы и ожидаемые результаты,
- автотесты дают воспроизводимый результат.
Data: 8–12 недель до пайплайна с метриками и выводами
Недели 1–2: данные, метрики и постановка задачи
Цель: сформулировать вопрос и критерий успеха.
- Возьмите датасет (открытый) и определите цель:
- прогноз (какая метрика? RMSE/F1/accuracy),
- сегментация (silhouette/cluster metrics),
- аналитика (какие BI-метрики?).
- Проверьте качество данных:
- пропуски,
- распределения,
- выбросы.
Недели 3–6: очистка и базовые модели/подходы
Цель: получить первый рабочий результат и понять причины ошибок.
- Сделайте baseline:
- линейная регрессия/логистическая регрессия/простая модель или частотный подход,
- для аналитики: простые разрезы и отчёты.
- Реализуйте воспроизводимый ноутбук:
- seed,
- train/test split,
- обработка категорий.
Недели 7–10: улучшение качества и анализ ошибок
Цель: доказать, что вы понимаете “почему”.
- Улучшение:
- feature engineering,
- баланс классов,
- кросс-валидация.
- Анализ:
- какие классы модель путает,
- где ошибки систематические.
Недели 11–12: финальный отчёт
- Что сделали,
- какая метрика выросла (и насколько),
- что ограничивает качество (качество данных, смещение, утечки).
Критерии прогресса (data):
- результат воспроизводим,
- есть метрика и понятный baseline,
- вы умеете объяснить, где модель ошибается и почему.
DevOps: 8–12 недель до воспроизводимого деплоя и диагностики
Недели 1–2: контейнеризация и локальный контур
Цель: приложение запускается через Docker одной командой.
- Возьмите ваш backend или простой сервис.
- Сделайте Dockerfile и docker-compose.yml.
- Проверьте:
- переменные окружения,
- порты,
- базовую конфигурацию.
Недели 3–6: CI и автоматический запуск проверок
Цель: автоматизировать рутину.
- Настройте pipeline:
- сборка,
- тесты,
- линтер (опционально),
- публикация образа (опционально).
- Добавьте healthcheck и корректные exit codes.
Недели 7–10: мониторинг и логирование
Цель: уметь диагностировать проблемы.
- Подключите метрики/логи на уровне принципов:
- структурные логи,
- понятные уровни log level,
- хотя бы базовый сбор/просмотр логов.
- Смоделируйте инцидент:
- неработающий сервис,
- неправильная переменная окружения,
- таймауты.
Недели 11–12: документирование
- README: как поднять окружение,
- как прогнать тесты,
- как понять, что “всё живо”.
Критерии прогресса (DevOps):
- окружение воспроизводится у другого человека,
- есть проверка здоровья сервиса,
- вы умеете по логам понять причину проблемы.
Как выбрать между двумя ролями: «треугольник проверки» за неделю
Если вы застряли между ролями (например, backend vs QA или frontend vs data), сделайте мини-эксперимент на 7 дней. Цель — не выбрать “сразу правильно”, а получить доказательства.
Треугольник проверки
- Сделайте артефакт на 1–2 дня для каждой роли (очень простой).
- backend: один endpoint + модель,
- QA: 10 тест-кейсов + 1 автотест,
- frontend: одна страница + форма,
- data: ноутбук “baseline + метрика”,
- devops: docker-compose + запуск.
- Измерьте усилие и удовольствие
- где вы застряли,
- что понравилось,
- сколько времени ушло.
- Проверьте устойчивость
- сможете ли вы продолжать без мотивационного “рывка” каждый день?
В большинстве случаев вы почувствуете разницу: одна роль даёт повторяемый цикл удовлетворения, другая — только «интерес по верхам».
Типичные ошибки на старте (и как их избежать)
Ошибка 1. Начать с платформенного «перечня тем»
План должен быть привязан к артефакту. Темы — это кирпичи, но не дом.
Антидот: в конце каждой недели ответить на вопрос: что я могу показать/проверить?
Ошибка 2. Учить вторую роль вместо первой
Если вы постоянно перескакиваете между треками, вы теряете непрерывность. Даже если обе роли вам интересны, на старте выберите одну как основной поток.
Антидот: второй трек — только как короткая проверка гипотезы (30–60 минут/неделя).
Ошибка 3. Нет критериев прогресса
Без метрик легко думать, что вы «всё изучаете». А на деле не создаётся база компетенций.
Антидот: 3–5 критериев, которые повторяются через каждые 2 недели.
Ошибка 4. Слишком большая сложность проекта
На 8–12 недель проект должен быть достаточно простым, чтобы вы дошли до конца и смогли улучшать качество.
Антидот: ограничьте функциональность до “ядра” и добавляйте сложность только после того, как ядро работает.
Практический шаблон плана на 8–12 недель (можно скопировать)
- Выбор роли (или 2 гипотезы):
- основная роль: ___
- запасная роль: ___
- Список артефактов на конец 8–12 недель:
- Артефакт 1: ___
- Артефакт 2 (тесты/метрики/документация): ___
- Артефакт 3 (демонстрация/README): ___
- Критерии прогресса (повторяемые каждые 2 недели):
- критерий A: ___
- критерий B: ___
- критерий C: ___
- Спринты:
- Недели 1–2: каркас и первый запуск
- Недели 3–6: ключевая функциональность + проверки
- Недели 7–10: качество и устойчивость
- Недели 11–12: упаковка результата и разбор
- Режим работы:
- сколько часов/неделю: ___
- дни недели/таймблоки: ___
- правило “не больше одной главной темы одновременно”: ___
Вывод: как выбрать роль и сохранить фокус на старте
Выбор роли в IT — это не экзамен на “самое правильное”, а серия практических проверок. Начните с карты: сопоставьте интересы и сильные стороны с тем, как каждая роль производит результат. Затем закрепите решение критериями прогресса: вам нужны воспроизводимые артефакты и повторяемая оценка качества работы.
Главная дисциплина на старте — фокус. План на 8–12 недель должен быть построен вокруг одного трека и измеримых целей. Если вы хотите структурировать этот процесс и не тратить недели на хаотичное “погружение”, полезно дополнить самостоятельную карту профессий учебной навигацией: например, курс «Карьера - с нуля!» можно рассматривать как способ получить понятный маршрут и вовремя сверяться с критериями, когда кажется, что вы учите много, но не двигаетесь.
Если хотите, скажите, какая у вас текущая ситуация (опыт/язык, сколько времени в неделю, между какими ролями сомневаетесь) — и я предложу персональный вариант плана на 8–12 недель с критериями прогресса и проектом под выбранную роль.