Как устроены процессы в Linux: ps, top, nice и systemd для разработчика
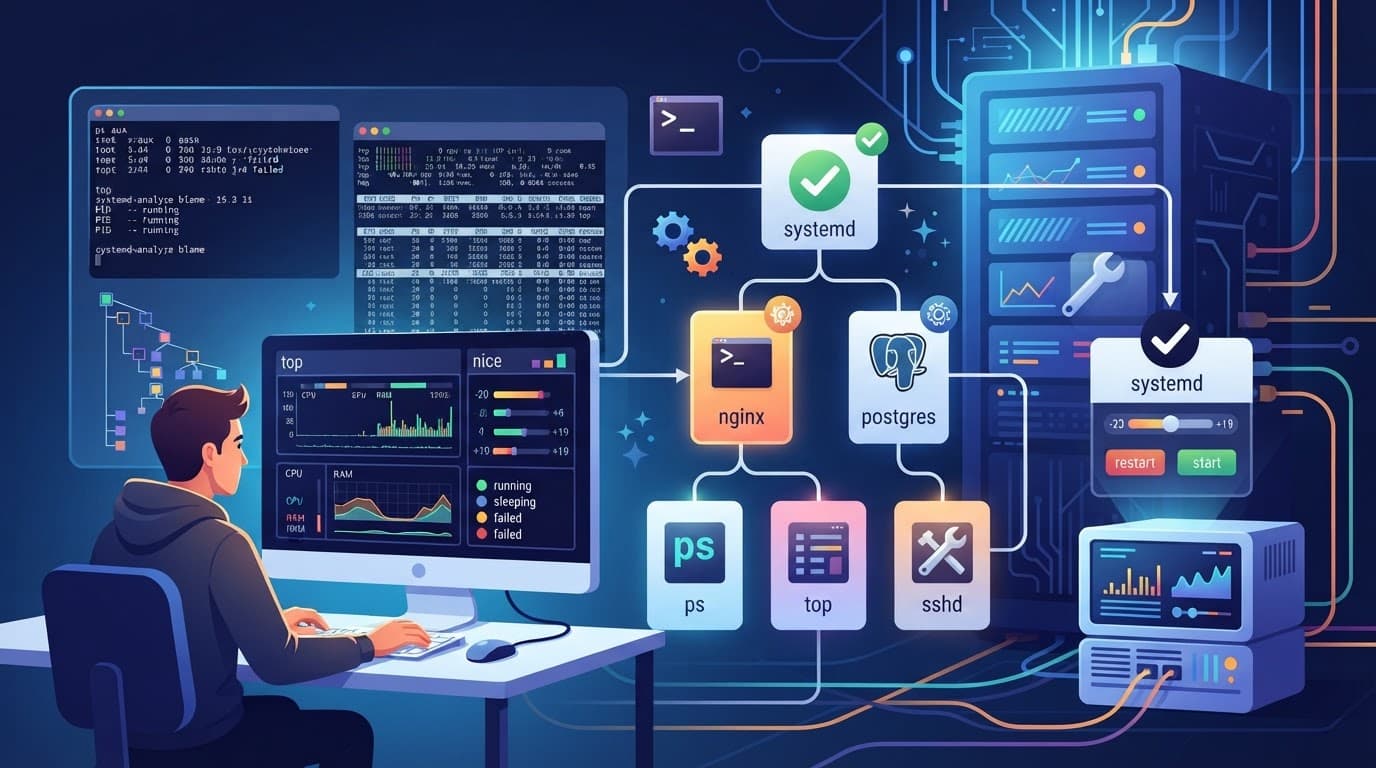
Разберём, как смотреть за нагрузкой и жизненным циклом процессов, как управлять приоритетами и корректно перезапускать сервисы через systemd. Поймёте, где искать причины лагов, таймаутов и «зависаний» на своей машине или сервере.
Содержание
Разработчик редко думает о процессах Linux до тех пор, пока что-то не начинает «подвисать»: приложение отвечает медленно, CI падает на таймаутах, сервер периодически «дергается», а после перезапуска вроде бы становится лучше, но ненадолго. В таких ситуациях важно уметь смотреть не в догадки, а в факты: что именно жрёт CPU или память, какие процессы «копят» задержку, почему сервис не перезапускается корректно и как управлять приоритетами.
Ниже разберём ядро практики: как наблюдать за процессами ( ps, top ), как управлять приоритетом выполнения ( nice и связанные механизмы ), и как корректно перезапускать и управлять сервисами через systemd. Будет много конкретики: какие поля смотреть, какие сценарии приводят к проблемам и как действовать, чтобы быстро локализовать причину лагов.
Понимание процесса в Linux: что именно вы наблюдаете
В Linux процесс — это сущность, имеющая:
- PID (идентификатор),
- состояние (например, выполняется, ожидает I/O, в остановке),
- ресурсы (CPU-время, память, страницы в кэше/аноним, размер виртуальной памяти),
- приоритеты планировщика,
- сигналы и каналы взаимодействия (сети, файловые дескрипторы),
- связь с родительским процессом и (часто) cgroups (через systemd/контейнеризацию).
При диагностики производительности часто ошибаются: видят «высокий CPU» и начинают оптимизировать код, хотя на самом деле узкое место — блокировки на диске, зависшие ожидания, утечки дескрипторов или неправильные настройки сервисов systemd. Поэтому полезно держать в голове: наблюдение за процессами — это сбор симптомов, а не диагноз. Но оно почти всегда сокращает пространство поиска.
ps: снимок состояния процессов и быстрый анализ
Почему ps полезен разработчику
ps даёт статический снимок: на конкретный момент времени вы получаете список процессов и выбранные метрики. Это удобно для:
- сравнения «до/после» (например, нагрузка выросла после деплоя),
- точечной проверки подозреваемого PID,
- быстрого просмотра деревьев процессов или привязки к пользователю/группе,
- сбора данных для последующего анализа (копирование в отчёт, лог).
Базовые команды и фильтры
- Посмотреть процессы по PID/пользователю и отсортировать по CPU:
ps -eo pid,ppid,user,comm,%cpu,%mem --sort=-%cpu | head -n 20
-e— выбрать все процессы-o— формат вывода--sort=-%cpu— сортировка по убыванию CPU
- Понять, какие процессы в «неровном» состоянии (например, ожидание ввода-вывода или блокировки):
ps -eo pid,ppid,stat,ni,pri,comm,%cpu,%mem --sort=-%cpu | head -n 30
Полезные поля:
stat— состояние (обычно один или несколько символов, напримерR,S,D,Z)ni— nice (влияние на приоритет)pri— текущий приоритет планировщика%cpu,%mem— относительные доли
- Показать дерево процессов (полезно для сервисов с воркерами):
ps -ejH -o pid,ppid,pgid,comm --sort=pid
-H рисует иерархию (за счёт графического вида ppid).
Частые ловушки ps
-
%CPUвps— не всегда то же самое, что вtop.
topсчитается/обновляется интерактивно, аps— это снимок с собственной логикой вычисления. Для быстрой ориентации различия не критичны, но для точных выводов смотрите метод подсчёта. -
psне покажет динамику.
Если процесс «пульсирует» CPU рывками,psможет случайно поймать «мгновение тишины». Тогда нуженtopили логи/метрики. -
Удобные поля выбирайте осмысленно.
Например,RSS(физическая память) часто важнее, чемVSZ(виртуальная). В современных Java/Node приложениях виртуальная память может быть большой из‑за выделений адресного пространства и маппинга, но реальная нагрузка определяется RSS.
top: динамика нагрузки и живое наблюдение
Ключевая идея
Если ps — это фотоснимок, то top — видеосъёмка в реальном времени. Он показывает изменяющиеся показатели и позволяет быстро понять, «растёт» ли нагрузка сейчас.
Полезные режимы top
Запуск:
top
Дальше вы обычно работаете без мыши: горячие клавиши зависят от версии top, но большинство стабильны.
- Отображать потоки/процессы более прицельно. Например, переключить режим отображения потока может быть полезно для Java (в зависимости от сборки):
- иногда помогает
H(threads), но проверьте в вашемtop(индикатор команд подсказки часто есть внизу).
- Отсортировать по CPU или памяти.
- В
topсортировка задаётся клавишамиP(CPU) иM(memory) — настраивайте под задачу.
- Фильтровать по процессу по имени или PID.
Часто вtopесть ввод фильтра, но если его нет — проще пользоватьсяtop -p PID.
Например, наблюдать конкретный процесс:
top -p <PID>
Что смотреть в top для локализации лагов
- Загрузка системы в верхней части:
us— user CPUsy— system CPUid— idlewa— время ожидания I/O (если отображается)si/so— прерывания
Если видите высокий wa, то оптимизация приложения «в лоб» может не помочь: проблема может быть в диске, сети, очередях, блокировках на файловой системе.
-
Сколько процессов реально «жгут» CPU.
Если один процесс раздувает CPU до 100%, а остальное — пассивно, это одна категория проблем. Если CPU «размазался» по десяткам процессов — возможно, вы теряете управление планированием (или деплой породил слишком много воркеров). -
Память и swap.
Если в системе растёт swap-in/out, то «лаги» почти неизбежны. Иногда кажется, что CPU свободен, а приложение всё равно тормозит — потому что оно ждёт страницы из swap.
Частые ошибки интерпретации
-
Не путать CPU и «время ответа».
Процесс может быть активно CPU‑bound, но сервис может всё равно тормозить из‑за очередей на сетевом уровне или блокировок на уровне приложения. -
Игнорировать I/O ожидания.
topиpsчасто показывают косвенно, что «что-то с диском», но для точного ответа нужныiostat,vmstat,iotop, анализ файловых блокировок, strace/perf и т.д. Тем не менее,top— лучший первый фильтр.
Управление приоритетом: nice и renice (и почему этого часто недостаточно)
Что делает nice
nice — это утилита для изменения nice value процесса. Nice влияет на приоритет планировщика: обычно меньшее nice означает более высокий приоритет, а большое nice — наоборот (процесс «уступает» CPU).
Нюансы:
- Приоритеты планировщика в Linux сложнее одной шкалы: есть политика планирования (normal/rt), есть real-time приоритеты, есть cgroups, есть O(1)/CFS и т.д.
- Но nice — распространённый и простой способ начать управлять CPU-распределением между процессами.
Применение nice при запуске
Например, запустить задачу с пониженным приоритетом:
nice -n 10 command
Диапазон nice зависит от политики, но классически:
- от
-20(высокий приоритет) до19(низкий приоритет) - отрицательные nice требуют повышенных прав (обычно root или нужные capabilities)
Изменить приоритет у уже запущенного процесса: renice
sudo renice -n 10 -p <PID>
Проверка текущих значений
В ps вы уже видели ni (nice):
ps -p <PID> -o pid,ni,pri,stat,comm
ni— nice valuepri— текущий приоритет (значение может отличаться по интерпретации в зависимости от планировщика)
Когда nice помогает, а когда нет
nice полезен, когда:
- у вас конкуренция за CPU,
- один сервис CPU-bound, а другие критичны к задержке,
- вы хотите «мягко» ограничить фоновые задачи.
`nice почти бесполезен, когда:
- проблема в I/O ожидании (диск/сеть), а не в CPU;
- сервисы управляются в cgroups с жёсткими лимитами (там приоритеты CPU определяются ещё и cgroups/cpu.weight);
- у процесса включены real-time политики (SCHED_FIFO/RR), где nice может быть не доминирующим фактором;
- вы запускаете несколько экземпляров одного процесса и «съедаете» ресурсы масштабированием.
Практический вывод: nice — инструмент управления CPU‑частотой выполнения. Он не заменяет правильные лимиты ресурсов, не отменяет таймауты, и уж точно не лечит зависания из-за блокировок в приложении.
systemd: жизненный цикл сервисов, перезапуски и корректная диагностика
Зачем systemd разработчику
Многие разработчики воспринимают systemd как «фон, который стартует и стопает». На практике systemd — это слой управления жизненным циклом, который влияет на всё:
- как сервис стартует (и в каком порядке),
- как он умирает/перезапускается,
- сколько времени ему дают на shutdown,
- какие ограничения применяются (CPU/memory/IO),
- как собираются статусы, журналы и причины падений.
Ошибки конфигурации systemd часто выглядят как «зависания»:
- сервис рестартится бесконечно,
- но с неправильной задержкой или с неверной настройкой timeout,
- или падает после старта, но systemd считает это нормой/ожидаемым поведением,
- или сервис стартует раньше зависимости (например, базе ещё не готова).
Базовый пример unit-файла
Обычно сервисы лежат в /etc/systemd/system/*.service или /lib/systemd/system/.
Типичный шаблон:
[Unit]
Description=My App
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=app
Group=app
ExecStart=/usr/bin/my-app --config /etc/my-app/config.yaml

Restart=on-failure
RestartSec=5

TimeoutStartSec=30
TimeoutStopSec=20

# Ограничения (пример)
MemoryMax=512M
CPUQuota=200%

[Install]
WantedBy=multi-user.target
Разберём ключевое:
After/Wants— зависимости (критично для «почему сервис стартует, но потом падает»).Type— как система понимает готовность сервиса:simple— процесс считается готовым сразу после запуска;notify— сервис явно уведомляет systemd о готовности (через sd_notify);oneshot— одноразовая задача.
RestartиRestartSec— политика перезапуска.TimeoutStartSec/TimeoutStopSec— таймауты старта и остановки.- Ограничения — влияют на поведение под нагрузкой.
Как корректно перезапускать сервис
Вручную:
sudo systemctl restart myapp.service
Посмотреть статус:
systemctl status myapp.service
Полезно, потому что там обычно есть:
- последние строки из журнала,
- код выхода,
- время последнего запуска/остановки.
Почему «правильный перезапуск» важнее, чем просто kill -9
Если сервис «висит», разработчик иногда делает грубое:
kill -9(SIGKILL),- или перезапускает процесс в обход unit-файла.
Это может:
- сорвать корректное освобождение ресурсов,
- сломать graceful shutdown (очереди не сбрасываются),
- оставить временные файлы/сокеты в нестабильном состоянии,
- увеличить вероятность повреждения данных (если сервис пишет в файл и не успел флашнуть).
systemctl restart позволяет systemd отработать протокол остановки:
- отправить SIGTERM,
- подождать
TimeoutStopSec, - при необходимости — SIGKILL уже как последнюю меру.
Локализация причин лагов через systemd и journald
Смотреть логи сервиса:
journalctl -u myapp.service -n 200 --no-pager
По времени (например, за последний час):
journalctl -u myapp.service --since "1 hour ago" --no-pager
Причины, которые часто всплывают:
- сервис стартует, но сразу уходит в аварийное завершение из‑за конфигурации;
TimeoutStartSecслишком мал — systemd считает старт неуспешным;- сервис не успевает корректно остановиться — timeouts вызывают жёсткий kill;
- рестарт происходит часто, и сервис «раскачивает» систему.
Важный практический приём: когда вы видите «зависания», проверяйте не только приложение, но и последовательность рестартов:
- как часто падает,
- что было последним в логах,
- был ли graceful shutdown,
- не превышает ли система лимиты (MemoryMax/CPUQuota).
Управление таргетами и моментом старта
Иногда сервис «зависает» только при холодном старте. Причина нередко банальна: сервис стартует до готовности зависимостей.
В unit-файле чаще применяют:
After=network-online.targetиWants=network-online.target,- зависимость на конкретные
.service(если нужно), Requires=если без этого сервис не должен жить.
Если, например, ваше приложение ждёт доступность внешней БД, а unit не учитывает это, приложение может запускаться, таймаутиться, терять соединения и уходить в аварийный цикл рестартов.
Сценарии из жизни: как найти причину лагов по цепочке
Сценарий 1: «Периодически всё тормозит, но CPU не 100%»
Шаги:
- Смотрите
top: есть ли ростwa(I/O wait), или рост system CPU (sy). - Проверьте память: растёт ли swap.
- Выпишите топ-процессы по RSS:
ps -eo pid,comm,%cpu,%mem,rss --sort=-rss | head -n 20 - Если сервис запускается через systemd — проверьте журналы на ошибки таймаутов:
journalctl -u myapp.service --since "today" --no-pager | tail -n 200
Часто виноваты:
- блокировки на файловой системе,
- резкое заполнение диска,
- I/O паттерн (например, синхронные операции на сеть/диск).
Сценарий 2: «Сервис перестал отвечать, но процесс жив»
Шаги:
ps/top: CPU и I/O ожидание процесса?- Если CPU низкий, но ответов нет — это может быть:
- ожидание внешнего ресурса,
- deadlock/блокировка,
- нехватка потоков/воркеров,
- проблемная синхронизация.
- systemd: смотрите состояние и логи.
systemctl status myapp.service
journalctl -u myapp.service -n 200 --no-pager
Иногда проблема в том, что systemd считает сервис «живым» (например, Type=simple), пока процесс не завершится. Но приложение внутри может зависнуть логически. Тогда перезапуск может помочь, но правильнее:
- расследовать причины дедлока/таймаутов,
- рассмотреть readiness/liveness через
Type=notifyили healthcheck‑механику (если используете reverse proxy/балансировщик).
Сценарий 3: «После деплоя начались рестарты и таймауты»
Шаги:
- systemd статус:
systemctl status myapp.service - Журналы:
journalctl -u myapp.service --since "10 minutes ago" --no-pager - Проверьте:
- не упали ли
ExecStart, - не изменились ли пути конфигов/доступы,
- не стал ли сервис дольше запускаться → возможно
TimeoutStartSecстал слишком мал.
- не упали ли
Перезапуски могут казаться «почти бесконечными», потому что Restart=on-failure триггерится аварийным завершением. Но иногда вы перезапускаете сервис слишком резко: крутится «горячий цикл». Тогда RestartSec и StartLimit* (ограничение частоты рестартов) становятся критичными.
Практика: мини-диагностика «за 5 минут»
Ниже — небольшой алгоритм, который часто помогает разработчику не утонуть в инструментах.
- Найти топ-процесс по CPU и памяти:
ps -eo pid,comm,%cpu,%mem,rss --sort=-%cpu | head -n 10
ps -eo pid,comm,%cpu,%mem,rss --sort=-rss  | head -n 10
- Посмотреть динамику (коротко) для конкретного PID:
top -p <PID>
- Проверить nice/приоритет подозреваемого:
ps -p <PID> -o pid,ni,pri,stat,comm
- Если сервис systemd — собрать логи:
sudo systemctl status myapp.service --no-pager
sudo journalctl -u myapp.service --since "30 minutes ago" --no-pager | tail -n 200
- Временно перезапустить сервис корректно:
sudo systemctl restart myapp.service
Смысл: вы не «лечите вслепую», а собираете картину. Если после корректного restart симптомы исчезают на короткое время, это часто сигнал о ресурсе/состоянии приложения (утечка, зависание, накопление очередей), а не о проблеме конфигурации systemd.
Комбинация подходов: когда nice и systemd должны работать вместе
Частая ошибка — надеяться только на один инструмент.
niceуправляет приоритетом конкретного процесса, но не объясняет systemd, когда сервис готов, и не задаёт таймауты остановки.- systemd управляет жизненным циклом, но не гарантирует оптимальное распределение CPU внутри системы, если вы не используете cgroups/лимиты.
Практический подход:
- Уточнить, что именно тормозит: CPU или I/O.
- Если CPU — рассмотреть
nice(или в systemd:CPUWeight,CPUQuota,IOWeightи др., в зависимости от задачи). - Если сервис «падает/рестартится/висит на shutdown» — сначала привести unit-файл к корректной модели жизненного цикла (timeouts,
Type, зависимости). - Только затем углубляться в профилирование приложения.
Выводы
Умение смотреть за процессами в Linux — базовый навык разработчика, особенно когда система уходит из «идеального лабораторного мира» в реальную нагрузку: сеть меняется, диск тормозит, деплой приносит неожиданные состояния, а под нагрузкой всплывают конкурентные баги.
psпомогает получить быстрый снимок: кто сколько потребляет CPU/память, какие состояния у процессов, какие значения nice.topдаёт динамику: позволяет увидеть, что происходит прямо сейчас — рост I/O wait, swap, разрастание CPU по процессам.nice/renice— простой механизм управления CPU‑приоритетом, полезный при конкуренции процессов, но не заменяет анализ I/O и корректные лимиты/политику.- systemd отвечает за жизненный цикл: зависимость при старте, корректную остановку, таймауты, политику рестартов и системную диагностику через
journalctl.
Если вы хотите структурировать это в цельную систему знаний (и быстрее пройти путь от «вижу симптомы» к «понимаю, где искать причину»), как вариант стоит посмотреть материал по теме процессов и systemd в формате учебной траектории на сайте школы: курс. Он может быть полезен как способ собрать практику в логичный порядок, а не собирать команды и примеры по кускам.