Структура и жизненный цикл данных в ML-проекте: dataset, признаки и воспроизводимость
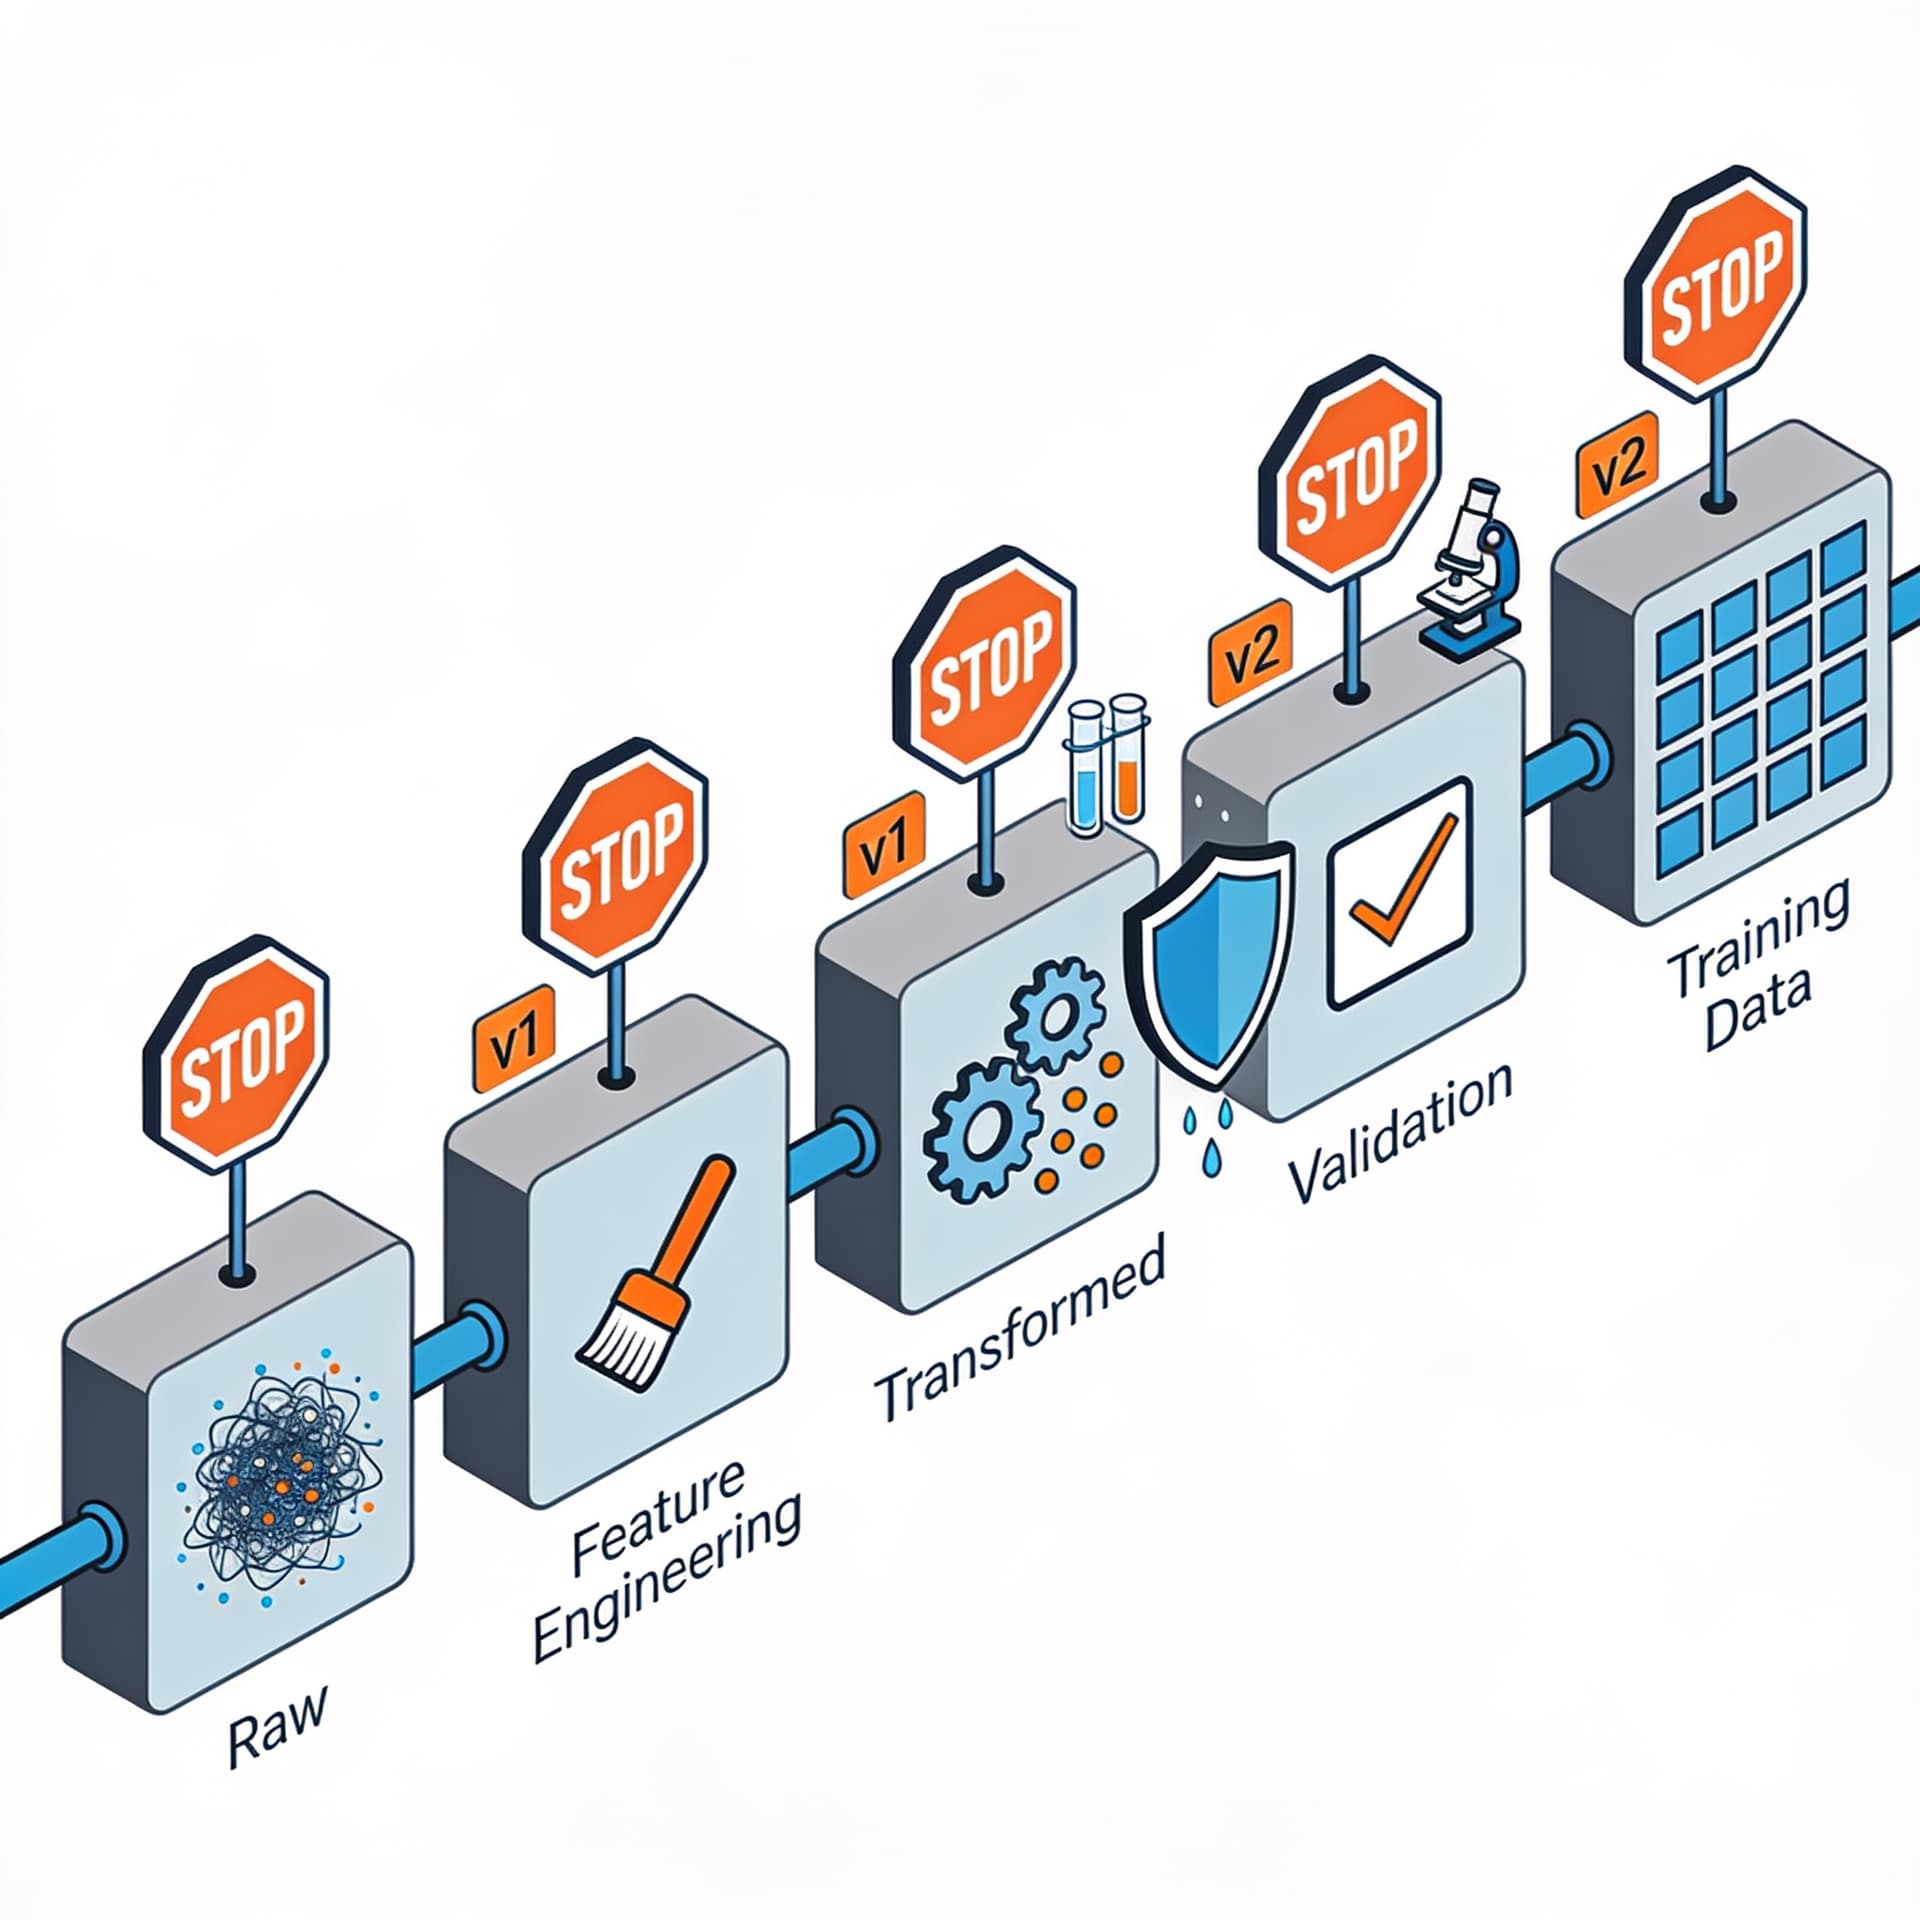
Покажем, как проектировать пайплайн от сырого датасета до признаков и обучающей выборки с контрольными точками и версионированием. Сфокусируемся на воспроизводимости, утечках данных и проверках качества на каждом шаге.
Содержание
В машинном обучении качество модели часто воспринимают как «эффект алгоритма» — выбора архитектуры, гиперпараметров, оптимизатора. На практике же значимая часть успеха и почти вся предсказуемость результата лежит в данных: как мы их получили, как преобразовали, какие признаки извлекли и какую выборку реально использовали для обучения и проверки.
ML-проект — это не один скрипт train.py, а система с жизненным циклом артефактов: сырые данные → очищенные датасеты → признаки → сплиты → обучающие наборы → модель → метрики. Ошибки в этой цепочке особенно неприятны тем, что они часто «выглядят как успех»: утечки данных дают завышенные метрики на валидации, а воспроизводимость ломается после первой итерации.
Ниже — практический разбор, как проектировать пайплайн данных так, чтобы:
- чётко отделять сырьё от производных артефактов;
- контролировать версии на каждом шаге;
- предотвращать утечки и смешивание контекстов;
- валидировать качество промежуточных результатов;
- поддерживать воспроизводимость, чтобы модель можно было переобучить и объяснить, что именно менялось.
Концептуальная модель: что именно является «dataset» в ML
Термин dataset в командах с практикой обычно обозначает разные вещи, и это нужно фиксировать документально. Условно полезно выделить три уровня:
Уровень 0: raw dataset (сырьё)
Это неизменяемые файлы или таблицы, которые вы получили «как есть»: логи, выгрузки из БД, файлы измерений. На этом уровне:
- не делайте преобразования «на месте»;
- не переименовывайте колонки случайно;
- не удаляйте «плохие» строки без фиксации причины.
Сырьё должно быть контентно неизменяемым. Изменения допускаются только через новое «издание» выгрузки (версию), а не «перезапись существующего».
Уровень 1: processed dataset (очищенное и приведённое)
Это результат детерминированной обработки:
- нормализация форматов,
- приведение типов,
- базовая очистка,
- стыковка таблиц,
- агрегирование по ключам,
- фильтрация по бизнес-правилам (с фиксированными критериями),
- формирование «таблицы фактов», пригодной для фиче-инжиниринга.
processed dataset должен быть воспроизводимым: при одинаковой версии raw и одинаковых версиях кода/конфигов результат — тот же.
Уровень 2: feature dataset (матрица признаков + метки)
Это уже конкретное представление данных для обучения конкретной постановки:
- вычисленные признаки (числовые, категориальные, текстовые эмбеддинги и т. п.),
- метки (target),
- служебные поля для сплитов (например,
group_id, временные окна), - индикаторы пропусков и качества,
- и, критически, контроль корректности разбиения.
Именно этот уровень чаще всего и «скрывает» утечки, поэтому к нему особые требования.
Жизненный цикл данных: от сырья до обучающей выборки с контрольными точками
Хороший пайплайн строится как серия шагов, у каждого из которых есть:
- входы (версии raw и зависимостей),
- преобразование (кода+конфиг),
- выход (версионируемый артефакт),
- проверки качества,
- запись метаданных (что получилось, как получено).
Почему контрольные точки обязательны
Без контрольных точек вы обычно обнаруживаете проблемы слишком поздно:
- модель «переобучилась» и метрики выглядят странно;
- после очередной правки вы не можете повторить прошлый результат;
- вы не знаете, где именно произошла утечка.
Контрольные точки позволяют локализовать проблему:
- если качество ухудшилось — сравниваем артефакты на конкретных этапах;
- если изменилась метрика — ищем, какие признаки и какие сэмплы изменились;
- если сломалась воспроизводимость — смотрим версии кода/конфигурации/данных.
Минимальная схема шагов
Шаг A. Ингест (raw acquisition)
- Фиксируем источник: выгрузка дата/время, SQL, параметры, хэши.
- Пишем raw артефакт в immutability-хранилище (S3/FS с версионированием, либо каталог с хэшами).
- Регистрируем метаданные: размер, количество строк, распределение основных полей.
Шаг B. Препроцессинг (processed dataset)
- Типизация, чистка, приведение схемы.
- Согласование ключей между таблицами.
- Нормализация временных меток.
- Результат: processed dataset версии
X.
Шаг C. Feature extraction
- Вычисление признаков в корректной логике времени/контекста.
- Обязательная дисциплина: признаки не должны «видеть» будущее относительно момента prediction.
- Результат: feature dataset версии
Y.
Шаг D. Сплиты (train/valid/test)
- Выбор стратегии разбиения:
- случайное (если нет временной структуры),
- временное (если есть drift/зависимость по времени),
- group-based (если важна группировка пользователя/устройства/сессии),
- stratified (если дисбаланс по классу).
- Результат: индексы/флаги принадлежности к сплитам или отдельные выгрузки.
Шаг E. Обучение
- Используем только feature dataset версии
Yи сплиты изD. - Фиксируем код обучения (версия ML-кода), зависимости, семена.
- Записываем метрики и артефакты модели.
Воспроизводимость: что и как фиксировать, чтобы результат повторялся
Воспроизводимость — это не только random_state=42. Чтобы повторить эксперимент через неделю, нужны минимум три слоя фиксации.
1) Версии данных
Для raw/processed/feature dataset необходимо понимать, какая именно версия использовалась. Практически это:
- хэш содержимого (или хотя бы хэш файлов),
- идентификатор run’а выгрузки,
- лог исходного запроса (если выгрузка из БД),
- список зависимостей (какие датасеты использовались для построения processed).
2) Версии кода и конфигов
Классическая ошибка: вы меняете функцию фичей, а затем пытаетесь повторить результат, не осознавая, что использовалась старая версия. Минимум:
- Git commit hash для кода каждого шага (ingest/transform/features/split/train),
- сериализованный конфиг пайплайна (YAML/JSON),
- версии библиотек (или lockfile).
3) Детерминизм вычислений
Даже при одинаковых данных и коде могут быть недетерминизмы:
- параллелизм в preprocessing,
- многопоточность линейной алгебры,
- особенности GPU/операций.
На практике:
- фиксируйте seed на Python/NumPy (и PyTorch/TF если используются),
- ограничивайте многопоточность (если нужно),
- где возможно — используйте детерминированные режимы.
Утечки данных (data leakage): где они рождаются и как их предотвращать
Утечка — это когда в признаки или целевую переменную попадает информация, недоступная на момент предсказания. Частые причины:
Логическая утечка через агрегаты
Пример: вы строите признак «средний доход пользователя за всё время», а метка — доход в следующем месяце. Тогда агрегат включает будущие события пользователя. Правильный вариант — агрегировать только до момента предсказания.
Утечка через нормализацию/скейлинг
Скейлер (mean/std, target encoding, частотная кодировка) должен обучаться только на train-сплите. Если вы посчитали статистики на всём датасете — валидация «подглядывает».
Утечка через выборку для признаков
Иногда признаки зависят от данных, которые мы затем используем в качестве train/valid/test, но без аккуратной фильтрации по времени или по группам. Например:
- вы обучаете word2vec/TF-IDF на всей базе текстов, включая test;
- вы делаете oversampling на всём датасете.
«Скрытые» утечки через join’ы
Два табличных источника иногда связаны через ключи, но на момент предсказания один из источников ещё не существовал или содержал меньше данных. Если это не учтено временным срезом — join может «внести будущее».
Проверки качества на каждом шаге: от здравого смысла до автоматизированных тестов
Чтобы пайплайн был надёжным, нужны проверки. Обычно их делят на три категории.
1) Схемные проверки (schema & contracts)
- все обязательные колонки присутствуют;
- типы колонок корректны;
- диапазоны значений не выходят за ожидания;
- уникальность ключей на ожидаемом уровне (например, «одна строка на событие»).
2) Статистические проверки (data drift & distribution)
- сравнение распределений ключевых признаков между версиями processed/feature;
- контроль доли пропусков;
- проверка меток: баланс классов, средние значения;
- контроль размеров сплитов.
3) Контроль корректности сплитов и утечек
- отсутствие пересечений
group_idмежду train и valid (если требуется group split); - отсутствие пересечений идентификаторов пользователей/устройств;
- проверка временного порядка: максимальное время в train < минимальное время в valid/test (для time split);
- для агрегатных фичей — проверка, что «используемые события» лежат в допустимом окне до момента предсказания.
Важно: тесты должны падать до обучения, иначе вы получите «дорогую диагностику» уже после того, как ошибку не исправить без регенерации признаков.
Проектирование данных для воспроизводимого сплитинга
Разбиение на train/valid/test — часть пайплайна данных, а не «пункт настройки в обучении». Это особенно верно для:
- временных задач,
- группировок (пользователь/устройство),
- задач с несколькими наблюдениями на один объект.
Сплит по времени
Если задача предсказывает событие в момент t, то train должен содержать только наблюдения с временами < t_cutoff. На уровне кода это выглядит как генерация масок на feature dataset:
import pandas as pd

def time_split(df: pd.DataFrame, time_col: str, cutoff: str):
    cutoff_ts = pd.to_datetime(cutoff)
    train_mask = pd.to_datetime(df[time_col]) < cutoff_ts
    valid_mask = pd.to_datetime(df[time_col]) >= cutoff_ts
    return df.loc[train_mask].copy(), df.loc[valid_mask].copy()
Но это лишь каркас. Важно также:
- фиксировать
cutoffв конфиге, - логировать, сколько строк ушло в каждый сплит,
- проверять, что целевая метка действительно соответствует временному определению задачи.
Group split без пересечений
Если один user_id фигурирует и в train, и в valid — утечка почти гарантирована (модель может запомнить пользователя). Тогда сплит должен быть по группам:
import numpy as np
from sklearn.model_selection import GroupShuffleSplit

def group_split(df, group_col, test_size=0.2, random_state=42):
    splitter = GroupShuffleSplit(n_splits=1, test_size=test_size, random_state=random_state)
    groups = df[group_col].values
    idx = np.arange(len(df))
    train_idx, valid_idx = next(splitter.split(idx, groups=groups))
    return df.iloc[train_idx].copy(), df.iloc[valid_idx].copy()
Проблема тут не в коде, а в дисциплине: split должен выполняться на том же feature dataset версии, что и последующее обучение, и должен быть воспроизводимым (seed + фиксированные входные данные).
Фиче-инжиниринг как версионируемый «детерминированный компилятор»
Фичи — это не просто инженерные преобразования. Это отдельный «компилятор», который:
- берёт processed dataset,
- применяет правила,
- возвращает feature dataset.
Чтобы пайплайн был воспроизводимым, вычисление фичей должно быть:
- детерминированным,
- параметризованным через конфиг,
- версиям подлежать не только данные, но и логика.
Детерминизм в признаках
Даже в “обычных” функциях легко получить недетерминизм:
- итерации по словарям (если порядок не фиксирован),
- сортировки с одинаковыми ключами без тай-брейкера,
- операции с float и неопределённым округлением.
Решение: фиксируйте сортировки (sort_values с явно заданными ключами), нормализуйте типы, используйте стабильные процедуры и сохраняйте параметры (например, списки топ-N категорий).
Фичи, зависимые от времени: rolling окна и «as-of»
Самая частая утечка в фичах — это агрегирование «по всей истории». Для корректного поведения используйте as-of логику: для момента предсказания берём только события до него.
Схема на pandas (упрощённо):
import pandas as pd

def add_user_event_count_asof(
    events: pd.DataFrame,
    entities: pd.DataFrame,
    user_col: str,
    time_events: str,
    time_entity: str,
    window_days: int | None = None
):
    """
    entities: строки "момент предсказания" (например, запросы пользователя)
    events: таблица событий пользователя (история)
    Возвращает entities с признаком count событий до time_entity.
    """
    events = events[[user_col, time_events]].copy()
    entities = entities[[user_col, time_entity]].copy()

    events[time_events] = pd.to_datetime(events[time_events])
    entities[time_entity] = pd.to_datetime(entities[time_entity])

    # Для каждой строки entities подсчитаем события до соответствующего времени
    # В проде это лучше делать оптимизированно (например, через merge_asof/индексы),
    # но логика здесь демонстрационная.
    counts = []
    for _, row in entities.iterrows():
        uid = row[user_col]
        t = row[time_entity]
        sub = events[events[user_col] == uid]
        sub = sub[sub[time_events] < t]
        if window_days is not None:
            sub = sub[sub[time_events] >= (t - pd.Timedelta(days=window_days))]
        counts.append(len(sub))

    entities["user_event_count_asof"] = counts
    return entities
Именно такие признаки нужно регулярно тестировать на утечку:
- для каждого сплита проверять, что события для расчёта находятся до момента;
- сравнивать признаковую статистику на краях временного разбиения.
Версионирование артефактов: как связать raw → processed → features → split
Есть два подхода к организации версий данных:
Подход 1: «каталогизация» артефактов
Каждый шаг сохраняет артефакт в каталог с идентификатором версии:
data/raw/v1/...data/processed/vX/...data/features/vY/...
Версия формируется из:
- хэшей raw артефактов,
- конфигов шага,
- git commit хэша.
Плюс: проще встраивать в CI. Минус: легко потерять связь «почему именно так», если метаданные не оформлены.
Подход 2: полноценный pipeline-регистратор (artifact registry)
В этом случае артефакты регистрируются в метаданных (таблица/хранилище), и у каждой сущности есть:
- входы (dependencies),
- параметры,
- хэши,
- результаты проверок качества,
- ссылка на конкретный run.
Плюс: больше управляемости и наглядности для команды. Минус: больше инфраструктуры.
Независимо от подхода ключевая мысль одна: каждому этапу нужен идентификатор, и этот идентификатор должен фигурировать в дальнейшем обучении. Иначе вы теряете причинность: модель обучалась на «каких-то фичах».
Минимальный воспроизводимый каркас пайплайна (пример структуры проекта)
Один из практичных шаблонов структуры репозитория:
pipelines/ingest/preprocess/features/split/train/
configs/preprocess.yamlfeatures.yamlsplit.yamltrain.yaml
data/raw/processed/features/splits/
artifacts/reports/(quality reports)models/
tests/test_schema.pytest_leakage.pytest_splits.py
Каждый модуль должен:
- читать конфиг,
- принимать явные аргументы входов (версии),
- сохранять выход под версией,
- писать quality report (хотя бы в JSON/CSV),
- не менять выход «на лету».
Как проверять утечки автоматически: практичные сценарии
Ниже — типовые проверки, которые реально быстро добавить.