Пайплайн качества кода: от pre-commit до статанализа (чек-лист для команды)
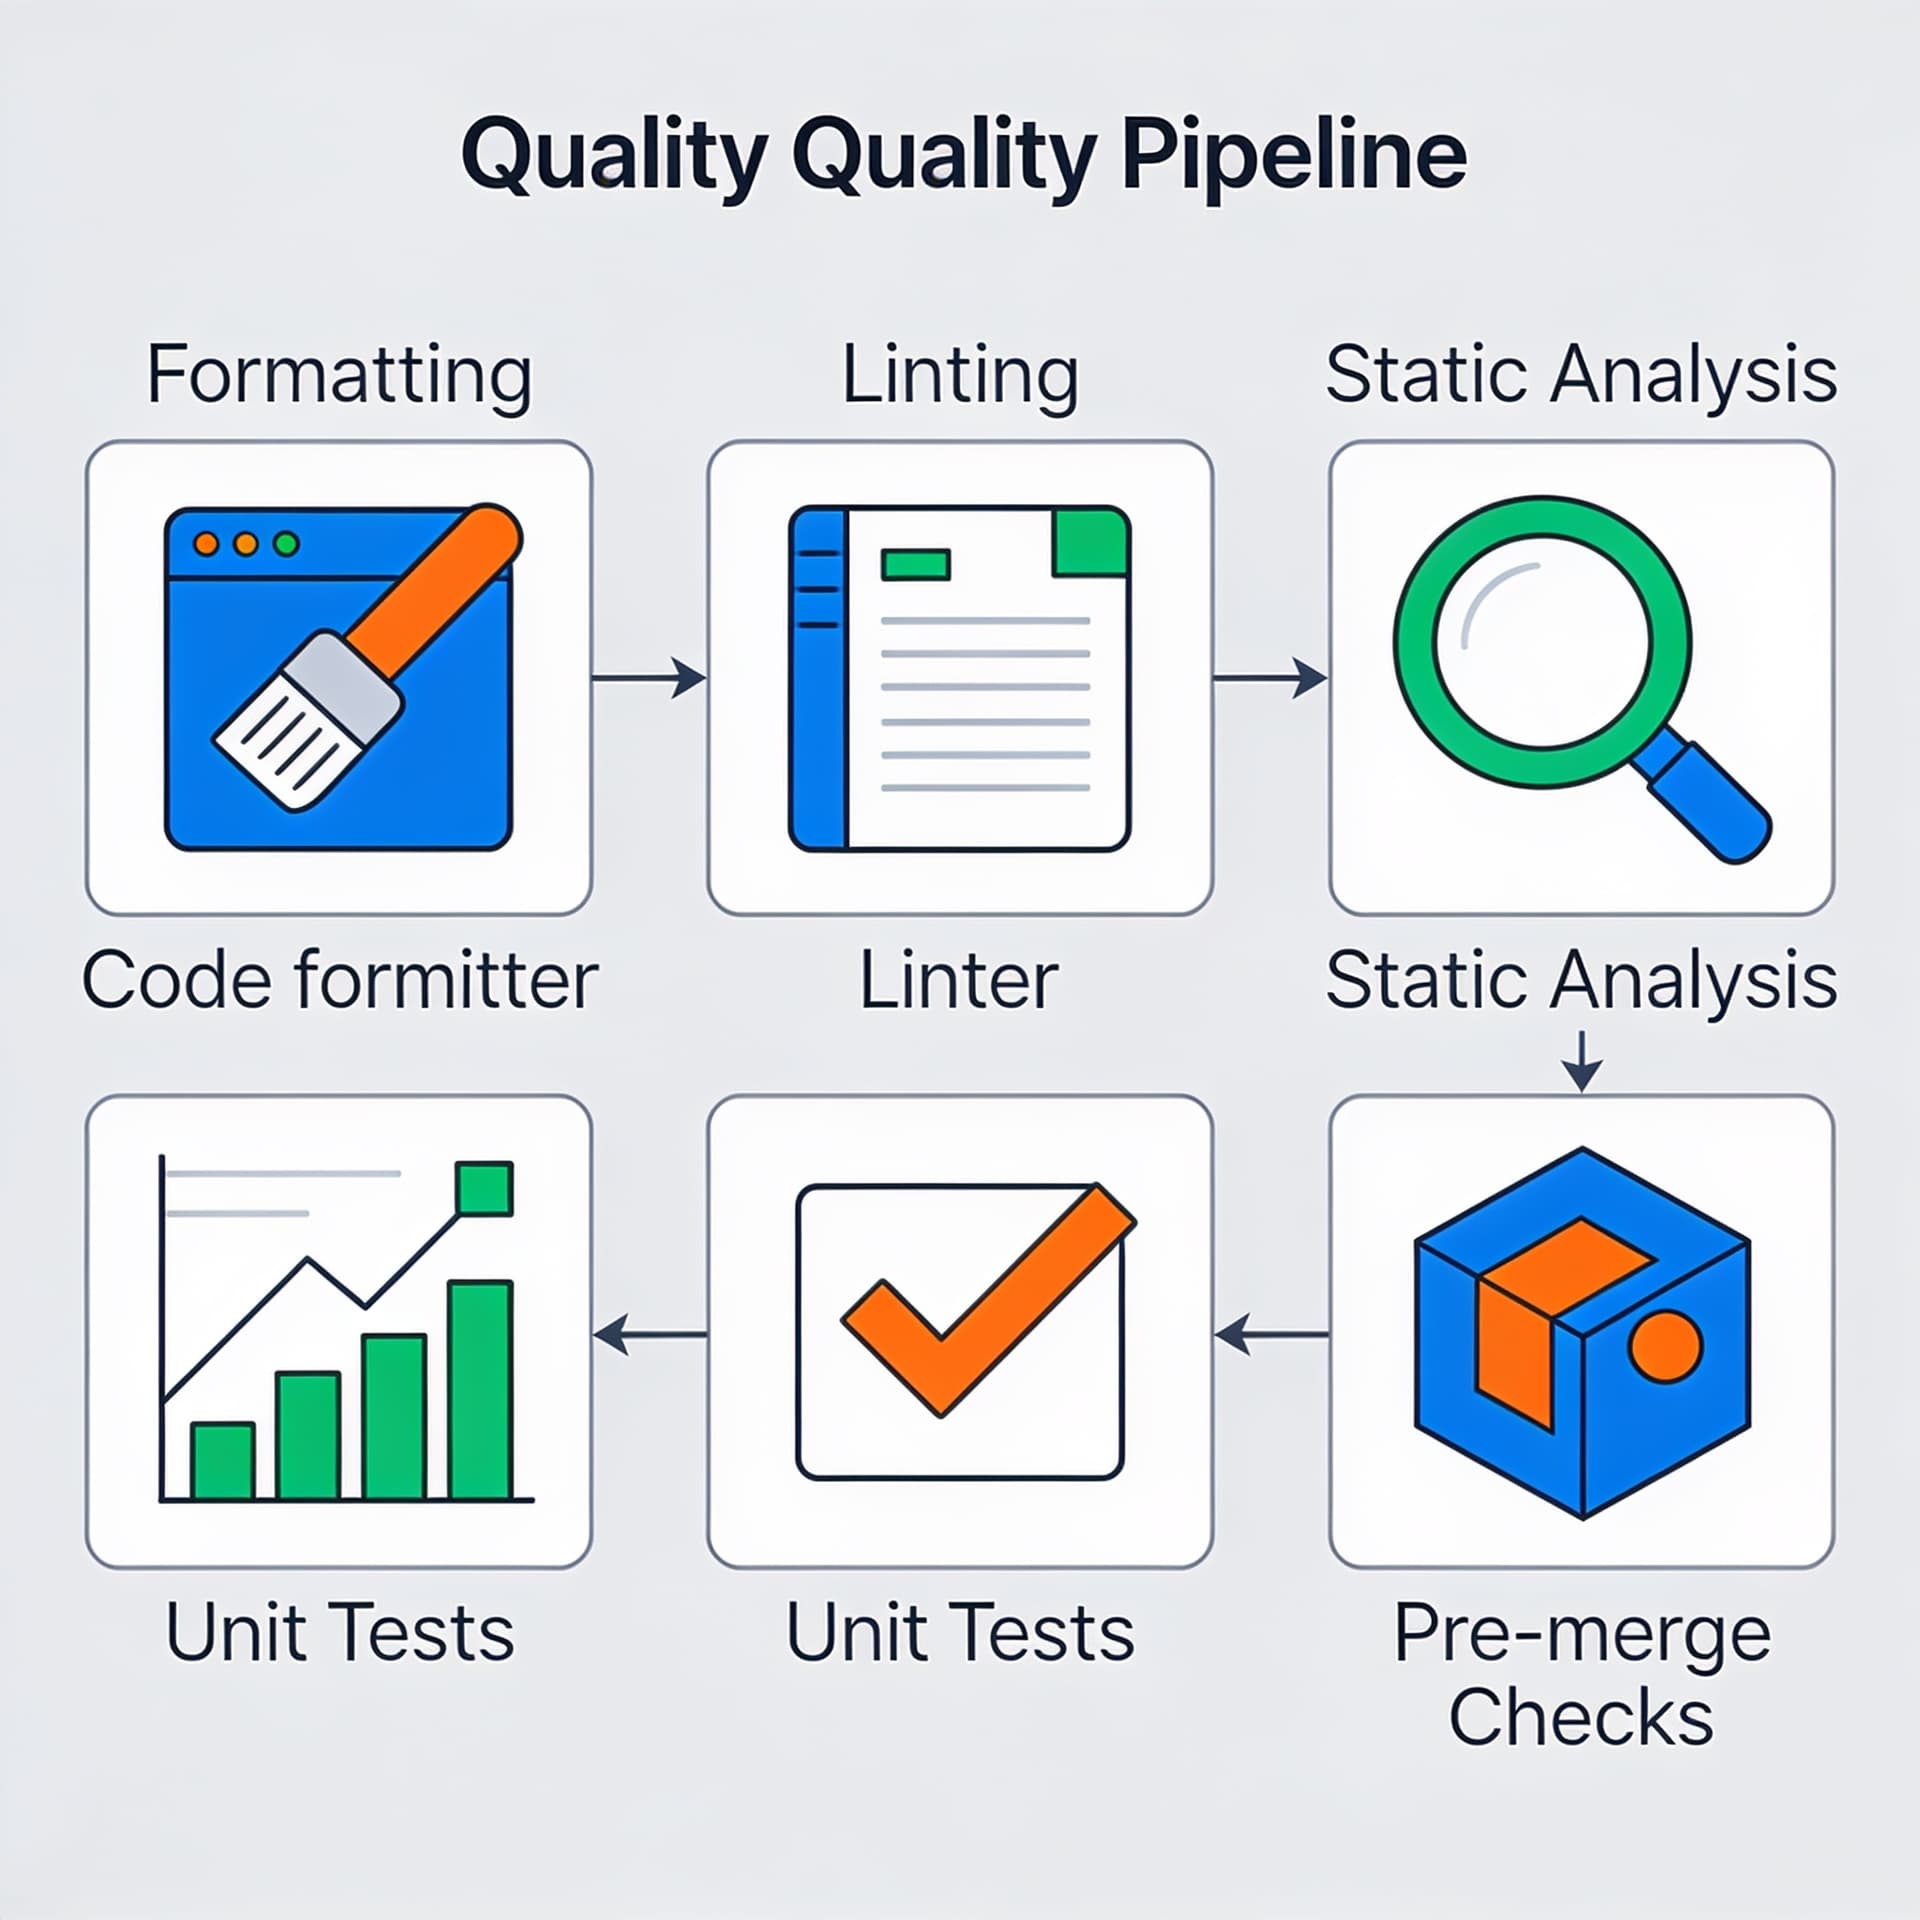
Соберём практичную схему контроля качества: форматирование, линтинг, статанализ, автотесты и проверки перед мерджем. Покажем, как закрепить это в процессах разработки.
Содержание
Качество кода в команде — это не вкусовщина и не «делайте аккуратно». Это управляемая система: набор автоматических проверок, единые правила и понятные механизмы, которые делают “правильно” проще, чем “случайно сломать”. Хорошая новость: большая часть контроля качества сегодня легко автоматизируется и встраивается в процесс разработки — от локальных хуков до CI перед мерджем.
Ниже соберём практичный пайплайн качества кода: форматирование, линтинг, статанализ, автотесты и проверки перед мерджем. Параллельно разберём, как закрепить это в регламентах команды, чтобы проверки действительно работали, а не «пугали красным» в последний момент.
Почему качество нельзя оставить “на совести”
Есть пять типичных сценариев, когда «качество» не становится привычкой:
- Ревью превращается в бесконечные замечания по стилю. Это отнимает время у сильных инженеров и не повышает качество — стиль и так должен быть автоматизирован.
- Линтеры есть, но никто их не запускает локально. В итоге проблемы обнаруживаются только в CI — фидбек запаздывает, разработчик теряет контекст.
- Статанализ начинают “когда-нибудь”. По факту команда получает море предупреждений, которые не договорились трактовать и приоритизировать.
- Тесты написаны, но непредсказуемы. Например, flaky-тесты создают ощущение, что CI «ненадёжен», и его перестают уважать.
- Нет понятного “definition of done”. Даже если есть проверки, непонятно, что считать достаточным уровнем качества для мерджа.
Выход — пайплайн с чёткой структурой: быстрое форматирование → синтаксические и стилевые проверки → более глубокий статанализ → автотесты → контроль компоновки в CI. Плюс договорённость команды: что считаем блокирующим, что — предупреждением, как измеряем прогресс.
Общая архитектура пайплайна
Рациональная схема для большинства проектов выглядит так:
-
pre-commit (локально, до коммита)
- форматирование или автоформатирование (если возможно),
- быстрые проверки линтера,
- проверка конфигураций (например, JSON/YAML),
- минимальный статанализ/проверки, которые не требуют тяжёлого прогона.
-
CI на pull request (перед мерджем)
- полный линтинг (если локальные проверки были быстрыми),
- статанализ (включая тяжёлые правила),
- запуск тестов с отчётами,
- сбор метрик покрытия/качества (опционально, но желательно),
- компиляция/сборка (для языков, где это критично).
-
Качество как контракт
- политика по тому, какие проверки блокируют мердж,
- требования к результатам статанализа,
- стратегия “suppress/waive” (как обрабатывать исключения),
- контроль регрессий: новые нарушения должны не появляться без согласования.
Важно: pre-commit не заменяет CI, он снижает стоимость ошибок и ускоряет фидбек. CI остаётся последним барьером.
Шаг 1. Форматирование как “невидимая” часть
Зачем форматер в пайплайне
Форматирование — это единственный этап, который лучше делать “без вариативности”. Идея проста: команда не спорит о стиле вручную, потому что стиль задаёт инструмент. Тогда ревью концентрируется на логике и архитектуре.
Принципы
- Автоформатирование по месту (если возможно): пусть код приводится к формату автоматически.
- Один источник правды: конфиг форматера должен лежать в репозитории.
- Единый стиль между инструментами: линтер не должен ругать то, что форматер приводит к норме.
Пример: Python (black + isort + pre-commit)
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/psf/black
    rev: 24.4.2
    hooks:
      - id: black
        language_version: python3

  - repo: https://github.com/PyCQA/isort
    rev: 5.13.2
    hooks:
      - id: isort
        name: isort (python)
        language_version: python3

  - repo: https://github.com/pre-commit/mirrors-prettier
    rev: "3.3.3"
    hooks:
      - id: prettier
        files: \.(md|json|yaml|yml|toml)$
В этом примере pre-commit сам прогонит форматеры при коммите. Если команда использует другой стек — принципы те же: форматер должен быть детерминированным.
Шаг 2. Линтинг: быстро поймать “мелкие” дефекты
Что линтинг должен делать
Линтеры хорошо ловят:
- потенциальные ошибки (неиспользуемые переменные, тени имен),
- нарушения стиля (но в связке с форматером),
- анти-паттерны (по правилам),
- качество кода на уровне “локальной” проверяемости.
Что линтеры НЕ должны делать
- Не пытаться заменить статанализ уровня данных/потока.
- Не превращаться в бесконечный список правил, который невозможно поддерживать.
Типичный подход для команды
- Запускайте минимальный набор правил локально (pre-commit).
- Запускайте расширенный набор в CI.
- Держите конфигурацию линтера в репозитории и ревизуйте её так же, как и код.
Пример: ESLint + pre-commit (Node.js)
repos:
  - repo: https://github.com/pre-commit/mirrors-eslint
    rev: v9.0.0
    hooks:
      - id: eslint
        files: \.(js|ts|tsx)$
        args:
          - --max-warnings=0
          - --fix-dry-run
Замечание: --fix-dry-run позволяет увидеть, что линтер “починил бы”, не меняя код. Если вы используете автофикс, тогда часть исправлений лучше делать отдельным шагом (или руками через форматер).
Шаг 3. Статический анализ: глубже, но управляемо
Статический анализ — это слой, который находит то, что линтер может не заметить: неправильные ветвления, ошибки типов (в статически типизированных языках), возможные null/undefined сценарии, проблемы с жизненным циклом объектов, потенциальные утечки и т.д.
Три стратегии интеграции статанализа
- “Жёстко сразу”
Хорошо для новых проектов или если репозиторий чистый. Минус — легко получить огромное количество существующих нарушений и сорвать поток разработки. - “Подчищаем и блокируем”
Сначала запускаем анализ в режиме отчёта, собираем baseline, затем идём итерациями: исправляем часть, затем постепенно включаем блокировку. - “Блокируем только новые нарушения”
Часто самый реалистичный вариант: CI сравнивает текущий PR с baseline (или анализирует изменённые строки/файлы) и блокирует регрессии, не ломая работу над legacy.
Как выбрать инструменты и правила
- Используйте набор правил по умолчанию как старт, но обязательно адаптируйте под домен проекта.
- Избегайте правил, которые дают много “шума” без ценности.
- Договоритесь о трактовке:
errorблокирует мердж,warning— хотя бы видим в отчётах.
Пример: TypeScript (tsc + eslint + “разумный” statanalyze)
В TS часто полезно разделить:
- tsc — проверка типов и синтаксическая целостность,
- eslint — стилистика и частично семантические правила,
- дополнительные инструменты (например, SonarQube, Semgrep и т.д.) — по необходимости.
Сценарий в CI может выглядеть так (упрощённо):
# локально/CI
npm ci
npm run lint
npm run typecheck   # tsc --noEmit
npm run test
А дальше уже отдельно добавляется “глубокий” анализ, который даёт больше полезных находок, но требует контроля ложных срабатываний.
Шаг 4. Автотесты: не просто “наличие”, а доверие к результату
Тесты — это двигатель качества, но только если результат тестов доверенный. Нередко ломают доверие к CI именно тесты.
Минимальная дисциплина
- Стабильность (flake-free): если тест иногда падает без изменений — он подрывает процесс.
- Скорость фидбека: быстрые юнит-тесты должны проходить быстро, интеграционные — по плану.
- Структура по уровням: unit → integration → e2e. Не смешивайте уровни хаотично.
Что тесты должны защищать
- Контракты вход/выход функций и методов.
- Критичные сценарии домена.
- Регрессии (особенно для проблем, которые уже ловили в проде).
Практика: “тесты на changed files”
На больших репозиториях можно запускать только релевантные тесты. Это усложняет инфраструктуру, но сильно ускоряет разработку. Если этого нет — хотя бы выделяйте тестовый набор, чтобы прогон был управляемым (например, test:unit, test:integration).
Пример: Jest (Node.js) — разделение стадий
{
  "scripts": {
    "test:unit": "jest --runTestsByPath test/unit",
    "test:integration": "jest --runTestsByPath test/integration",
    "test": "npm run test:unit && npm run test:integration"
  }
}
Шаг 5. Проверки перед мерджем в CI: сделать “барьер” реальным
CI должен быть последней гарантией. Основные цели:
- воспроизводимость (сборка и запуск должны работать одинаково у всех),
- отсутствие “ручных шагов”,
- единая политика блокировки.
Рекомендуемая последовательность шагов
- Установка зависимостей (с кэшем).
- Формат/линтинг быстрым набором (как часть защиты).
- Typecheck/синтаксическая корректность.
- Статический анализ в полном режиме.
- Сборка (если нужно).
- Тесты (минимальный набор для smoke + полный).
- Публикация артефактов: отчёты (линтер, coverage, статанализ).
Политика блокировки
- Форматирование: либо автоисправление (тогда проверка в CI только убеждает, что “всё отформатировано”), либо блокировка.
- Линтинг: обычно блокирует при нарушениях
error. - Статический анализ: блокирует регрессии и критические ошибки.
- Тесты: блокируют при падении любых обязательных наборов.
Закрепляем процесс: как сделать пайплайн частью “definition of done”
Проблема большинства команд не в том, что у них нет инструментов. Проблема — отсутствие правил игры.
Чек-лист для PR (чёткий, краткий, единый)
Рекомендуемый список, который удобно вставить в шаблон PR или в описание релиза:
До открытия PR
- Локально прогнал
pre-commit run --all-files(или минимум: форматтер + линтер + быстрые тесты). - Код отформатирован и проходит локальные хуки.
- Добавил/обновил тесты для изменения поведения.
В PR
- CI проходит: lint/typecheck/static analysis/tests.
- Нет новых нарушений статанализа (если действует baseline).
- Если есть исключения/waiver — приложено обоснование и ссылка на тикет.
- Для изменений API/контракта есть соответствующие тесты и документация (если требуется).
После мерджа (по необходимости)
- Если были правки правил анализа — обновлён baseline и принято решение, что считать “ошибкой”.
- Если появился flaky-тест — заведен баг с воспроизводимым сценарием.
Как договориться об исключениях (waivers)
Исключения неизбежны, но их нельзя превращать в способ “обойти правило”. Рекомендуется:
- Исключения только на конкретный файл/правило/строку.
- Срок действия: например, waiver действует до следующего релиза или до конкретного тикета.
- Обязательная причина: “почему сейчас нельзя” и “когда исправим”.
Типичные ошибки и подводные камни
1) Слишком много правил сразу
Статанализ и линтеры легко настроить на режим “всё запрещено”. Но если вы включите сотни предупреждений в legacy — команда перестанет воспринимать отчёты как сигнал.
Решение: baseline + постепенное ужесточение + блокировка только новых регрессий.
2) Разный формат между локальным и CI
Человек проходит локальный форматер, но CI ругается на другую конфигурацию или другую версию инструмента.
Решение: фиксировать версии (pin) в конфиге, использовать одни и те же конфиги и команды.
3) Прогон слишком дорогих задач в pre-commit
Если pre-commit запускает тяжёлый статанализ по всему репозиторию — разработчики будут отключать хуки или обходить их.
Решение: локально — быстро; тяжёлое — в CI. Для больших задач можно применять “run only changed”.
4) Flaky-тесты как “норма”
Если тесты иногда падают, люди будут игнорировать CI, и качество деградирует.
Решение: выделяйте flaky в отдельный трекер, диагностируйте причины (тайминги, внешние зависимости), ограничивайте параллелизм при необходимости.
5) Нет метрик и нет прогресса
Если отчёты есть, но никто не смотрит динамику (сколько нарушений ушло/осталось), процесс превращается в ритуал.
Решение: хотя бы раз в спринт смотреть:
- количество статических ошибок по категориям,
- долю новых нарушений,
- время выполнения CI,
- покрытие ключевых модулей (не обязательно “минимум по проекту”, но тенденция важна).
Практический пример пайплайна: “от commit до merge” (агностично)
Ниже — пример логики, как это можно разложить по шагам. Он не привязан к конкретному языку, но отражает типовую структуру.
1) pre-commit (локально)
- format:
prettier/black/gofmt - lint:
eslint/ruff/flake8 - quick static checks:
typecheckна быстрых сценариях (иногда только changed files) - sanity: проверка конфигов (yaml/json), запрет больших файлов, секреты (опционально)
2) CI (pull request)
- install with cache
- full lint
- full typecheck/compile
- static analysis full mode (baseline/regression)
- unit tests + integration tests (по времени)
- publish reports
3) gating rules
- блокировать мердж при:
- падении тестов,
- критических линтер-ошибках,
- регрессиях статанализа,
- нарушении форматирования (или несоответствии “autofix result”).
Чек-лист для команды: готовая “политика качества”
Используйте этот список как основу для внутреннего документа (например, в README репозитория или в Confluence).
Инструменты и запуск
- Есть локальный pre-commit (или аналог) с форматтером.
- Линтер запускается локально и проверяется в CI.
- Есть статический анализ; внедрён baseline или механизм “только новые нарушения”.
- Есть автотесты: unit минимум, интеграционные — по критичности.
- CI проверяет: линтинг, типы/сборку, статанализ, тесты.
- Проверки повторяемы: фиксированы версии инструментов.
Правила и договорённости
- Определено, что блокирует мердж, а что лишь предупреждает.
- Есть регламент для waiver: причина + привязка к тикету + срок действия.
- У команды единая конфигурация (через конфиги в репозитории).
- Статанализ обновляется контролируемо (не “одним PR всё выключить”).
Качество процесса
- Наблюдается прогресс: снижается число нарушений, сокращается шум.
- Тесты не flaky, или есть план по их устранению.
- CI не слишком медленный (и есть стратегия ускорения).
Как внедрять пайплайн без “перелома через колено”
Если вы начинаете с нуля или хотите улучшить существующий процесс, действуйте итерациями:
- Стабилизируйте форматирование
Подключите форматер и убедитесь, что локальные и CI-результаты совпадают. - Добавьте быстрые хуки pre-commit
Минимальный набор, который даёт немедленный фидбек. - Включите линтинг в CI
На старте можно мягко (warnings), но к мерджу должен быть барьер. - Добавьте статанализ через baseline
Начните с отчёта,