Стабильные асинхронные интеграции в Python: таймауты, отмена задач и ретраи без “скрытых” зависаний
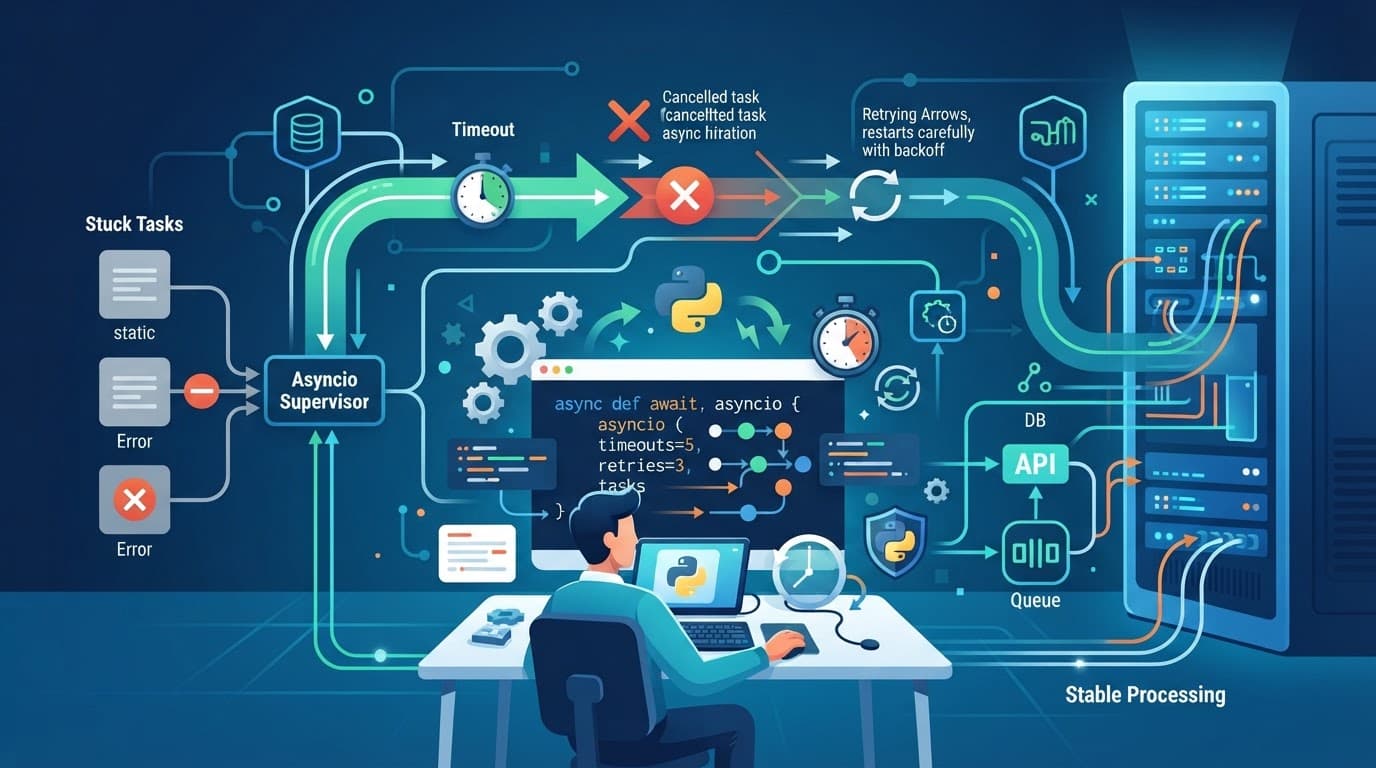
Разберём типовые причины зависаний в async-коде, как правильно выставлять таймауты, как корректно отменять задачи и как строить ретраи так, чтобы при сбоях не разгонять нагрузку и не терять управление ресурсами.
Содержание
Асинхронный Python — удобный инструмент для интеграций: вебхуки, вызовы внешних API, очереди, файловые хранилища, ретраи при сбоях. Но у async есть один неприятный эффект: ошибки и “тихие” зависания часто маскируются под общую «нагрузку» или «подвисание корутин». В результате сервис может перестать отвечать, хотя CPU не обязательно растёт, а логи выглядят «почти нормальными».
В этой статье разберём, почему async-код зависает или деградирует со временем, как правильно проектировать таймауты, как корректно отменять задачи и как строить ретраи без разгона нагрузки и без потери управления ресурсами. Материал ориентирован на asyncio (и типовой стек вроде aiohttp), но принципы применимы и к другим асинхронным фреймворкам.
Почему async-интеграции “зависают”: типовые причины
Под «зависанием» в контексте интеграций обычно подразумевают одно из трёх:
- Корутину ждут бесконечно, потому что таймауты отсутствуют или выставлены неправильно.
- Отмена не работает как ожидается: задачи игнорируют отмену или корректно не освобождают ресурсы (сокеты, соединения, семафоры).
- Ретраи разгоняют нагрузку: при сбоях система начинает производить всё больше запросов и конкурировать за одни и те же ограниченные ресурсы, пока не наступает лавина.
Ниже — наиболее частые источники проблем.
Нет таймаута на уровне “операции”, а не “соединения”
Даже если вы задаёте таймаут на connect, сетевой вызов может “висеть” на чтении тела ответа или на внутренних ожиданиях. В HTTP это особенно заметно: TCP-соединение установилось, но сервер не отдаёт данные.
Правило: таймаут должен покрывать весь жизненный цикл запроса (или хотя бы критичную часть — например, получение заголовков и тела).
Таймауты слишком короткие или несогласованные
Слишком маленький таймаут для внешнего API приводит к постоянным ретраям, а это может:
- увеличить долю ошибок;
- создать дополнительную конкуренцию за соединения;
- забить event loop обработкой отмен/повторных задач.
Слишком длинные таймауты, наоборот, держат “висящие” корутины и потребляют лимиты (например, пул соединений), из‑за чего остальные запросы начинают ждать.
Правило: таймауты должны соответствовать SLA внешнего сервиса и вашим внутренним лимитам. На практике полезно разделять:
- таймаут соединения,
- таймаут на ожидание заголовков,
- таймаут на чтение тела,
- общую “операционную” длительность.
Отмена задачи не приводит к завершению работы
В asyncio отмена реализуется через task.cancel(), а внутри корутины обычно происходит выброс asyncio.CancelledError. Но это срабатывает корректно только если:
- вы не перехватываете
CancelledErrorслишком широко; - вы не блокируете event loop синхронными операциями;
- вы освобождаете ресурсы в
finally.
Типичная ошибка — перехватывать Exception и продолжать работу, тем самым “поглощая” отмену.
Зависание из-за семафоров и “утечек” слотов
Если вы используете asyncio.Semaphore (или ограничение пула соединений) и забываете освобождать слот при отмене, вы получите классическую проблему: после серии отмен слот не возвращается, и новые запросы начинают блокироваться навсегда.
Правило: любые “занятые ресурсы” (семафоры, блокировки, контексты соединений) освобождаются в finally, а лучше — через контекстные менеджеры.
Подмена “доказуемых” ретраев на бесконечные циклы
Иногда ретраи делают вида:
while True:
    try:
        return await call()
    except TimeoutError:
        continue
Это гарантированный рецепт для каскадных зависаний: вы потеряете контроль над количеством попыток и временем жизни операции.
Правило: ретраи ограничиваются по числу попыток и/или по общему бюджету времени. Плюс обязательно нужен бэкофф.
Таймауты: как выставлять правильно и предсказуемо
Базовый принцип: таймауты должны быть “документированы” в коде
Стабильность начинается с того, что таймауты явно видны в интерфейсе функции. Это означает, что функция, которая делает внешний запрос, должна принимать параметры таймаута (или хотя бы ссылаться на конфигурацию), а не прятать их внутри “как-нибудь”.
asyncio.timeout: единая точка контроля
В современных версиях Python есть контекстный менеджер asyncio.timeout() — удобный и более читаемый способ задать таймаут на блок кода.
Пример: обёртка над интеграцией с внешним HTTP API (без привязки к конкретной библиотеке):
import asyncio
from typing import Any, Dict

async def fetch_json(url: str, client, *, timeout_s: float) -> Dict[str, Any]:
    async with asyncio.timeout(timeout_s):
        resp = await client.get(url)
        # Важно: весь сценарий (включая чтение ответа) должен быть внутри таймаута
        data = await resp.json()
        return data
Ключевой момент: таймаут охватывает весь путь, где возможна задержка: ожидание сети, чтение, парсинг (если он асинхронный).
Раздельные таймауты: когда это нужно
Если вы работаете с HTTP библиотекой, которая поддерживает раздельные таймауты (например, на connect/read), лучше использовать их. Тогда вы не “схлопываете” разные причины задержки в один общий таймаут и проще анализируете метрики.
Условная схема:
connect_timeout— сколько времени ждать установку соединения;sock_read_timeout— сколько ждать данные;total_timeout— ограничение на всю операцию (полезно как страховка).
Важно: различайте таймауты и ошибки отмены
asyncio.timeout() при истечении генерирует исключение TimeoutError (фактически asyncio.TimeoutError). А отмена задачи снаружи приводит к asyncio.CancelledError.
Правило: при построении ретраев обычно вы ретраите таймауты и сетевые ошибки, но не отмену задачи. Иначе вы превратите “управляемую отмену” в “бесконечные попытки, пока task.cancel не перестанет быть актуальным”.
Отмена задач: как отменять “по контракту” и не оставлять мусор
Корректная отмена — это не просто вызов task.cancel(). Это договорённость между вызывающим и вызываемым кодом: отмена либо:
- быстро останавливает операцию,
- либо гарантированно освобождает ресурсы и возвращает управление.
Контракт: что должно происходить при отмене
Хороший контракт для интеграционной функции:
- При
CancelledErrorфункция не продолжает ретраи. - Всегда выполняются
finally, где освобождаются ресурсы. - Если есть незавершённые дочерние задачи — их отменяют тоже.
Паттерн: отмена в “finally” и повторная проброска
Пример структуры для операции, которая использует семафор и делает сетевой запрос:
import asyncio

async def limited_call(semaphore: asyncio.Semaphore, func, *args, **kwargs):
    await semaphore.acquire()
    try:
        return await func(*args, **kwargs)
    finally:
        semaphore.release()
Этот код освобождает слот даже при отмене, но лучше делать ещё аккуратнее через контекстный менеджер (если вы его реализуете), потому что acquire()/release() легко забыть.
Если вы перехватываете исключения — не забудьте пробросить CancelledError:
async def robust_call(semaphore: asyncio.Semaphore, func, *args, **kwargs):
    async with semaphore:  # release гарантирован
        try:
            return await func(*args, **kwargs)
        except asyncio.CancelledError:
            # Отмена — это сигнал, а не ошибка сети
            raise
Почему нельзя глушить CancelledError
Если вы сделаете:
try:
    ...
except Exception:
    ...
то CancelledError часто попадёт внутрь Exception? В современных версиях CancelledError наследуется от BaseException, но на практике реальная ошибка — “поглощение отмены” через слишком широкий except. Даже когда тип не попадает, разработчики иногда делают except BaseException: или “собирают” отмену логом и продолжают работу. Любая попытка “обработать отмену как обычную ошибку” ломает систему остановки.
Практика: в интеграциях всегда явно выделяйте отмену:
except asyncio.CancelledError:
    raise
except TimeoutError:
    ...
except Exception as e:
    ...
Отмена группы задач: аккуратность с gather
При отмене группы задач важно понимать, что asyncio.gather(..., return_exceptions=False) при отмене одной из задач может бросить исключение и прервать ожидание. Поэтому при “управлении жизненным циклом” используйте сценарии с явной отменой всех задач и корректной обработкой результатов.
Ретраи без разгона: стратегии, бэкофф и бюджет попыток
Ретраи — это не “повторить 3 раза”. Это управление рисками: вы увеличиваете вероятность успеха, но также увеличиваете нагрузку и время ответа системы при деградации внешнего сервиса.
Золотая тройка: ограничение попыток, ограничение времени, бэкофф
Для стабильности ретраев нужны три компонента:
- max_attempts — максимум попыток.
- max_total_time или общий бюджет времени.
- Exponential backoff с jitter — чтобы не синхронизировать ретраи тысяч клиентов.
Jitter: почему “просто экспоненциальный бэкофф” иногда всё равно ломает
Если все клиенты начинают ретраить одновременно, то даже бэкофф с фиксированными интервалами может создать “ритмические” пики. Jitter добавляет случайность.
Рекомендуемая схема:
delay = base * 2**(attempt-1)delay *= random.uniform(0.5, 1.5)(или другой диапазон)- ограничить
delayсверху (max_delay).
Пример: ретраи с таймаутом, бюджетом и корректной отменой
Ниже — практичный шаблон: функция retryable принимает асинхронный callable, таймаут на одну попытку, и список исключений для ретраев.
import asyncio
import random
from typing import Awaitable, Callable, Type, Tuple, Optional, Any

RetryExc = Tuple[Type[BaseException], ...]

async def retryable(
    op: Callable[[], Awaitable[Any]],
    *,
    max_attempts: int = 5,
    max_total_time_s: float = 20.0,
    per_attempt_timeout_s: float = 5.0,
    retry_on: RetryExc = (TimeoutError, ConnectionError, OSError),
    base_delay_s: float = 0.2,
    max_delay_s: float = 3.0,
) -> Any:
    start = asyncio.get_running_loop().time()

    attempt = 1
    while True:
        elapsed = asyncio.get_running_loop().time() - start
        if attempt > max_attempts or elapsed >= max_total_time_s:
            raise TimeoutError(f"Retry budget exhausted after {attempt-1} attempts, elapsed={elapsed:.2f}s")

        try:
            async with asyncio.timeout(per_attempt_timeout_s):
                return await op()

        except asyncio.CancelledError:
            # Отмена — всегда мгновенно прекращаем работу
            raise

        except retry_on as e:
            attempt += 1
            elapsed = asyncio.get_running_loop().time() - start
            if attempt > max_attempts or elapsed >= max_total_time_s:
                raise

            # Экспоненциальный backoff + jitter
            delay = min(max_delay_s, base_delay_s * (2 ** (attempt - 2)))
            delay *= random.uniform(0.5, 1.5)

            # Не спим бесконечно: сон внутри общей задачи должен уважать отмену
            try:
                await asyncio.sleep(delay)
            except asyncio.CancelledError:
                raise

        except Exception:
            # Любую другую ошибку не ретраим: пробрасываем наверх
            raise
Что этот шаблон уже защищает
- Не будет бесконечного цикла.
- Общий бюджет времени ограничивает “застревание” при медленном внешнем сервисе.
- Отмена не превращается в ретраи.
- Jitter снижает вероятность синхронных пиков.
- Пер-операционный таймаут гарантирует, что одна попытка не будет висеть слишком долго.
Важный нюанс: ретраить только то, что реально “должно быть” ретраено
Ретраить всё подряд — плохая идея. Например:
- HTTP 4xx (кроме некоторых 429/408) часто не являются ретраируемыми при тех же параметрах.
- Явная бизнес-ошибка (валидация payload) ретраями не лечится.
- Ошибки авторизации (401/403) ретраями не лечатся.
Поэтому на практике обычно делают маппинг:
- какие исключения ретраим,
- какие HTTP статусы считаем ретраируемыми,
- какие — нет.
Интеграции “под нагрузкой”: очереди, лимиты параллелизма и пул соединений
Даже идеально настроенные таймауты и ретраи не спасут, если вы не управляете параллелизмом.
Семафор как инструмент обратного давления
Если у вас много входящих событий и вы создаёте много сетевых задач, без лимита вы:
- исчерпаете файловые дескрипторы/сокеты,
- перегрузите внешний сервис,
- начнёте ловить лавины таймаутов.
Семафор или очередь с ограничением — простой механизм обратного давления.
Пример: ограничиваем параллельные интеграции:
import asyncio

semaphore = asyncio.Semaphore(20)

async def process_one(event, client):
    async with semaphore:
        return await retryable(
            lambda: fetch_remote(event, client),
            max_attempts=5,
            per_attempt_timeout_s=4.0,
        )
Пул соединений — не “желательно”, а “необходимо” для предсказуемости
Если вы делаете aiohttp.ClientSession (или аналоги), обычно:
- держите один session на процесс/сервис,
- используйте keep-alive,
- ограничивайте количество одновременных соединений (в настройках клиента).
Иначе на ретраях вы ещё и создадите массу новых соединений и ускорите деградацию.
Очередь ретраев может быть хуже, чем кажется
Некоторые строят ретраи через повторное помещение в очередь. Это иногда нужно (например, при длительных задачах), но важно помнить:
- ретраи через очередь могут породить “вечные” элементы, если не учитывать TTL;
- при остановке сервиса вам нужно гарантировать корректную отмену воркеров и завершение работы.
Если вы используете очереди — добавляйте TTL и dead-letter подход.
Как диагностировать скрытые зависания: что логировать и как проверять
Стабильность — это не только код, но и наблюдаемость. Несколько практичных идей.
Логируйте попытки ретраев с контекстом, но не шумите
Для каждой попытки логировать слишком детально часто вредно. Достаточно:
- номер попытки,
- причина (тип исключения + кратко сообщение),
- какая задержка перед следующей попыткой,
- таймауты.
Пример:
import logging
logger = logging.getLogger(__name__)

# внутри except retry_on as e:
logger.warning("Remote call failed (%s). attempt=%s/%s delay=%.2fs",
               type(e).__name__, attempt, max_attempts, delay)
Метрики: таймауты, ретраи, отмены, время запроса
Минимальный набор:
- count таймаутов (per endpoint),
- count ретраев (и распределение попыток),
- count отмен задач (как признак остановки/перегрузки),
- histogram длительности попытки и общей операции.
Если вы видите рост ретраев и одновременный рост длительности — это сигнал деградации внешней системы или проблем с лимитами параллелизма.
Трейсинг “жизненного цикла” задачи
Полезно иметь correlation id и видеть:
- когда задача стартовала,
- какой был пер-попыточный таймаут,
- сколько фактически заняло времени до отмены/успеха.
Полный пример: надёжная HTTP-интеграция с таймаутами и ретраями
Ниже — цельная заготовка. Предположим, что у вас есть client, который умеет делать get(url, ...) и возвращает ответ с status и json().
import asyncio
import aiohttp
import random
from typing import Any, Callable, Awaitable, Tuple, Type

RetryExc = Tuple[Type[BaseException], ...]

async def retryable(
    op: Callable[[], Awaitable[Any]],
    *,
    max_attempts: int = 5,
    max_total_time_s: float = 20.0,
    per_attempt_timeout_s: float = 4.0,
    retry_on: RetryExc = (TimeoutError, aiohttp.ClientError),
    base_delay_s: float = 0.2,
    max_delay_s: float = 3.0,
) -> Any:
    start = asyncio.get_running_loop().time()
    attempt = 1

    while True:
        elapsed = asyncio.get_running_loop().time() - start
        if attempt > max_attempts or elapsed >= max_total_time_s:
            raise TimeoutError(f"Retry budget exhausted after {attempt-1} attempts, elapsed={elapsed:.2f}s")

        try:
            async with asyncio.timeout(per_attempt_timeout_s):
                return await op()

        except asyncio.CancelledError:
            raise

        except retry_on as e:
            attempt += 1
            elapsed = asyncio.get_running_loop().time() - start
            if attempt > max_attempts or elapsed >= max_total_time_s:
                raise

            delay = min(max_delay_s, base_delay_s * (2 ** (attempt - 2)))
            delay *= random.uniform(0.5, 1.5)
            await asyncio.sleep(delay)

async def fetch_and_validate(
    session: aiohttp.ClientSession,
    url: str,
    *,
    per_attempt_timeout_s: float,
    status_for_retry: set[int] = {429, 500, 502, 503, 504},
) -> dict[str, Any]:
    async with session.get(url) as resp:
        # Здесь важна логика ретраев по HTTP-статусам.
        if resp.status in status_for_retry:
            # Поднимем исключение, которое поймается в retryable
            raise aiohttp.ClientResponseError(
                request_info=resp.request_info,
                history=resp.history,
                status=resp.status,
                message=f"Retryable status: {resp.status}",
                headers=resp.headers,
            )

        resp.raise_for_status()
        return await resp.json()

async def integrate(url: str) -> dict[str, Any]:
    timeout_total_budget_s = 20.0
    per_attempt = 4.0

    # В реальном коде session лучше держать на уровне приложения.
    async with aiohttp.ClientSession() as session:
        return await retryable(
            lambda: fetch_and_validate(
                session,
                url,
                per_attempt_timeout_s=per_attempt,
            ),
            max_attempts=5,
            max_total_time_s=timeout_total_budget_s,
            per_attempt_timeout_s=per_attempt,
            retry_on=(aiohttp.ClientError,),
        )

# usage:
# result = await integrate("https://api.example.com/data")
Этот пример показывает важные детали:
retryableконтролирует жизненный цикл попыток, таймаут и отмену.- Валидация HTTP статусов встроена в
fetch_and_validate. - Отмена (
CancelledError) пробрасывается наверх и не превращается в ретраи.
Типичные ошибки при проектировании “надёжного async”
1) Таймаут выставлен, но чтение тела вне таймаута
Если вы делаете async with timeout(...): только вокруг client.get(), но не вокруг resp.json() или чтения стрима, то зависание может происходить на чтении.
2) Перехватываете Exception и продолжаете работу после отмены
Потеря CancelledError — частая причина “почему при выключении сервиса всё равно не останавливается”.
3) Ретраите без джиттера и без ограничения общей длительности
Внешняя деградация превращается в локальную деградацию через синхронизацию ретраев и каскады ожиданий.
4) Нет обратного давления (лимита параллельности)
Даже хороший retry-политик при отсутствии лимитов превращает сервис в генератор запросов.
5) Семафор освобождается не в finally
Любая ветка кода, где “забывается” release, приводит к деградации со временем. В async это часто всплывает не сразу, а после нескольких отмен/ошибок.
Вывод: стабильность — это контракт, а не набор “best practices”
Стабильные асинхронные интеграции в Python строятся из нескольких контрактов:
- Таймауты должны покрывать реальный участок задержки и быть согласованы с логикой ретраев.
- Отмена задач должна уважаться и не превращаться в ретраиваемую “ошибку”.
- Ретраи должны иметь ограничение по попыткам и времени, бэкофф с джиттером и ретраить только то, что действительно может быть восстановлено.
- Лимиты параллелизма и пул ресурсов защищают систему от лавины при деградации внешних сервисов.
Если вы хотите углубиться в системный подход к асинхронным интеграциям — включая то, как проектировать таймауты, политики ретраев и архитектуру наблюдаемости, — полезно посмотреть курс по теме на /course/ (в формате, где можно последовательно разобрать практические шаблоны и типовые провалы).
Впрочем, даже без курса ключ к предсказуемости — это дисциплина: явные таймауты в коде, корректная обработка CancelledError, ограниченные ретраи и контроль параллелизма. Когда эти элементы на месте, async перестаёт быть “чёрным ящиком” и начинает работать как инженерный инструмент.