Системный дебаг памяти и производительности в Python: где искать утечки и как проверять гипотезы
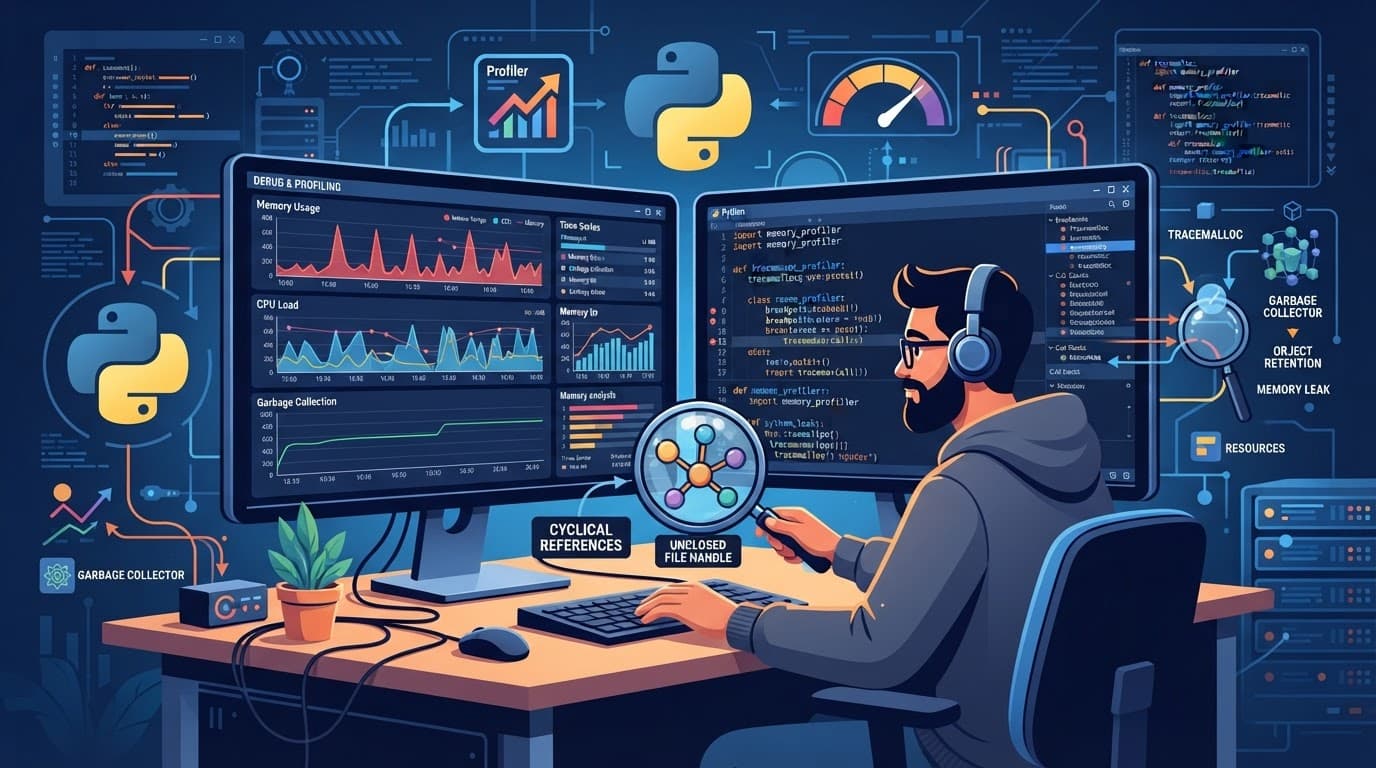
Пошагово разберём типовые причины роста памяти (кэширование, циклические ссылки, удержание объектов в замыканиях, неверная работа с ресурсами) и как подтверждать догадки трейсами, профилировщиками и метриками. В конце — чек-лист расследования для задач из
Содержание
Проблемы с памятью и производительностью в Python редко выглядят как “одна очевидная ошибка”. Чаще это системный эффект: где-то забыли закрыть ресурс, где-то непреднамеренно удержали объекты дольше нужного, где-то накапливаются кэш-структуры или циклические ссылки не дают сборщику освободить память вовремя. В продакшене это проявляется как рост RSS, рост времени пауз GC, деградация латентности, “пилообразный” график или внезапные всплески после определённых событий.
Ниже — практический, пошаговый подход к расследованию. Я буду говорить не только о “как профилировать”, но и о том, как строить и проверять гипотезы: какие метрики собирать, какие инструменты подключать, как интерпретировать результаты и что делать, если данные противоречат ожиданиям.
Как отличить утечку памяти от накопления “рабочего” кэша
Прежде чем ковырять код, полезно понять природу наблюдаемого симптома.
Метрики, которые стоит фиксировать сразу
В продакшене обычно уже есть часть данных, но лучше собрать “минимальный набор”:
- RSS / memory usage по процессу (system level): растёт ли постоянно или после всплесков откатывается?
- Resident memory vs Heap: в Python heap и память на уровне ОС — не всегда одно и то же (из-за аллокаторов, arena/obmalloc, буферов, mmap).
- GC metrics:
gc.get_count()(количество коллекций/попыток на уровнях поколений),gc.get_stats()(если включены).
- Время/частота GC: долгие паузы часто маскируют другие проблемы.
- Число объектов определённых типов (например, списков, dict, экземпляров конкретных классов) — через
tracemallocили сторонние метрики. - CPU и контекст переключений: иногда “утечка” — это просто рост вычислительной нагрузки и накопление очередей.
Типовые паттерны
-
RSS растёт монотонно и не возвращается — чаще всего:
- реальные утечки (ссылки остаются живыми),
- неосвобождённые буферы/ресурсы,
- рост внутренних структур или глобальных кэшей,
- проблемы с native-ресурсами (C-расширения, библиотеки, которые удерживают память вне Python heap).
-
RSS растёт “пилой” и откатывается — вероятно, это:
- аллокатор держит arena (не освобождает ОС),
- циклы и задержка GC,
- кэширование, которое работает с разными ключами.
-
Heap растёт, но RSS нет — бывает, когда объекты остаются в памяти процесса, но аллокатор ограничивает отдачу ОС.
-
GC паузы растут при стабильном RSS — возможны:
- большое количество циклических ссылок,
- чрезмерная аллокация “короткоживущих” объектов,
- высокая нагрузка на генерации GC.
Инструменты: что подключать в первую очередь
tracemalloc для “откуда берётся память”
tracemalloc даёт трассировку аллокаций на уровне Python-heap. Он помогает подтвердить, что “память растёт из X”, и связать это с конкретными строками кода.
Минимальный сценарий:
import tracemalloc
import time

tracemalloc.start(25)  # n: сколько кадров трассы держать

# ... прогон вашего кода/нагрузки ...
time.sleep(5)

snapshot = tracemalloc.take_snapshot()
top = snapshot.statistics('traceback')

for stat in top[:20]:
    print(stat)
Что важно:
- сравнивайте снимки “до” и “после” одного известного события (запрос, обработка очереди, батч).
- фильтруйте по доменам/модулям: часто десятки причин, но интересны 1–3.
Пример сравнения:
import tracemalloc

tracemalloc.start(25)

snap1 = tracemalloc.take_snapshot()

# триггер события
# ...

snap2 = tracemalloc.take_snapshot()

stats = snap2.compare_to(snap1, 'lineno')
for s in stats[:15]:
    print(s)
Профилировщики: “что реально делает CPU” и где узкие места
Память ≠ производительность, но одно часто маскирует другое.
- PyInstrument (быстрое и удобное дерево вызовов).
- cProfile / pstats (классика, хорошо для статистики по функциям).
- yappi (быстрый in-process профайлинг, иногда удобнее).
- Для системного профилирования можно использовать py-spy (sampling, часто безопаснее в проде).
Когда подозреваете утечки через очереди/фоновые задачи, полезны ещё:
- метрики длины очередей,
- время обработки,
- число активных задач,
- состояние thread pool / event loop.
GC и циклические ссылки: базовая диагностика
Python GC собирает объекты только если есть циклы и типы, которые нужно собирать. Сборщик можно временно “обнажить”:
import gc

gc.set_debug(gc.DEBUG_STATS)  # на время отладки
gc.collect()
В проде это обычно не включают, но локально/в staging — да. Плюс полезно периодически логировать статистику:
import gc
import time

while True:
    print(gc.get_stats())
    time.sleep(10)
Типовые причины роста памяти и утечек: как проверять каждую гипотезу
Ниже — “карту мест”, где чаще всего прячутся проблемы. По каждой причине — что проверить и как подтвердить.
1) Чрезмерное/неограниченное кэширование (включая “невинные” dict)
Симптомы:
- рост памяти коррелирует с ростом числа уникальных ключей,
- память растёт после операций “парсинг/рендер/компиляция/загрузка”.
Частые источники:
functools.lru_cacheбез лимита (maxsize=Noneили большой размер),- глобальный
dictдля “кэширования результатов”, - накопление “состояния” в слоях (например, кэш метаданных по входящему payload),
- кэширование шаблонов/схем без eviction,
- хранение результатов в долгоживущих структурах при обработке событий.
Как проверять:
- найдите места с ростом ключей:
dict/cacheпо ключам, получаемым из пользовательских данных. - сделайте snapshot до/после обработки набора уникальных запросов и посмотрите “top allocators”.
- добавьте ограничение и проверьте эффект (экспериментально).
Пример: если используется lru_cache, убедитесь, что maxsize задан:
from functools import lru_cache

@lru_cache(maxsize=4096)
def parse_schema(schema_text: str):
    ...
Если вы подозреваете “ручной кэш”, введите временно лимит и логируйте размер:
cache = {}
MAX_CACHE = 5000

def get_or_compute(key):
    v = cache.get(key)
    if v is not None:
        return v
    v = compute(key)
    cache[key] = v
    if len(cache) > MAX_CACHE:
        # примитивное эвиктирование: в реальном коде — нормальная стратегия
        cache.pop(next(iter(cache)))
    return v
Подводный камень: даже если Python-heap освобождает объекты, RSS может не падать мгновенно из-за поведения аллокатора. Смотрите на динамику и heap-снимки.
2) Циклические ссылки и задержка сборки
Симптомы:
- периодические “ступеньки” памяти,
- GC начинает активнее работать, растут паузы,
- утечка проявляется сильнее на высоком QPS, когда объектов много и они живут дольше “типичного цикла”.
Где чаще всего:
- замыкания, которые удерживают себя опосредованно,
- структуры типа “родитель хранит ребёнка, ребёнок хранит обратную ссылку”,
- классы с
__del__(финализация может усложнить освобождение), - ссылки в графе, где часть узлов освобождается, но цикл остаётся достижимым.
Как проверять:
- включите
tracemallocи посмотрите, связаны ли “ростовые” строки с объектами, участвующими в циклах. - используйте
gc.collect()как тест: если принудительная сборка заметно снижает heap после события — возможно, проблема в циклах/GC-полузабытых ссылках.
Быстрый диагностический пример с подсчётом объектов по типам (не абсолютная истина, но полезный индикатор):
import gc

def count_instances(cls):
    return sum(1 for obj in gc.get_objects() if isinstance(obj, cls))

# ... в момент подозрения ...
print(count_instances(SomeClass))
Подводный камень: gc.get_objects() дорогой, это не для продакшена. Но в staging/локально помогает понять масштаб.
3) Удержание объектов в замыканиях, callback’ах и event-loop
Это одна из самых коварных причин. Код может быть “логически корректным”, но фактически удерживать большие объекты из-за того, что функция обратного вызова живёт дольше, чем ожидается.
Симптомы:
- память растёт после подписок на события/таймеры/очереди,
- есть рост числа зарегистрированных обработчиков,
- в heap сохраняются большие payload/буферы, которые больше не нужны.
Типовые сценарии:
- подписка на callback без отписки (
unsubscribe) в конце жизненного цикла, - closure захватывает переменную с большим объектом (
data,session,request), - использование
asyncio.create_taskбез корректного завершения/отмены, - добавление обработчика в библиотеку, которая хранит callback.
Как проверять:
- Найдите, какие объекты остаются достижимыми. Это можно сделать через
objgraph(в staging/локально) или через собственные “следы” сweakref. - Временно замените callback на версию без захваченных больших объектов — если проблема исчезает, гипотеза подтверждается.
- Смотрите на рост количества задач/handlers. Если у вас
asyncio, логируйте число pending tasks.
Пример: замыкание, которое удерживает большой объект:
def make_handler(big_blob):
    def handler(msg):
        # big_blob удерживается handler'ом
        process(msg, big_blob)
    return handler
Если handler живёт дольше, чем big_blob, то память не освободится. Исправление зависит от архитектуры:
- хранить только идентификатор,
- выносить big_blob в структуру с ограниченным временем жизни,
- использовать
weakref(осторожно: может стать источником ошибок, если объект исчезнет раньше).
Пример с weakref:
import weakref

def make_handler(obj):
    obj_ref = weakref.ref(obj)

    def handler(msg):
        o = obj_ref()
        if o is None:
            return
        process(msg, o)

    return handler
Подводный камень: weakref.ref работает только когда объект может быть собран. Если на него всё равно есть сильные ссылки в других местах, это не поможет.
4) Неверная работа с ресурсами: файлы, сокеты, контекст-менеджеры
Иногда “утечка памяти” на самом деле — утечка ресурсов, которую OS и библиотечные слои интерпретируют как рост памяти: буферы, дескрипторы, незакрытые сокеты, накопление pending I/O.
Симптомы:
- число файлов/соединений растёт,
- в системе появляются FD (file descriptors) около лимита,
- время ответа деградирует,
- RSS растёт из-за буферов и очередей.
Проверки:
- в Python — строго используйте
withи закрывайте объекты. - включите аудит дескрипторов в staging (через
psutil.Process().num_fds()на Linux). - ищите предупреждения/лог ошибки библиотеки.
Пример корректного закрытия:
import aiohttp

async def fetch(session: aiohttp.ClientSession, url: str):
    async with session.get(url) as resp:
        return await resp.text()
Частая ошибка: await resp.text() без async with или “забытый” session lifecycle.
5) Накопление данных в очередях и фоновых задачах
Здесь память растёт не потому, что “объект не освобождается”, а потому что его слишком много одновременно: производитель быстрее потребителя, и очередь накапливается.
Симптомы:
- рост памяти синхронен росту длины очереди,
- рост задержки (latency) со временем без регрессии на CPU,
- при остановке входящего трафика память начинает спадать.
Что делать:
- добавить backpressure: ограничить размер очереди,
- уменьшить размер батчей,
- правильно настроить concurrency и worker pool,
- ускорить потребление или отложить тяжёлое.
Как подтвердить гипотезу:
- метрики:
queue_length,in_flight_tasks,task_duration, - сравнить heap snapshot во время роста очереди: там почти всегда много объектов “данные/сообщения”, а не “утекшие” структуры.
6) Проблемы с native-памятью в C-расширениях и библиотеках
Python может освобождать свои объекты, но:
- некоторые библиотеки держат память вне Python heap (например, через буферы, кеши, аллокаторы),
- GC не видит эти “ссылки”, потому что они не в Python-объектах,
- возможны утечки в самой библиотеке (не всегда, но бывает).
Симптомы:
tracemallocне показывает рост “из Python-строк”,- RSS растёт, а heap-снимки почти не меняются,
- при деинициализации библиотеки память остаётся.
Как проверять:
- сравнить
tracemallocдинамику и системный RSS. - использовать системные профилировщики/аллокаторы:
- Linux:
valgrind/heaptrack(в связке со staging), - jemalloc/tcmalloc статистика (если применимо).
- Linux:
- тестировать версию библиотеки и упрощать repro.
7) “Ложные” утечки: удержание больших структур неочевидными ссылками
Утечки иногда не связаны с явным циклом. Например, структура хранит ссылки на “контекст” (логгер, трассировки, метаданные), а в контексте — большой payload.
Симптомы:
- память растёт вместе с количеством логов/трассировок,
- в heap видно много строк/байтов, похожих на payload.
Как проверять:
- ограничить логирование (особенно payload, stack trace),
- смотреть
tracemallocпо строкам, связанным с сериализацией/логированием, - отключить tracing в библиотеке и сравнить снимки.
Методология расследования: проверяем гипотезы без “угадывания”
Ниже — рабочий процесс, который хорошо ложится на реальные инциденты.
Шаг 1. Выберите событие и фиксируйте “до/после”
Любая “утечка” должна быть привязана к:
- типу запроса,
- конкретному обработчику,
- фазе батча (например, после парсинга/рендера/обогащения).
Делайте как минимум:
- snapshot A (до),
- snapshot B (после N запросов),
- сравнение.
Это снижает шум и помогает не путать кэширование с утечкой.
Шаг 2. Подберите инструмент под вопрос
- Хотите знать “какие строки выделяют больше всего” →
tracemalloc. - Хотите понять “куда уходит CPU” → cProfile/pyinstrument.
- Хотите понять “есть ли циклы и где их граф” → gc + objgraph/weakref-эксперименты.
- Хотите понять “почему растёт RSS, но tracemalloc молчит” → native/аллокаторы/библиотеки.
Шаг 3. Интерпретируйте результаты критично
tracemallocпоказывает Python allocations, а не всю память.- Top allocations не всегда означают “утечку”:
- некоторые объекты могут временно занимать много памяти,
- GC может освободить, но RSS ещё не вернулся.
- Инструменты themselves добавляют нагрузку — поэтому:
- сравнивайте в одинаковых условиях,
- тестируйте в staging.
Шаг 4. Делайте микро-эксперименты вместо больших рефакторингов
Примеры:
- ограничить кэш и посмотреть эффект;
- отключить конкретный callback-поток и сравнить;
- сделать forced GC перед/после (только как тест);
- обрезать payload в логировании.
Если эффект есть — гипотеза становится рабочей.
Практический пример: расследование “растёт heap после обработки сообщений”
Допустим, у вас есть worker, который обрабатывает сообщения из очереди. Вы видите рост памяти после process_message(). Вы делаете минимальную диагностику.
import tracemalloc
import time

tracemalloc.start(25)

def snapshot(label):
    snap = tracemalloc.take_snapshot()
    stats = snap.statistics('filename')
    print(f"--- {label} ---")
    for s in stats[:10]:
        print(s)

snapshot("before")

# прогон: обработать 10k сообщений
for _ in range(10_000):
    process_message()

snapshot("after")
Дальше вы сравниваете с compare_to и выбираете top по “lineno”:
snap1 = tracemalloc.take_snapshot()

for _ in range(10_000):
    process_message()

snap2 = tracemalloc.take_snapshot()

for stat in snap2.compare_to(snap1, 'lineno')[:20]:
    print(stat)
Если окажется, что top выделения связаны с сериализацией/агрегацией payload, это может быть:
- очередь копит данные,
- где-то держится reference на исходный payload,
- замыкание удерживает контекст.
Если top — это конкретный модуль с кэшем:
- проверьте
maxsize/eviction, - проверьте, не ключи ли — это уникальный пользовательский ввод.
После нахождения “узкого места” вы подтверждаете гипотезу правкой с ограничением/отпиской, и снова делаете snapshots.
Чек-лист расследования из продакшена (по порядку)
Ниже — компактный план, которым удобно пользоваться, когда инцидент “горячий”.
0) Зафиксируйте симптомы и контекст
- RSS/heap растёт монотонно или “пилой”?
- Растёт ли после конкретного типа запросов/сообщений?
- Меняется ли длина очередей/число in-flight задач?
1) Соберите данные (минимум)
- system memory (RSS) + GC stats (частота/время)
- tracemalloc snapshots до/после события
- CPU profile на интервал с ростом задержек (если есть деградация)
2) Быстро исключите “несоответствие уровней”
- tracemalloc растёт вместе с RSS? Если нет — вероятна native-память.
- После остановки входящего трафика память падает? Если да — скорее накопление очередей.
3) Проверьте кэширование и долгоживущие структуры
- Есть ли LRU/handmade кэши с неограниченным ростом?
- Кэш ключей — не пользовательский ли ввод с высокой кардинальностью?
- Есть ли очистка/eviction и работает ли она?
4) Проверьте циклические ссылки
- Есть ли граф “родитель↔ребёнок” и обратные связи?
- Есть ли классы с
__del__или ресурсоёмкие финализаторы? - Принудительный
gc.collect()заметно меняет картину?
5) Проверьте удержание объектов в callback/closure
- Есть ли подписки без отписки (events, observers, handlers)?
- Замыкания захватывают большие структуры?
- Асинхронные задачи завершаются/отменяются корректно?
6) Проверьте ресурсы и корректность lifecycle
- Все файлы/сокеты/HTTP сессии закрываются через context manager?
- В staging контролируются FD/соединения?
- Нет ли накопления pending I/O?
7) Если это не Python heap — смотрите в сторону native
-
tracemallocпочти не объясняет рост. - Библиотека/расширение может держать память вне Python.
- Проверьте версию и воспроизведение на минимальном примере.
8) Сделайте “подтверждающий” эксперимент
- Ограничить кэш / добавить eviction и сравнить snapshots.
- Убрать подписку/обработчик и посмотреть на изменение роста.
- Изменить callback closure (не захватывать payload) и проверить эффект.
- Проверить backpressure на очередях.
9) Закрепите измерениями
- Сравните графики памяти до/после правки.
- Проверьте в нагрузочном сценарии, а не только на тестовом “мини-цикле”.
Вывод: как сделать дебаг памяти воспроизводимым
Дебаг памяти в Python — это не “поиск утечки глазами в коде”, а инженерный цикл: измерить → выдвинуть гипотезу → проверить → уточнить. Инструменты вроде tracemalloc и GC-механики дают возможность привязать проблему к конкретным строкам и типам объектов, а профилировщики и метрики — понять, не является ли рост памяти следствием накопления очередей или native-слоёв.
Если хочется системно и глубже разобраться в инструментах профилирования, дебага и методике проверки гипотез (включая практику интерпретации результатов), как один из способов структурировать знания можно посмотреть материал по теме в виде курса: [ /course/ ].
Главный принцип остаётся тем же: не верьте интуиции без измерений. В продакшене это и быстрее, и честнее — а главное, приводит к исправлениям, которые можно подтвердить графиками и снимками памяти.