Сбор первичного профиля производительности: как найти узкое место в Python за 30 минут
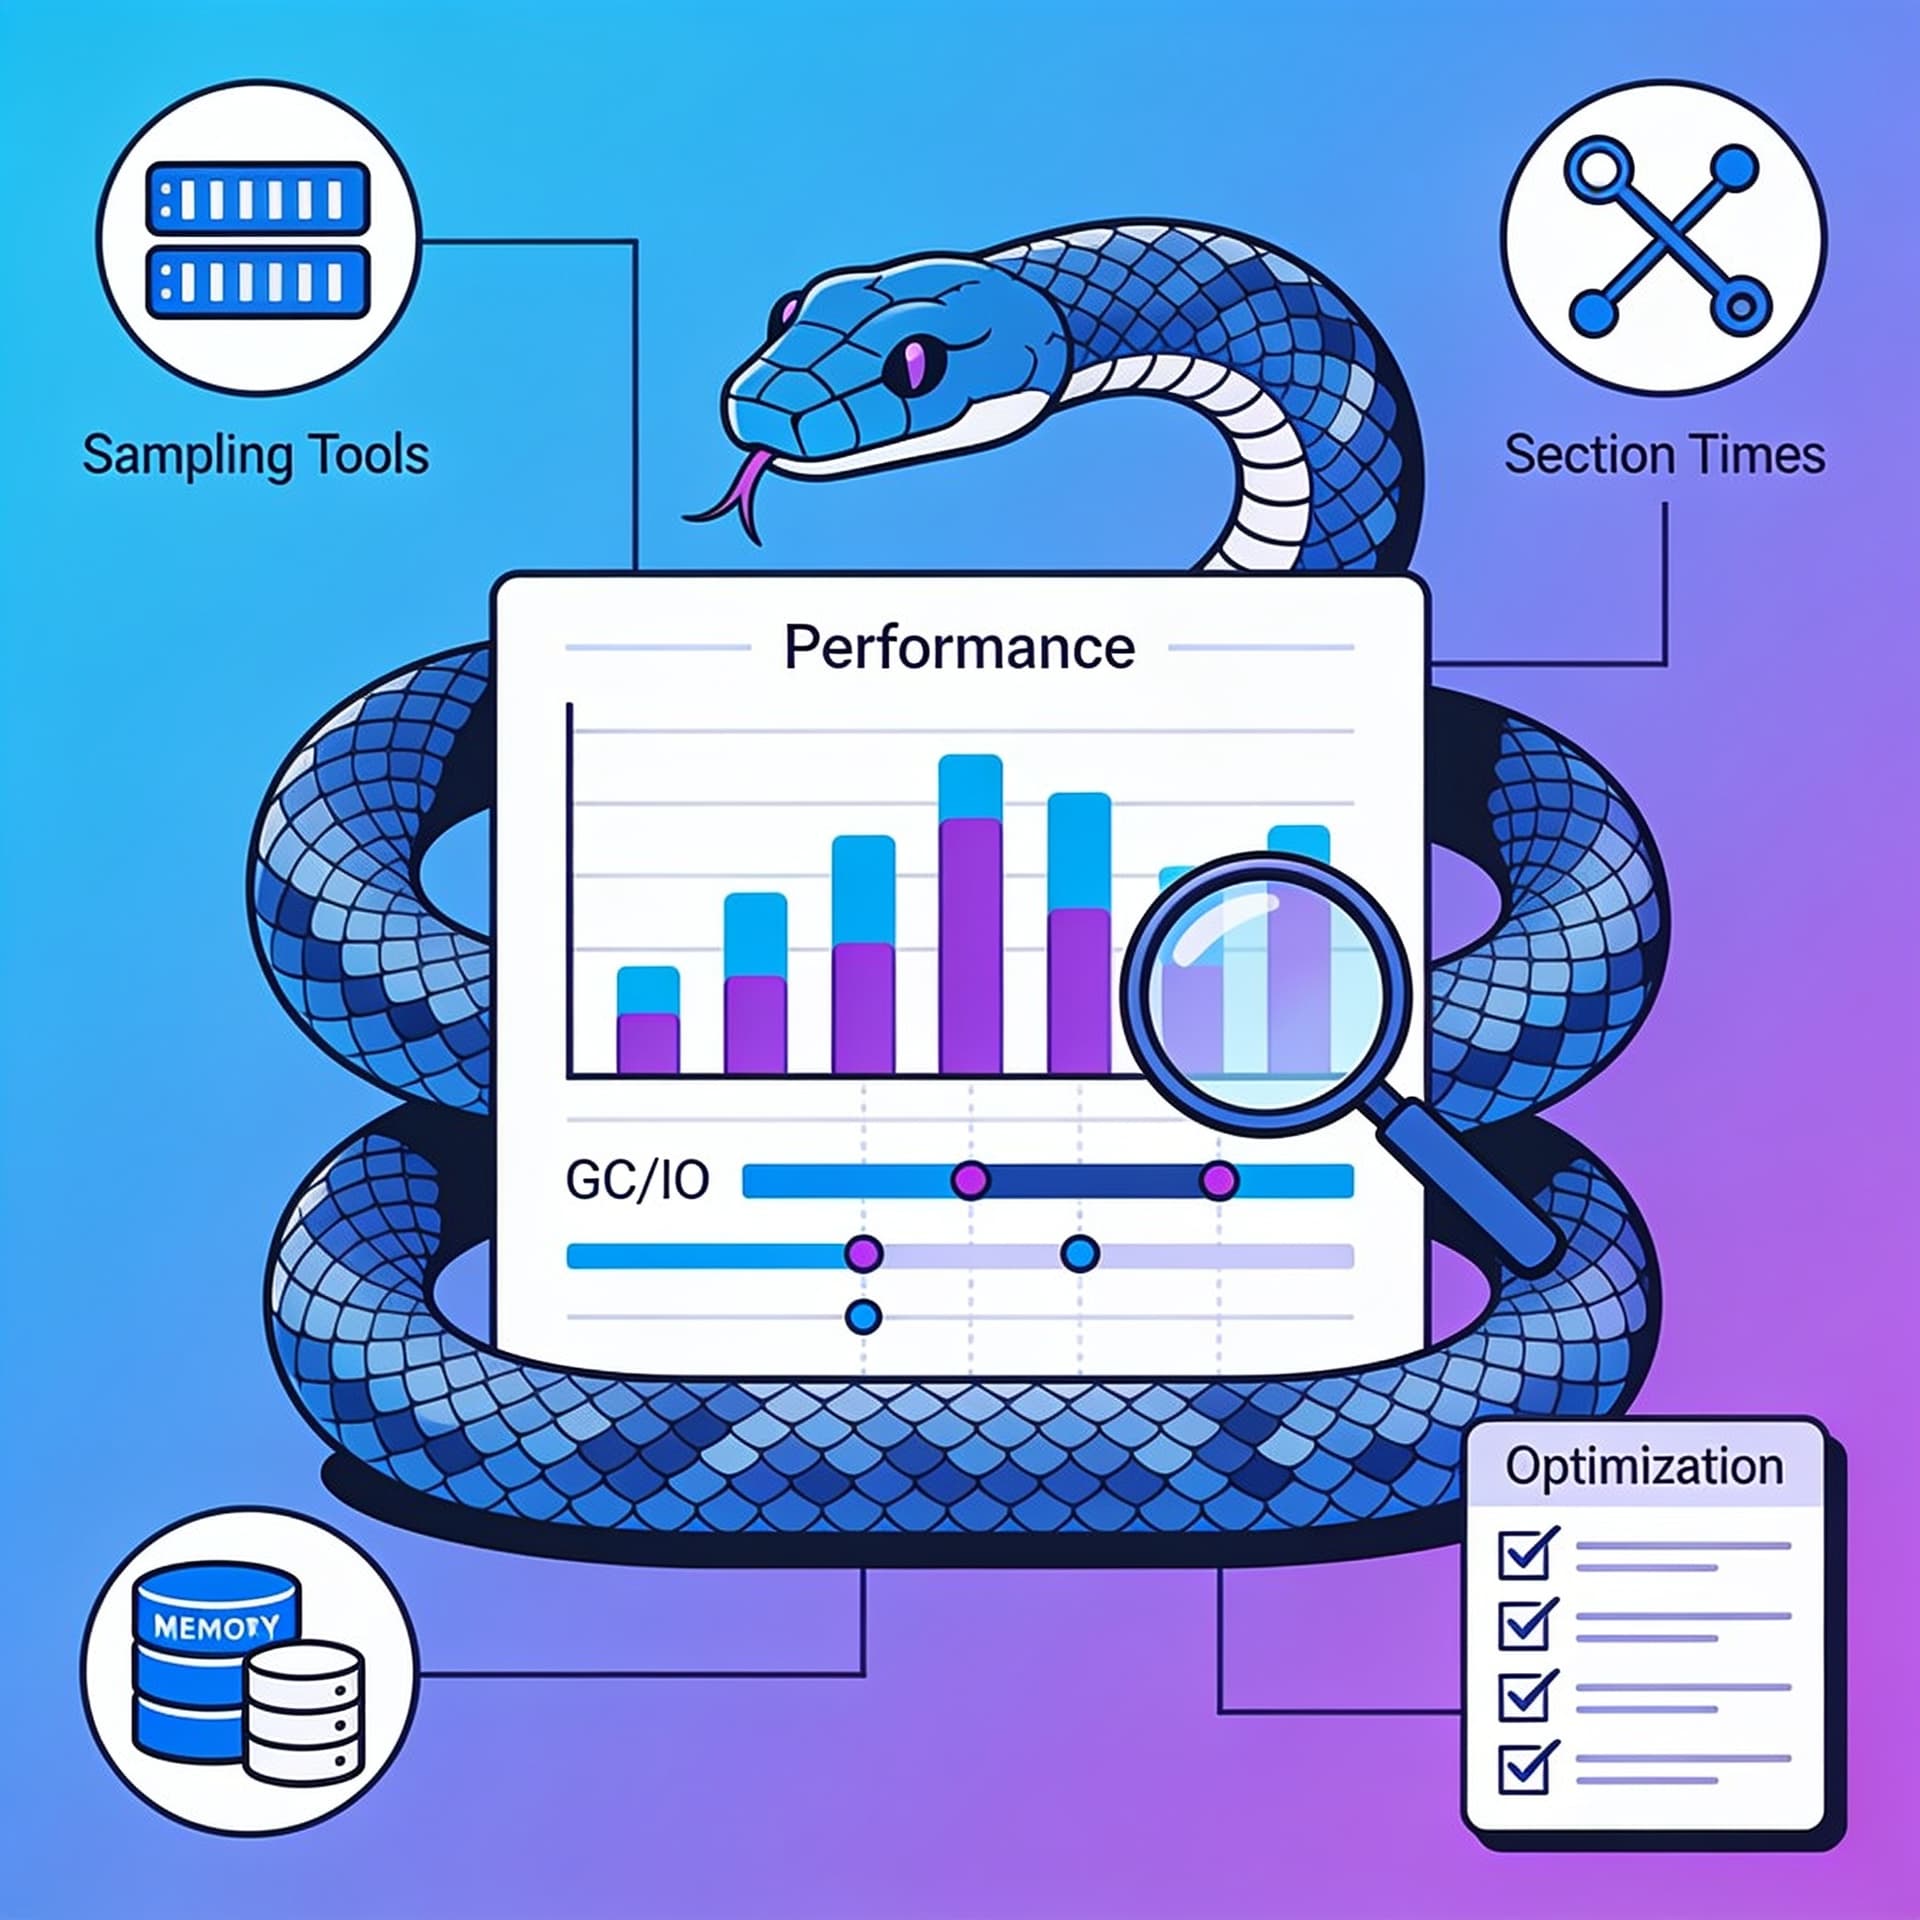
Разберём, как быстро собрать baseline: метрики, sampling-профилирование, тайминги по участкам и оценка влияния GC/IO. Дальше — как интерпретировать результаты и выбрать следующую оптимизацию без преждевременного микро-рефакторинга.
Содержание
Производительность в Python чаще всего «проседает» не из‑за одной магической причины, а из‑за сочетания факторов: где-то слишком дорого по CPU, где-то вы ждёте I/O, где-то растёт доля работы сборщика мусора (GC), а где-то ошибочно оптимизируют микро-операцию, которая не влияет на общую картину. Проблема в том, что без базового профиля легко впасть в режим угадывания — и потратить часы на рефакторинг ради эффектов, которые не измерены.
Ниже — практичный план, как за ~30 минут собрать первичный (primary) профиль производительности, получить baseline метрик и выбрать следующую разумную оптимизацию. Это не «глубокая диагностика на неделю», а именно быстрый способ перестать гадать и начать действовать от данных.
Для практики можно подключить систематизирующий разбор из материала по профилированию и измерениям — например, курс « » (подойдёт, если нужно быстро структурировать подход и закрепить методы на примерах).
Что значит «узкое место» в Python (и почему нельзя начинать с микро-рефакторинга)
В контексте Python «узкое место» — это часть системы, вклад которой в общее время исполнения существенно больше других частей. Важно понимать две типовые ошибки:
-
Ошибочная фокусировка на самом медленном операторе в изоляции.
Например, вы заменилиlist.appendна «более быстрый вариант», но итоговое время почти не изменилось, потому что 90% занимал I/O или ожидание блокировки. -
Непонимание природы времени: CPU vs wait.
Если программа «медленная», она может быть медленной по CPU (обработка), а может быть медленной из-за ожиданий: диск, сеть, синхронизация, таймеры, очереди. Разные причины — разные инструменты и разные решения.
Поэтому первичная задача профилирования — не «найти самый плохой участок навсегда», а:
- получить картину распределения времени по участкам,
- понять, насколько это CPU-, I/O- или GC-ограничено,
- зафиксировать baseline, чтобы оценивать эффект следующих шагов.
План на 30 минут: что измерять и в каком порядке
0–5 минут: зафиксировать тест-кейс и базовые метрики
Без воспроизводимого сценария профилирование превращается в наблюдение за случайностью. Вам нужно:
- конкретный вход (данные), размер (например, N элементов),
- режим запуска (один процесс/много?),
- интерпретатор (точная версия Python, наличие PyPy и т.д.),
- окружение (память не переполняем? есть ли конкуренция с другими задачами?).
Минимальный чек-лист:
- Зафиксируйте версию Python:
python -V. - Если это веб/обработка потока — зафиксируйте число запросов/итераций.
- Убедитесь, что кэш (если есть) не «подменяет» картину: прогоните 1–2 раза до замера (или наоборот — измеряйте «холодный» сценарий отдельно).
Дальше — baseline по времени. На этой стадии не нужен сверхточный инструмент, но нужен стабильный замер.
Быстрый тайминг по сценарию (для baseline)
import time

def run():
    # Вызов вашего пайплайна/функции
    ...

if __name__ == "__main__":
    # прогрев
    for _ in range(2):
        run()

    start = time.perf_counter()
    for _ in range(5):
        run()
    elapsed = time.perf_counter() - start
    print(f"{elapsed / 5:.6f} sec per run")
Опирайтесь на perf_counter() — это системный высокоточный таймер.
Зачем baseline: дальше все оптимизации должны сравниваться с исходным временем на том же сценарии.
5–15 минут: sampling-профилирование, чтобы быстро увидеть горячие зоны
Sampling-профилирование — это метод, когда профайлер периодически «останавливает» поток и фиксирует текущий стек вызовов. В отличие от tracing-профилирования (которое записывает каждую операцию), sampling обычно достаточно лёгкий и даёт быстрый обзор.
Для Python один из самых удобных вариантов — py-spy (внешний sampling профайлер, работает без сильной нагрузки и без модификации кода).
Запуск py-spy (пример)
py-spy record -o profile.svg -- python your_script.py
py-spy top -- python your_script.py
Если вы запускаете конкретную функцию через CLI/pytest, можно профилировать сам процесс.
Что получить:
- список функций с наибольшим «временем» (по смыслу — долей семплов),
- иногда визуализацию (flamegraph).
Важно: sampling показывает преимущественно CPU-время. Если ваша программа часто ждёт I/O, sampling может фиксировать стек во время ожиданий не так, как вы ожидаете. Поэтому sampling — стартовая точка, но не финальный вердикт.
15–25 минут: тайминги по участкам (instrumentation), чтобы привязать стек к реальности
Sampling показывает «где горит CPU», но не всегда помогает понять «что именно мы делаем на уровне доменной логики». Поэтому нужен второй слой — быстрые замеры по ключевым участкам:
- подготовка данных,
- парсинг/преобразования,
- вычисление,
- сериализация/вывод,
- упаковка результатов.
Как правильно ставить тайминги
Подход — минимальный instrumentation с time.perf_counter(). Не захламляйте код на всё подряд: измеряйте границы (шаги пайплайна), чтобы получить дерево времени.
import time
from contextlib import contextmanager

@contextmanager
def timed(name, stats: dict):
    start = time.perf_counter()
    yield
    stats[name] = stats.get(name, 0.0) + (time.perf_counter() - start)

def pipeline(data):
    stats = {}
    with timed("load", stats):
        items = data  # или чтение/подготовка

    with timed("transform", stats):
        items = [f(x) for x in items]  # пример

    with timed("compute", stats):
        result = g(items)

    with timed("serialize", stats):
        out = str(result)

    return out, stats

if __name__ == "__main__":
    out, stats = pipeline(list(range(1_000_000)))
    print(out[:100])
    for k, v in sorted(stats.items(), key=lambda x: -x[1]):
        print(f"{k:12s} {v:.3f}s")
Результат: вы увидите, что, например, «transform» занимает 70% времени. Тогда уже имеет смысл смотреть sampling именно внутри этой области.
25–30 минут: оценить роль GC и I/O (чтобы не оптимизировать «не то»)
Теперь быстро ответим на два вопроса:
- Есть ли признаки того, что GC влияет на время?
- Есть ли существенная доля I/O-ожиданий?
Проверка GC: быстрые измерения
Один из практичных способов — посмотреть счётчики сборок и включения/выключения. Можно временно включить логирование событий, но это обычно тяжеловато. Быстрее — сравнить числа до/после и посмотреть, растёт ли количество циклов GC.
import gc
import time

def run_work():
    # ваш код
    ...

if __name__ == "__main__":
    gc.disable()  # осторожно: это диагностика, не финальное решение
    start = time.perf_counter()
    run_work()
    t_no_gc = time.perf_counter() - start

    gc.enable()
    start = time.perf_counter()
    run_work()
    t_with_gc = time.perf_counter() - start

    print(f"no_gc:   {t_no_gc:.3f}s")
    print(f"with_gc:  {t_with_gc:.3f}s")
    print("delta:", t_with_gc - t_no_gc)
Интерпретация:
- Если выключение GC значительно ускоряет — у вас может быть много «порождаемого мусора» (аллоки/циклы), и GC начинает заметно тормозить.
- Но: отключение GC меняет поведение памяти и потенциально увеличит потребление/побочные эффекты, поэтому рассматривайте это как индикатор, а не как решение «оставить без GC».
Более аккуратно: можно оставить GC включённым и посмотреть статистику:
import gc

def gc_stats():
    counts = gc.get_count()  # счётчики поколений
    thresholds = gc.get_threshold()
    return counts, thresholds
И сопоставить динамику во время прогона.
Быстрая оценка I/O vs CPU: как не обмануться
Если есть I/O (файлы, сеть, база), то sampling CPU может показать неочевидные «виновники», потому что поток может простаивать внутри системных вызовов. Быстрый способ отличить:
- посмотрите, сколько времени занимает «serialize/output» или «load» из ваших таймингов по участкам,
- если у вас есть возможность — добавьте метрики времени ожиданий (например, замер вокруг вызовов, которые ходят в сеть/файлы),
- используйте статистику блокировок (если многопоточно) или количество ожиданий (если есть очереди/async).
В простом сценарии достаточно разнести тайминг на блоки: если «I/O-блок» доминирует — оптимизация алгоритма внутри CPU-блока будет вторична.
Как интерпретировать результаты: три типовых сценария
Сценарий A: Sampling показывает CPU-горячую функцию, и тайминги подтверждают доминирование
Признаки:
- sampling показывает концентрацию семплов в одной/нескольких функциях,
- тайминги по участкам показывают, что соответствующий шаг пайплайна занимает 50–90% времени.
Дальше логика простая: оптимизировать нужно внутри этой области, но не микро-уровнем, а «на шаге»:
- заменить алгоритм (например,
O(N^2)наO(N log N)), - сократить число объектов и аллокаций,
- избежать лишних проходов по данным,
- использовать более подходящую структуру данных.
На этой фазе полезно задать себе вопросы:
- есть ли повторные вычисления (кэшировать? мемоизация?),
- есть ли избыточные конверсии типов/форматов,
- можно ли батчить операции (особенно для I/O).
Сценарий B: Тайминги показывают сильную роль I/O, а sampling «не даёт ясности»
Признаки:
- шаги «load», «fetch», «serialize», «write» занимают основную долю,
- sampling показывает странные функции, но они не «выглядят» как CPU-узкое место.
Решения обычно не в микро-рефакторинге:
- уменьшить количество запросов (агрегация/батчинг),
- уменьшить объём передаваемых данных (фильтрация/проекция),
- включить параллелизм там, где это безопасно (но измерить: конкуренция за ресурсы может ухудшить ситуацию),
- сменить формат/механику сериализации.
Если вы работаете с файлами: проверьте, нет ли случайного «перечитывания» данных, повторного пересоздания объектов, нерационального чтения (строки вместо байт, маленькие reads вместо больших).
Сценарий C: GC влияет на время (delta при отключении GC заметная)
Признаки:
- выключение GC ускоряет заметно,
- количество аллокаций высокое (например, внутри циклов постоянно создаются списки/словари/временные объекты),
- возникают циклы ссылок или большое количество временных структур.
Что делать дальше — не только «выключить GC». Основные направления:
- уменьшить создание временных объектов (переиспользование списков/буферов, генераторы вместо промежуточных списков там, где это реально сокращает объём),
- ограничить «рост словарей/списков внутри циклов» (или предварительно аллоцировать размер, где возможно),
- проверить, нет ли циклов ссылок между объектами (особенно в пользовательских классах),
- оценить возможность структурировать данные так, чтобы уменьшить количество объектов.
На уровне практики помогает правило: если вы видите «лишний список» на одном шаге, попробуйте заменить цепочку map/filter/list на один проход и проверить изменения в профиле.
Выбор следующей оптимизации: как не попасть в ловушку преждевременного микро-рефакторинга
После первичного профиля у вас появляется ранжированный список областей. Дальше важно выбрать следующий шаг оптимизации так, чтобы он имел шанс дать эффект и не потребовал долгого переписывания.
Правило 1: оптимизируйте на уровне «где тратится время», а не «где кажется медленно»
Если sampling/тайминг показывают, что «горячая» функция занимает 5% общего времени — оптимизация этой функции почти наверняка не окупится, если вы будете переписывать большой участок кода.
И наоборот: если 70% времени уходит на один шаг — даже грубая оптимизация внутри него часто даёт ощутимый результат.
Правило 2: любое изменение должно быть проверяемым
Дальше делайте короткие итерации:
- Уточнить гипотезу на основе профиля.
- Внести изменение минимально возможного масштаба.
- Перемерить baseline тем же способом.
- Зафиксировать результат (хотя бы в виде таблицы: до/после/дельта).
Правило 3: не пытайтесь «ускорить всё» за один PR
Оптимизация — это серия экспериментов. Если вы сделаете десять изменений сразу, вы не узнаете, что именно дало эффект (или ухудшило производительность).
Типичные подводные камни первичного профиля
Ложные «виновники» из-за прогрева и кэширования
Python и окружение могут вести себя по-разному:
- JIT нет (если CPython), но кэш данных/прогрев страниц, косвенные эффекты диска и сети вполне реальны.
- Поэтому baseline стоит считать на повторяемом сценарии и иногда отдельно для «холодного» и «тёплого» состояния.
Неправильная гранулярность таймингов
Если вы поставили таймеры слишком мелко (например, на каждую строку) — вы получите:
- шум,
- искажённые измерения (оверхьед),
- неудобство интерпретации.
Если слишком крупно — вы не сузите область для следующего шага.
Sampling может пропустить «время ожиданий»
Sampling — прежде всего про CPU-напряжение: он не гарантирует, что «время в ожидании» будет измерено так же понятно, как CPU.
Отсюда и необходимость связки: sampling + тайминги по участкам.
GC-эксперименты — это диагностический тест, а не стратегия
Отключение GC может временно ускорить, но ценой роста памяти. В продакшене это почти всегда плохая практика без серьёзной инженерной проверки.
Мини-практикум: как собрать отчёт по результатам за 30 минут
Чтобы процесс был управляемым, зафиксируйте результаты в простой структуре. Например:
- Baseline по времени:
X.XXX sec/run. - Sampling топ-5 функций (из
py-spy top): список с долей семплов. - Тайминги по участкам: шаги с временем и долей.
- Проверка GC: delta при
gc.disable()/gc.enable(). - I/O-индикаторы: доля «load/serialize/write».
В конце выберите 1–2 области для следующей оптимизации и сформулируйте гипотезу. Например:
- «70% времени уходит на transform; внутри — частые конверсии списков; оптимизация: заменить цепочку на один проход и сократить промежуточные аллокации».
- «Serialize/write занимает 40%; гипотеза: ускорит батчирование/смена формата/уменьшение объёма данных».
- «GC влияет: delta -20%; гипотеза: снизить число временных объектов в циклах».
Что делать дальше (после первичного профиля)
Первичный профиль отвечает на вопрос «где искать». Следующий этап — углубление в конкретную область:
- если проблема CPU: применить более детальное профилирование (line-profiling, memory profiling, анализ аллокаций),
- если проблема I/O: измерить размер данных, количество операций, латентность; проверить конкурентность и батчирование,
- если проблема GC: изучить места аллокаций, структуру циклов, поведение поколений GC,
- если проблема миксом: разделить задачи и измерять каждый слой отдельно (например, CPU-часть и I/O-часть как отдельные функции).
Хорошая инженерная практика — превращать профиль в дорожную карту: что проверяем дальше, что меняем, как измеряем эффект.
Вывод
Сбор первичного профиля производительности в Python — это не попытка «в один заход найти идеальное решение», а быстрый способ выйти из режима догадок. За 30 минут вы можете:
- зафиксировать baseline по времени,
- увидеть горячие зоны через sampling-профилирование (например,
py-spy), - подтвердить их таймингами по логическим участкам,
- быстро оценить влияние GC и I/O, чтобы не оптимизировать не то.
Главная ценность такого подхода — **правильный выбор следующей