Собеседование по Python: как объяснять алгоритм вслух и защищать выбор сложности
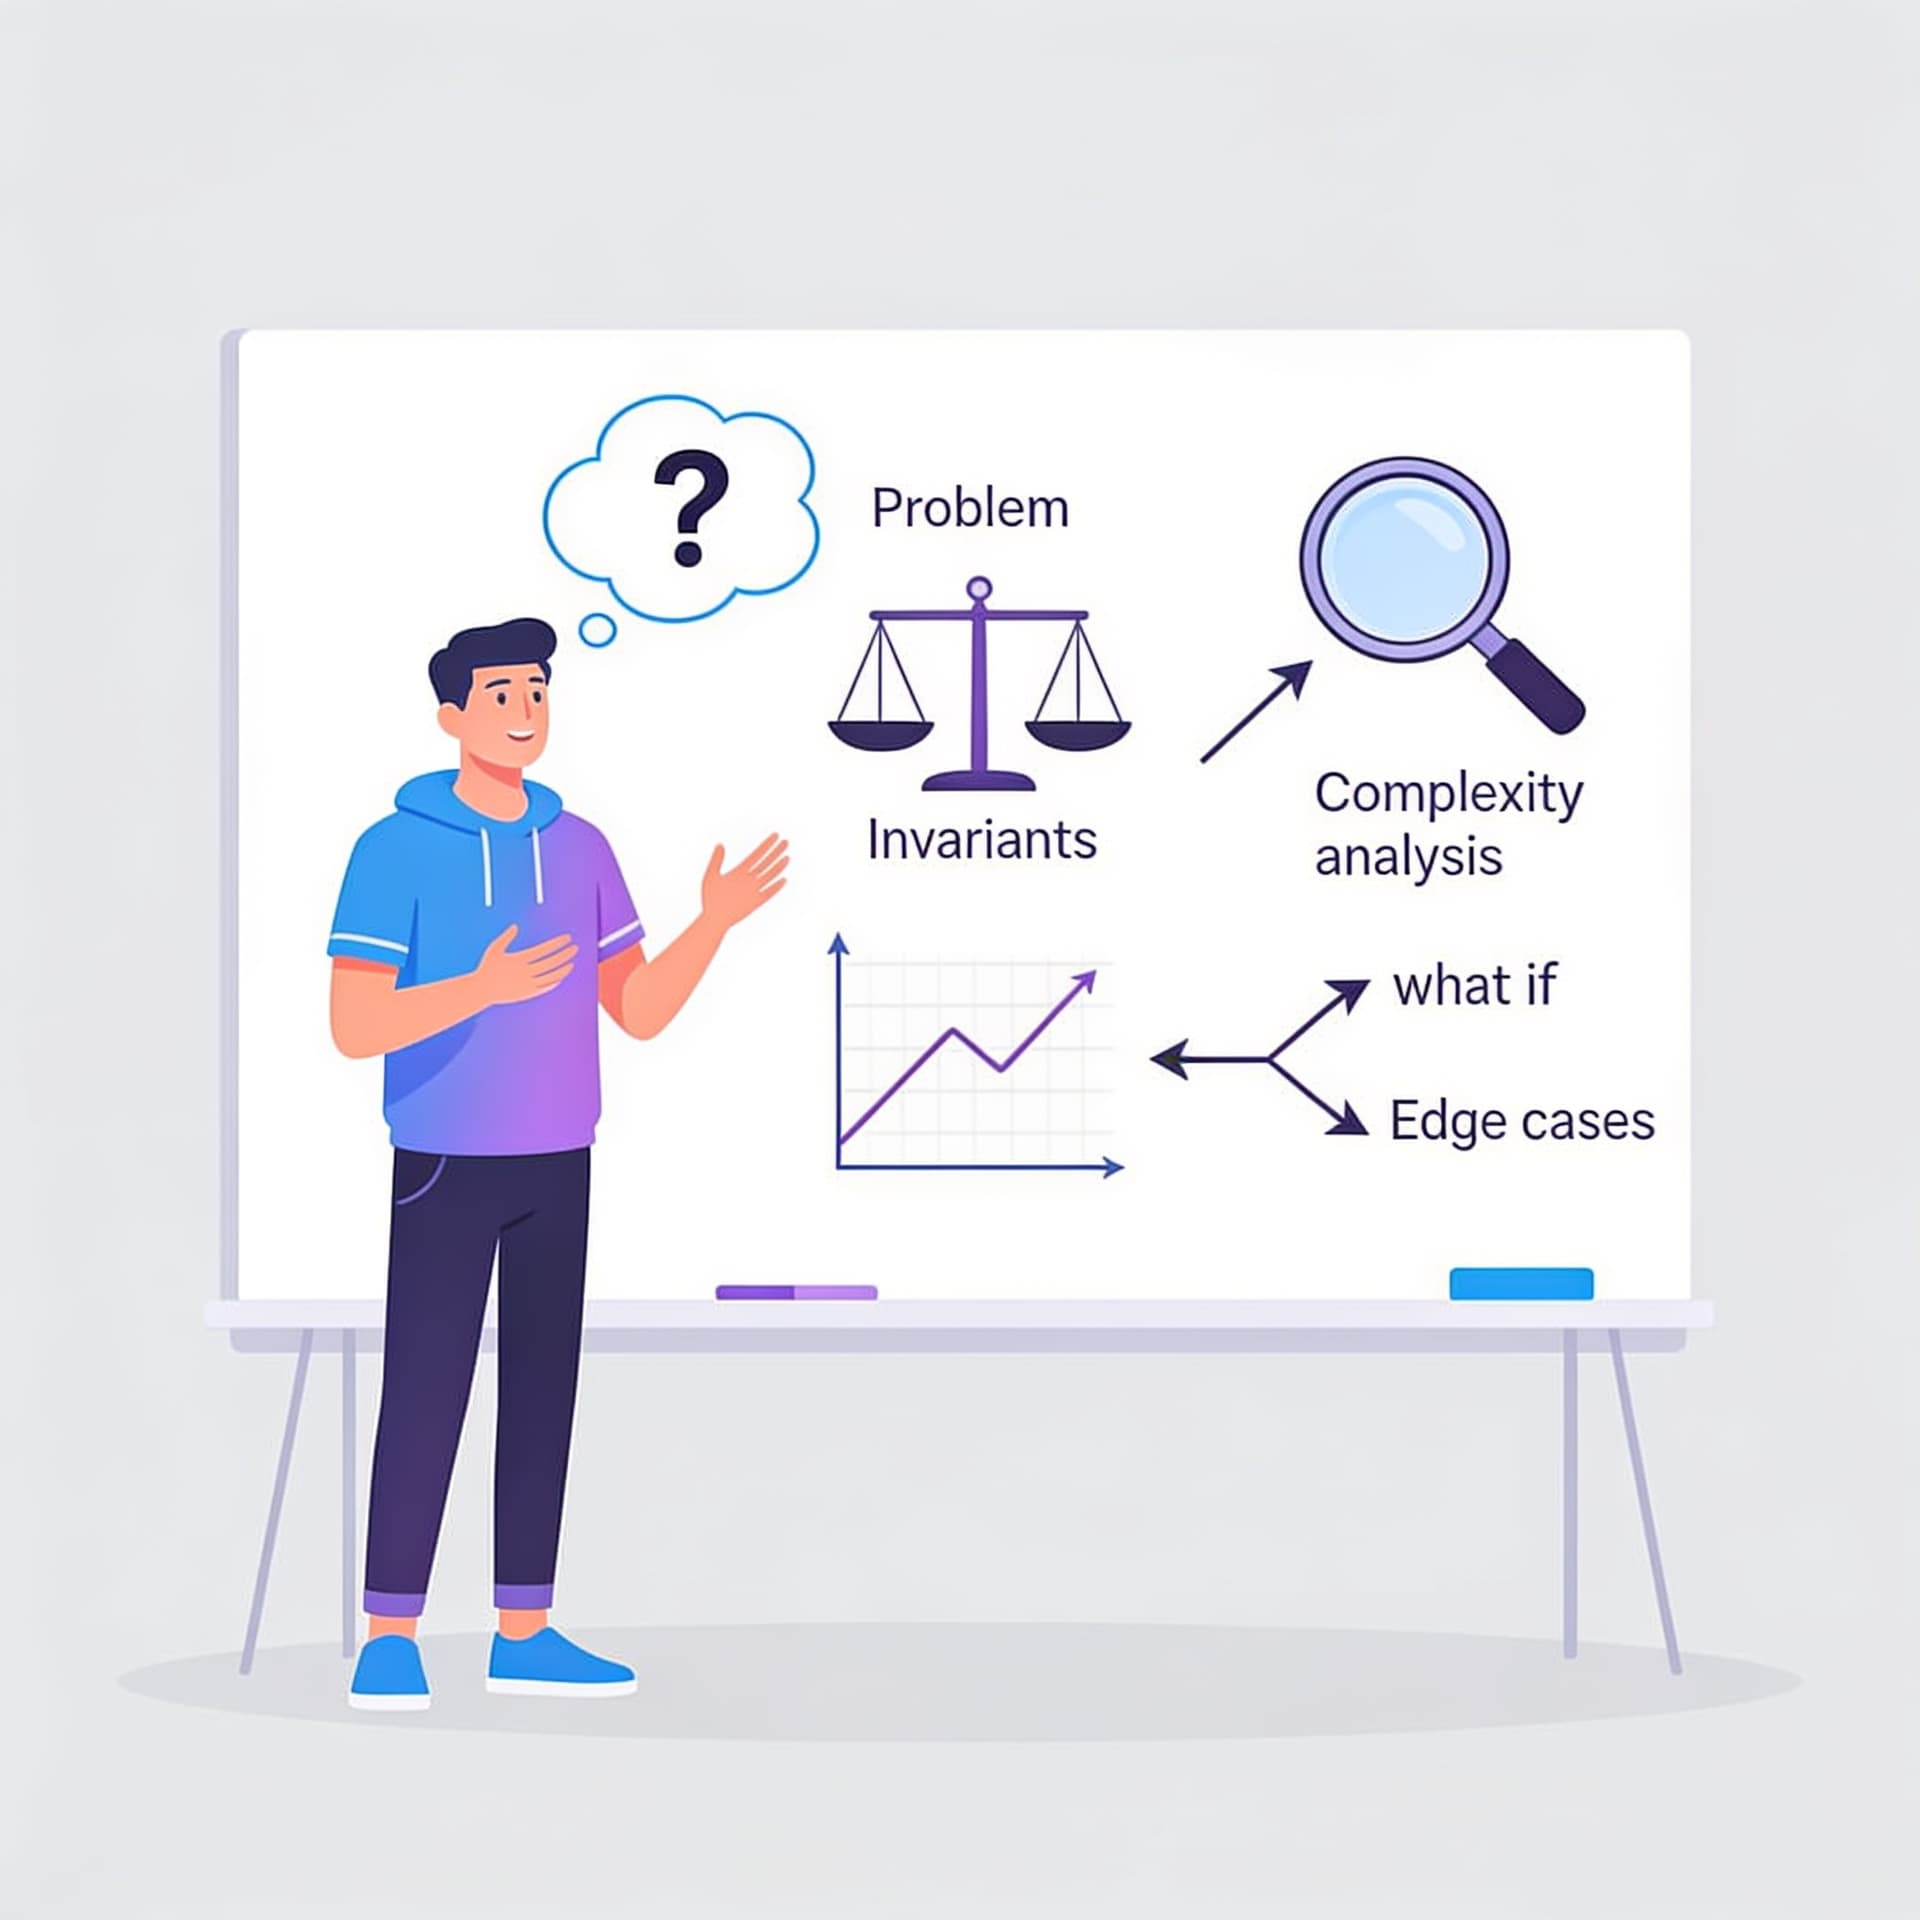
Покажем структуру ответа на задачу: постановка, инварианты, оценка сложности, разбор крайних случаев и “что если”. Будет упор на навык общения, а не только на код.
Содержание
На собеседовании по Python проверяют не только то, умеете ли вы написать код. Часто решающим становится то, как вы мыслите под давлением: умеете ли вы разложить задачу на понятные части, сформулировать инварианты, аккуратно оценить сложность и — что особенно важно — уметь защитить свои решения при уточняющих вопросах.
Ниже разберём, как строить ответ на алгоритмическую задачу так, чтобы он выглядел убедительно: от постановки до “крайних случаев” и веток “что если”. Формат ориентирован на реальную практику: вы сможете применить структуру к большинству задач из типовых подборок (и к задачам в стиле Яндекс/Сбер/маркетплейсов).
Как звучит хороший ответ: общий каркас коммуникации
Условно любой алгоритмический ответ на собеседовании можно представить как диалог. Интервьюер задаёт вопросы, а вы отвечаете так, чтобы:
- Вы показали, что поняли постановку (и ограничений).
- Сформулировали инварианты — свойства, которые всегда истинны в ходе алгоритма.
- Объяснили идею без кода, “человеческим языком”.
- Оценили сложность и сопоставили её ограничениям задачи.
- Разобрали крайние случаи (пограничные значения, пустые структуры, дубликаты).
- Ответили на “что если”: изменится ли решение, если поменяются допущения.
- Только затем перешли к коду — и в конце проверили корректность на примерах.
Ключевой навык — уметь говорить “структурно”. Даже если код написан идеально, но объяснение хаотично, высок шанс получить “неуверенность” со стороны интервьюера.
1) Постановка задачи: сначала уточните, потом решайте
Начните с того, как вы воспринимаете вход/выход и что именно требуется оптимизировать.
Что проговорить вслух
- Тип входных данных: массив? строки? граф? числа? есть ли ограничения на размер.
- Формат результата: вернуть число/индекс/список/булево значение.
- Условия корректности: что должно быть истинно для ответа.
- Ограничения: важны верхние границы
n,m, допустимая память, время.
Если ограничений нет явно, вы можете вежливо запросить уточнение или хотя бы обозначить, что будете ориентироваться на типичные рамки (например, O(n log n) приемлем, O(n^2) — нет при больших n).
Типичная ошибка
Сразу писать код, не проговорив договорённости. На собеседовании это выглядит так, будто вы “угадываете” формат задачи. Интервьюер может начать проверку на тестах уже во время объяснения — и вы будете вынуждены перекраивать решение под уточнения.
2) Инварианты: что именно вы обязуетесь поддерживать
Инвариант — это правило вида “на каждом шаге алгоритма X остаётся истинным”. Важнейшая причина, почему инварианты полезны: они превращают доказательство корректности из абстракции в понятные шаги.
Как формулировать инвариант на пальцах
Для каждого решения спросите себя:
- Какая структура данных хранит “правильное состояние”?
- Какой критерий определяет, что текущее состояние корректно?
- Что меняется на каждом шаге и почему не ломает корректность?
Пример формулировки инварианта (для типичных задач)
Допустим, у вас есть задача на поиск подотрезка с суммой k и вы используете префиксные суммы и мапу частот. Инвариант можно сказать так:
На шаге
iв хэш-таблице хранится количество встреченных префиксных суммprefix[j]для всехj < i. Тогда для текущегоprefix[i]количество подотрезков, заканчивающихся вiс суммойk, равно числуprefix[i] - k, которое я уже видел раньше.
Это звучит убедительно, потому что задаёт связь между состоянием данных и тем, что вы считаете.
Частая ошибка: “инвариант” подменяют описанием
Некоторые кандидаты говорят: “Мы добавляем элементы в список и сортируем”. Это не инвариант. Это описание действий. Инвариант отвечает на вопрос: что вы гарантируете о результате этих действий.
3) Оценка сложности: не просто Big-O, а “почему это проходит”
Интервьюеры часто спрашивают не “какая сложность”, а “почему вы считаете, что она подходит”, “что произойдёт при худшем случае”, “какой trade-off вы сделали”.
Что стоит проговаривать
- Время: какие операции выполняются сколько раз.
- Память: какие структуры данных растут вместе с
n. - Худший случай: что происходит, если вход неблагоприятный.
- Ограничение задачи: соотнесите с
n.
Важный нюанс: Python и скрытые факторы
Big-O у Python-решений иногда одинаковый, но отличаются константы. Приведите пример того, что вы учитывали:
list.append— амортизированно O(1)set/dict— в среднем O(1), но в худшем теоретически может быть хуже; на практике считают средний случай- сортировка
sorted—O(n log n)и обычно дороже одной линейной проходки
На собеседовании достаточно сказать:
Я использую
dict, и операции поиска/вставки в среднем O(1), значит общий проход линейный. В сортировке был быO(n log n), но здесь это не нужно.
Типичная ошибка: “сложность не посчитали, но кажется”
“Кажется, что это O(n log n)” — формулировка, которую интервьюер услышит как отсутствие контроля. Даже если ошибка небольшая, она снижает доверие.
4) Крайние случаи: показать, что вы не сломаетесь на краю
Крайние случаи — это не “ещё один тест”. Это места, где логика обычно неявно предполагает “что-то не бывает”.
Как системно их искать
Проанализируйте по параметрам:
n = 0,n = 1- все элементы одинаковые
- наличие отрицательных чисел (если речь про суммы/сравнения)
- пустая строка, строка длины 1
- дубликаты
- очень большие значения (переполнение неактуально в Python, но важна логика сравнений)
- “уже отсортировано” / “строго отсортировано в обратную сторону”
- несколько возможных ответов: как выбирается один?
Мини-метод: прогонять мысленно инвариант
Возьмите инвариант и попробуйте “продавить” его на граничных входах. Если вы чувствуете, что инвариант становится неочевидным, значит алгоритм требует аккуратного условия в коде.
5) “Что если”: защита выбора и адаптация решения
Это секция, где вы выигрываете интервью. Интервьюер намеренно усложняет ввод вопросами вроде:
- Что если нужно вернуть не только количество, но и сам подотрезок?
- Что если вход изменится и станет больше?
- Что если данные не в списке, а стримятся?
- Что если требование будет минимизировать память?
- Что если вместо “в среднем” важна гарантия?
Как отвечать грамотно
Не пытайтесь “угадать правильную версию”. Лучше отвечать структурно:
- Что в текущем решении зависит от допущений?
- Можно ли расширить решение напрямую?
- Если нет — какая часть меняется?
- Какая новая сложность получается?
- Есть ли компромисс по качеству (например, эвристики) — если так вообще допустимо?
Типичная ошибка
Сказать “тогда всё перепишем”. На собеседовании это выглядит как отсутствие инженерного понимания.
6) Сквозной пример: формат объяснения на задаче
Возьмём классическую задачу: подсчитать число подотрезков, сумма которых равна k. Хотя вариаций десятки, шаблон объяснения одинаков: префиксные суммы + хэш-таблица.
Постановка (вслух)
Даны числа
numsдлиныnи целоеk. Нужно вернуть количество пар индексов(l, r), где0 <= l <= r < n, такие что суммаnums[l] + ... + nums[r]равнаk. Ограничения не указаны, поэтому хочу решение лучше, чемO(n^2).
Идея без кода
Введу префиксные суммы
prefix[i] = sum(nums[0..i]).
Тогда сумма отlдоrравнаprefix[r] - prefix[l-1].
Значит, чтобы сумма равняласьk, нужно чтобыprefix[l-1] = prefix[r] - k.
Я буду идти слева направо и хранить вdictчастоты уже встреченных префиксных сумм.
Инвариант
На позиции
iвcountхранится число индексовj < i, для которыхprefix[j]равна некоторому значению.
Когда я считаю текущийprefix[i], добавляю к ответуcount[prefix[i] - k], потому что каждое такое ранее встреченное значение даёт подотрезок, заканчивающийся вiи суммойk.
Крайние случаи
Нужно учесть подотрезки, начинающиеся с
0. Для этого я заранее добавлю в структуру частоту префикса0равной 1, как будтоprefix[-1] = 0.
Сложность
Я один раз прохожу по массиву. На каждом шаге выполняю поиск/увеличение в
dict, что в среднем O(1).
Итого время O(n), память O(n) в худшем случае.
Что если (защита)
- Если спросят: а если нужны сами подотрезки?
Тогдаdictнужно изменить: вместо частот хранить списки индексов или хотя бы последних индексов, и аккуратно собрать ответы. Время может вырасти из-за количества решений, и это уже будет зависеть от вывода. - Если скажут: а если числа огромные, но длина небольшая — всё равно корректно.
- Если спросить: а можно ли без
dict?
Можно через сортировку префиксов, но это дастO(n log n)и потребует другой логики с индексами; при текущем наборе ограниченийdictпроще и быстрее.
Код (и комментарии, которые не мешают)
from collections import defaultdict
from typing import List

def subarray_sum_count(nums: List[int], k: int) -> int:
    count = defaultdict(int)
    count[0] = 1  # prefix[-1] = 0

    prefix = 0
    ans = 0

    for x in nums:
        prefix += x
        ans += count[prefix - k]
        count[prefix] += 1

    return ans
Как продолжить после кода
После написания кода можно подтвердить корректность на мини-примере, вслух:
Например,
nums = [1,1,1],k = 2.
Подотрезки:[1,1](две штуки).
Мой алгоритм будет считать совпадения префиксов и вернёт 2.
Интервьюер увидит, что вы понимаете, а не просто воспроизвели шаблон.
7) Частые проблемы именно в “объяснении вслух”
Ниже — типовые сценарии, которые портят оценку даже при хорошем коде.
1) Слишком ранняя детализация
Кандидат сразу бросается в “мы создаём массив dp длины n+1, индексируем с i-1” — и теряет смысловую линию.
Как лучше: сначала 2–3 предложения “зачем” и “какой инвариант”.
2) Нет явной связи “данные → решение”
Если вы используете dict/heap/dp, объясните, что именно хранится и почему этим можно пользоваться.
Пример слабого объяснения:
“Я храню какие-то значения в dict.”
Пример сильного:
“Я храню частоты префиксных сумм, чтобы за O(1) находить, сколько раз раньше встречалась сумма, дополняющая текущую до k.”
3) Сложность рассказана без проверки ограничения
Даже правильное O(n log n) может оказаться неподходящим, если n до 10^7.
Как лучше: “Если n до 10^5 — это ок, если до 10^6 — всё равно проходит, потому что память и константы такие-то”. На уровне интервью достаточно качественного соотнесения.
4) Крайние случаи обсуждаются “как-нибудь потом”
Наблюдение: интервьюер иногда в середине диалога говорит: “А что если вход пустой?”
Если вы раньше не заложили структуру ответов, придётся отвечать экспромтом.
8) Универсальный шаблон ответа (можно копировать в голове)
Вот практичная структура, которой удобно пользоваться на любой задаче:
- Постановка: что вернуть и какие ограничения.
- Идея: какой подход выбран и почему.
- Инварианты: что хранится/какое свойство поддерживается.
- Алгоритм: шаги на уровне слов.
- Сложность: время и память, почему подходит.
- Крайние случаи: что ломает типичные решения.
- Что если: как изменится решение при вариациях требований.
- Код: реализация с короткими комментариями.
- Проверка: прогон на 1–2 примерах.
Эта схема работает именно потому, что её легко оценивать со стороны: интервьюер может “проверять контроль” на каждом пункте.
Вывод: инженерное мышление важнее шаблона
Собеседование по Python — это не экзамен по написанию кода “в вакууме”. На практике вас оценивают по способности объяснить ход мысли: сформулировать инварианты, дать корректную оценку сложности и защитить выбор решения в ответ на уточняющие вопросы. Именно это чаще всего отличает кандидата, который “прошёл по тестам”, от кандидата, с которым спокойно можно идти в разработку.
Если вам нужно системно прокачать именно разговорный навык решения задач, полезно тренироваться на подборках с задачами в формате интервью. Например, в качестве одного из способов углубиться можно рассмотреть курс «40+ задач по Python с собеседований: Яндекс, Сбер, Wildberries и Avito» — как тренировочную базу для выработки устойчивого шаблона объяснения и защиты решений.
Главное — не копировать чьи-то ответы, а каждый раз возвращаться к каркасу: постановка → инварианты → сложность → крайние случаи → “что если”. Тогда даже сложные задачи превращаются в управляемый процесс, а не в набор случайных попыток.