Мониторинг ошибок в Python: Sentry (или аналоги) + трассировка запросов от клиента до базы
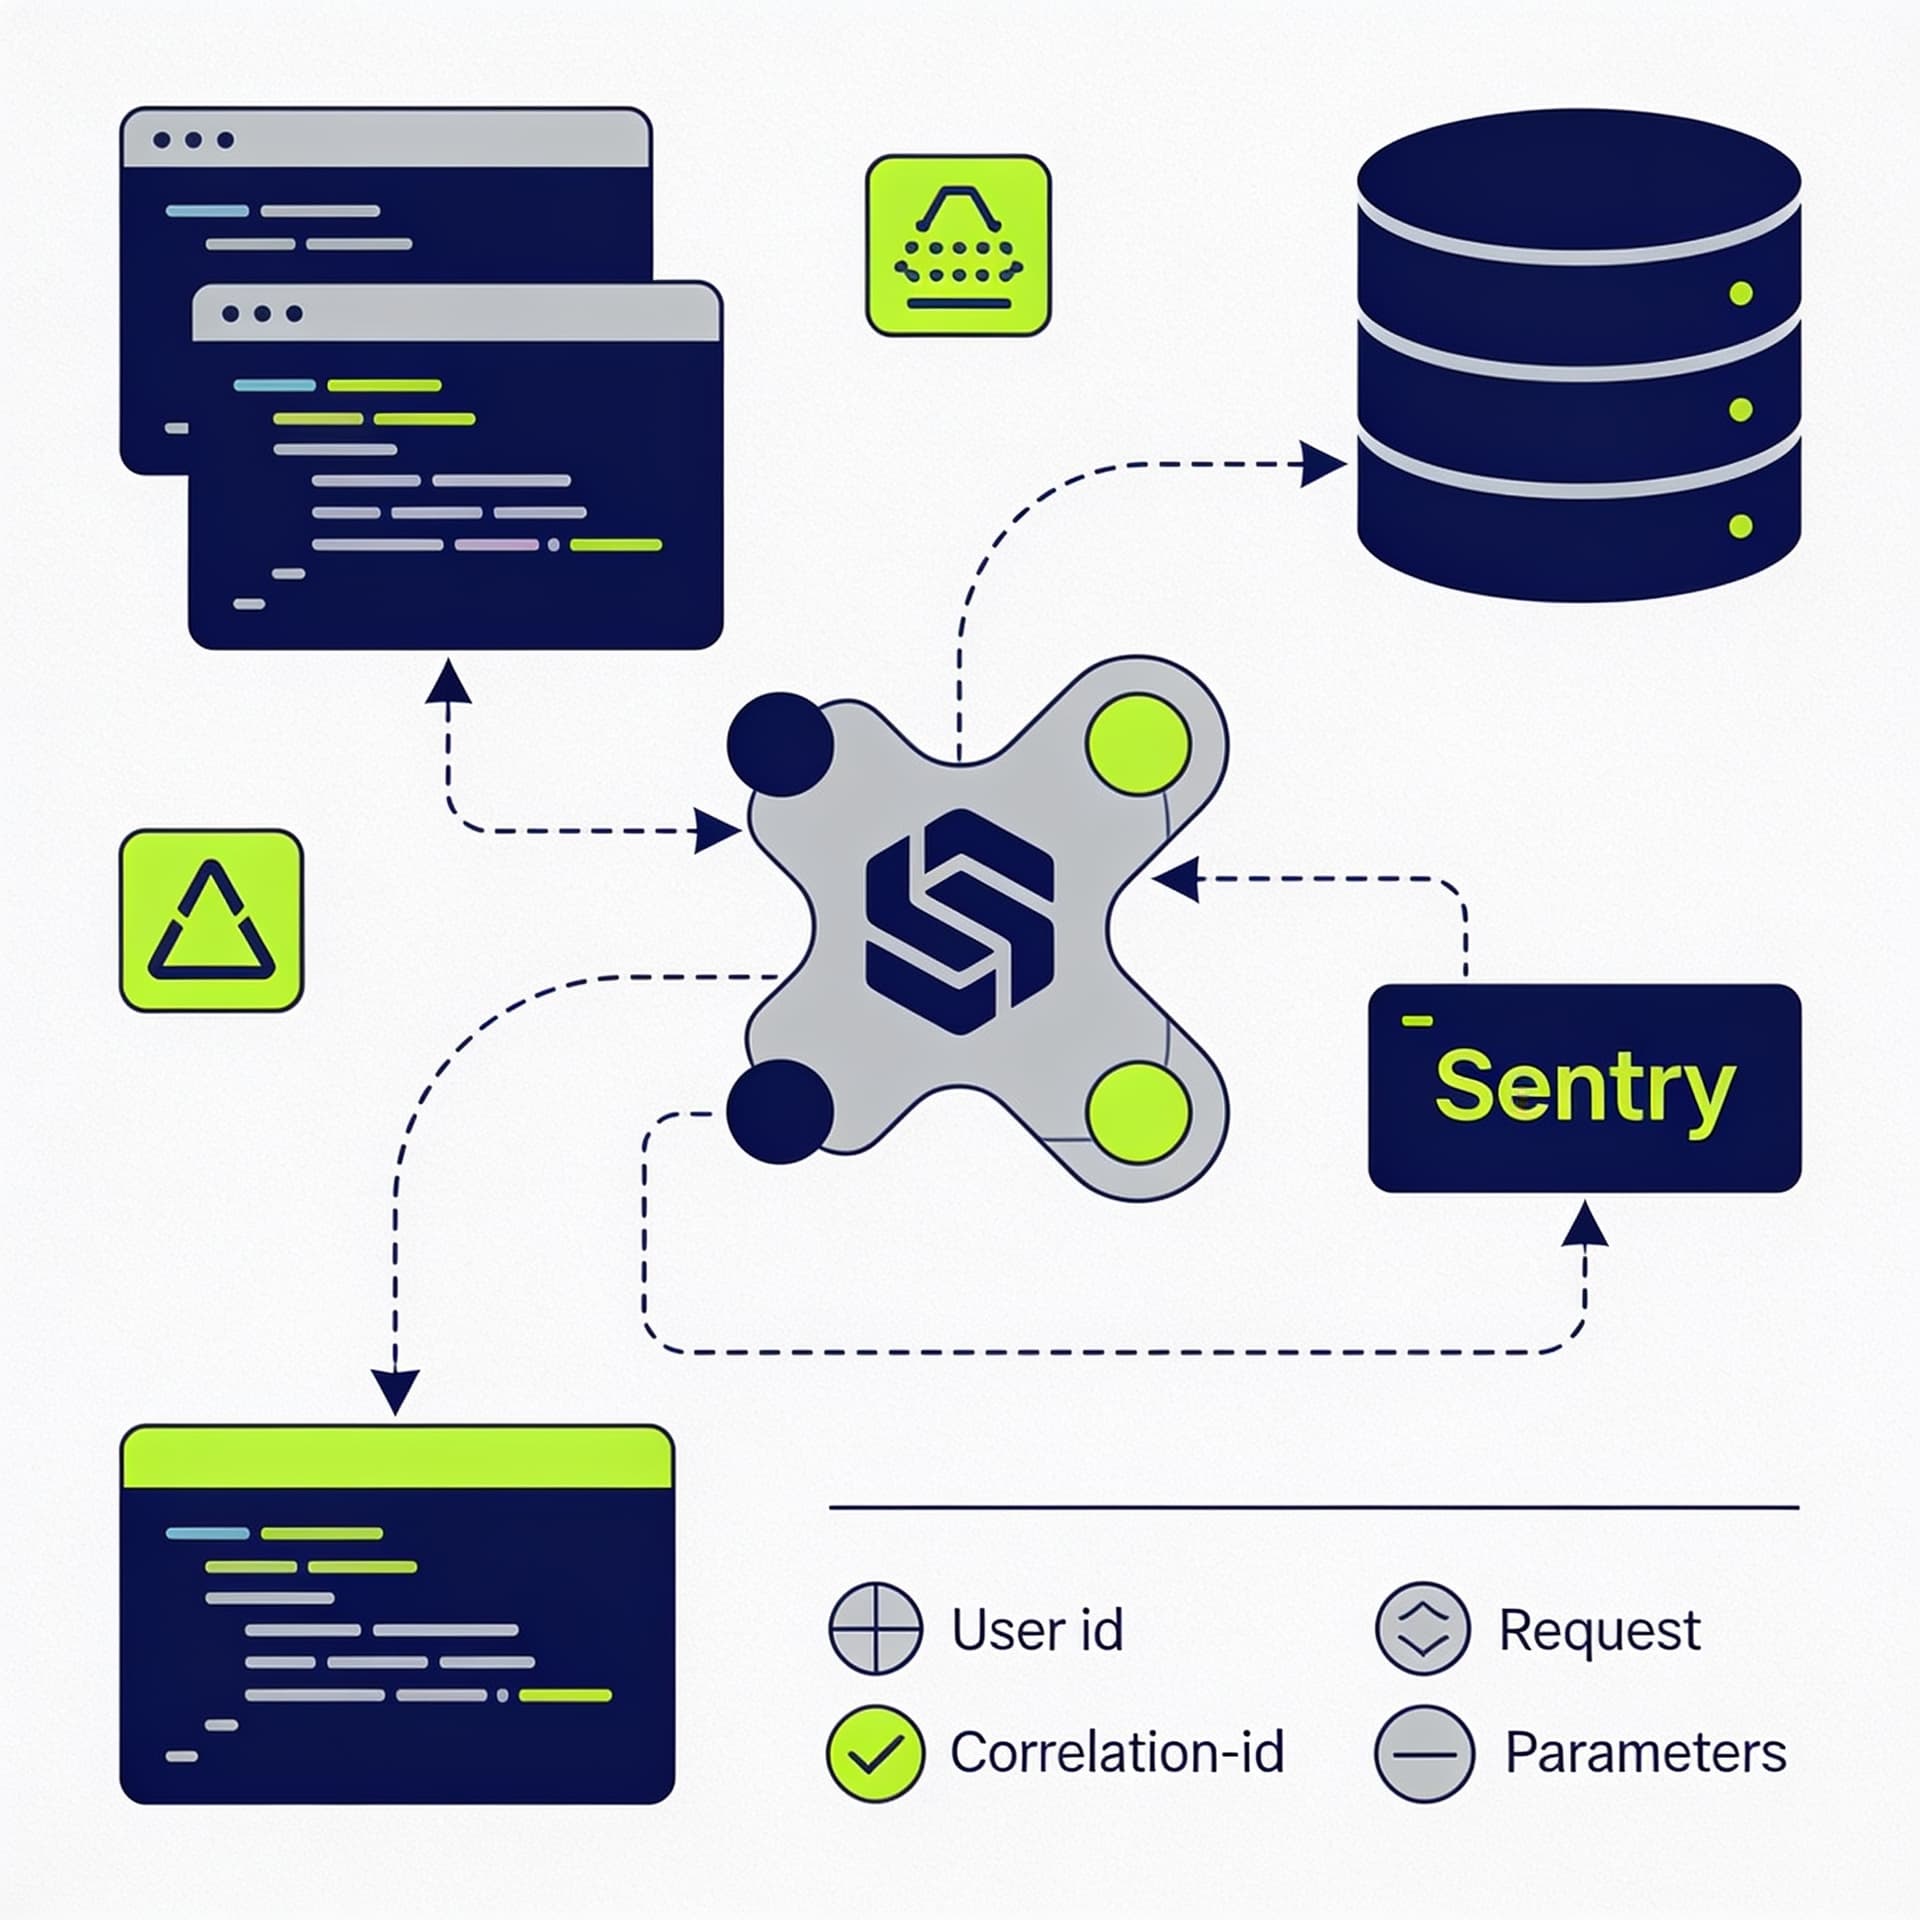
Как настроить сборку исключений и контекста (user_id, correlation-id, параметры запроса) так, чтобы ошибки были воспроизводимыми и сопоставимыми между релизами. Разберём, какие события логировать, а какие лучше не спамить, и как привязать отчёты к конкрет
Содержание
В Python-приложениях ошибки редко бывают «чисто серверными». Чаще всего это цепочка причин: один запрос клиента запускает несколько функций, обращений к БД, внешних сервисов, фоновых задач — и где-то на этом пути что-то ломается. Проблема в том, что до тех пор, пока у вас нет воспроизводимого контекста и единого способа связать запрос с ошибкой, расследование превращается в угадайку: какой именно релиз, какой эндпоинт, какие параметры, какой пользователь и какая транзакция в базе.
Хорошая новость: современный мониторинг ошибок (Sentry и аналоги) позволяет собирать исключения, контекст и «след» запроса так, чтобы ошибки становились сопоставимыми между релизами и удобными для воспроизведения. В этой статье разберём практический подход: какие события логировать, что не спамить, как собрать user_id, correlation-id, параметры запроса, как привязать отчёты к конкретным операциям/эндпоинтам и как получить трассировку «от клиента до базы» без превращения системы в хранилище приватных данных.
Почему “просто логировать исключения” недостаточно
Большинство команд начинает с простого: пишут stack trace в файл или в stdout, собирают логи в ELK/ClickHouse и… всё. Это полезно, но у такого подхода есть типичные ограничения:
- Нет связности между компонентами. Исключение в приложении может быть следствием таймаута БД, который случился раньше. По логам руками находите корреляцию, но это медленно.
- Сложно сопоставлять между релизами. Сегодня упало в версии
2026.08.01, завтра — в2026.08.02. Без чёткогоreleaseи стабильного «ключа» сравнивать трудно. - Проблема с персональными данными. Логи часто содержат
email,phone, IP, payloadы запросов — и это потенциальный риск. - Невоспроизводимость. Даже если stack trace есть, не всегда ясно, какой именно запрос был отправлен: путь, параметры, заголовки, кто инициатор (
user_id), какая транзакция в БД.
Sentry и похожие сервисы решают часть вопросов из коробки: сбор исключений, группировка, метаданные окружения, release health, базовая трассировка. Но ценность появляется только тогда, когда вы правильно настроили контекст и корреляцию запросов.
Архитектура наблюдаемости: ошибки, корреляция и трассировка
Рассмотрим целевую картину. Когда клиент обращается к API:
- На входе запроса создаётся или извлекается correlation-id (иногда он называется trace id).
- В контекст запроса добавляются:
user_id(или более безопасный идентификатор),- информацию об эндпоинте/операции,
- ключевые параметры запроса (в объёме, который можно безопасно хранить).
- Исключение перехватывается в одном месте (глобальный middleware/handler).
- При отправке события в Sentry вы добавляете:
- стабильные теги (например,
endpoint,method,operation), - пользовательский контекст (
user_id), - correlation-id,
- release и окружение (
environment).
- стабильные теги (например,
- Для трассировки вы включаете инструментирование библиотек:
- web framework (FastAPI/Flask/Django),
- DB driver (например, SQLAlchemy, psycopg2),
- внешних HTTP-клиентов.
Идеальный результат: открываете конкретную ошибку в Sentry и видите, к какому запросу клиента она привязана, какой путь, какие параметры, кто инициатор, и цепочку операций до базы.
Sentry vs аналоги: что учитывать при выборе
Sentry — де-факто стандарт, но есть аналоги: OpenTelemetry + визуализатор/collector (например, Jaeger/Tempo) для трассировок, а для ошибок — сервисы вроде Bugsnag, Rollbar, Airbrake, либо самописный пайплайн через OpenTelemetry logs/exception events.
При выборе важно смотреть не на «наличие дашбордов», а на инженерные свойства:
- Группировка событий: чтобы один и тот же тип ошибки не превращался в сотни «уникальных» инцидентов.
- Release tracking: связывание событий с конкретным релизом.
- Triage/stack trace: наличие быстрой классификации.
- Теги и контекст: возможность хранить endpoint и correlation-id в полях, а не только в тексте.
- Совместимость с OpenTelemetry: если вы строите трассировку на стандарте.
Дальше будем ориентироваться на Sentry, потому что он хорошо документирован и часто используется как базовый слой для ошибок. Принципы же перенесутся на аналоги.
Подготовка: release, environment, DSN и базовые настройки SDK
Sentry на Python обычно настраивается через SDK. Важно сразу выстроить базу: release, environment, корректный dsn и отключение отправки «лишнего», где это уместно.
Установка
pip install sentry-sdk
Пример конфигурации (например, в приложении FastAPI)
import os
import sentry_sdk
from sentry_sdk.integrations.fastapi import FastApiIntegration

sentry_sdk.init(
    dsn=os.getenv("SENTRY_DSN"),
    environment=os.getenv("APP_ENV", "development"),
    release=os.getenv("APP_RELEASE"),  # желательно: git sha или semver build
    integrations=[FastApiIntegration()],
    # В проде часто отключают лишние профилировщики, если они не нужны
    # traces_sample_rate=0.0,  # включим позже для трассировки
    send_default_pii=False,  # важно для безопасности
)
Ключевые нюансы:
APP_RELEASEдолжен быть стабильным и сопоставимым между релизами. Git SHA — отличный вариант, semver — тоже, если он действительно соответствует build.send_default_pii=Falseуменьшает шанс случайно отправить персональные данные из стандартных полей.
correlation-id: как связать событие об ошибке с конкретным запросом
Почти любое расследование упирается в вопрос: «какой именно запрос клиента?». Для этого нужен один идентификатор, который проходит через весь стек.
Где брать correlation-id
Варианты:
- Приходит от клиента в заголовке:
X-Correlation-IDилиtraceparent. - Если нет — генерируйте сами (UUID v4/ULID).
- Если используете OpenTelemetry — лучше строить всё вокруг стандарта W3C
traceparent.
Ниже покажем подход с произвольным X-Correlation-ID.
Middleware: создание/извлечение correlation-id и сохранение в контекст
Пример для FastAPI (идея переносится на Flask/Django):
import uuid
import contextvars
from fastapi import Request

correlation_id_var = contextvars.ContextVar("correlation_id", default=None)

def get_correlation_id(request: Request) -> str:
    # Пример: ищем в заголовке
    cid = request.headers.get("X-Correlation-ID")
    if cid:
        return cid
    return str(uuid.uuid4())

@app.middleware("http")
async def correlation_middleware(request: Request, call_next):
    cid = get_correlation_id(request)
    correlation_id_var.set(cid)

    # Можно также пробросить дальше в response
    response = await call_next(request)
    response.headers["X-Correlation-ID"] = cid
    return response
Добавление correlation-id в Sentry scope
Sentry имеет concept “scope” (контекст события). Правильный путь — добавить correlation-id как tag или extra, чтобы по нему было легко фильтровать события.
В middleware вы можете заранее положить значение в scope для всех последующих логов/исключений:
import sentry_sdk
from sentry_sdk import configure_scope

@app.middleware("http")
async def sentry_scope_middleware(request: Request, call_next):
    cid = request.headers.get("X-Correlation-ID") or "generated-by-other-middleware"
    # Подстраховка: берём из contextvar, если вы его установили
    cid = correlation_id_var.get() or cid

    with configure_scope() as scope:
        scope.set_tag("correlation_id", cid)

    return await call_next(request)
Практика: лучше использовать set_tag для полей, по которым вы будете часто фильтровать (endpoint, method, env). Для больших структур — set_extra.
user_id: как добавить идентификатор пользователя безопасно и полезно
Почти всегда user_id помогает ускорить расследование: «у кого проявляется?». Но ключевой момент — не путайте идентификатор пользователя с персональными данными.
Рекомендации:
- Используйте внутренний
user_id(число/UUID). - Не отправляйте
email,phone, полный IP (особенно если не получили согласия/не соответствует политике). - Если user неизвестен (гость, ошибка авторизации) — отправляйте
Noneили не отправляйте поле вообще.
Где брать user_id
Для API это обычно доступно после аутентификации в dependency/мидлваре/контексте запроса.
Пример: установка user в Sentry scope
from sentry_sdk import configure_scope

def set_user_in_sentry(user_id: str | None):
    with configure_scope() as scope:
        if user_id is not None:
            scope.set_user({"id": str(user_id)})
        else:
            scope.set_user(None)
Важно: set_user(None) может отличаться по поведению в SDK, но смысл понятен: не засоряйте события «пустыми» пользователями.
Параметры запроса: какие поля добавлять, а какие не надо
Сбор параметров полезен только если он:
- помогает воспроизвести,
- не нарушает безопасность,
- не приводит к «комбинаторному взрыву» группировок.
Основной принцип
Добавляйте в события:
- метод (
GET/POST), - путь (
/api/v1/orders/{id}или хотя бы исходный route name), - параметры, влияющие на поведение (например,
limit,currency,report_type), - идентификаторы бизнес-объектов (
order_id,invoice_id).
Не добавляйте:
- полномасштабный JSON body (особенно если там много PII),
- секреты (токены, пароли),
- большие бинарные/вложенные структуры,
- весь query string, если там могут быть пользовательские данные.
Параметризация, чтобы ошибки группировались
Одна из типичных ошибок: добавлять в теги или сообщения «сырые» параметры запроса (например, order_id=123, order_id=124) — и тогда одно и то же исключение превратится в множество групп. Группировка в Sentry зависит от механизма “fingerprinting”, но часто добавленные “ключи” ухудшают картину.
Лучше:
- хранить
order_idвextra, а не в тегах, или - в тегах хранить “маску” (
has_order_id=true) + route template.
Пример безопасного отбора параметров
def safe_request_context(request: Request):
    # Путь лучше получить как "route path" (шаблон), если framework позволяет.
    path = request.url.path
    method = request.method

    # Допустим, вы знаете, какие query params важны и безопасны
    query = dict(request.query_params)
    limit = query.get("limit")
    currency = query.get("currency")

    return {
        "method": method,
        "path": path,
        "limit": int(limit) if limit and limit.isdigit() else None,
        "currency": currency,
        # correlation_id и user_id добавим отдельно
    }
Дальше вы добавляете эти поля в extra:
import sentry_sdk
from sentry_sdk import configure_scope

@app.middleware("http")
async def add_request_context(request: Request, call_next):
    with configure_scope() as scope:
        ctx = safe_request_context(request)
        for k, v in ctx.items():
            if v is not None:
                scope.set_extra(k, v)
    return await call_next(request)
Привязка отчётов к эндпоинтам и операциям
Одна из самых практичных настройок — сделать так, чтобы в Sentry события были легко локализуемы по эндпоинту и бизнес-операции.
Почему “path” может быть недостаточным
Если у вас GET /orders/123, то path будет разным для каждой сущности. Лучше:
- использовать route name (
orders_detail), - или шаблон пути (
/orders/{order_id}), - или хранить оба:
endpoint_templateиresource_id.
Пример: endpoint_template через FastAPI router
FastAPI позволяет получить request.scope["route"] в middleware. В зависимости от версии и подхода это может работать иначе, но идея такова:
@app.middleware("http")
async def sentry_endpoint_context(request: Request, call_next):
    endpoint_template = None
    route = request.scope.get("route")
    if route and getattr(route, "path", None):
        # path часто как "/orders/{order_id}"
        endpoint_template = route.path

    with configure_scope() as scope:
        if endpoint_template:
            scope.set_tag("endpoint", endpoint_template)
        scope.set_tag("method", request.method)
    return await call_next(request)
Добавление бизнес-операции
Теги для “операции” помогают в расследовании между командами: «это обработка платежа», «это пересчёт статуса», «это валидация схемы».
Обычно операцию задают на уровне сервиса/хэндлера:
def set_operation(operation: str):
    with configure_scope() as scope:
        scope.set_tag("operation", operation)
А в обработчике:
async def create_invoice(...):
    set_operation("invoices.create")
    # ...
Обработка исключений: единая точка отправки и “правильный” fingerprint
Глобальный обработчик
Важно ловить исключения в одном месте, чтобы:
- гарантировать отправку в Sentry,
- добавлять контекст (уже в scope),
- не дублировать события (например, если framework уже сделал захват).
Пример для FastAPI:
from fastapi.responses import JSONResponse
from fastapi import Request
import sentry_sdk

@app.exception_handler(Exception)
async def unhandled_exception_handler(request: Request, exc: Exception):
    # Sentry SDK может перехватывать сам, но для контроля контекста иногда полезно явно захватить.
    # Если интеграция FastAPI уже отправляет исключение, не отправляйте повторно.
    sentry_sdk.capture_exception(exc)
    return JSONResponse(
        status_code=500,
        content={"detail": "Internal server error"},
    )
“Воспроизводимость” и стабильность группировки
Чтобы ошибки были сопоставимыми между релизами, нужно:
- стабильный
release, - стабильная группировка исключений (stack trace чаще всего),
- аккуратная работа с fingerprint, если вы хотите принудительно группировать.
Один из вариантов — задавать fingerprint по типу ошибки и ключевым участкам стека, но не по данным запроса.
Пример:
import sentry_sdk
from sentry_sdk import configure_scope

def capture_with_fingerprint(exc: Exception):
    with configure_scope() as scope:
        # Пример: группируем по типу и “коду” места
        scope.fingerprint = [
            "type:" + type(exc).__name__,
            "frame:orders_service.py:create_invoice",
        ]
        sentry_sdk.capture_exception(exc)
Проверяйте эффект: fingerprint — мощный инструмент, который легко сделать «слишком общим» или «слишком специфичным».
Трассировка запросов до базы: от корреляции к span’ам
Ошибки — это только вершина айсберга. Трассировка (distributed tracing) показывает, где именно потеря времени или где возникла проблема: сериализация запроса, сетевой слой, очередь, транзакция БД, блокировки.
Подход на основе OpenTelemetry
Современный стандарт: OpenTelemetry. Но не везде он внедрён до конца. Даже если вы используете Sentry для ошибок, вы можете подключить tracing через Sentry (transaction traces) или через OTel collector.
В рамках статьи покажем концепцию “traces через Sentry”, потому что это проще для старта.
Включение traces_sample_rate
Sentry поддерживает tracing. Для начала используйте небольшой процент:
sentry_sdk.init(
    dsn=os.getenv("SENTRY_DSN"),
    environment=os.getenv("APP_ENV", "development"),
    release=os.getenv("APP_RELEASE"),
    integrations=[FastApiIntegration()],
    traces_sample_rate=0.1,  # например, 10% для прод-дебага
)
Дальше вы должны убедиться, что приложение и драйверы БД инструментируются. Для SQLAlchemy/Sanic/HTTP-клиентов часто нужны дополнительные интеграции или auto-instrumentation.
Инструментирование базы: SQLAlchemy / psycopg2 и проблемы реального мира
Где чаще всего ломается связь “запрос → база → ошибка”
- Тайминг и контекст теряются при использовании async-пула/фоновых задач, если вы не прокидываете trace context.
- Транзакции: если вы не правильно завершаете/откатываете транзакцию, некоторые ошибки появляются в другом месте.
- Сторонняя библиотека не инструментирована, и трасса обрывается.
Практическое решение: единый слой работы с БД
Часто самый эффективный шаг — создать единый “репозиторий” или “data access layer”, который:
- оборачивает операции БД,
- логирует/отмечает операцию (например,
operation=repo.find_order), - гарантирует, что ошибка будет поймана и отправлена с нужным контекстом.
Например, при SQLAlchemy (упрощённо):
from sqlalchemy.orm import Session

class OrdersRepository:
    def __init__(self, session: Session):
        self.session = session

    def get_order(self, order_id: str):
        # Можно добавить операцию
        # (обычно это делается на уровне service/handler, но допустимо и здесь)
        return self.session.query(Order).filter(Order.id == order_id).one()
Если ошибка возникает в БД, но scope уже обогащён endpoint/user_id/correlation-id, Sentry событие будет корректно связано с запросом.
Что именно логировать: события, трассы, “ошибки ожиданий” и шум
Одна из лучших практик — разделить ошибки на категории:
- Непредвиденные исключения (bugs, некорректные состояния, неожиданные ответы внешних сервисов).
- Ошибки интеграции (ошибки внешних API, таймауты).
- Ошибки данных (валидация, “не найдено”, несоответствие формата).
- Ошибки управления потоком (cancelled tasks, client disconnect, “ранний выход”).
Sentry обычно позволяет отправлять всё подряд, но это создаёт шум и делает триаж бессмысленным.
Практика: фильтровать и “downscope”
В Sentry можно настраивать:
- исключения, которые не отправлять (например,
HTTPException404/400), - исключения, которые отправлять как “info”/“warning” или только в определённых условиях,
- частоту отправки (sampling).
Пример с фильтрацией некоторых исключений:
import sentry_sdk
from sentry_sdk import capture_exception

def maybe_capture(exc: Exception):
    # Пример: не отправляем ошибки "не найдено" и валидацию
    if exc.__class__.__name__ in {"HTTPException"}:
        return
    capture_exception(exc)
В реальном проекте лучше работать по конкретным типам, а не по именам классов.
“Не спамить” параметрами
Отдельная линия — ограничение объёма extra:
- не отправляйте огромные payload’ы,
- не отправляйте поля, которые часто меняются и не несут исследовательской ценности,
- не отправляйте секреты.
Сценарий “событие воспроизводимо”: как собрать минимум для расследования
Представим, что вам пришло исключение в Sentry. Что нужно, чтобы вы смогли воспроизвести и локализовать проблему быстро?
Минимальный набор полей:
release(иenvironment)correlation_idendpoint(шаблон) +methoduser.id(если релевантно и безопасно)operation(бизнес-функция или service method)- “ключевые идентификаторы”:
order_id,invoice_id,payment_id
- “ключевые параметры поведения”:
limit,currency,feature_flag,mode
- Время и трасса (если включено tracing)
Это ровно тот набор, который даёт расследованию инженерную управляемость: вы можете повторить запрос (или его часть) в тестовой среде, проверить конкретную сущность, сравнить поведение между релизами.
Типичные ошибки при настройке Sentry и трассировки
1) Случайно отправили PII
Чаще всего причина — вы добавили в extra весь request.json(), включая email/phone/address, либо отправили “default PII”. Решение:
- строгая схема отбора полей,
send_default_pii=False,- внутренние политики на уровне разработчиков.
2) correlation-id не пробрасывается в async
contextvars решают часть проблем, но только если вы используете их правильно и не теряете контекст на переходах. Решение:
- middleware на входе,
- использование
contextvarsкак источника истины, - проверка с корреляцией на реальных запросах (а не на тесте, где всё синхронно).
3) endpoint хранится как реальный path
/orders/123 вместо /orders/{order_id} создаёт огромное количество групп по одному и тому же коду. Решение:
- сохраняйте route template или route name.
4) fingerprint основан на данных запроса
Если включили order_id в fingerprint — получите “уникальную” ошибку на каждую сущность. Решение:
- fingerprint — только на код/место/тип исключения.
5) Трасса обрывается на внешнем сервисе
Если HTTP-клиент или очередь не инструментированы, вы не увидите связь. Решение:
- включать auto-instrumentation,
- убедиться, что trace context передаётся в заголовках.
Объединяем всё вместе: пример “правильной” базовой настройки (скелет)
Ниже — сквозной пример идей: correlation-id, endpoint/operation tags, safe extras, привязка user.
Это не “копипаста под ваш проект”, а ориентир структуры.
import os
import uuid
import contextvars
from fastapi import FastAPI, Request
import sentry_sdk
from sentry_sdk import configure_scope

correlation_id_var = contextvars.ContextVar("correlation_id", default=None)

app = FastAPI()

sentry_sdk.init(
    dsn=os.getenv("SENTRY_DSN"),
    environment=os.getenv("APP_ENV", "development"),
    release=os.getenv("APP_RELEASE", "local"),
    send_default_pii=False,
    # traces_sample_rate=0.1,  # включайте после отладки контекста
)

def safe_request_context(request: Request):
    query = dict(request.query_params)
    limit = query.get("limit")
    currency = query.get("currency")
    return {
        "limit": int(limit) if limit and limit.isdigit() else None,
        "currency": currency,
    }

@app.middleware("http")
async def observability_middleware(request: Request, call_next):
    cid = request.headers.get("X-Correlation-ID") or str(uuid.uuid4())
    correlation_id_var.set(cid)

    # endpoint template
    endpoint_template = None
    route = request.scope.get("route")
    if route and getattr(route, "path", None):
        endpoint_template = route.path

    with configure_scope() as scope:
        scope.set_tag("correlation_id", cid)
        scope.set_tag("method", request.method)
        if endpoint_template:
            scope.set_tag("endpoint", endpoint_template)

        # safe extras
        ctx = safe_request_context(request)
        for k, v in ctx.items():
            if v is not None:
                scope.set_extra(k, v)

    response = await call_next(request)
    response.headers["X-Correlation-ID"] = cid
    return response

@app.exception_handler(Exception)
async def handler(request: Request, exc: Exception):
    # В проде лучше исключить дублирование с интеграцией, но концепт таков:
    with configure_scope() as scope:
        scope.set_tag("endpoint", request.url.path)  # для диагностики; лучше route template
        scope.set_tag("method", request.method)
        scope.set_extra("correlation_id", correlation_id_var.get())
        # scope.set_user(...) — если вы храните user_id в контексте
        sentry_sdk.capture_exception(exc)
    return {"detail": "Internal Server Error"}
Ключевые отличия «рабочей схемы» от хаотичной:
- корреляция гарантирована,
- параметры фильтруются,
- endpoint хранится как шаблон (когда возможно),
- user_id добавляется на уровне аутентификации,
- release/env подставляются из CI/CD.
Как проверить, что всё работает: чеклист валидации
- Один тестовый запрос вызывает ошибку.
- Откройте событие в Sentry:
- проверьте
releaseиenvironment, - найдите
correlation_id, - убедитесь, что
endpointпохож на шаблон, - проверьте
user.id(если ожидается), - убедитесь, что
extraсодержит нужные поля и нет PII.
- проверьте
- Сравните два релиза: ошибка должна попадать в ту же группу (или в ожидаемую новую), но при этом быть привязана к разным
release. - Трассировка (если включена):
- убедитесь, что есть спаны web → service → db,
- убедитесь, что correlation-id/trace context не потерялся на async границах.
Выводы: наблюдаемость как инженерный процесс
Мониторинг ошибок в Python — это не про установку SDK. Это про управляемую систему контекста: вы должны гарантировать, что каждое исключение несёт минимальный, безопасный и воспроизводимый набор данных. Тогда Sentry (или аналог) превращается из “кнопки отправки stack trace” в инструмент расследования, который:
- сопоставляет ошибки между релизами,
- позволяет быстро локализовать эндпоинт и бизнес-операцию,
- связывает запрос клиента с операциями до базы,
- сокращает время диагностики и снижает нагрузку на людей в триаже.
Если вы хотите глубже разобрать принципы построения контекста, трассировки и практики работы с наблюдаемостью в реальных проектах, можно рассмотреть курс по смежной теме — например, разделить обучение так, чтобы параллельно с кодом вы выстраивали и модель событий/тегов; один из таких путей — /course/ (подберите материал под ваш стек и сценарии).
Главное — начать с малого: correlation-id + endpoint шаблон + release + безопасные extras. А трассировку до базы и расширение набора контекста делайте итеративно, проверяя, что вы не создаёте шум и не теряете контекст на переходах между компонентами.