Параллельность в Python без головной боли: потоки vs процессы vs асинхронность
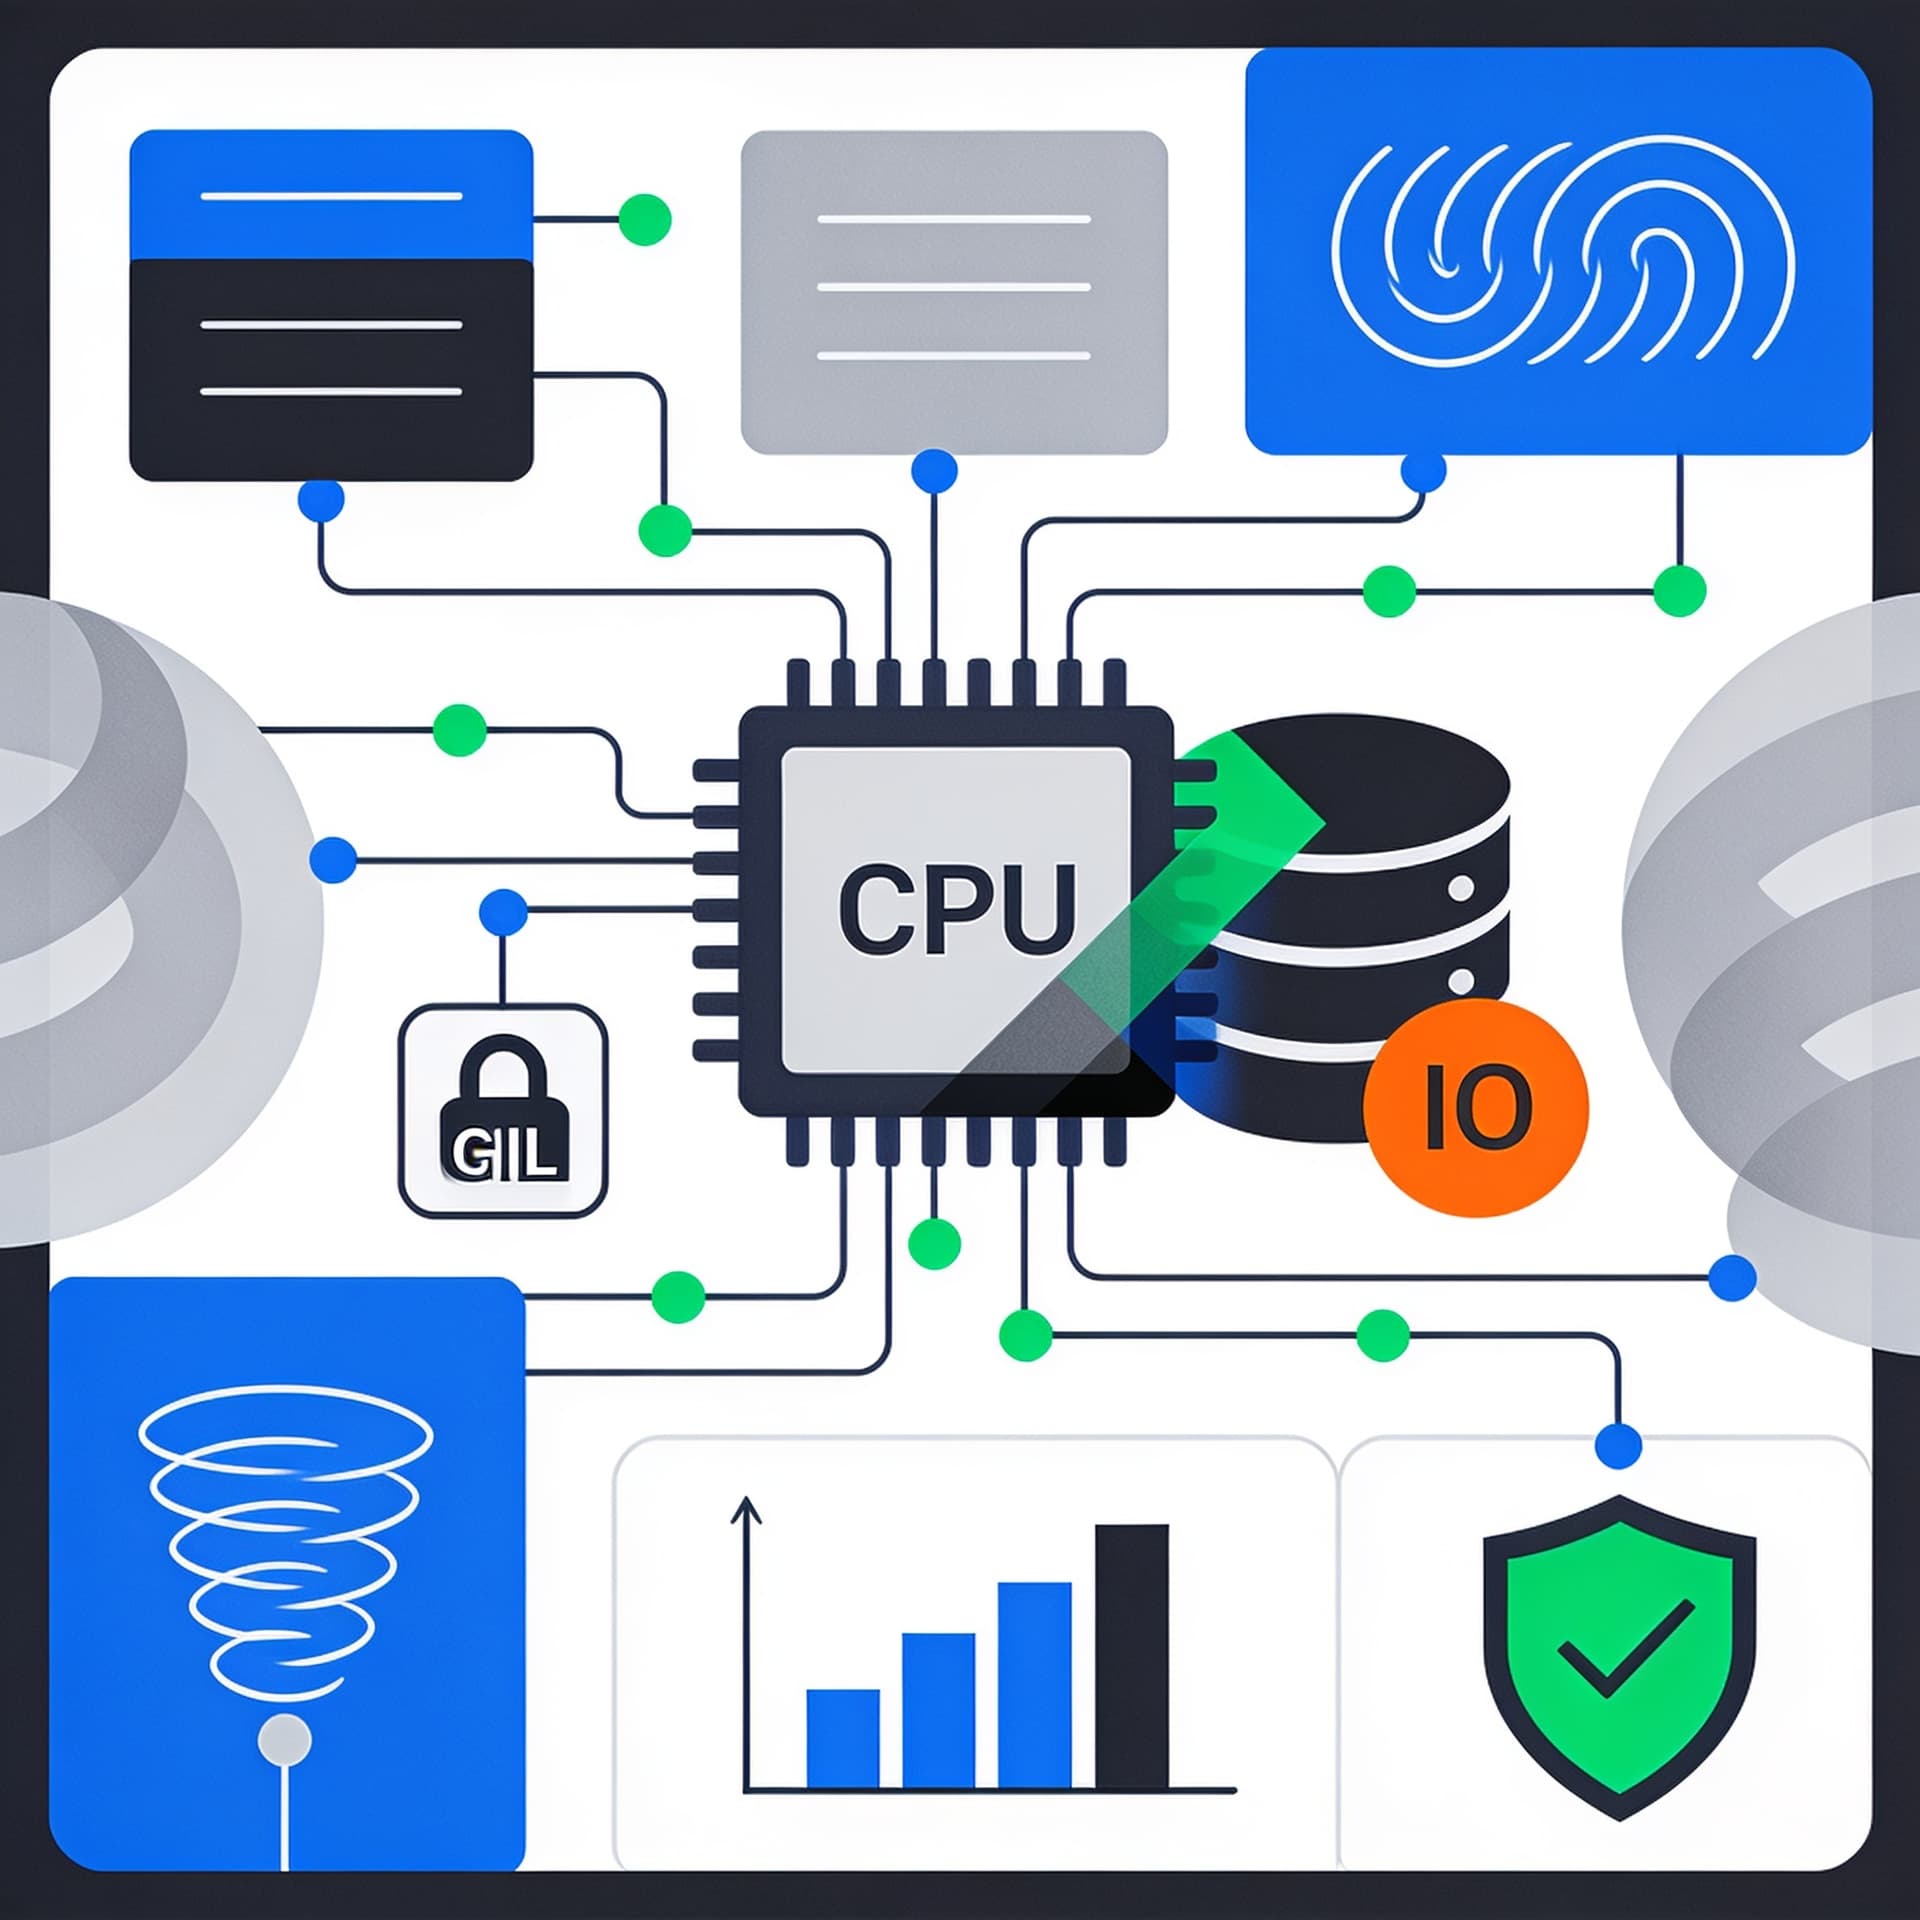
Как выбрать подходящий инструмент для задач с CPU, IO и смешанной нагрузкой. Покажем, где под капотом узкие места (GIL), как измерять эффект и как избежать типичных ошибок планирования задач.
Содержание
Параллельность в Python — тема, где легко «победить» в теории и получить нулевой эффект в реальности. Причина не в том, что инструменты плохие, а в том, что нагрузка бывает разная: CPU-bound, IO-bound и смешанная. Плюс есть дополнительные ограничения платформы — прежде всего GIL, механика планирования и особенности библиотек.
Эта статья — практический разбор того, как выбирать подходящий инструмент, что происходит под капотом, как измерять эффект и какие ошибки планирования задач чаще всего сводят выигрыш на нет.
Что именно мы пытаемся ускорить
В Python “параллельность” — это не одно понятие. Обычно речь о трёх сценариях:
1) CPU-bound: вычисления в Python
Если задача упирается в процессор (например, сжатие данных, обработка изображений, перебор, вычисление статистик на больших массивах), то “ускорение” означает: нужно задействовать несколько ядер.
Проблема: GIL (Global Interpreter Lock) мешает одновременно исполнять байткод Python в одном процессе. Это ключ к пониманию, почему “потоки” часто не дают ускорения для CPU-bound.
2) IO-bound: ожидание сети/файлов/таймеров
Если задача в основном ждёт (запросы к API, чтение/запись, ожидание ответов базы, сканирование файлов), то “ускорение” означает: скрыть время ожидания, переключаясь на другую работу.
Потоки и асинхронность здесь обычно выигрывают, потому что время занятости CPU минимально.
3) Смешанная нагрузка
Часто в реальных системах 80% времени — IO, а 20% — CPU. Здесь важно не только “выбрать инструмент”, но и правильно распределить работу по стадиям.
Три инструмента: потоки, процессы и асинхронность
Потоки (threading): параллелизм ожидания
Потоки в Python полезны, когда:
- много I/O (сетевые вызовы, диск, ожидания),
- вы используете библиотеки, которые отпускают GIL во время системных вызовов или работают на нативном коде,
- задача проста и вы не хотите перестраивать архитектуру под event loop.
Типичный механизм: один процесс, несколько потоков. Планировщик ОС переключает потоки; Python при этом остаётся в рамках одного интерпретатора процесса и упирается в GIL при CPU-bound.
Узкое место: GIL
GIL не даёт потокам одновременно исполнять Python-байткод. Поэтому если CPU-bound — потоки часто будут вести себя как “один поток, но с накладными расходами на переключение”.
Процессы (multiprocessing): параллелизм CPU
Процессы обходят GIL, потому что каждый процесс имеет собственный интерпретатор и собственный GIL. Это делает multiprocessing подходящим для CPU-bound задач.
Минусы:
- выше накладные расходы на запуск процессов,
- нужно продумать передачу данных (pickle/IPC/очереди),
- сложнее управление ресурсами и обработка ошибок.
Асинхронность (asyncio): параллелизм ожидания в одном потоке
asyncio — это кооперативная многозадачность в одном потоке: задачи “уступают управление” при ожиданиях (await). Это удобно для IO-bound.
Плюсы:
- меньше накладных расходов, чем у потоков,
- контроль конкурентности через семафоры/лимиты,
- хорошая интеграция с современными сетевыми библиотеками.
Минусы:
- CPU-bound нельзя “просто заменить” на async: вычисления всё равно блокируют event loop,
- нужно соблюдать дисциплину: никаких долгих синхронных вычислений в корутине.
Где под капотом возникают узкие места
GIL: что он делает и чего не делает
GIL — это механизм сериализации исполнения байткода Python в рамках процесса. В упрощённом виде:
- Пока поток выполняет байткод Python, другие потоки не могут выполнять байткод.
- Во время I/O и некоторых операций на C-библиотеках GIL может быть отпущен.
Важно: это не “потоки всегда бесполезны”. Потоки могут эффективно работать, если большая часть времени — ожидания и/или нативные операции, которые освобождают GIL.
Планирование: почему «я запустил 100 задач» не значит «они ускорятся»
Есть несколько практических ограничений:
- лимиты соединений (сетевая подсистема, пул HTTP),
- лимиты файлов/дескрипторов,
- лимиты базы данных (коннекты, пул, транзакции),
- контекстные переключения (для потоков),
- временные кванты и “thundering herd” при асинхронности (когда много задач просыпаются одновременно).
Отдельная ошибка — запускать задачи “в лоб” без ограничения конкурентности. Это часто приводит не к ускорению, а к деградации из-за очередей и конкуренции за ресурсы.
Как измерять эффект корректно: не верьте ощущениям
Самая частая ошибка при сравнении подходов — измерять “в целом” без учёта того, что вы тестируете.
Правильный набор метрик
Для CPU/IO смешанных задач смотрят:
- throughput (сколько задач/сек обработано),
- latency (p50/p95/p99, особенно для IO),
- CPU utilization (сколько реально времени процессор занят),
- количество активных задач и время ожиданий.
Измерения
- Для времени —
time.perf_counter()(корректен для измерений длительности). - Для профилирования —
cProfile(для CPU-bound в одном процессе) и системные инструменты (htop, perf на Linux). - Для асинхронности — логирование времени ожидания
awaitи тайминги внутри корутин.
Ниже — минимальный пример корректного замера CPU-bound (однопоточный базовый уровень):
import time
import math

def work(n: int) -> float:
    s = 0.0
    for i in range(n):
        s += math.sqrt(i)  # имитируем CPU-bound
    return s

def benchmark(fn, *args, repeats=5):
    durations = []
    for _ in range(repeats):
        t0 = time.perf_counter()
        fn(*args)
        durations.append(time.perf_counter() - t0)
    durations.sort()
    return {
        "min": durations[0],
        "median": durations[len(durations)//2],
        "max": durations[-1],
    }

print(benchmark(work, 3_000_00))
На практике сравнивать нужно одинаковые условия: одинаковый объём данных, одинаковые ограничения сети/диска, одинаковая конфигурация пула.
“Ускорение” ≠ “ускорение”
Если у вас IO-bound и вы увеличиваете параллельность, то throughput может расти до некоторого предела, а затем будет падать: база начинает отвечать медленнее, появляются ретраи, очередь запросов растёт.
Именно поэтому измерения обязательны: у каждого сервиса/машины есть свой “sweet spot”.
Потоки: когда они оправданы и как использовать без ошибок
Сценарий: IO-bound
Классический пример — загрузка данных из сети через синхронный HTTP-клиент, который блокирует поток.
Паттерн: ThreadPoolExecutor + лимит
from concurrent.futures import ThreadPoolExecutor, as_completed
import requests

URLS = ["https://example.com/api/1", "https://example.com/api/2"] * 50

def fetch(url: str) -> int:
    r = requests.get(url, timeout=10)
    r.raise_for_status()
    return len(r.text)

def run():
    results = []
    with ThreadPoolExecutor(max_workers=16) as pool:
        futures = [pool.submit(fetch, u) for u in URLS]
        for fut in as_completed(futures):
            results.append(fut.result())
    return results

if __name__ == "__main__":
    run()
Ключевые моменты:
max_workers— не “сколько угодно”, а разумный лимит.as_completedпозволяет начать обработку результатов сразу, а не ждать окончания всех задач.timeoutобязателен: иначе зависшая операция заблокирует поток и “съест” лимит.
Подводный камень: CPU-bound в потоках
Если fetch внутри потоков заменится на тяжёлую обработку на чистом Python — эффект исчезнет. В таком случае подход меняется: CPU-часть выносится в процессы, а IO — остаётся в потоках/асинхронности.
Процессы: как получить реальный выигрыш на CPU и не утонуть в накладных расходах
Сценарий: CPU-bound
multiprocessing (или concurrent.futures.ProcessPoolExecutor) полезен для CPU-bound вычислений. Но важно:
- не передавайте гигантские данные в каждую задачу,
- избегайте постоянной сериализации больших объектов,
- группируйте работу (батчами).
Пример: ProcessPoolExecutor
from concurrent.futures import ProcessPoolExecutor
import math

def cpu_work(n: int) -> float:
    s = 0.0
    for i in range(n):
        s += math.sqrt(i)
    return s

def run(nums):
    with ProcessPoolExecutor(max_workers=4) as pool:
        # map удобно, но при больших объёмах лучше батчить
        return list(pool.map(cpu_work, nums))

if __name__ == "__main__":
    nums = [300_000] * 20
    results = run(nums)
    print(len(results), results[0])
Накладные расходы: почему “процессы быстрее” не всегда правда
Даже для CPU-bound ускорение может не появиться, если:
- задачи слишком маленькие (overhead IPC/serialization доминирует),
- вы отправляете большие объекты в аргументах,
- вы запускаете процессы на каждый вызов без повторного использования.
Практический совет: измеряйте и уменьшайте размер задач до “достаточного” гранулярного уровня. Иногда лучше обработать данные пачками внутри одного вызова, чем назначать миллион мелких задач.
Общие ресурсы и “скрытые” проблемы
- Глобальные переменные в процессе — разные для каждого worker. Если вы “инициализируете” тяжёлые структуры, нужно продумать инициализацию один раз на worker.
- Блокировки и очереди — тоже стоимость. Если можно обойтись без shared state, часто лучше так и сделать.
Асинхронность: максимальная эффективность для IO-bound при дисциплине
Сценарий: IO-bound с event loop
Если ваш стек — async-friendly (например, aiohttp, asyncpg, async-клиенты), то asyncio даёт хороший throughput при малых накладных расходах.
Пример: ограничение конкурентности
import asyncio
import aiohttp

URLS = ["https://example.com/api/1", "https://example.com/api/2"] * 50

SEM = asyncio.Semaphore(16)

async def fetch(session: aiohttp.ClientSession, url: str) -> int:
    async with SEM:
        async with session.get(url, timeout=aiohttp.ClientTimeout(total=10)) as resp:
            resp.raise_for_status()
            text = await resp.text()
            return len(text)

async def run():
    async with aiohttp.ClientSession() as session:
        tasks = [asyncio.create_task(fetch(session, u)) for u in URLS]
        results = []
        for t in asyncio.as_completed(tasks):
            results.append(await t)
    return results

if __name__ == "__main__":
    results = asyncio.run(run())
    print(len(results))
Здесь важно:
Semaphoreограничивает реальную параллельность, иначе можно “убить” сервис.aiohttp.ClientTimeoutзадаёт общие тайм-ауты.- Не забывайте об обработке исключений (в проде — обязательно).
Подводный камень: CPU внутри корутин
Если вы в fetch начнёте делать тяжёлую обработку на Python, event loop будет заблокирован, и выигрыш пропадёт.
В таком случае есть два варианта:
- вынести CPU в
ProcessPoolExecutor(сasyncio.to_thread— для I/O, не для CPU), - либо использовать нативные/параллелизируемые библиотеки (NumPy часто освобождает GIL, но это зависит от операции).
Смешанная нагрузка: практичная архитектура “IO в async + CPU в процессы”
Самый устойчивый подход для реальных пайплайнов: разделить этапы.
- IO-этап — асинхронный (asyncio) или потоковый (threading) в зависимости от библиотек.
- CPU-этап — процессы (ProcessPool) или нативный код.
Пример паттерна: async-скачивание + CPU-обработка в процессах
import asyncio
import aiohttp
from concurrent.futures import ProcessPoolExecutor
import math

def cpu_transform(payload: str) -> float:
    # имитируем CPU-bound вычисление
    n = min(len(payload) * 1000, 500_000)
    s = 0.0
    for i in range(n):
        s += math.sqrt(i)
    return s

async def run(urls):
    loop = asyncio.get_running_loop()
    sem = asyncio.Semaphore(16)

    with ProcessPoolExecutor(max_workers=4) as pool:
        async with aiohttp.ClientSession() as session:
            async def one(url: str):
                async with sem:
                    async with session.get(url, timeout=aiohttp.ClientTimeout(total=10)) as resp:
                        resp.raise_for_status()
                        text = await resp.text()
                    # переносим CPU-часть в процессы
                    return await loop.run_in_executor(pool, cpu_transform, text)

            tasks = [asyncio.create_task(one(u)) for u in urls]
            results = []
            for t in asyncio.as_completed(tasks):
                results.append(await t)
            return results

if __name__ == "__main__":
    urls = ["https://example.com/api/1"] * 20
    print(len(asyncio.run(run(urls))))
Заметьте дисциплину:
- event loop только “оркестрирует” I/O,
- CPU реально исполняется в отдельных процессах,
- параллельность ограничена: и для I/O через
Semaphore, и для CPU черезmax_workers.
Типичные ошибки планирования задач и как их избегать
Ошибка 1: “Сделаю 100 потоков/корутин — будет быстрее”
Часто это превращается в:
- всплеск соединений,
- рост времени ожиданий,
- перегрузка очередей на стороне БД/HTTP-сервиса,
- деградация latency.
Лекарство: всегда вводите лимиты конкурентности:
Semaphoreв async,max_workersвThreadPoolExecutor/ProcessPoolExecutor.
Ошибка 2: CPU-bound в async — event loop зависает
Симптом: latency “плавает”, задачи выполняются как будто последовательно, CPU у одного ядра 100%.
Лекарство:
- CPU выносить в процессы (
run_in_executor), - или использовать нативные оптимизации, которые не блокируют Python (NumPy/numba/C extensions).
Ошибка 3: Слишком мелкие CPU-задачи в ProcessPool
Если каждая задача — крошечная, накладные расходы на сериализацию/IPC съедают выигрыш.
Лекарство: батчить задачи или увеличивать гранулярность.
Ошибка 4: Передача больших объектов между процессами
Передача аргументов в процессы требует сериализации. Если объект большой, pickle превращается в отдельную “работу”, и вы теряете эффект.
Лекарство:
- передавать минимальные данные,
- хранить данные ближе к воркерам (инициализация в worker),
- использовать shared memory/меммап (в сложных случаях).
Ошибка 5: Отсутствие тайм-аутов и отмены задач
В конкурентных системах без тайм-аутов вы получаете “вечные” операции, которые занимают ресурсы: потоки, соединения, воркеры.
Лекарство:
- всегда задавать
timeout, - в async — корректно отменять задачи при тайм-ауте/ошибке,
- в процессах — обрабатывать исключения и гарантировать завершение.
Практический “чек-лист” выбора
Когда вы планируете параллельность, ответьте на вопросы:
-
Это CPU-bound или IO-bound?
- Если в основном CPU → начинайте с процессов.
- Если в основном ожидание → начинайте с потоков или asyncio.
-
Какие библиотеки у вас?
- Если у вас есть async-ready клиенты — asyncio логичнее.
- Если всё синхронное — потоки могут быть дешевле по трудозатратам.
-
Нужно ли смешивать IO и CPU?
- Тогда разделяйте этапы: IO в async/threads, CPU в processes.
-
Есть ли лимиты у внешних систем?
- Введите конкурентность-лимиты, иначе “ускорение” сломает сервис.
-
Как вы измеряете?
- Benchmark + профилирование + сравнение p50/p95 latency (для IO).
Где “границы” и что делать, если хотите ещё глубже
С практикой обычно приходит понимание: потоки, процессы и асинхронность — это не “три конкурирующих магии”, а три способа управлять тем, как расходуется время (CPU vs ожидание) и *ка