Переход с raw SQL на SQLModel: где выигрываете, а где придётся думать
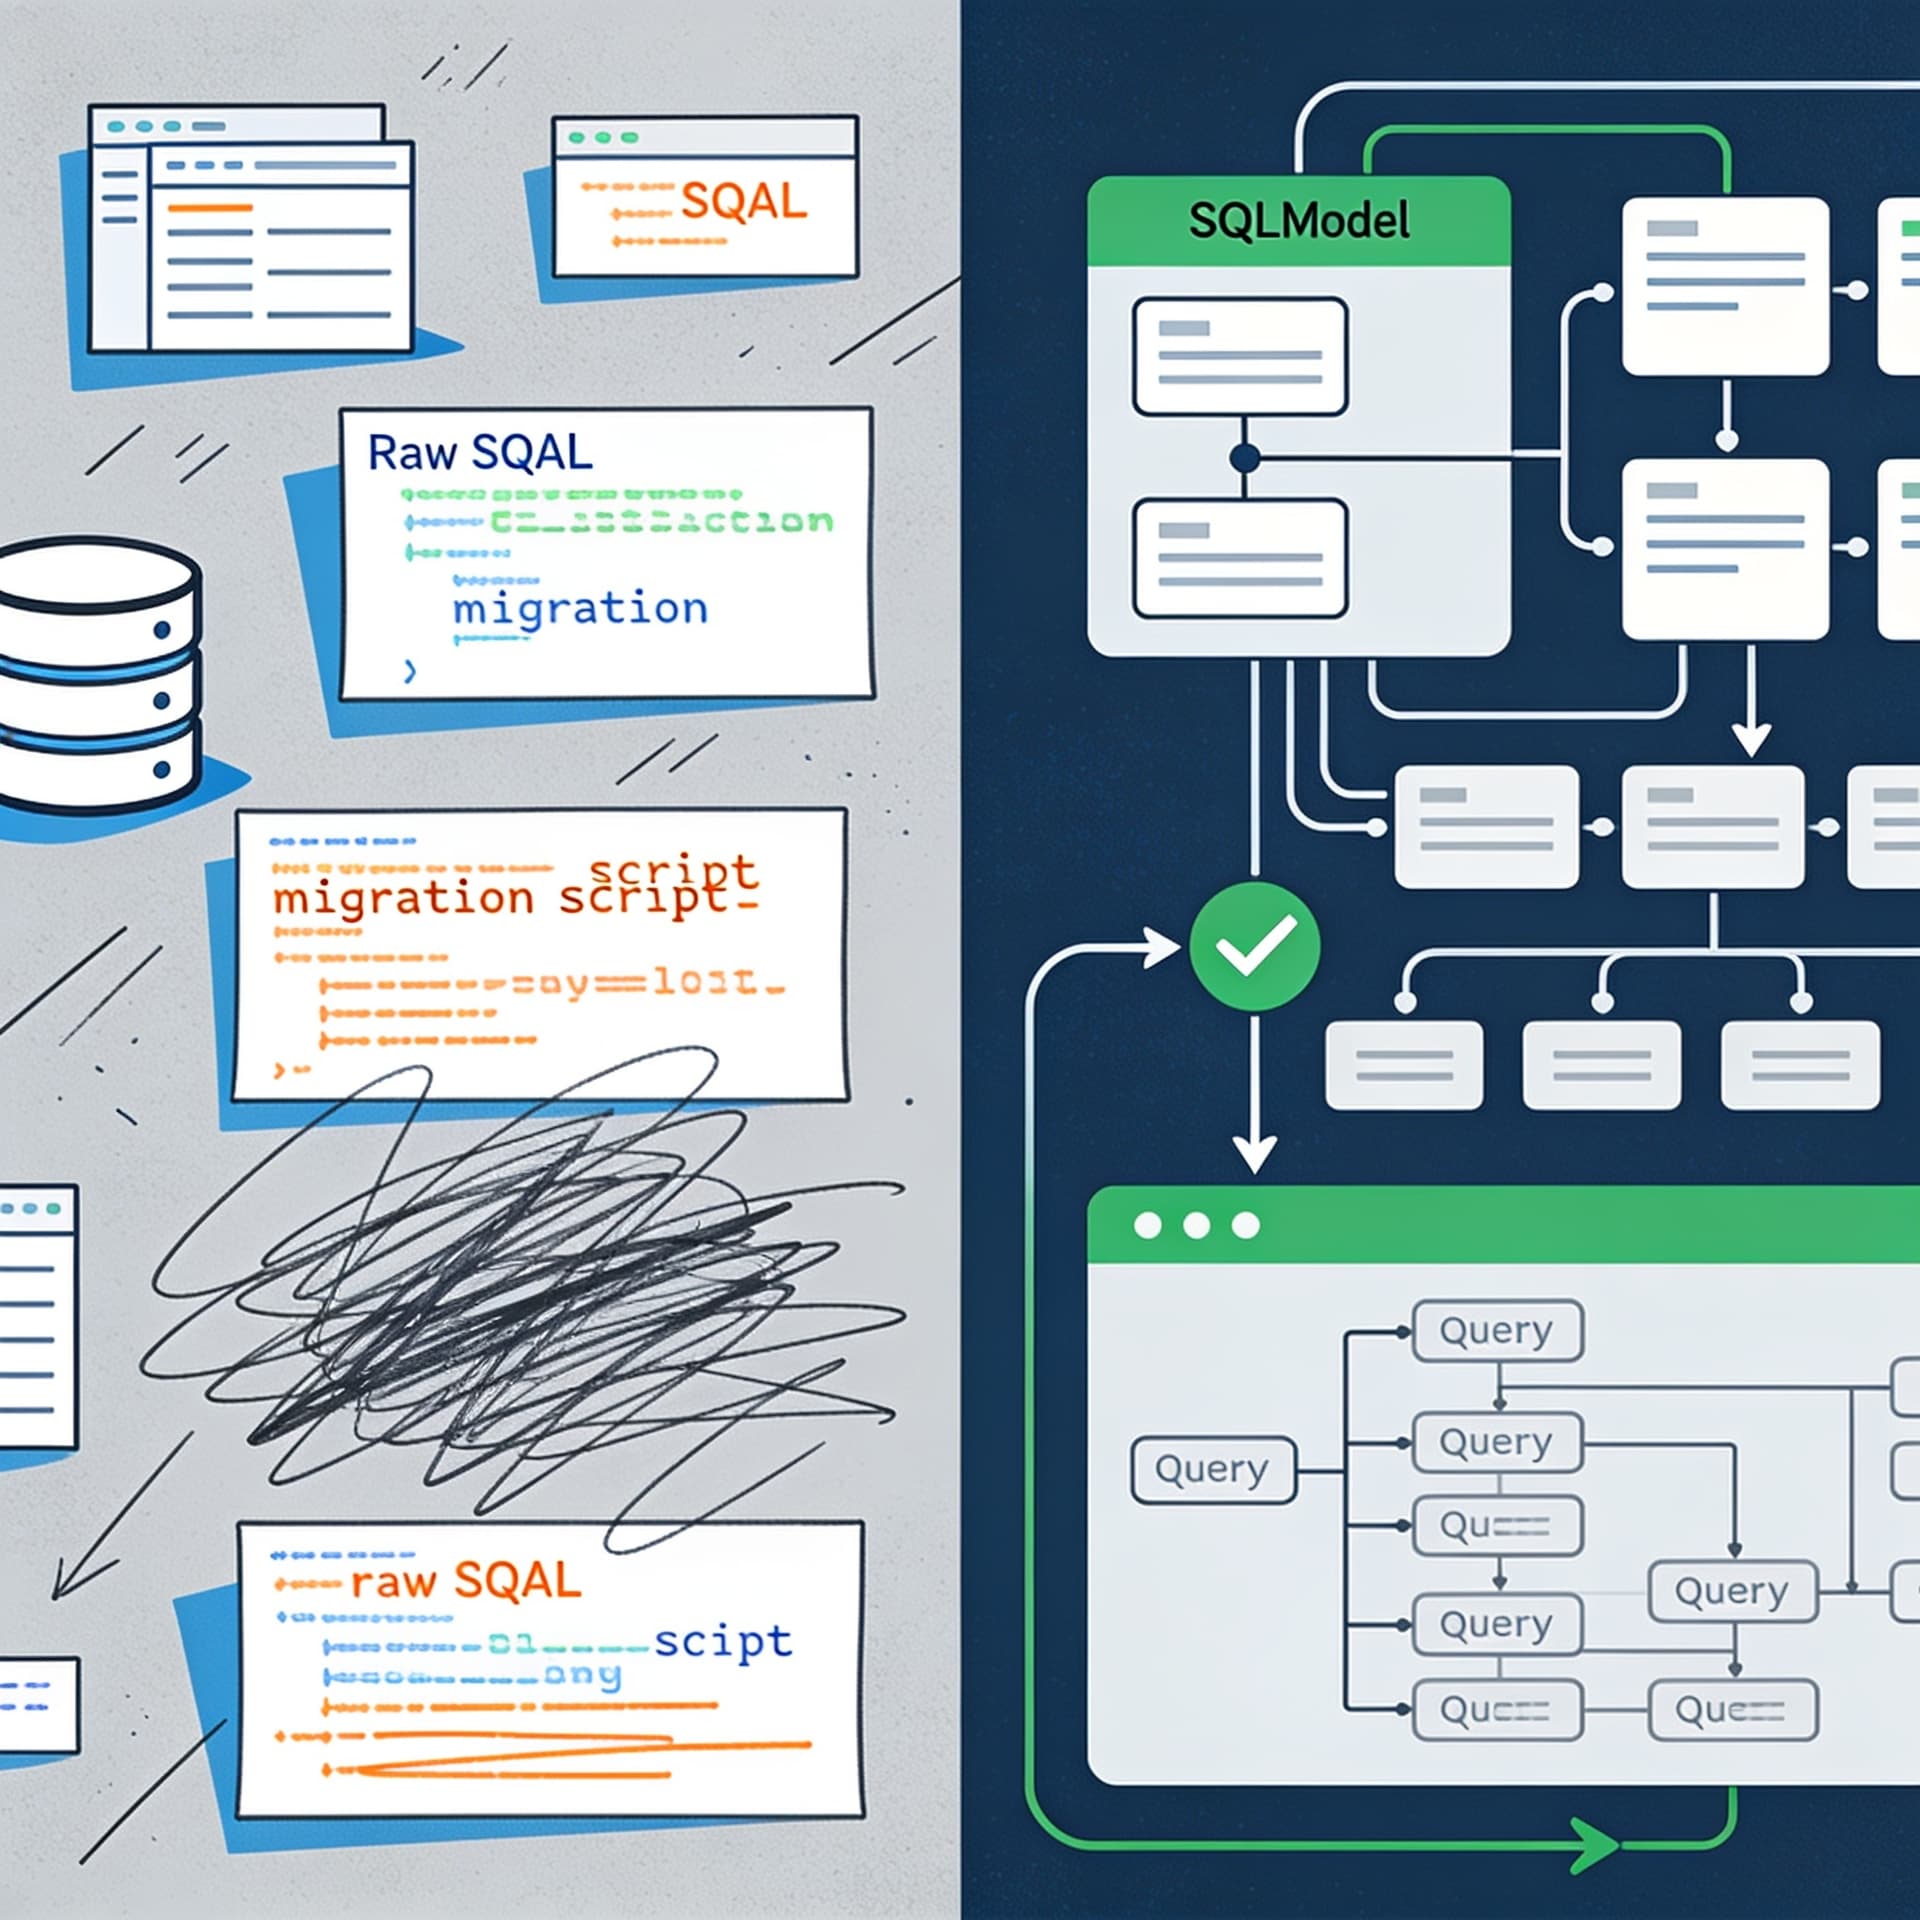
Сравним подходы на практике: модели, связи, ограничения, миграции и работа с сложными запросами. Дадим правила, когда SQLModel — лучший выбор, а когда лучше писать SQL осознанно.
Содержание
Многие проекты на Python начинались с raw SQL по простой причине: так быстрее получить работающий результат, особенно когда схема уже есть и запросы «знают, как надо». Со временем же вы сталкиваетесь с типичными болями: дублирование логики в строках SQL, дрейф схемы и моделей, сложность с валидацией входных данных, неочевидные связи и слабая поддержка переносимости.
SQLModel (надстройка над SQLAlchemy) обещает решить значительную часть этих проблем: модели становятся “единственным источником правды” для схемы, типы данных — ближе к Python, а типизация и валидация — к входным данным. Но на практике переход — не «заменили строку на модель и всё стало лучше». В реальном коде выигрыши проявляются в определённых зонах, а местами приходится думать ещё внимательнее, чем с raw SQL.
Ниже — разбор подходов на практике: как меняются модели, связи, ограничения, миграции и работа со сложными запросами. Дам правила выбора: когда SQLModel — лучший инструмент, а когда лучше оставлять осознанно написанный SQL.
Что именно вы меняете: raw SQL vs модели
raw SQL: сила — в выражении и контроле
Raw SQL — это:
- максимальный контроль над тем, что реально выполняется в БД;
- простая проверка «как будет» через EXPLAIN/ANALYZE;
- возможность использовать специфические фичи конкретного СУБД (например, PostgreSQL JSONB-операторы, CTE-цепочки, оконные функции).
Но цена — в том, что предметная область живёт в нескольких местах:
- схемы — в миграциях/DDL;
- структуры — где-то в DTO/Pydantic;
- запросы — в репозиториях строками SQL;
- связи и ограничения — частично в БД, частично «в голове».
Со временем это даёт расхождения и «магические» зависимости.
SQLModel: схему вы описываете ближе к домену
SQLModel упрощает:
- объявление таблиц и полей (как правило — через Python-объекты);
- валидацию входных данных (частично на уровне Pydantic);
- управление связями и ограничениями на уровне ORM;
- единообразие: меньше кода, который описывает одно и то же разными способами.
Но важно понимать: SQLModel не отменяет SQL. Он лишь переводит часть логики на уровень запросов ORM. Если вам нужен конкретный план выполнения или сложная оптимизация, ORM может стать «ещё одним слоем», который придётся уметь обходить.
Модели и типы: где ORM действительно выигрывает
Типизация и валидация “до запроса”
С raw SQL валидация обычно живёт в отдельных слоях (Pydantic DTO, ручные проверки). В SQLModel типы и ограничения часто становятся общими:
- поля модели задают тип данных;
- Pydantic-часть помогает поймать некорректные входные значения до записи в БД;
- ограничения валидации могут частично подтягиваться из схемы.
Пример упрощённой модели пользователя:
from typing import Optional
from sqlmodel import SQLModel, Field


class User(SQLModel, table=True):
    id: Optional[int] = Field(default=None, primary_key=True)
    email: str = Field(index=True, unique=True)
    age: Optional[int] = Field(default=None, ge=0, le=150)
    is_active: bool = Field(default=True)
В чём плюс по сравнению с raw SQL:
- меньше разрозненных мест, где вы проверяете
ageили ограничиваете email; - форма входных данных часто совпадает с моделью домена/таблицы.
Однако подводный камень: ограничения, заданные на уровне Python/валидации, — это не то же самое, что ограничения на уровне БД. DB-уровень остаётся обязательным для консистентности. Если вы полагаетесь только на валидацию ORM, вы рискуете получить рассинхрон при параллельных изменениях или альтернативных путях записи данных.
Нюанс: “уникальность” — не только индексы, но и политика обработки
В модели выше unique=True создаёт уникальный constraint (в зависимости от миграций/генерации). Но как вы обрабатываете нарушение уникальности?
С raw SQL часто вы ловили конкретную ошибку СУБД и отвечали на неё. В ORM нужно всё равно:
- отлавливать исключения на уровне транзакции;
- маппить их на понятные ошибки домена.
То есть ORM уменьшает количество кода, но не снимает проблему проектирования ошибок.
Связи: where SQLModel помогает, но не магия
Один-ко-многим и многие-ко-многим: меньше ручного труда
С raw SQL связи обычно реализуются через JOIN’ы, где:
- вы вручную пишете условия соединения;
- вы заботитесь о фильтрах, пагинации, агрегациях;
- вы иногда копируете паттерны из запроса в запрос.
В SQLModel типичные связи декларативнее. Пример: у пользователя есть посты (один-ко-многим).
from typing import List, Optional
from sqlmodel import SQLModel, Field, Relationship


class PostBase(SQLModel):
    title: str
    content: str


class User(SQLModel, table=True):
    id: Optional[int] = Field(default=None, primary_key=True)
    email: str = Field(index=True, unique=True)
    posts: List["Post"] = Relationship(back_populates="author")


class Post(SQLModel, table=True):
    id: Optional[int] = Field(default=None, primary_key=True)
    title: str
    content: str

    user_id: int = Field(foreign_key="user.id")
    author: Optional[User] = Relationship(back_populates="posts")
В этом месте SQLModel часто даёт выигрыш:
- код становится ближе к предметной модели;
- меньше ручных JOIN’ов при работе с объектами (в зависимости от того, как вы строите запросы и грузите отношения).
Но нужно думать: загрузка отношений и N+1
Самая частая проблема при переходе на ORM — «скрытый N+1». Raw SQL почти всегда заставляет вас думать о том, какой JOIN сделать. ORM иногда позволяет случайно уйти в режим:
- загрузили список пользователей;
- по каждому пользователю лениво достали посты;
- и получили десятки/сотни запросов.
SQLModel как часть экосистемы SQLAlchemy не отменяет эту реальность. Поэтому правило для перехода звучит так:
Если отношения нужны в ответе API — проектируйте загрузку заранее (joined/ selectin), а не полагайтесь на дефолты.
В противном случае вы можете даже ухудшить производительность относительно raw SQL.
Ограничения и индексы: проще объявить, но сложнее держать в согласии
Как переносится логика ограничений
В raw SQL ограничения закреплены в миграциях: CHECK, FOREIGN KEY, UNIQUE, NOT NULL, partial indexes.
В SQLModel вы объявляете их в моделях (полями и параметрами Field). Однако вопрос миграций остаётся тем же: кто и как применяет DDL к БД.
Важно уточнить практику команды:
- вы используете Alembic для миграций?
- миграции генерируются из моделей автоматически или вручную?
- как вы контролируете изменения в схемах в ревью?
Если миграции не дисциплинированы, то “модель в коде” и “схема в БД” расходятся — и вы получаете те же проблемы, что были с raw SQL, только в другом месте.
Индексы и сложные ограничения
Лёгкие индексы index=True в модели — обычно не проблема. А вот:
- составные индексы;
- partial indexes;
- выражения для функциональных индексов;
- специфичные для PostgreSQL constraint’ы;
— часто потребуют более глубокого уровня: либо прямых DDL в миграциях, либо расширенной конфигурации метаданных.
Вывод практический: SQLModel хорошо описывает базовые constraints, но для «тяжёлой» индексной политики всё равно будет место для осознанного SQL в миграциях (или в фабрикации индексов).
Миграции: главный “взрослый” вопрос при переходе
Где переход ломается чаще всего
Переход с raw SQL на ORM обычно начинается с репозиториев и моделей. Но схема в БД — источник истины. Поэтому вам придётся синхронизировать:
- изменения моделей;
- изменения миграций;
- ожидания рантайма (какие constraints реально уже существуют).
Типичный сценарий провала:
- вы поменяли модель, добавили поле и
unique=True; - в коде ORM уже думает, что constraint есть;
- миграции не применились (или применились не везде);
- на проде получили неожиданные дубликаты или ошибки.
С raw SQL это тоже случается, но там обычно весь путь DDL/запросов контролируется более прямо.
Рекомендации по процессу
- Договоритесь, что схема — это миграции. Модели — описание этой схемы, но они не заменяют процесс DDL.
- В ревью миграций убедитесь, что изменения действительно соответствуют изменённым моделям.
- На время миграции используйте фазовый подход:
- сначала добавить nullable поля и индексы/constraints без строгих проверок;
- затем backfill;
- затем сделать constraint строгим (например, NOT NULL).
Это универсальная стратегия, она одинаково полезна и при raw SQL, и при SQLModel.
Репозитории и запросы: как выглядит «обычный день» с SQLModel
CRUD и простые выборки
CRUD обычно становится короче. Пример: создание пользователя.
from sqlmodel import Session, select
from typing import Optional

# engine создаётся отдельно
# from sqlalchemy.engine import Engine

def create_user(session: Session, email: str) -> Optional[int]:
    user = User(email=email)
    session.add(user)
    session.commit()
    session.refresh(user)
    return user.id
Для чтения:
def get_user_by_email(session: Session, email: str) -> Optional[User]:
    statement = select(User).where(User.email == email)
    return session.exec(statement).first()
С raw SQL вы бы написали курсор/строку, маппинг в структуру, обработку результата. ORM снимает часть рутины, а код становится ближе к домену.
Но вопрос “сколько SQL генерируется” остаётся
ORM генерирует SQL, и важно понимать:
- какая часть будет “in-database”;
- какие вычисления окажутся в Python;
- как будет выглядеть конкретный SQL.
Практический подход: в сложных местах включайте логирование и смотрите реальный SQL, который исполняется. Это особенно важно при переходе, когда ожидания разработчика могут не совпасть с тем, что сделал ORM.
Сложные запросы: где SQLModel выигрывает, а где raw SQL неизбежен
Когда ORM справляется хорошо
SQLModel/SQLAlchemy отлично подходит для:
- выборок по фильтрам и сортировкам;
- пагинации;
- простых агрегаций;
- выборок с предсказуемыми JOIN’ами;
- комбинаций условий
and_ / or_ / in_, если логика не превращается в монстра.
Пример запроса: список постов пользователя с условием по активности.
(Упрощённо, без демонстрации загрузки отношений.)
from sqlmodel import select

def posts_for_active_users(session):
    statement = (
        select(Post)
        .join(User, Post.user_id == User.id)
        .where(User.is_active == True)
        .order_by(Post.id.desc())
    )
    return session.exec(statement).all()
Когда без “осознанного SQL” всё равно придётся думать
Есть несколько классов ситуаций, где raw SQL остаётся оправданным:
-
Сильно специфичный SQL конкретной СУБД
Например, сложная работа с JSONB, рекурсивные CTE, window functions с нестандартными выражениями, materialized views. -
Запросы, где критичен план выполнения
Вы часто делаете “тонкую” оптимизацию: хинты, особые индексы, точные условия в нужном порядке. ORM может дать SQL, который “выглядит похоже”, но по плану будет хуже. -
Очень сложные отчётные выборки
Когда запрос превращается в многоступенчатую аналитическую конструкцию, ORM может увеличить когнитивную нагрузку. Иногда проще и честнее оставить SQL, чем пытаться выразить его через построитель запросов. -
Сложные маппинги результатов
Например, запрос возвращает набор полей, который не ложится прямо на модель таблицы. Тогда raw SQL может быть проще, а ORM — потребует доп. слоёв (alias, column mapping, DTO).
“Компромиссная” стратегия: гибридный подход
Хорошая практика для перехода — не “всё ORM”, а “всё там, где это даёт пользу”.
- Используйте SQLModel для схемы, валидации, базовых CRUD и большинства транзакционных операций.
- Для действительно тяжёлых запросов оставляйте raw SQL (или SQLAlchemy Core), но:
- контролируйте параметры безопасно (bind parameters);
- документируйте, почему именно этот запрос не перевели в ORM;
- сохраняйте тесты и/или план выполнения (на уровне подхода, не магии).
Если вы решаете оставить raw SQL в одном месте, это не провал перехода — это инженерное решение.
Переход шаг за шагом: так обычно делают правильно
Шаг 1. Выделите “границы” функциональности
Начните с модулей, где:
- много одинаковой структуры объектов (таблицы/DTO);
- запросы типовые;
- доменная логика не завязана на специфичный SQL.
Где плохо начинать: отчётность со сложными CTE и хитрой аналитикой — лучше позже.
Шаг 2. Сначала модели и миграции, потом запросы
Если вы начнёте переписывать запросы раньше, чем привести схему и миграции в порядок, получите двойную нестабильность:
- запросы могут быть неактуальны относительно БД;
- миграции ещё не поддерживают новые constraints.
Начните с “вертикали схемы”: модели → миграции → запуск на staging → проверки.
Шаг 3. Контроль N+1 и количества запросов
Соберите список API-эндпоинтов/сценариев, которые читают отношения. Для каждого:
- решите, какие поля реально нужны;
- выберите стратегию загрузки (и проверьте запросы в логах).
Не пытайтесь “починить потом”, N+1 обычно сначала незаметен, а потом становится дорогим.
Шаг 4. Для сложных запросов сделайте осознанный выбор
Не превращайте “переход” в соревнование: кто перепишет быстрее. Если конкретный запрос — кандидат на raw SQL, то:
- оставьте его raw;
- используйте SQLModel там, где это приносит регулярную пользу.
Типичные ошибки при переходе на SQLModel
1) Путаница между Pydantic-валидацией и DB-constraints
Да, SQLModel опирается на Pydantic и может валидировать поля. Но:
- это не заменяет constraint’ы в БД;
- это не гарантирует целостность при конкурентных изменениях;
- это не заменяет транзакционные правила.
Ошибка: считать, что “раз модель валидирует — значит данные в БД валидны”. На практике нет.
2) Неучёт стратегии загрузки отношений
Ошибка: “отношения сами подтянутся”. Итог — N+1.
Правило: когда отношения нужны — проектируйте загрузку.
3) Миграции не соответствуют моделям
Ошибка: модель меняется, а миграции — “потом”. Потом часто превращается в инциденты.
Правило: схема — миграции, модели — описание.
4) Непонимание того, какой SQL реально выполняется
ORM — это генератор. Он полезен, но может:
- добавлять лишние JOIN’ы;
- влиять на порядок условий;
- менять форму SQL для агрегатов.
Без проверки вы можете получить ухудшение производительности, даже не заметив.
Правила выбора: когда SQLModel — лучший, а когда raw SQL осознаннее
SQLModel часто лучший выбор, если…
- вам важны схемы “в одном месте”: модели + валидация + ограничения;
- вы хотите уменьшить объём кода в репозиториях;
- большая часть запросов — транзакционные и типовые (CRUD, выборки, простые JOIN);
- у команды есть дисциплина по миграциям и ревью SQL/запросов.
raw SQL (или SQLAlchemy Core) часто разумнее, если…
- запрос завязан на конкретные фичи СУБД или сложные аналитические конструкции;
- вы тщательно оптимизируете план выполнения;
- результат не ложится в ORM-модели (или маппинг становится сложнее самого SQL);
- вы уже достигли стабильной производительности и миграция в ORM принесёт больше риска, чем выгоды.
Практический вывод: как думать о переходе, а не просто “заменить библиотеку”
Переход с raw SQL на SQLModel — это не про библиотеку ради библиотеки. Это про распределение ответственности:
- SQLModel помогает собрать доменную модель и схему ближе друг к другу.
- Миграции и стратегия запросов всё равно требуют инженерной дисциплины.
- ORM ускоряет разработку для типичных задач, но сложные запросы не исчезают — просто их иногда проще оставлять SQL’ом, а не пытаться “приручить” их построителем ORM.
Если хотите разлож