Курс по Rust без страха: как мыслить через типы и состояния
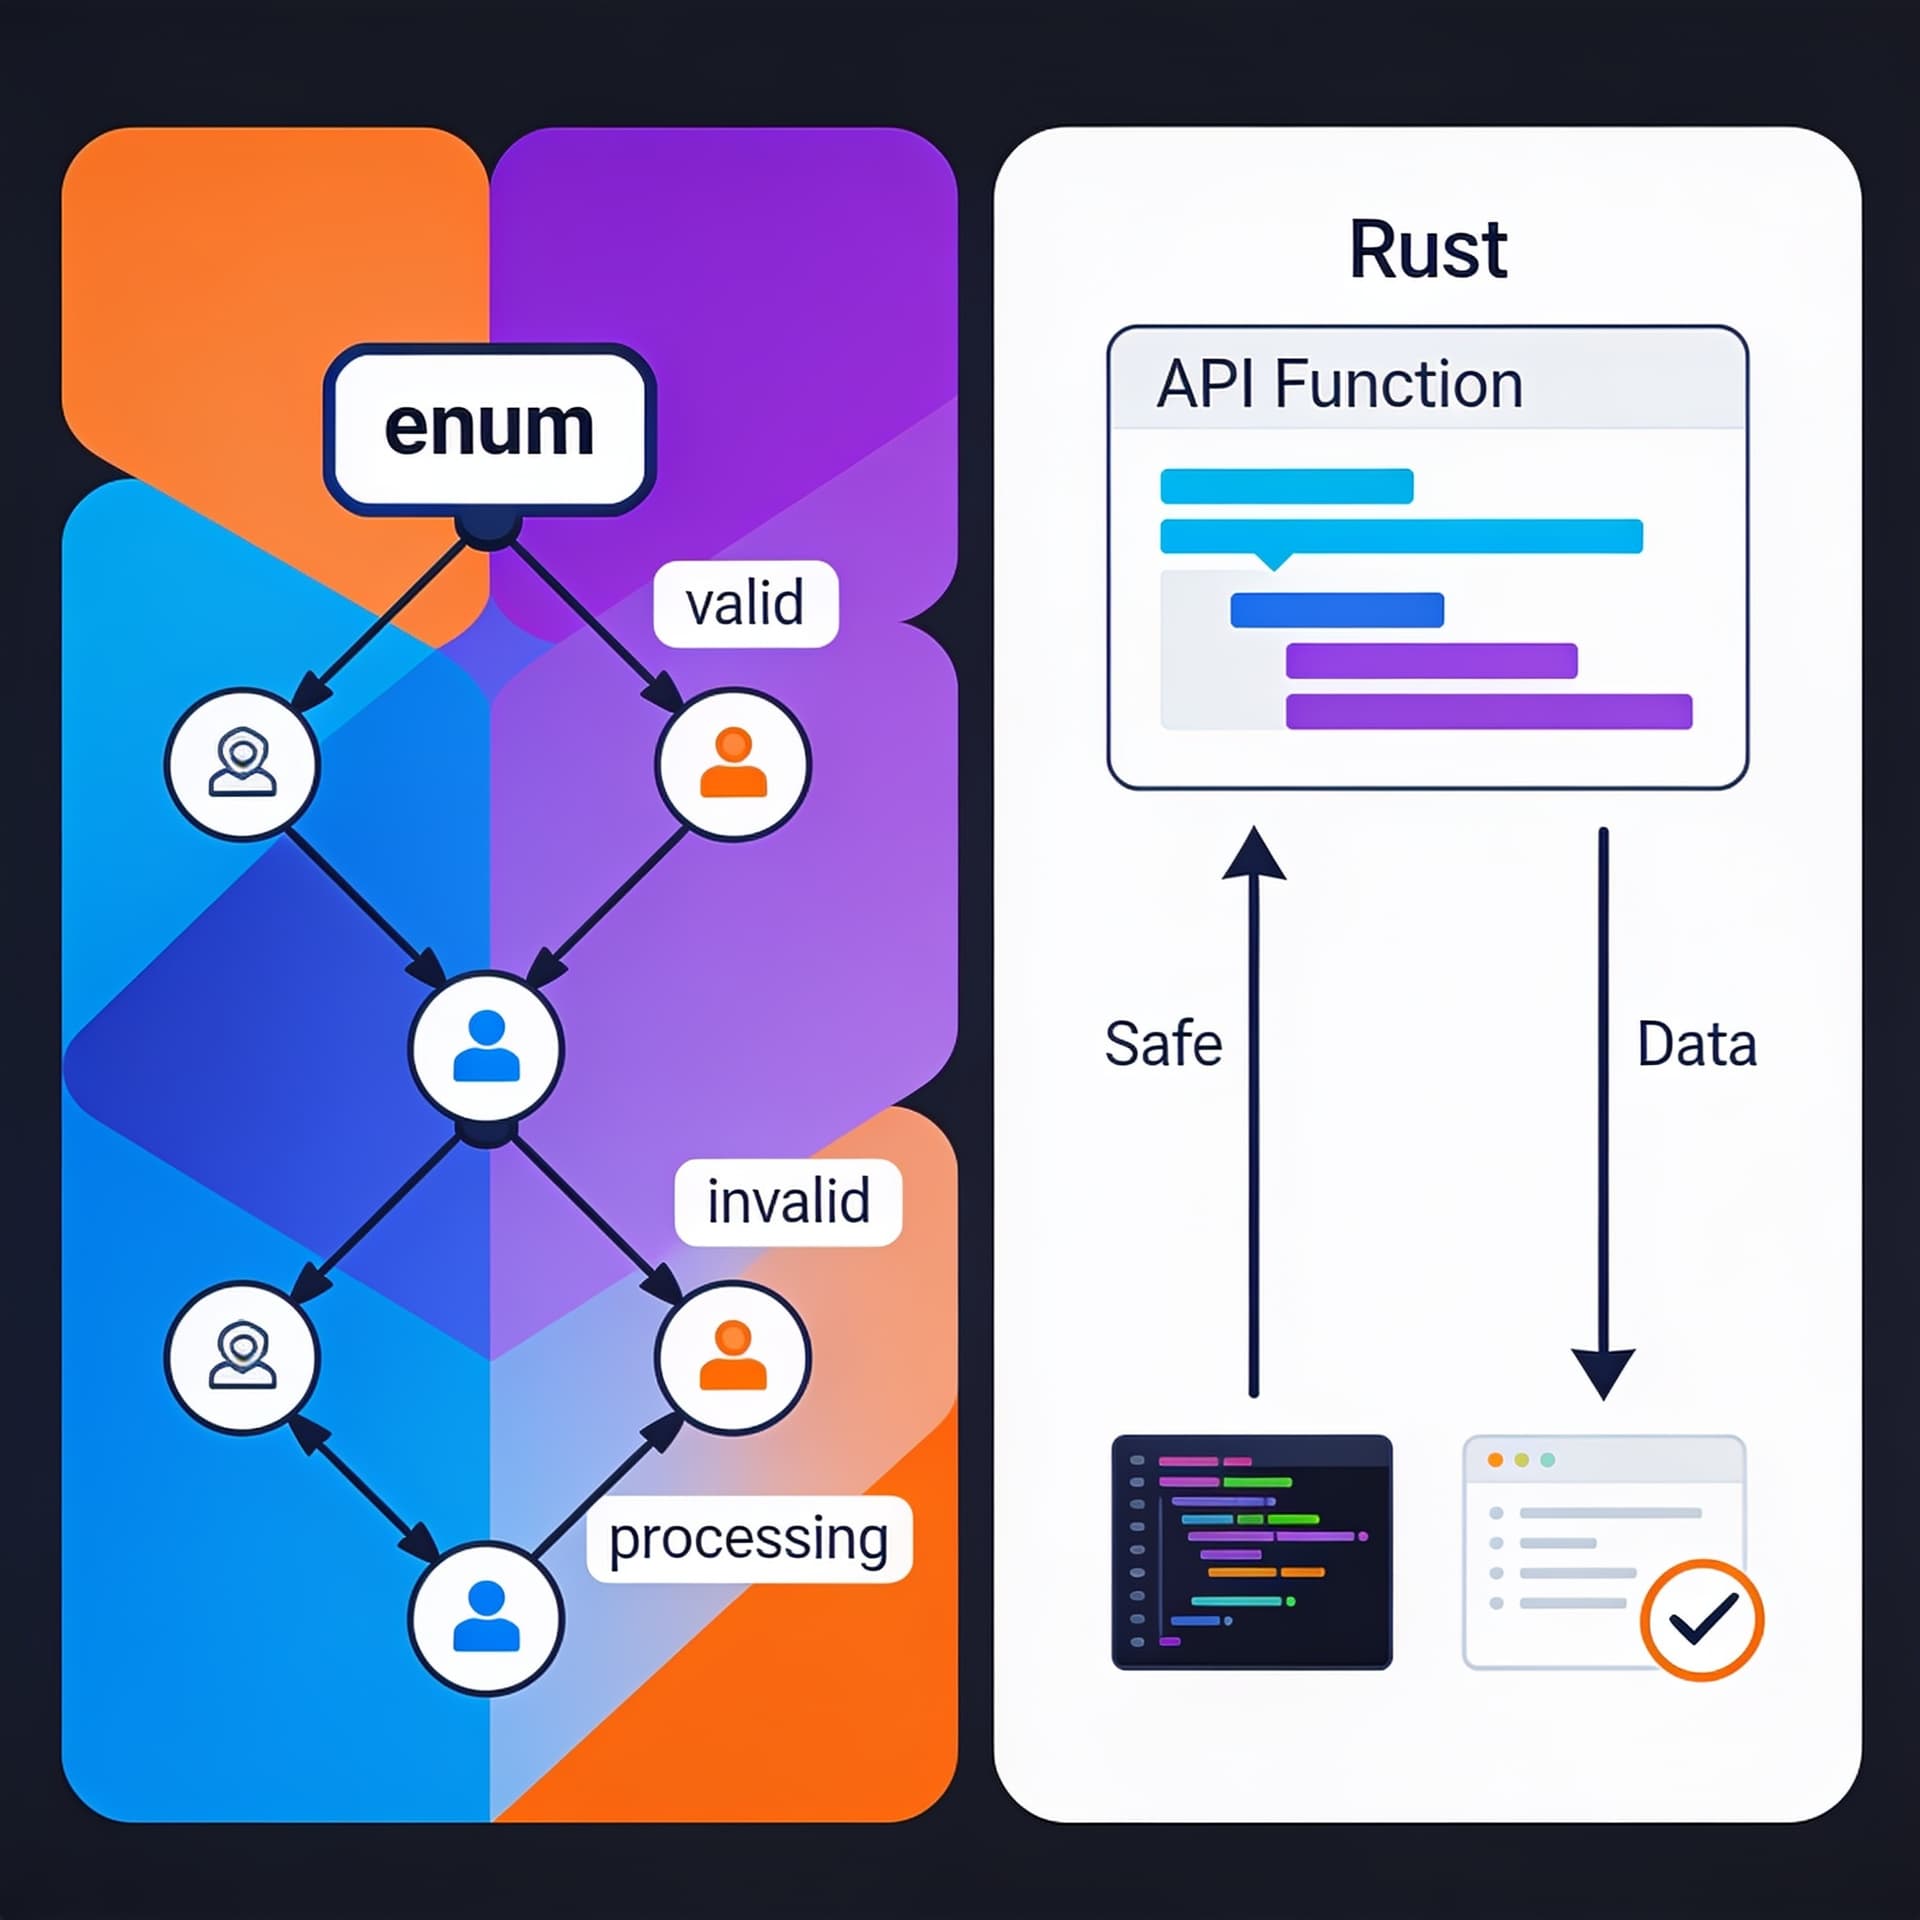
Покажем, как заменять “валидируй в runtime” на типобезопасность: enum-состояния, запрет некорректных переходов и проектирование API функций. Дадим мини-проект, который демонстрирует пользу подхода.
Содержание
Одна из самых частых причин, по которой Rust кажется «страшным», — не синтаксис и даже не заимствования. Страх рождается из старой привычки: «сначала напишу как получится, а потом проверю в runtime». В экосистеме Rust такой стиль обычно приводит к лишней валидации, хрупким веткам кода и багам, которые обнаруживаются слишком поздно — уже в проде.
Хорошая новость: Rust отлично подходит для безопасного проектирования. Его можно использовать так, чтобы некорректные состояния вообще не существовали. Для этого нужно поменять мышление: перейти от «проверим при выполнении» к «запретим неправильные переходы на уровне типов».
В этой статье разберём практический подход: моделирование состояний через enum, проектирование API-функций так, чтобы они принимали только корректные типы, и минимизация проверок в runtime за счёт типобезопасности. В конце соберём мини-проект, который демонстрирует, как это выглядит в реальном коде.
Небольшая ремарка по обучению: если хотите системно укрепить навыки, можно посмотреть курс Rust — он полезен как методичное продолжение после чтения этой статьи и для закрепления на практике.
Почему «валидируй в runtime» — плохая стратегия в системном коде
Что именно означает “валидировать в runtime”
Обычно это выглядит так:
- у нас есть структура данных (например,
Session,Order,FileTransfer); - в runtime мы проверяем её поля на корректность;
- функции пытаются «дожить» до успеха и возвращают ошибки при невалидных данных.
К примеру (упрощённый пример):
struct Order {
    state: String,
    paid: bool,
}

impl Order {
    fn ship(&mut self) -> Result<(), String> {
        if self.state != "Paid" || !self.paid {
            return Err("Cannot ship unpaid order".into());
        }
        self.state = "Shipped".into();
        Ok(())
    }
}
Код компилируется, но корректность зависит от строк, флагов и дисциплины программиста. У таких решений есть минусы:
- Неполнота проверок. Проверили в
ship(), но забыли в другом месте. - Сложность инвариантов. Инварианты расползаются по разным методам.
- Ложная уверенность. Ошибки логики проявляются только при определённых входах.
- Сложнее рефакторинг. Изменение модели требует обновлять проверки во многих местах.
Как Rust помогает “перенести” ошибки в компиляцию
Rust сильнее всего в одном: он позволяет описать ограничения так, чтобы компилятор помогал их соблюдать.
Если у вас есть конечный автомат (состояния + допустимые переходы), это естественно моделировать:
- состояниями — через
enumили отдельные типы; - переходами — через методы/функции, которые доступны только в определённых состояниях;
- “невозможные” переходы — не реализуются вообще (и не компилируются).
Смысл в том, чтобы состояние стало частью типа, а значит, компилятор сможет отследить корректность ваших сценариев.
Состояния как типы: enum и строгое проектирование переходов
Модель “состояние = enum” и запрет некорректных переходов
Пусть у нас есть процесс покупки: Created -> Paid -> Shipped. На уровне логики это конечный автомат. Типобезопасный подход:
Orderхранит только одинstate, ноstateпредставленenum;- переходы реализуются через методы, которые возвращают новый
Orderв целевом состоянии; - вы не даёте пользователю “ручками” создать
Orderв произвольном состоянии.
Пример:
#[derive(Debug, Clone)]
pub struct Order {
    id: u64,
    state: OrderState,
}

#[derive(Debug, Clone)]
pub enum OrderState {
    Created,
    Paid,
    Shipped,
}
Пока вы так сделаете, это всё ещё может разрешать некорректные переходы — если методы позволяют поменять состояние на что угодно. Значит, нужно проектировать API.
API-функции как “разрешённые переходы”
Обычно переход — это операция, которая:
- принимает “источник” состояния,
- возвращает “целевое” состояние,
- при необходимости — добавляет данные (например,
paid_at,shipment_id).
Вариант A: один тип Order и enum внутри, но переходы проверяются match-ветками.
Вариант B (часто более строгий): разделить состояние на типы. Для учебного текста нам подойдёт вариант B — он лучше показывает, как “запретить” некорректный переход на уровне типов, а не через Result.
Ниже реализуем вариант B.
Вариант с типами состояний: типобезопасный конечный автомат
Идея: Order<S> где S — маркер состояния
Создадим тип Order<S>, где S будет маркером состояния. Тогда функция pay() будет доступна только для Order<Created>, а ship() — только для Order<Paid>.
use std::marker::PhantomData;

#[derive(Debug)]
pub struct Order<S> {
    id: u64,
    total_cents: u64,
    state: PhantomData<S>,
}

#[derive(Debug)]
pub struct Created;
#[derive(Debug)]
pub struct Paid;
#[derive(Debug)]
pub struct Shipped;
Почему тут PhantomData? Он помогает компилятору “понимать”, что S часть типа, даже если в runtime данных о состоянии не хранится.
Переходы как методы “только на нужном типе”
Теперь методы:
impl Order<Created> {
    pub fn new(id: u64, total_cents: u64) -> Self {
        Self {
            id,
            total_cents,
            state: PhantomData,
        }
    }

    pub fn pay(self) -> Order<Paid> {
        Order {
            id: self.id,
            total_cents: self.total_cents,
            state: PhantomData,
        }
    }
}

impl Order<Paid> {
    pub fn ship(self) -> Order<Shipped> {
        Order {
            id: self.id,
            total_cents: self.total_cents,
            state: PhantomData,
        }
    }
}

impl Order<Shipped> {
    pub fn total(&self) -> u64 {
        self.total_cents
    }
}
Что важно: неверные переходы не требуют if и return Err. Они просто не компилируются.
Попытка сделать:
let created = Order::<Created>::new(1, 1000);
let shipped = created.ship(); // ошибка компиляции: нет метода ship для Order<Created>
Это и есть результат типобезопасного проектирования.
Но где же runtime-проверки?
Они остаются, но переходы, которые строго логически невозможны, не требуют проверок вообще. Runtime остаётся для реальных неопределённостей:
- внешние вызовы (например, платёжный провайдер вернул ошибку);
- ввод пользователя/файлы;
- время/сеть.
В таких случаях логично возвращать Result, но границы ответственности лучше строить так, чтобы “ошибки несоответствия состоянию” не всплывали в Result.
Как проектировать функции так, чтобы типы “вели” пользователя
Ошибка №1: сделать метод с параметром состояния вместо типобезопасного API
Например, вот так часто делают в начале:
pub fn ship(order: &mut Order) -> Result<(), String> { ... }
И внутри ищут order.state. Это превращает инварианты в “предположения автора”. В Rust лучше:
- принимать
Order<Paid>вместо&Order; - возвращать
Order<Shipped>.
Тогда корректность становится интерфейсом.
Ошибка №2: “универсальные” функции, которые принимают Order<S> без ограничений
Если вы пишете:
pub fn reset<S>(order: Order<S>) -> Order<Created> { ... }
Вы разрушаете смысл модели состояний. Такие “универсальные” функции могут быть допустимы (например, для админских операций), но тогда их нужно явно маркировать и делать сложнее использовать случайно.
Ошибка №3: публичный конструктор, который позволяет создать неправильное состояние
Если Order<S> имеет публичные поля или публичный конструктор, пользователь сможет собрать “невозможные” значения. Поэтому:
- поля держим приватными;
- конструкторы делаем только там, где состояние корректно.
Мини-проект: безопасный “воркфлоу” заказа и печать отчёта
Соберём небольшой пример, который похож на реальную разработку: есть заказ, его нужно создать, оплатить, отправить, а затем сформировать отчёт.
Требования к мини-проекту
- Нельзя отправить заказ до оплаты.
- Нельзя оплатить уже отправленный заказ.
- “Состояния” должны быть выражены типами.
- Нужно показать, как это упрощает код без runtime-валидации.
Код мини-проекта
1) Типы состояний и структура заказа
use std::marker::PhantomData;

#[derive(Debug)]
pub struct Order<S> {
    id: u64,
    items: Vec<String>,
    total_cents: u64,
    state: PhantomData<S>,
}

#[derive(Debug)]
pub struct Created;
#[derive(Debug)]
pub struct Paid {
    payment_id: String,
}
#[derive(Debug)]
pub struct Shipped {
    shipment_id: String,
}
Здесь отличие от простого маркерного struct. Мы используем данные внутри состояния: после оплаты — payment_id, после отправки — shipment_id.
2) Создание заказа
impl Order<Created> {
    pub fn new(id: u64, items: Vec<String>, total_cents: u64) -> Self {
        Self {
            id,
            items,
            total_cents,
            state: PhantomData,
        }
    }
}
3) Переход Created -> Paid
В реальной системе платеж может провалиться, поэтому будем моделировать как Result. Но заметим: “невозможный переход” (оплата заказа, который уже отправлен) не должен даже компилироваться.
#[derive(Debug)]
pub enum PaymentError {
    ProviderDown,
    Declined,
}

impl Order<Created> {
    pub fn pay(self, payment_id: String) -> Result<Order<Paid>, PaymentError> {
        // Здесь могли бы быть вызовы внешнего провайдера.
        // Для демонстрации допустим, что если payment_id пустой — ошибка.
        if payment_id.is_empty() {
            return Err(PaymentError::Declined);
        }

        Ok(Order {
            id: self.id,
            items: self.items,
            total_cents: self.total_cents,
            state: PhantomData::<Paid>,
        })
    }
}
Но Paid у нас с полем payment_id. Как тогда хранить его? Вариант выше не хранит данных из-за PhantomData. Значит, корректнее сделать state реально содержащим данные, а не PhantomData. Для краткости перепишем структуру.
Исправим модель:
#[derive(Debug)]
pub struct Order<S> {
    id: u64,
    items: Vec<String>,
    total_cents: u64,
    state: S,
}

#[derive(Debug)]
pub struct Created;

#[derive(Debug)]
pub struct Paid {
    payment_id: String,
}

#[derive(Debug)]
pub struct Shipped {
    shipment_id: String,
}
Теперь переходы будут содержать данные.
Создание:
impl Order<Created> {
    pub fn new(id: u64, items: Vec<String>, total_cents: u64) -> Self {
        Self {
            id,
            items,
            total_cents,
            state: Created,
        }
    }
}
Переход:
#[derive(Debug)]
pub enum PaymentError {
    Declined,
    ProviderDown,
}

impl Order<Created> {
    pub fn pay(self, payment_id: String) -> Result<Order<Paid>, PaymentError> {
        if payment_id.trim().is_empty() {
            return Err(PaymentError::Declined);
        }

        Ok(Order {
            id: self.id,
            items: self.items,
            total_cents: self.total_cents,
            state: Paid { payment_id },
        })
    }
}
4) Переход Paid -> Shipped
#[derive(Debug)]
pub enum ShipmentError {
    CarrierTimeout,
    AddressInvalid,
}

impl Order<Paid> {
    pub fn ship(self, shipment_id: String) -> Result<Order<Shipped>, ShipmentError> {
        if shipment_id.trim().is_empty() {
            return Err(ShipmentError::AddressInvalid);
        }

        Ok(Order {
            id: self.id,
            items: self.items,
            total_cents: self.total_cents,
            state: Shipped { shipment_id },
        })
    }
}
5) Отчёт только для Shipped
Предположим, отчёт можно сформировать только после отправки.
impl Order<Shipped> {
    pub fn report(&self) -> String {
        format!(
            "Order #{}: shipped={} items={} total_cents={}",
            self.id,
            self.state.shipment_id,
            self.items.len(),
            self.total_cents
        )
    }
}
6) Использование: корректный сценарий компилируется, неверный — нет
fn main() -> Result<(), Box<dyn std::error::Error>> {
    let order = Order::<Created>::new(
        42,
        vec!["Keyboard".into(), "Mouse".into()],
        19999,
    );

    // Корректный сценарий:
    let paid = order.pay("pay_abc123".to_string())?;
    let shipped = paid.ship("shp_999".to_string())?;

    println!("{}", shipped.report());

    // Неверный сценарий (не компилируется):
    // let shipped2 = order.ship("shp_x".into())?;

    Ok(())
}
Что мы выиграли
- Инвариант “состояние соответствует фазе” обеспечивается компилятором.
- Проверки на несоответствие фаз исчезают из
runtime-ветвления. - API становится самодокументируемым. Сигнатуры функций показывают допустимые операции.
- Ошибки бизнес-логики превращаются в ошибки компиляции.
Когда enum лучше, чем типы состояний
Тема обычно уводит в сторону: “раз типы — значит всегда типы”. Нет. Есть важный практический момент.
Enum-состояния часто удобны, когда объект живёт “в одном экземпляре” и меняет состояние
Например, у вас есть структура, которую нужно держать в коллекции Vec<Order>, и её состояние меняется во времени. Тогда Order { state: OrderState } проще для хранения, сериализации и работы с единым интерфейсом.
Но типобезопасность всё равно можно повысить:
- сделать
OrderStateприватным; - обеспечить единственные переходы через методы;
- не давать пользователю конструировать “сломанные” комбинации.
Если вам важнее хранение/десериализация/единая структура, используйте enum. Если важнее строгость переходов и гарантии на этапе компиляции — типы состояний.
Подводные камни: как не испортить пользу типобезопасности
Слишком сложные generics и “типовое многословие”
Типы состояний могут разрастаться: Order<...> начинает иметь длинные параметры, появляются where-ограничения и читаемость падает.
Решения:
- используйте маркеры простых состояний;
- делайте публичный API на уровнях выше (например, методы
pay_and_ship()), оставляя детализацию внутри; - группируйте повторяющееся через трейты или приватные функции.
Сериализация/десериализация
При Order<S> возникает вопрос: как сериализовать S? На практике часто нужен мост:
- либо сериализуем “плоскую” модель (
OrderDTOсenum), - либо используем
serdeтак, чтобы данные состояния тоже сериализовались.
Если сериализация — критичная часть, иногда выгоднее enum внутри, а типобезопасность поддерживать через переходы/конструкторы.
Обобщённые функции “состояние произвольное”
Если где-то вы пишете функцию, которая должна работать с любым Order<S>, вы неизбежно возвращаетесь к “валидируем в runtime” или к тому, что некоторые операции недоступны. Но это не ошибка подхода, а естественное следствие строгого API.
Например, “печать суммы” может быть доступна для всех состояний:
impl<S> Order<S> {
    pub fn total_cents(&self) -> u64 {
        self.total_cents
    }
}
А “ship/report” — только для нужных состояний.
Какой подход выбрать: чеклист практичности
-
Есть ли у вас чёткий конечный автомат?
Тогда моделирование через типы состояний илиenumпочти всегда оправдано. -
Нужны ли “данные” внутри состояния?
Если да — типы состояний особенно хороши (какPaid { payment_id }иShipped { shipment_id }). -
Состояние часто хранится/передаётся как единое значение?
Тогдаenumможет быть практичнее из-за сериализации и удобства контейнеров. -
Насколько критичны запрет некорректных переходов?
Если это центральный