Rust: как устроить ошибки в приложении — Result, thiserror и человекочитаемые сообщения
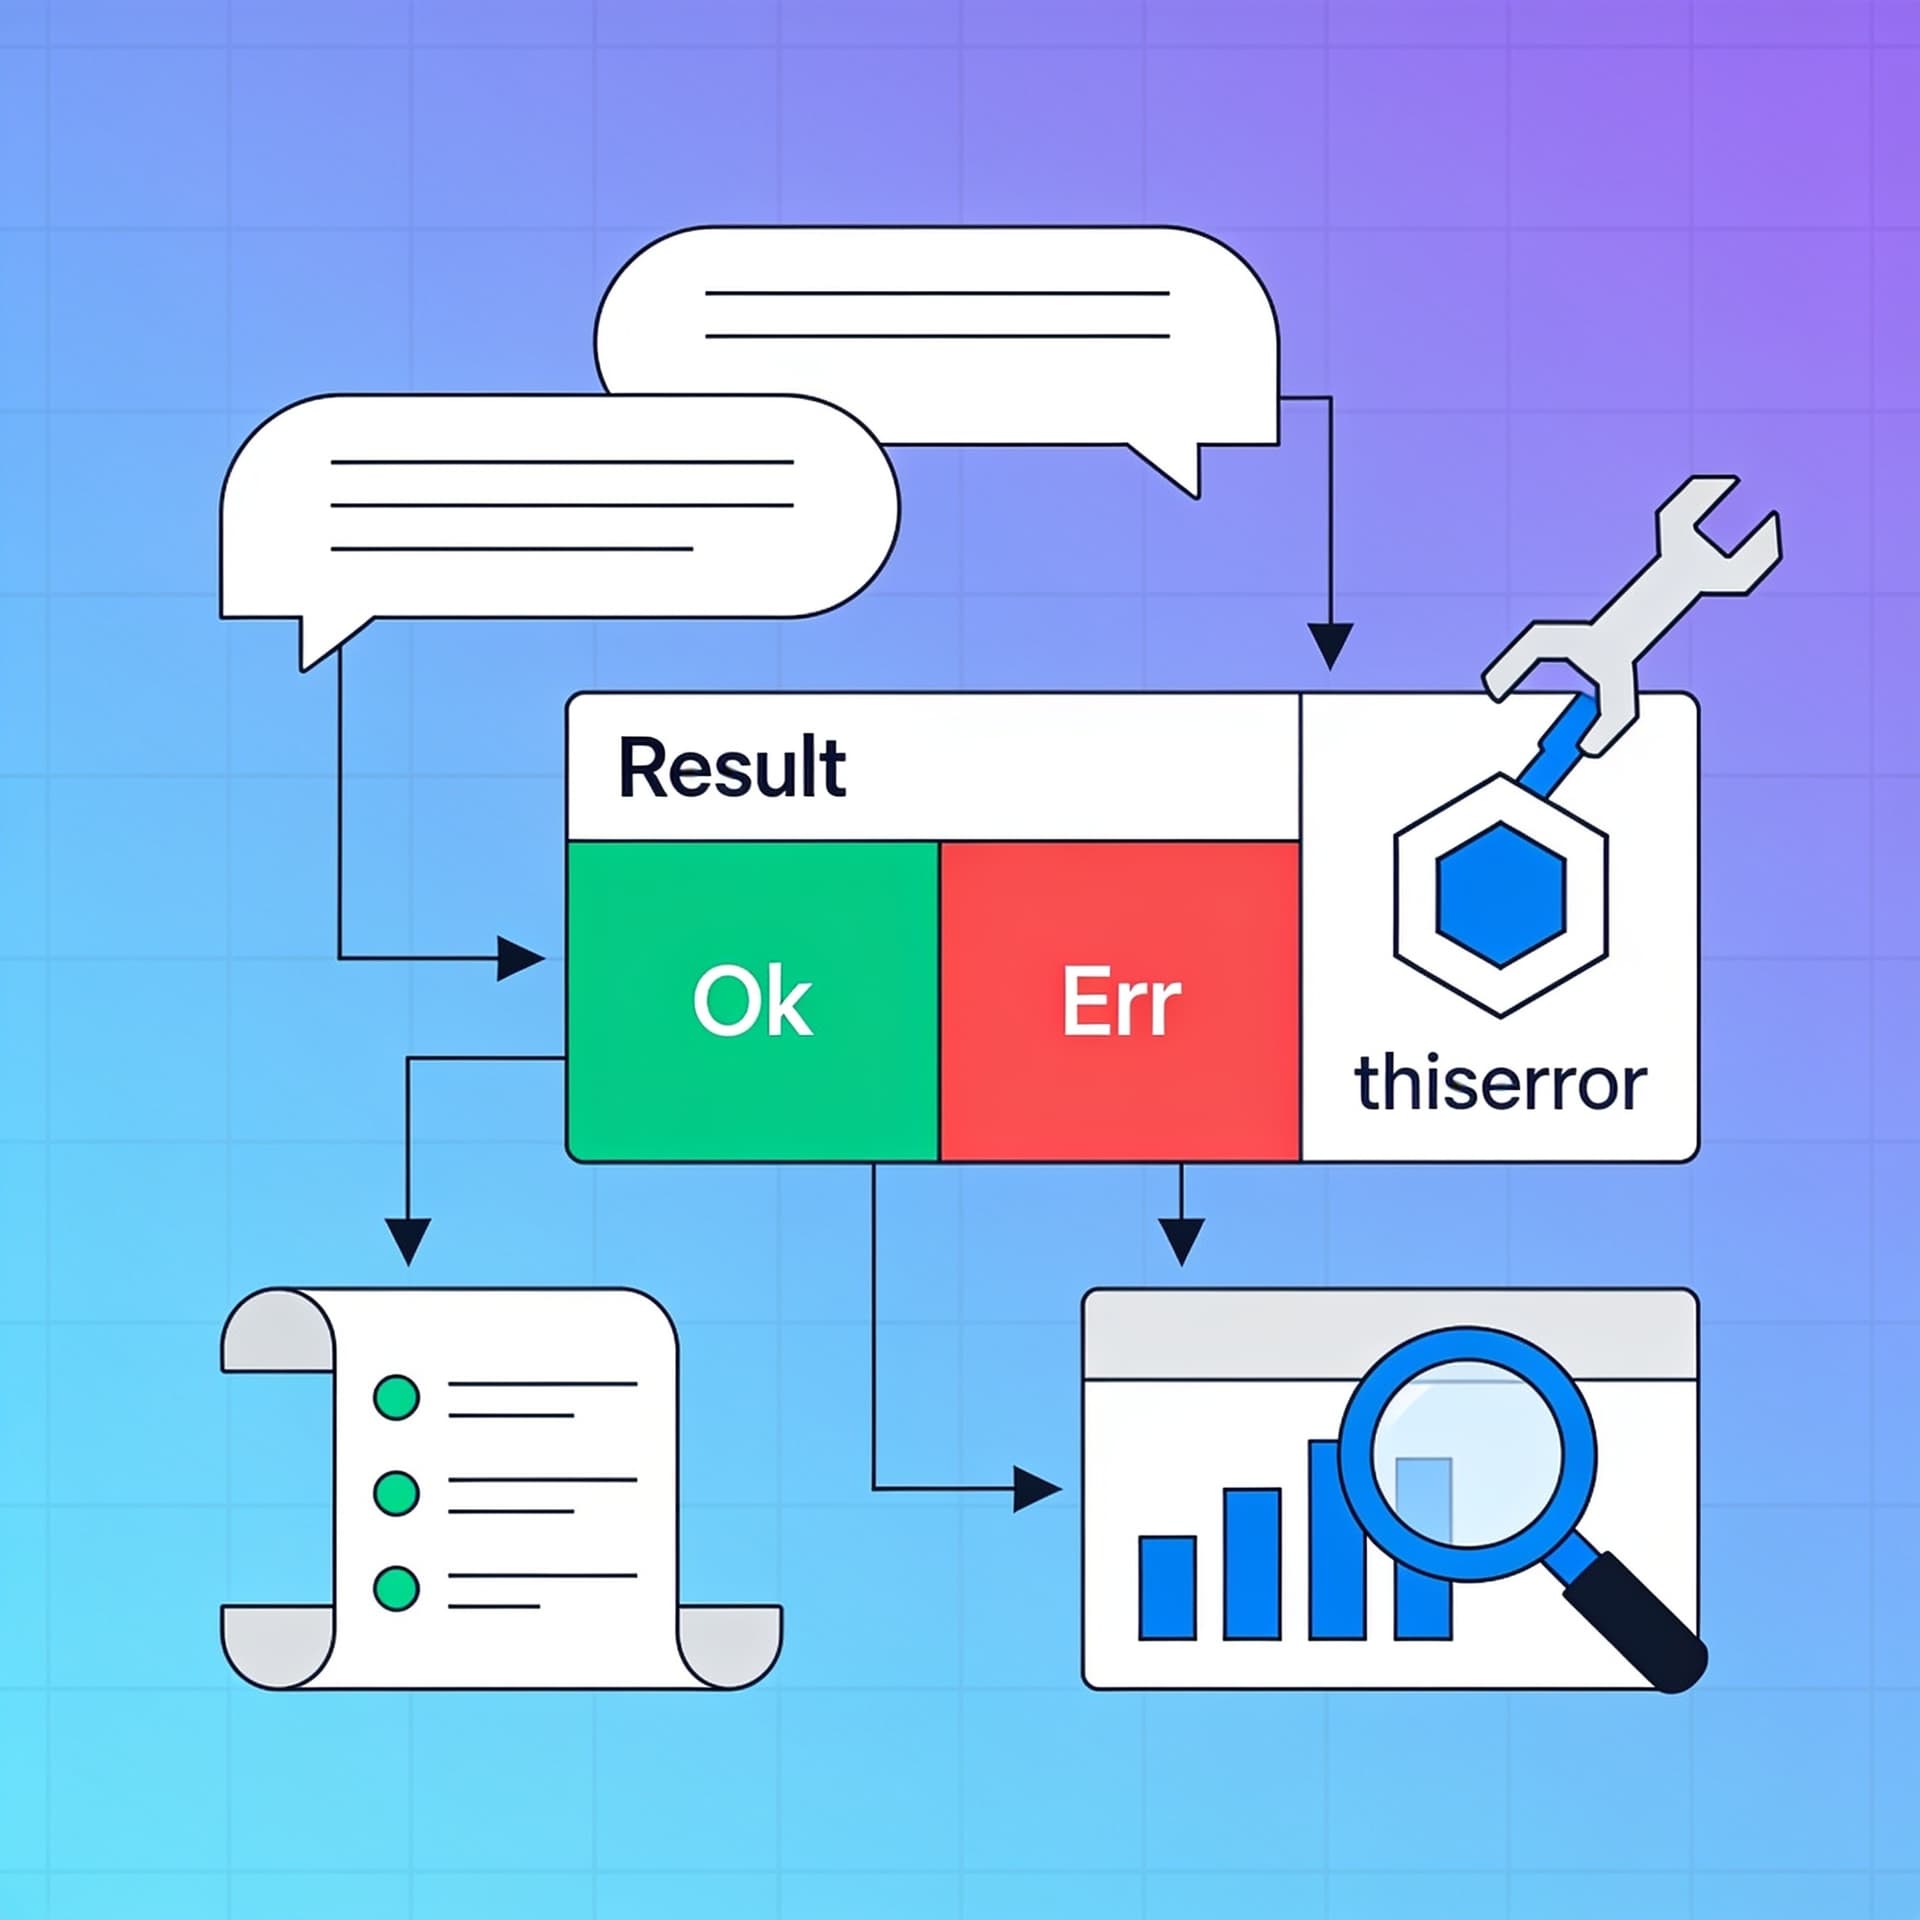
Разберём, как правильно проектировать типы ошибок, чтобы их можно было логировать, отображать и пробрасывать вверх без потери контекста. Поднимем качество диагностики для реальных проектов.
Содержание
В зрелом Rust‑проекте ошибки — это не «неудачное состояние», которое нужно поскорее обработать, а полноценная часть интерфейса: ими обмениваются слои приложения, они логируются с контекстом, превращаются в сообщения для пользователя и при необходимости пробрасываются наверх так, чтобы причины не терялись. Когда структура ошибок продумана заранее, диагностика становится предсказуемой, поддержка — быстрее, а дебаг — спокойнее.
В этой статье разберём, как проектировать типы ошибок в Rust с опорой на Result, thiserror и техники, которые помогают получать и машинно‑читаемую, и человекочитаемую информацию — без «потери контекста» при пробросе.
Почему ошибки требуют архитектуры
Большинство новичков строит обработку ошибок так:
- возвращаем
Result<T, Box<dyn Error>>или простоanyhow::Error; - в верхнем слое — печатаем сообщение.
Иногда это работает, но в реальных системах быстро проявляются проблемы:
- Невозможность различать ошибки по типам. Если всё превращено в
Box<dyn Error>, верхний слой хуже понимает, что именно случилось (например, это «невалидный запрос» или «внутренняя ошибка»). - Потеря контекста. Сообщения часто «схлопываются» до одного предложения. Вы уже не видите: что именно было входом, какой ресурс пытались открыть, на каком этапе случилось.
- Путаница между логами и пользовательским текстом. Один и тот же
Displayначинают использовать и для логирования, и для UI. В результате логи становятся нечёткими, а пользователю показывается технический мусор. - Сложность поддержки. Когда в коде десятки мест с
map_err(|e| format!("...: {}", e)), изменения превращаются в хаос.
Хорошая архитектура ошибок отвечает на три вопроса:
- Как классифицировать ошибки (чтобы принимать решения по типам)?
- Как сохранять и накапливать контекст при пробросе?
- Как получить разные представления ошибки: для логов, для ответов API и для пользователя?
Базовая модель: Result<T, E> и разделение ответственности
Правило 1: ошибки — часть доменной модели
Rust поощряет явные типы ошибок. Даже если в итоге вы возвращаете ошибку «наружу» как AppError, внутри лучше сохранять структуру причин.
Например, сервис может различать:
- ошибки валидации запроса (400);
- отсутствие ресурса (404);
- ошибки внешних интеграций (502/503);
- внутренние ошибки (500).
Если тип ошибок «слишком общий», у вас нет надёжного способа выбрать HTTP‑статус или сообщение.
Правило 2: Display — для человека, Debug — для диагностики
По умолчанию:
Debugчасто содержит детали и полезен для логов.Display— текст, пригодный для пользователя или краткого сообщения.
Но на практике это нужно договориться внутри проекта: что именно вы считаете «человеческим» текстом, а что — «техническими деталями».
thiserror: простой и выразительный способ объявить ошибки
Пакет thiserror даёт удобную деривацию Error и позволяет аккуратно:
- объявить разные варианты ошибки (enum);
- указать формат
Display; - автоматом реализовать
source()для цепочки причин (что важно для сохранения контекста).
Минимальный пример
Допустим, у нас есть функция чтения конфигурации:
use thiserror::Error;

#[derive(Debug, Error)]
pub enum ConfigError {
    #[error("файл конфигурации не найден: {0}")]
    NotFound(String),

    #[error("не удалось распарсить конфигурацию: {0}")]
    Parse(#[from] serde_json::Error),

    #[error("неизвестная ошибка конфигурации")]
    Unknown,
}
Здесь:
Parse(#[from] serde_json::Error)делает возможным автоматический?внутрьserde_json::Error.#[error(...)]формируетDisplay‑сообщение.Debugостаётся информативным, аDisplayможно использовать для ответа наружу.
Чего не хватает в реальном приложении
В реальном проекте вы почти всегда хотите:
- накапливать контекст («какой файл/URL/параметр»);
- пробрасывать первопричину (чтобы можно было восстановить цепочку);
- иметь разные форматы для логов и пользовательских ответов.
thiserror закрывает большую часть, но вам нужно правильно выбрать границы уровней и то, какие данные хранить в ошибках.
Проектирование иерархии ошибок: слой за слоем
Одна из самых практичных стратегий — создать «ошибку на слой» и при необходимости «ошибку на приложение».
Например:
RepositoryError— ошибки доступа к данным (БД, файлы, сеть).ServiceError— ошибки бизнес‑логики, в которые заворачиваютсяRepositoryErrorи другие причины.AppError— ошибки, которые возвращаются наружу (API/CLI).
Наличие этих уровней не означает, что нужно всегда добавлять новые enum. Но это полезно, когда нужно:
- различать типы ошибок для маршрутизации (например, статусы HTTP);
- скрывать внутренние детали пользователю, но не скрывать их для логов.
Накопление контекста: как не терять причину
Контекст обычно добавляют при оборачивании ошибки на каждом уровне. Важно:
- не заменять первопричину на новый текст;
- не «пересобирать строку», а сохранять цепочку причин;
- хранить структурированные поля (например,
path,user_id,operation), а не только текст.
thiserror поддерживает это через хранение исходной ошибки как поля и использование source.
Пример: обёртка с контекстом
Допустим, репозиторий читает файл. Ошибка должна содержать путь:
use std::path::PathBuf;
use thiserror::Error;

#[derive(Debug, Error)]
pub enum RepositoryError {
    #[error("не удалось прочитать файл {path}")]
    ReadFile {
        path: PathBuf,
        #[source]
        source: std::io::Error,
    },

    #[error("не удалось обработать файл {path}: {reason}")]
    ProcessFile {
        path: PathBuf,
        reason: String,
    },
}
Здесь:
ReadFileхранит иpath, и оригинальнуюstd::io::Errorкакsource.- Логирование может показать и текст
Display, и исходную причину, которую удобно искать.
Использование:
pub fn read_config(path: PathBuf) -> Result<String, RepositoryError> {
    let data = std::fs::read_to_string(&path).map_err(|e| RepositoryError::ReadFile {
        path,
        source: e,
    })?;

    Ok(data)
}
Да, выше мы используем map_err, но в реальных проектах часто применяют небольшие helper‑функции или macro‑обёртки, чтобы не размножать шаблоны. Главное — принцип: «контекст + источник».
Умение «пробросить наверх без потери контекста»
Проброс — это не просто ?. Это ещё и правильная схема: как нижний слой сообщает верхнему, что именно случилось и почему.
Классический приём в Rust:
- верхний enum содержит нижний как поле
source; - для некоторых вариантов можно использовать
#[from], чтобы?автоматически конвертировал ошибки.
Пример: репозиторий → сервис → приложение
use thiserror::Error;

#[derive(Debug, Error)]
pub enum ServiceError {
    #[error("ошибка доступа к данным: {0}")]
    Repository(#[from] RepositoryError),

    #[error("некорректное состояние сервиса: {0}")]
    InvalidState(String),
}

#[derive(Debug, Error)]
pub enum AppError {
    #[error("операция не удалась: {0}")]
    Service(#[from] ServiceError),
}
На практике обычно не нужно делать AppError отдельным слоем, если сервисный enum уже подходит для верхнего уровня. Но в API‑проектах отдельный AppError часто удобен: он связывается с транспортом (HTTP/гRPC), а внутренние enum не обязаны «знать» про протокол.
Ключевое: используйте #[from] там, где это действительно конверсия уровня ошибок. А там, где нужна добавка контекста (например, параметры операции), лучше конструировать variant вручную, добавляя source.
Человекочитаемые сообщения: не путайте лог и ответ пользователю
Проблема одного Display
thiserror даёт один Display. Если вы используете его и для логов, и для HTTP‑ответов, через неделю получите:
- логи без достаточного контекста (или слишком длинные);
- ответы пользователю с внутренними деталями;
- невозможность поддержать «локализацию» сообщений без рефакторинга.
Решение: отдельная функция/поле для «user message»
Один из распространённых подходов: хранить ошибки структурно и дополнительно реализовать метод:
fn user_message(&self) -> Cow<'static, str>или простоString;- либо
fn status_code(&self) -> StatusCode(если это HTTP).
Пример для API:
use axum::http::StatusCode;
use std::borrow::Cow;

#[derive(Debug, thiserror::Error)]
pub enum AppError {
    #[error(transparent)]
    Service(#[from] ServiceError),

    #[error("ресурс не найден")]
    NotFound,
}

impl AppError {
    pub fn status_code(&self) -> StatusCode {
        match self {
            AppError::NotFound => StatusCode::NOT_FOUND,
            AppError::Service(_) => StatusCode::INTERNAL_SERVER_ERROR,
        }
    }

    pub fn user_message(&self) -> Cow<'static, str> {
        match self {
            AppError::NotFound => Cow::Borrowed("Ресурс не найден"),
            AppError::Service(_) => Cow::Borrowed("Внутренняя ошибка"),
        }
    }
}
Важно: Display остаётся для диагностики (часто для логов), а пользовательский текст — для UI/клиента.
Если у вас CLI, «пользовательское» сообщение тоже нужно: оно отличается от инженерного текста (который обычно уходит в лог).
Логирование: как добиться полезного вывода
Почему важна цепочка source
Когда ошибка содержит source (а thiserror это обеспечивает), стандартные средства логирования могут печатать цепочку причин. Это помогает быстро выяснить «где именно» случилось.
Например, в tracing вы можете логировать ошибку и её причину автоматически. Важно, чтобы ошибки были Debug + Error (как делает thiserror::Error).
Точка логирования: один раз или много?
Типичная ошибка архитектуры — логировать на каждом слое. Это:
- порождает дублирование;
- может «перезатереть» полезный контекст;
- усложняет поиск первопричины.
Практика, которая обычно хорошо работает:
- на нижних уровнях — не логируйте (или логируйте только если иначе вы теряете контекст);
- на верхнем обработчике запроса — логируйте один раз, включая
errorиcontext.
Тогда лог представляет собой итоговую ошибку приложения, но содержит всю цепочку причин через source.
Типизация ошибок и принятие решений: маппинг в статусы/коды
Если вы пишете API, вам почти неизбежно нужен маппинг «ошибка → транспортное представление».
Обычно это делается функцией на верхнем уровне:
status_code()to_response()/to_body()
Пример: более детальный маппинг
Представим ServiceError может отражать «валидацию», «отсутствие», «внешнюю ошибку».
use axum::http::StatusCode;
use thiserror::Error;

#[derive(Debug, Error)]
pub enum ServiceError {
    #[error("некорректный запрос: {details}")]
    Validation { details: String },

    #[error("объект не найден: {id}")]
    NotFound { id: String },

    #[error("ошибка внешней системы")]
    Upstream(#[source] anyhow::Error),
}
Дальше:
#[derive(Debug, Error)]
pub enum AppError {
    #[error(transparent)]
    Service(#[from] ServiceError),
}

impl AppError {
    pub fn status_code(&self) -> StatusCode {
        match self {
            AppError::Service(ServiceError::Validation { .. }) => StatusCode::BAD_REQUEST,
            AppError::Service(ServiceError::NotFound { .. }) => StatusCode::NOT_FOUND,
            AppError::Service(ServiceError::Upstream { .. }) => StatusCode::BAD_GATEWAY,
        }
    }

    pub fn user_message(&self) -> &'static str {
        match self {
            AppError::Service(ServiceError::Validation { .. }) => "Некорректные данные",
            AppError::Service(ServiceError::NotFound { .. }) => "Ресурс не найден",
            AppError::Service(ServiceError::Upstream { .. }) => "Ошибка внешнего сервиса",
        }
    }
}
Заметьте: мы используем структуру ошибок (enum‑варианты) для принятия решений. Это кардинально лучше, чем разбирать строки текста.
Частые ошибки при проектировании ошибок в Rust
1) «Лёгкая» ошибка вместо типизированной
Использование anyhow::Error или Box<dyn Error> на всех уровнях иногда оправдано на прототипах, но в приложении обычно наступает момент, когда:
- нужно маппить ошибки на разные ответы;
- нужно отличать retryable и non‑retryable;
- нужно разные категории логировать отдельно.
Типизированные ошибки решают это системно. Это не означает, что anyhow нельзя, но нужно понимать границы: где вы теряете типизацию.
2) Переписывание первопричины строкой
Антипример:
.map_err(|e| RepositoryError::ReadFile {
    path,
    source: std::io::Error::new(std::io::ErrorKind::Other, format!("{e}")),
})?;
Вы «заменяете» оригинальную ошибку новой, грубо конструируя смысл из строки. Лучше сохранить оригинал как source.
Правильно:
.map_err(|e| RepositoryError::ReadFile { path, source: e })?;
3) Дублирование логов и чрезмерное количество уровней
Слишком частая практика: каждый модуль логирует, потом верхний слой тоже логирует — в итоге вы видите один и тот же инцидент десятками строк. Иногда лучше:
- логировать только на границе входа (HTTP handler, main, background worker);
- а на внутренних слоях оставлять контекст через структуру ошибки.
4) Смешивание пользовательского текста и инженерного Display
Если Display содержит технические детали ("failed to decode UTF-8 at byte 123"), показ пользователю почти всегда будет выглядеть плохо. Отдельный метод user_message() (или DTO‑ответ) решает это.
Практический каркас: «скелет» типизированных ошибок
Ниже — компактный, но достаточно полный шаблон, который можно адаптировать под проект.
1) Ошибки репозитория (структурные варианты + source)
use thiserror::Error;
use std::path::PathBuf;

#[derive(Debug, Error)]
pub enum RepositoryError {
    #[error("файл не найден: {path}")]
    NotFound { path: PathBuf },

    #[error("не удалось прочитать файл {path}")]
    ReadFile {
        path: PathBuf,
        #[source]
        source: std::io::Error,
    },
}
2) Ошибки сервиса (бизнес‑смысл + конверсия)
use thiserror::Error;

#[derive(Debug, Error)]
pub enum ServiceError {
    #[error("ошибка репозитория: {0}")]
    Repository(#[from] RepositoryError),

    #[error("обработка конфигурации невозможна: {0}")]
    InvalidConfig(String),
}
3) Ошибки приложения (транспортная интеграция + user message)
use axum::http::StatusCode;
use thiserror::Error;

#[derive(Debug, Error)]
pub enum AppError {
    #[error(transparent)]
    Service(#[from] ServiceError),
}

impl AppError {
    pub fn status_code(&self) -> StatusCode {
        match self {
            // Пример: маппинг по цепочке причин
            AppError::Service(ServiceError::Repository(
                RepositoryError::NotFound { .. }
            )) => StatusCode::NOT_FOUND,

            AppError::Service(ServiceError::InvalidConfig { .. }) => StatusCode::BAD_REQUEST,

            AppError::Service(_) => StatusCode::INTERNAL_SERVER_ERROR,
        }
    }

    pub fn user_message(&self) -> &'static str {
        match self {
            AppError::Service(ServiceError::Repository(
                RepositoryError::NotFound { .. }
            )) => "Ресурс не найден",

            AppError::Service(ServiceError::InvalidConfig { .. }) => "Некорректные данные",

            AppError::Service(_) => "Внутренняя ошибка",
        }
    }
}
Обратите внимание: маппинг может быть глубже, если ошибки «внутри» вложены через несколько enum. Это нормально, зато вы сохраняете точность.
4) Верхний слой: единая точка логирования
Псевдокод обработчика:
async fn handler