Индексы и планы запросов: ускоряем SQL, а не «угадываем»
Разберём, как читать EXPLAIN/EXPLAIN ANALYZE и как корректно выбирать индексы. Научимся находить бутылочные горлышки в запросах и убирать лишние сортировки.
Содержание
SQL часто ускоряют так, как будто он — лотерея: добавляют индексы «на всякий случай», меняют ORDER BY местами, переписывают запросы без проверки, и потом удивляются, почему производительность то растёт, то падает. Такая стратегия почти гарантированно упирается в стену: индексы не универсальны, а оптимизатор — не маг. Он опирается на статистику, ограничения, доступные индексы и выбранные способы выполнения.
Правильный путь начинается там, где многие заканчивают: с чтения плана запроса через EXPLAIN/EXPLAIN ANALYZE, выявления узких мест и уже после этого — корректного выбора индексов и удаления лишней работы (чаще всего сортировок, лишних чтений и повторных вычислений).
В этой статье разберём:
- как интерпретировать
EXPLAINиEXPLAIN ANALYZE, - какие признаки в плане указывают на «бутылочное горлышко»,
- как принимать решения по индексам без угадываний,
- как устранять лишние сортировки и другие дорогие шаги,
- какие типичные ошибки встречаются на практике.
Как работает оптимизатор: почему план — не формальность
Оптимизатор SQL (в PostgreSQL, MySQL, Oracle, SQL Server — все они отличаются, но смысл общий) должен решить: каким образом выполнить запрос с минимальной стоимостью. Он рассматривает варианты:
- как читать таблицы (последовательно или через индекс),
- как соединять их (nested loop, hash join, merge join),
- где фильтровать (как можно раньше сузить набор строк),
- нужно ли сортировать и где это делать,
- использовать ли индексы для
ORDER BY,GROUP BY, уникальности, - применять ли «пушдаун» ограничений в подзапросах/CTE.
Стоимость в плане — это не «реальная миллисекунда», а внутренняя оценка. Поэтому главный принцип такой: сначала смотрим структуру плана и реальные метрики из EXPLAIN ANALYZE, затем принимаем решения.
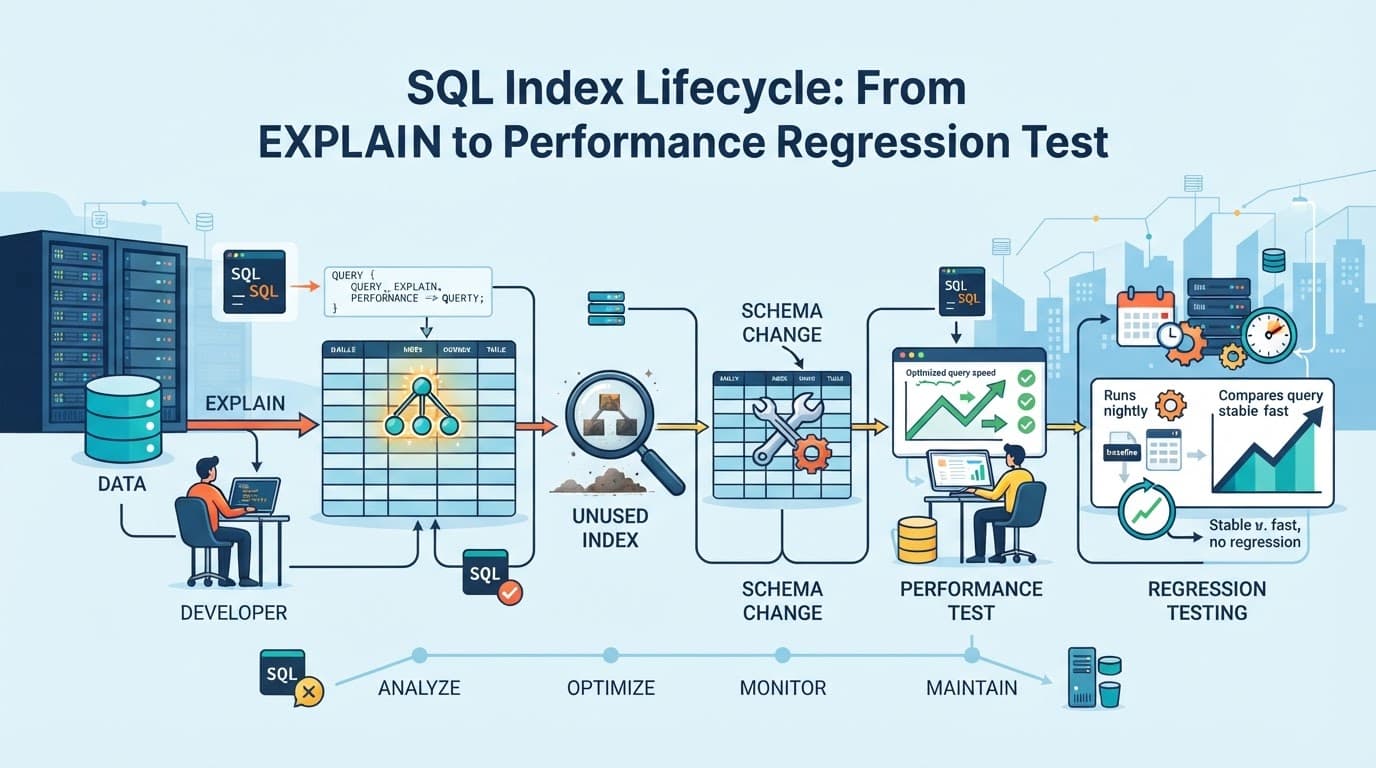
EXPLAIN и EXPLAIN ANALYZE: что именно смотреть
Что даёт EXPLAIN
EXPLAIN показывает предполагаемый план: как оптимизатор думает выполнить запрос. Примерно так: «я считаю, что это будет стоить X, поэтому выберу A». Если статистика устарела или запрос нестабилен по параметрам, оценка может сильно отличаться от реальности.
Поэтому EXPLAIN — хороший старт, но не финальный арбитр.
Что даёт EXPLAIN ANALYZE
EXPLAIN ANALYZE запускает запрос и собирает реальные метрики. На практике это самый важный инструмент: он показывает,
- сколько строк реально обработано на каждом шаге,
- сколько времени ушло на узлы плана,
- где именно возникла задержка.
В PostgreSQL типично показывается формат вроде:
actual time=... rows=... loops=...
Эти поля — ваш «рентген».
На что смотреть в реальном плане
Рассмотрим базовую схему чтения плана:
-
Сравните оценки и фактические строки
Еслиrowsиз плана иrowsизEXPLAIN ANALYZEсильно расходятся, это сигнал проблемы со статистикой или с логикой запроса. Например, оптимизатор мог выбрать не тот join-метод или неверную стратегию индекса. -
Определите узел с наибольшим вкладом во время
Не все узлы одинаково дорогие. Даже если общий запрос медленный, «тяжёлое» место может быть внутри одного конкретного оператора (часто это сортировка, hash aggregate, join или seq scan по большой таблице). -
Ищите «лишние» операции: Sort, HashAggregate, Materialize, лишние Recheck/Filter
Сортировки и агрегирования часто выполняются на больших объёмах данных, и именно там обычно «утекают» секунды. -
Смотрите на типы доступа к таблицам
В идеале вы видитеIndex Scan/Index Only ScanвместоSeq Scanна больших таблицах (хотя иногда seq scan — лучше). Главное — понимать, почему так. -
Смотрите на повторяемость (loops)
Если nested loops выполняются с большим числом итераций, даже «дешёвый» внутренний шаг может внезапно стать самым дорогим.
Бутылочные горлышки: как быстро найти узкое место
Пример 1: запрос медленный из‑за сортировки
Допустим, запрос:
SELECT user_id, created_at
FROM events
WHERE created_at >= now() - interval '30 days'
ORDER BY created_at DESC
LIMIT 50;
Наивная мысль: «добавим индекс». Но какой? И поможет ли он сортировке?
В плане вы ищете оператор Sort. Если он есть и сортирует много строк до применения LIMIT, это означает, что оптимизатор не смог использовать индекс для ORDER BY.
Типичный вариант хорошего индекса для PostgreSQL:
CREATE INDEX ON events (created_at DESC);
Тогда запрос может перейти к плану без явного Sort, используя индексный доступ + ограничение.
Как распознать проблему по плану
- есть
Sortи он стоит высоко по времени, - сортировка выполняется до
Limit(часто это видно по месту, где стоитLimitв дереве), - или сортировка работает с большим числом строк, а затем обрезается
LIMIT.
Практический вывод: если запрос содержит ORDER BY ... LIMIT, приоритет — индексы, которые поддерживают порядок. Иначе СУБД вынуждена отсортировать «всё», чтобы выбрать «первые 50».
Индексы: как выбирать, а не «наугад»
Общий принцип: индекс должен помогать конкретной операции
Индекс — это не ускоритель «вообще». Он ускоряет:
- выборку по условиям (
WHERE), - соединение (
JOIN), - сортировку/группировку (
ORDER BY,GROUP BY), - проверку на существование (
EXISTSв некоторых формах), - уникальность/ограничения (иногда тоже полезно).
Если запросы не используют порядок/фильтры, индекс может оказаться бесполезным — или даже ухудшить производительность из‑за дополнительных затрат на запись.
Составные индексы: порядок колонок имеет значение
Для составного индекса (PostgreSQL и большинство БД с B-Tree) порядок колонок влияет на то, какие условия будут «схвачены» индексом.
Например, часто встречается паттерн:
WHERE account_id = ?
  AND created_at >= ?
ORDER BY created_at DESC
Здесь логично индексировать (account_id, created_at DESC). Он одновременно:
- отфильтрует по
account_id, - позволит читать диапазон по
created_at, - даст правильный порядок для
ORDER BY.
Индекс вида ON events (created_at DESC, account_id) может не сработать так эффективно, потому что ключ сортировки начинается с другой колонок: условие по account_id окажется менее «доступным» в рамках индексного прохода.
Индекс для поиска по равенству + диапазон
Когда есть равенство и диапазон:
col = constant(равенство),col2 BETWEEN .../col2 >= .../col2 < ...(диапазон),
как правило, лучше ставить индекс так, чтобы сначала шла колонка с равенством. Тогда оптимизатор может сузить область сканирования и уже внутри выбирать диапазон.
Индекс для GROUP BY: нужен ли вообще
Если запрос:
SELECT user_id, COUNT(*)
FROM events
WHERE created_at >= now() - interval '30 days'
GROUP BY user_id;
вариант ускорения — индекс по (user_id) или (created_at, user_id), но многое зависит от плана:
- иногда помогает
HashAggregate(не требует сортировки), - иногда
GroupAggregate(требует упорядочивания) — тогда индекс может устранитьSort/GroupAggregateна больших данных.
Ключевой тест: смотрите в плане, какой агрегатор выбран и есть ли Sort перед ним.
Убираем лишние сортировки: самые частые причины и решения
Сортировка — одна из самых распространённых причин деградации. Даже быстрый сорт может стать дорогим, если:
- сортируются миллионы строк,
- сортировка вынуждена из‑за неподдерживаемого порядка,
- сортировка повторяется в вложенных запросах или после join.
1) ORDER BY не поддерживается индексом
Если запрос:
SELECT *
FROM orders
WHERE status = 'paid'
ORDER BY created_at DESC;
и в плане есть Sort, вероятно, индекс отсутствует (или не подходит по порядку). Решение: индекс, совпадающий с фильтром и сортировкой:
CREATE INDEX ON orders (status, created_at DESC);
2) Сортировка выполняется до применения LIMIT
Запрос:
SELECT *
FROM events
ORDER BY created_at DESC
LIMIT 100
WHERE user_id = 42;
Звучит так, будто должен примениться фильтр до сортировки, но в реальности оптимизатор может иначе разложить запрос (особенно при сложных условиях). Проверьте план: если фильтрация и join происходят после сортировки, вы оплачиваете сортировку лишних строк.
Решение может быть как индексация, так и переписывание запроса так, чтобы фильтр был более «явным» для оптимизатора. В PostgreSQL CTE не всегда ведёт к материализации, но в некоторых случаях влияет. Поэтому главное — опять же план.
3) ORDER BY в подзапросе без гарантии полезности
Иногда в сложных запросах встречается:
SELECT ...
FROM (
  SELECT ...
  FROM ...
  ORDER BY ...
) t;
Если во внешнем запросе ORDER BY отсутствует (или он по сути заменяется), порядок внутри подзапроса может быть лишним, а СУБД может всё равно сортировать, если считает это нужным по семантике (или из‑за конструкции запроса).
В SQL порядок строк без ORDER BY в конечном результате не гарантирован. Поэтому ORDER BY «внутри ради порядка» часто бессмысленен.
Соединения (JOIN) и индексы: где чаще всего ошибаются
1) Индекс на ключ соединения — это базовый минимум
Если у вас:
SELECT *
FROM orders o
JOIN users u ON u.id = o.user_id;
Обычно полезно:
- индексировать
orders.user_id, - и/или рассчитывать на индекс
users.id(еслиid— PK, он уже индексирован).
Если индексов нет, оптимизатор может выбрать hash join или nested loops с дорогими чтениями.
2) Неправильный индекс приводит к «почти работает»
Запрос может ускориться, но остаться медленным: потому что индекс используется частично. Например, есть индекс, но он не покрывает фильтр и сортировку.
Классическая ситуация: индекс есть на created_at, но запрос фильтрует ещё и по status, а сортирует по created_at. Тогда оптимальнее составной индекс (status, created_at DESC).
3) Слишком много индексов: плата за запись
Индекс улучшает чтение, но ухудшает вставки/обновления. В OLTP системах нужно балансировать: иногда один составной индекс заменяет несколько и уменьшает накладные расходы.
Covering indexes и “Index Only Scan”: когда индекс реально закрывает запрос
В PostgreSQL есть понятие index-only scan, когда СУБД может ответить на запрос, не читая таблицу целиком, если:
- нужные колонки есть в индексе,
- и для visibility map возможно отсутствие чтения heap (зависит от вакуума и MVCC).
Пример:
-- запрос читает только user_id и created_at
SELECT user_id, created_at
FROM events
WHERE created_at >= now() - interval '7 days'
ORDER BY created_at DESC
LIMIT 200;
Если создать индекс:
CREATE INDEX ON events (created_at DESC, user_id);
то теоретически часть данных можно получить из индекса. В плане вы увидите Index Only Scan (или хотя бы Index Scan) вместо обращения к таблице.
Это не магия: если visibility map плохая (например, таблица активно меняется без VACUUM), index-only может деградировать до обычного index scan с чтением heap. Но как идея — полезно.
Стратегия диагностики: пошаговый алгоритм
Ниже — практический алгоритм, который можно повторять для любых «медленных» запросов.
Шаг 1. Зафиксируйте проблему
- Что именно медленное? Время ответа? CPU? число блокировок?
- Есть ли разница между средним и худшим временем?
- Есть ли параметры (например,
LIMIT, диапазон дат), которые меняют план?
Шаг 2. Снимите план с анализом
Используйте EXPLAIN ANALYZE для реального набора данных и типичных параметров.
Шаг 3. Найдите самый дорогой узел
Смотрите на реальные actual time и на то, какие операции масштабируются с размером данных:
Seq Scanна большой таблице,Sort,HashAggregateна огромном количестве групп,Nested Loopс большимloops,Materialize(иногда признак неудачной декомпозиции).
Шаг 4. Проверьте расхождение оценок и факта
Если оценки сильно неверны:
- возможно, устарела статистика,
- запрос может быть параметризован и страдает от планов «под другой диапазон»,
- возможны проблемные типы данных/функции в
WHERE, которые мешают селективности.
В PostgreSQL часто помогает обновление статистики (ANALYZE) и аккуратные конструкции без лишних преобразований.
Шаг 5. Сформулируйте индекс “под операцию”, а не “под запрос”
Если проблема в WHERE status = ... и потом ORDER BY created_at DESC, индекс должен поддерживать именно это:
- правильный порядок колонок,
- правильную сортировку (DESC/ASC — в PostgreSQL для B-Tree влияет),
- при необходимости покрывать колонки.
Шаг 6. Перезапустите план и сравните
Новый индекс должен менять конкретные узлы плана:
- исчезает
Sort, - падает время
Seq Scan, - уменьшается число строк, проходящих через join/aggregate,
- сокращаются
loops.
Типичные ошибки, которые мешают ускорять SQL
Ошибка 1: добавлять индекс, пока не увидели узкое место
Если не понять, почему время растёт (сортировка? join? агрегирование?), индекс может не дать эффекта или ускорить не то место.
Ошибка 2: индекс «в целом» вместо поддержки условий и порядка
Индекс по одной колонке редко устраняет все проблемы, если запрос использует несколько критериев и требует сортировки/ограничения.
Ошибка 3: игнорировать составной индекс и порядок колонок
Без понимания префиксной природы составных индексов легко получить индекс, который частично используется или не используется вовсе.
Ошибка 4: злоупотреблять ORDER BY внутри запросов
Без финального ORDER BY порядок не гарантирован, а сортировка может стать лишней. Смотрите на план.
Ошибка 5: не учитывать стоимость индекса на запись
Особенно в системах с активными UPDATE/INSERT. Добавление множества индексов может «ускорить SELECT», но ухудшить общий latency системы.
Мини-практикум: как проверить эффект индекса на сортировке и LIMIT
Допустим, у нас таблица events:
user_id(int),created_at(timestamp),payload(text).
Запрос:
SELECT user_id, created_at
FROM events
WHERE user_id = 42
ORDER BY created_at DESC
LIMIT 100;
Вариант A: без индекса под порядок
Вероятно, план покажет Sort по большому набору строк (всё, что подходит по user_id), затем Limit.
Индекс для оптимизации
Создаём:
CREATE INDEX events_user_created_at_idx
ON events (user_id, created_at DESC);
После этого в плане стоит ожидать:
- чтение через
Index Scan, - отсутствие (или резкое уменьшение)
Sort, - быстрый переход к первым 100 строкам.
Если Sort всё равно есть, причина может быть в несоответствии порядка, неиспользуемости индекса из-за преобразований в запросе (например, created_at::date), или данных/статистике.
Подводные камни чтения планов: когда “индекс есть, но не помогает”
-
Оценки селективности неверны
Тогда оптимизатор может выбрать не тот план. Решение — обновить статистику и проверить расхождения оценки и факта. -
Функции/каст в WHERE ломают индексируемость Например,
WHERE created_at::date = '2026-01-01'может не использовать индекс наcreated_atнапрямую. Часто нужно переписать условие в диапазон по датам. -
Колонка в сравнении с выражением
WHERE col = some_function(?)иногда делает вычисление на стороне данных. -
Слишком общий индекс Например, индекс по
created_atможет помочь только когдаWHEREдостаточно селективен. Если выборка огромная, индекс может быть менее эффективен, чем seq scan.