SQL-диагностика: как читать планы выполнения без паники
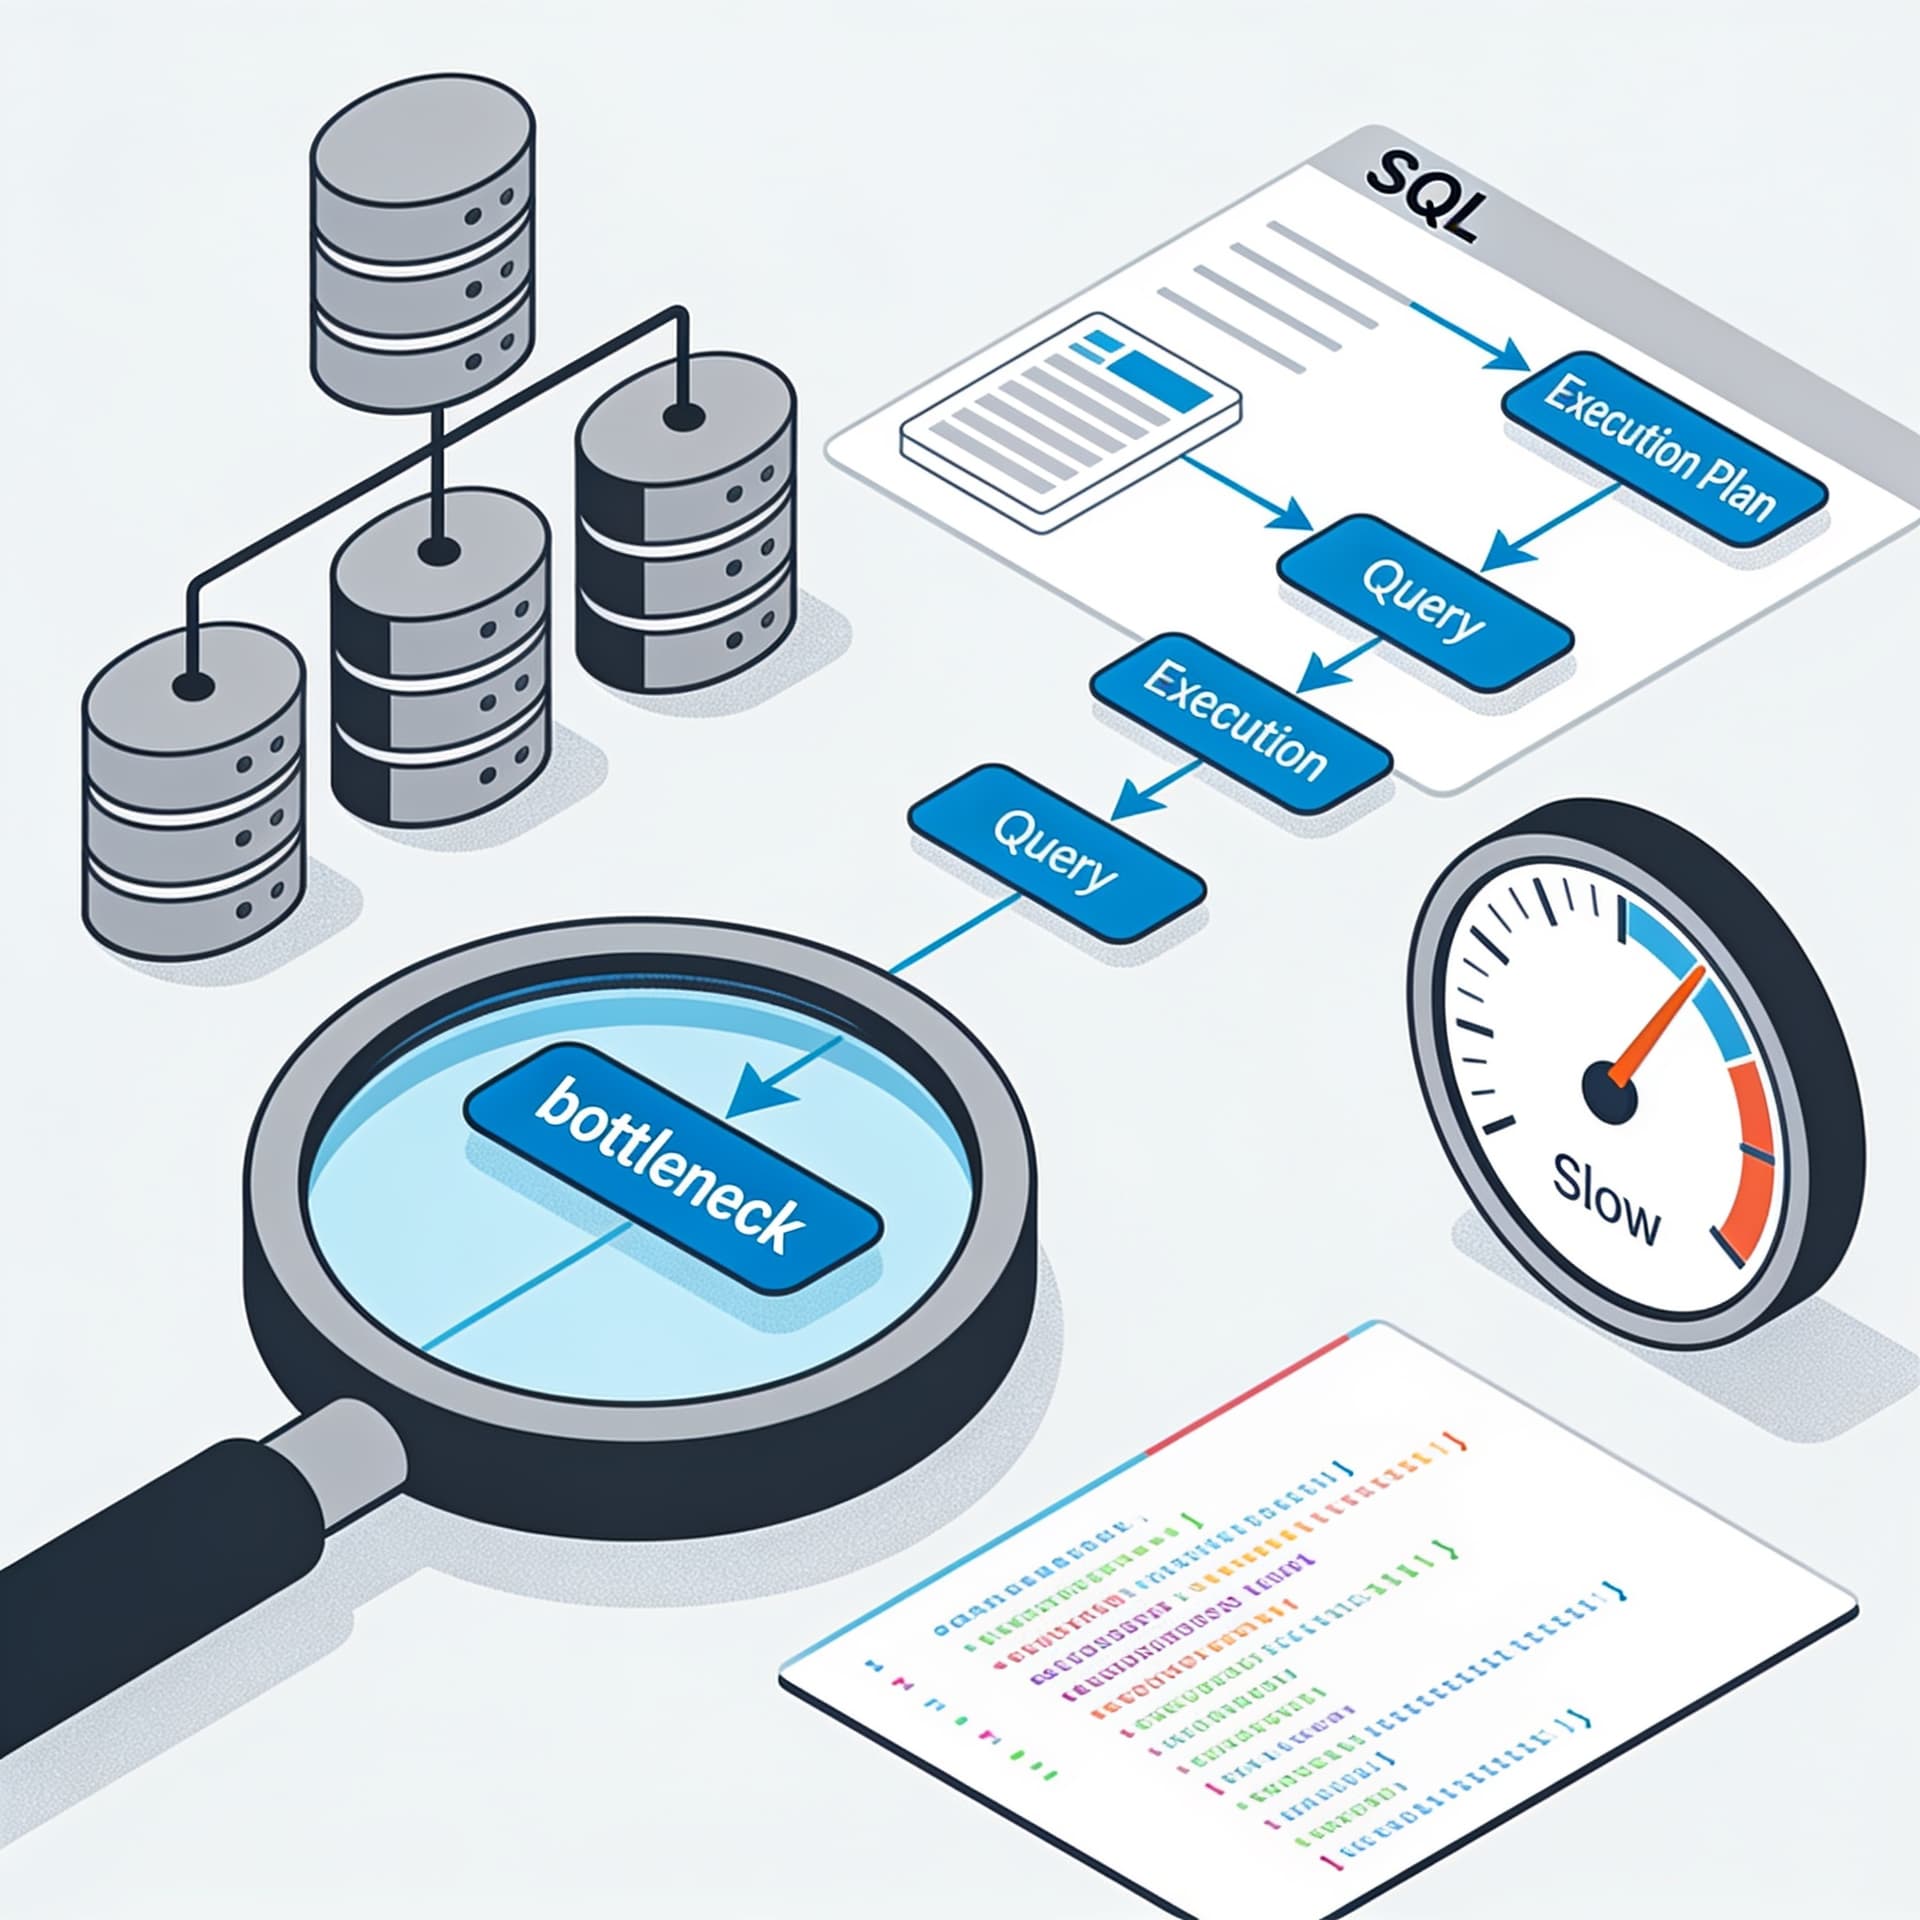
Научимся интерпретировать EXPLAIN, видеть узкие места и понимать, почему именно этот план выбран. Потренируемся на типовых причинах тормозов.
Содержание
Когда запрос начинает «тормозить», первая реакция почти всегда одна: паника и попытка переписать SQL целиком. Проблема в том, что в большинстве случаев истинная причина скрывается не в тексте запроса, а в том, как СУБД его исполнила: какой путь доступа к данным выбрала, какие индексы использовала, где споткнулась об оценку кардинальности и как устроена физическая схема выполнения.
Планы выполнения (EXPLAIN, а в некоторых СУБД — EXPLAIN ANALYZE) — это не формальность и не «красивый отчёт». Это инструмент диагностики, который помогает ответить на три ключевых вопроса:
- Что именно СУБД делает (операторы и порядок выполнения).
- Почему именно так (оценки стоимости, используемые индексы, способ соединений/агрегаций).
- Где узкое место (операции с большим числом строк, дорогие сортировки/хэши, отсутствующие индексы, неэффективные условия).
Эта статья — практическое руководство по чтению планов выполнения без паники: научимся интерпретировать EXPLAIN, выявлять типовые причины тормозов и сопоставлять текст запроса с выбранной стратегией оптимизатора. Примеры будут на диалекте PostgreSQL, но подход и большинство идей применимы и к другим СУБД (MySQL, MariaDB, Oracle, SQL Server) — просто меняются названия операторов и способы вывода.
Что важно знать до чтения EXPLAIN
“План” ≠ “фактическое выполнение”
EXPLAIN показывает оценку оптимизатора: предполагаемую стоимость, оценочные ряды (rows), порядок операций. Реальные времена могут отличаться, если, например, статистика устарела, параметры (bind variables) влияют на селективность, или есть нетипичные распределения данных.
Для практической диагностики лучше использовать:
EXPLAIN ANALYZE(если доступно) — план с фактическими метриками времени/строк.- В некоторых случаях —
EXPLAINвместе сBUFFERS/VERBOSE(PostgreSQL).
На что смотреть в плане в первую очередь
В большинстве планов вы найдёте структуру наподобие дерева операторов. Начинайте с:
- Самых верхних узлов (итоговый
Aggregate,Sort,Join,Limit). - Узлов, где стоимость максимальна (в PostgreSQL это
cost=...). - Операторов, которые либо обрабатывают очень много строк, либо сортируют/хэшируют.
- Разрыв между оценками и фактом (особенно полезно в
EXPLAIN ANALYZE).
Типовые источники “плохих” планов
План может быть выбран «не так», но причины почти всегда из одной из категорий:
- Нет подходящего индекса или он есть, но запрос не позволяет его использовать.
- Сильная ошибка в оценке селективности (статистика устарела, выражения нечётко интерпретируются).
- Неявное преобразование типов (например, сравнение
uuidс текстом). - Форматирование условия (например, функция на столбце в
WHEREвместо диапазона по индексу). - Неподходящий тип соединения или сложная логика
OR/подзапросов. - Отсутствие ограничения на количество строк до дорогих операций (сортировки/агрегации).
Как устроен план выполнения и как его читать
Общая структура дерева операторов
Представьте план как конвейер: от сканирования базовых таблиц до объединения результатов и финальной трансформации.
Обычно логика такая:
- Access:
Seq Scan,Index Scan,Bitmap Index Scan,CTE Scan. - Transform:
Filter,Sort,Aggregate,Hash,Materialize. - Combine:
Nested Loop,Hash Join,Merge Join. - Final:
Limit,Unique,Result.
Важно: физический план может быть «сложнее» логического запроса. Например, фильтр могут «протолкнуть» ближе к источнику, DISTINCT — переписать как Unique, а JOIN — переставить местами.
Стоимость и кардинальность (rows)
В PostgreSQL в узле плана есть примерно такие поля:
cost=STARTUP..TOTAL— оценка стоимости до/после.rows=N— оценка количества строк на выходе узла.width— оценочная ширина строки (для оценки ресурсов).
Ключевой практический сигнал: какие узлы ожидаемо работают с большим количеством строк. Даже если итоговое время выглядит не таким большим, узлы с rows на порядок выше остальных почти всегда источник проблем.
Индексы в планах: как распознавать их использование
Типичные маркеры в PostgreSQL:
Index Scan using idx_name— используется обычный индексный проход.Bitmap Index Scan using idx_name+Bitmap Heap Scan— комбинация множества индексов/диапазонов, часто при нескольких значениях или низкой селективности.- Отсутствие
Index Scan/Bitmap Index Scanпри наличии подходящего условия — красный флаг.
В других СУБД аналогичные идеи: ищите признаки индексного доступа и оценки селективности.
Практика: диагностика по типовым сценариям тормозов
Ниже — набор «классических» причин, которые встречаются чаще всего. Для каждого сценария: как распознать в плане и что делать.
Сценарий 1: Seq Scan вместо индексного доступа
Как распознать
В плане вы видите Seq Scan on ... при условии вида:
WHERE col = ...WHERE col BETWEEN ...WHERE col IN (...)
И при этом есть индекс на col.
Почему так происходит
Самые частые причины:
- Запрос не может использовать индекс из-за выражений/функций:
WHERE lower(email) = 'x'— индекс поemailне помогает.
- Типы несовместимы (неявные преобразования):
WHERE id = '123'приidтипаuuidможет ломать использование индекса.
- Низкая селективность: оптимизатор считает, что выгоднее пройти таблицу целиком.
- Устаревшая статистика: оптимизатор ошибся в оценках.
Что делать
- Уберите функции с левого края или используйте индекс по выражению (в PostgreSQL).
- Приведите типы явно.
- Проверьте статистику:
ANALYZEи актуальность.
Пример: функция на столбце ломает индекс
Допустим, есть индекс CREATE INDEX ON users (email);
Плохо:
EXPLAIN
SELECT *
FROM users
WHERE lower(email) = 'test@example.com';
Если оптимизатор не выбрал индекс, в плане будет Seq Scan или фильтрация после скана.
Правильно для PostgreSQL:
CREATE INDEX ON users (lower(email));

EXPLAIN
SELECT *
FROM users
WHERE lower(email) = 'test@example.com';
Сценарий 2: Огромные оценки rows из-за неверной статистики
Как распознать
Смотрите на rows и особенно на расхождение в EXPLAIN ANALYZE:
- оценка говорит, что будет 10 строк,
- а на деле выходит 10 000 000.
Это часто приводит к выбору неверного join-стратегии (например, Nested Loop вместо Hash Join) и к «катастрофе» времени.
Почему так происходит
- статистика устарела,
- в данных есть редкие значения (например, “плавающая” частота статусов),
- выражения/CTE могут скрывать зависимости (в старых версиях PostgreSQL поведение CTE отличалось),
- параметризация запроса (prepared statements) создаёт проблемы оценки.
Что делать
- Запустите
ANALYZE(или авто-статистику, если она есть). - Проверьте, есть ли улучшенная статистика (extended statistics) для коррелированных колонок.
- Иногда помогает переписать запрос так, чтобы условия были более «понятны» оптимизатору.
В качестве базового шага:
ANALYZE your_table;
Если есть корреляции между колонками (например, country и status), подумайте о расширенной статистике (в PostgreSQL это отдельный инструмент).
Сценарий 3: Неправильный JOIN (Nested Loop vs Hash/Merge)
Как распознать
Если вы видите:
Nested Loopна больших наборах данных,- или
Hash Joinс огромными потребностями, - либо
Merge Joinи при этом много сортировок (Sort),
то это потенциальная точка тормозов.
Типовой паттерн:
Nested Loopначинает делать тысячи (или миллионы) итераций,- внутри каждой итерации — дорогой поиск (иногда даже
Seq ScanилиIndex Scanпо неудачному индексу).
Почему Nested Loop внезапно становится дорогим
Nested Loop эффективен, когда:
- внешний набор маленький,
- внутренний набор находится быстро по индексу,
- и селективность предсказуема.
Если селективность оценена неверно, оптимизатор может «ошибочно» выбрать Nested Loop.
Что делать
- Убедиться, что индексы есть на колонках соединения (и в нужном порядке/типах).
- Проверить оценки vs факт в
EXPLAIN ANALYZE. - Переписать запрос так, чтобы ограничения применялись раньше (например, через
WHEREдо join или через материализацию/CTE — но осторожно). - Если проблема в оценках — смотреть в статистику и extended stats.
Пример: JOIN по неиндексированной колонке
-- допустим, нет индекса на orders.user_id
EXPLAIN
SELECT *
FROM users u
JOIN orders o ON o.user_id = u.id
WHERE u.id = 42;
Если orders.user_id не индексирован, план может стать дорогим.
Исправление:
CREATE INDEX ON orders(user_id);
После этого обычно появляется Index Scan на orders или выбор более эффективного join.
Сценарий 4: Дорогая сортировка (Sort) и “утечки” LIMIT
Как распознать
В плане встречается Sort (или GroupAggregate/Aggregate с подготовкой) до Limit.
Классическая картина:
- есть
ORDER BY ... LIMIT N, - но СУБД сортирует огромный набор, прежде чем отрезать.
Почему так происходит
ORDER BY требует глобального порядка. Если условия WHERE применяются поздно, или join раздувает количество строк, сортировка может стать доминирующей.
Также важны составные индексы: если есть индекс под ORDER BY, оптимизатор может обойти сортировку.
Что делать
- Убедиться, что
WHEREмаксимально сужает данные до сортировки. - Создать составной индекс под
ORDER BYи связанный фильтр.
Например:
-- запрос: фильтр по status и сортировка по created_at desc
EXPLAIN
SELECT *
FROM events
WHERE status = 'published'
ORDER BY created_at DESC
LIMIT 50;
Потенциальная оптимизация:
CREATE INDEX ON events(status, created_at DESC);
После чего EXPLAIN часто показывает использование индекса и отсутствие большого Sort.
Сценарий 5: Аггрегация/Дистинкт без нужных условий
Как распознать
В плане есть Aggregate, GroupAggregate, HashAggregate или Unique, и при этом большие rows.
Часто это происходит, когда:
- агрегируете по столбцам, которые не индексированы,
- или сначала делаете
JOIN, раздувая набор, а только потом агрегируете.
Что делать
- Попробовать агрегировать до join (если логически возможно).
- Создать индексы на ключи агрегации, особенно если агрегирование основано на фильтрах.
- Проверить, нельзя ли заменить
DISTINCTна более рациональную схему (иногда меняется семантика, но часто можно).
Сценарий 6: EXISTS/IN и коррелированные подзапросы
Как распознать
В плане подзапросы превращаются в особые узлы (в PostgreSQL — SubPlan, Semi Join, и т.п.). Если подзапрос коррелированный, он может выполняться много раз.
Плохой признак:
- количество запусков подзапроса велико (в
EXPLAIN ANALYZEэто видно), - внутри подзапроса есть тяжёлая фильтрация.
Что делать
- Проверить, есть ли индекс на колонках корреляции.
- Рассмотреть переписывание
EXISTSв semi-join через явныйJOIN(аккуратно, чтобы не сломать логическую эквивалентность). - Иногда помогает
DISTINCTвнутри подзапроса или ограничение по логике.
Методика: как выстроить разбор плана как расследование
Чтобы не утонуть в деталях, используйте повторяемый сценарий.
Шаг 1. Выведите план в “человеческом” режиме
Если доступны опции:
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)в PostgreSQL.
Пример:
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT ...
FROM ...
WHERE ...;
BUFFERS поможет понять, упирается ли проблема в дисковые чтения (shared read) или в CPU.
Шаг 2. Найдите самый “дорогой” узел
Смотрите на cost (и при ANALYZE — на actual time).
Вопросы:
- Это сортировка?
- Это join?
- Это сканирование таблицы?
- Это последовательная фильтрация больших наборов?
Шаг 3. Сверьте ожидания и реальность
Если EXPLAIN ANALYZE показывает:
rowsсильно отличаются,- время в узле сильно больше ожидаемого,
значит, оптимизатор ошибся. Следующий шаг — выяснить, почему ошибся: статистика, выражения, корреляции, параметры.
Шаг 4. Проверьте индексы относительно условий
Краткая проверка:
- есть ли индекс на колонках
WHEREиJOIN? - используется ли он в плане?
- нет ли выражений на индексируемой стороне?
Практический приём: выпишите условия и сопоставьте с индексами. Большинство “мистических” провалов объясняются отсутствием подходящего индекса или тем, что запрос не даёт СУБД использовать его.
Шаг 5. Изменяйте одно “рычажное” действие за раз
Не делайте серию правок без измерений. Лучше:
- поменять индекс,
- потом снова получить
EXPLAIN, - сравнить.
Так вы точно поймёте, что именно улучшило ситуацию.
Отдельный блок: почему СУБД “выбрала именно этот план”
Одна из самых тревожных мыслей — “почему оптимизатор не сделал иначе?”. Важно помнить: оптимизатор выбирает план по модели стоимости, а не по “вашему интуитивному ощущению”.
Основные причины, по которым план кажется нелогичным
- Селективность условия оценена иначе, чем ожидалось.
- Стоимость случайного доступа выше ожидаемой (например, из-за распределения страниц на диске).
- Нет возможности использовать индекс из-за выражений/типов.
- Данные в таблице изменились, статистика не отражает реальность.
- Ограничения запроса требуют дорогих операций (например,
ORDER BYбез подходящего индекса).
Как проверить гипотезу: “почему не индекс?”
Частая техника — сравнить несколько вариантов запросов (или добавить подсказки, если в вашей СУБД они допустимы). В PostgreSQL можно использовать enable_* параметры для экспериментов, но делать это в проде опасно. Как диагностический инструмент — иногда полезно.
Пример (диагностический; не как постоянное решение):
SET enable_seqscan = off;

EXPLAIN
SELECT ...
FROM ...
WHERE ...;
Если после запрета Seq Scan план стал значительно быстрее/ожидаемее — проблема действительно может быть в оценках стоимости или статистике. Но финальное решение всё равно должно быть “правильным” (индекс/статистика/переписывание), а не постоянным отключением стратегий.
Подводные камни: что чаще всего ломает диагностику
1) Сравнивать планы без фиксации контекста
План может меняться в зависимости от:
- настроек параметров,
- размера work_mem,
- состояния кэша страниц,
- статистики,
- параметров запроса.
Для честного сравнения старайтесь:
- прогонять тесты одинаково,
- и при возможности использовать
EXPLAIN (ANALYZE, ...).
2) Игнорировать “второй порядок” узлов
Иногда проблема не в самом дорогом узле по cost, а в узле, который запускает дорогую ветку многократно (например, внутренний путь Nested Loop).
3) Путать стоимость и узкое место реального времени
cost — модель. Реальное время — факт. Для диагностики узкого места используйте actual time и анализ loops.
4) Переусложнять запрос вместо анализа
Если вы просто переп