Terraform для тех, кто “уже настроил, но страшно”: модульность и state без боли
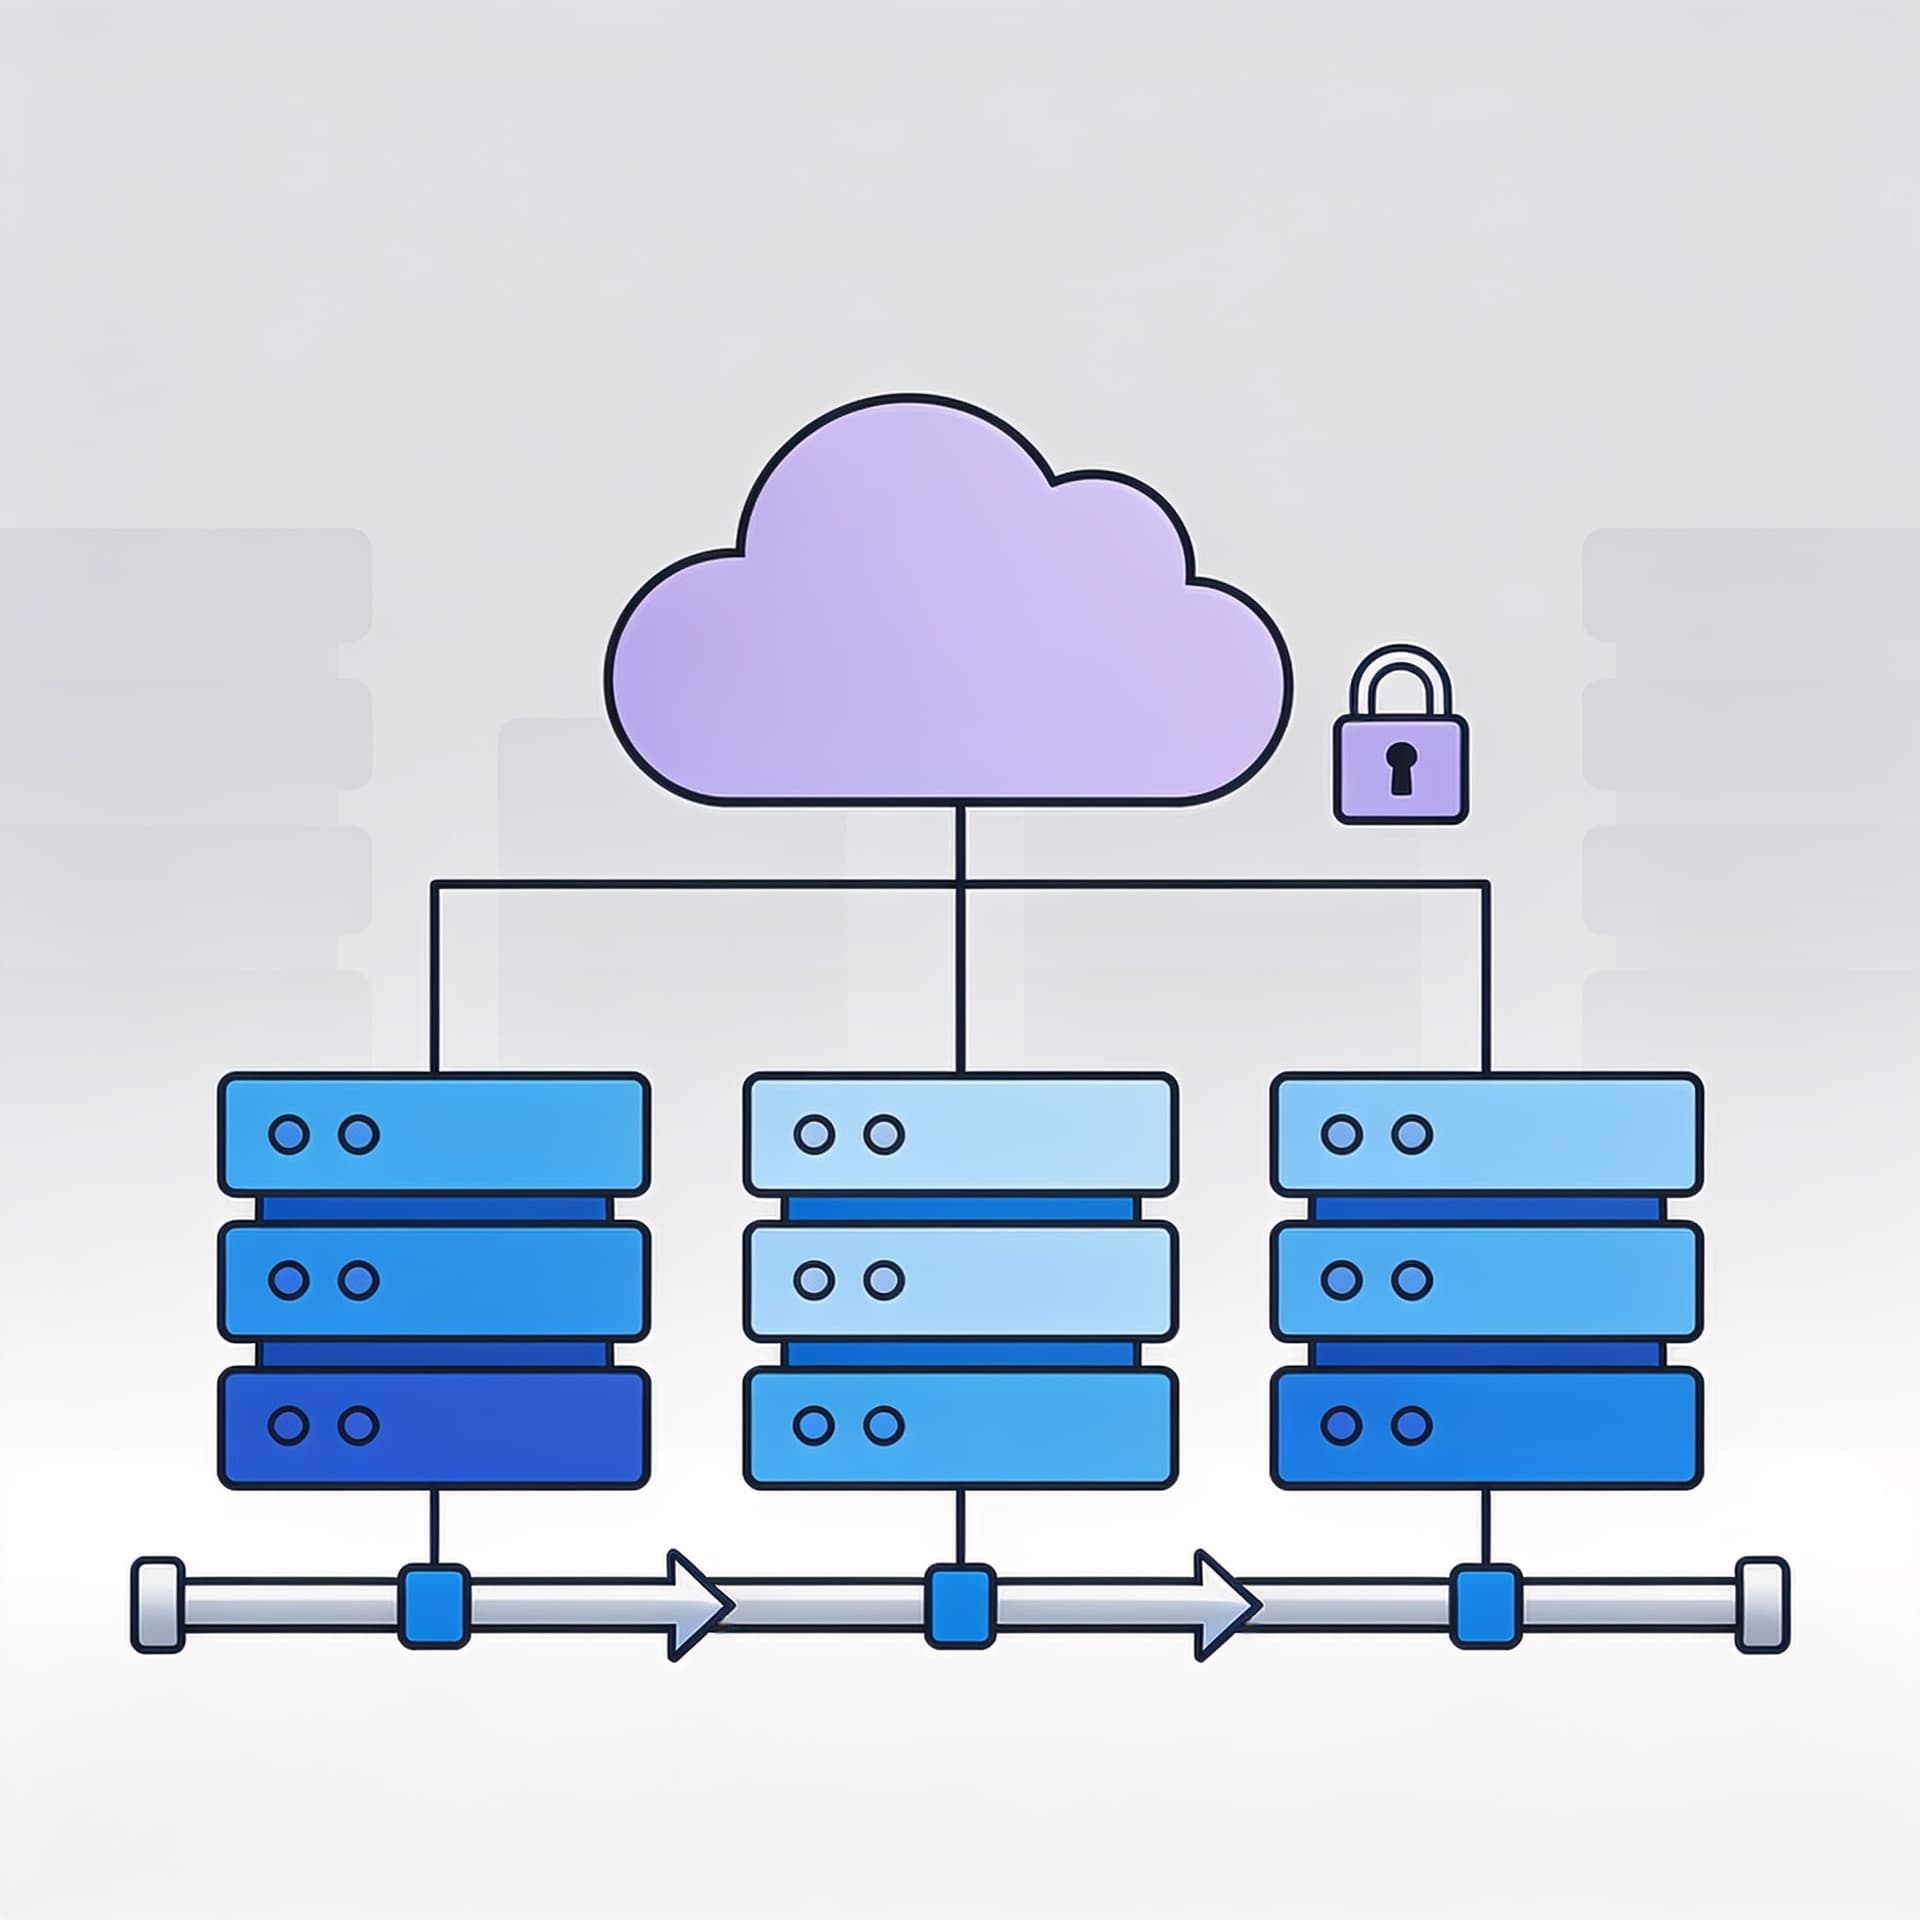
Разберём структуру модулей, remote state, блокировки и стратегию развёртывания, чтобы инфраструктура не ломалась от каждого коммита.
Содержание
Terraform часто начинает жизнь в режиме «всё работает, просто держу конфиги в одном репозитории». А потом наступает момент, когда страх становится рациональным: любая правка, любой коммит — и инфраструктура может “переехать” не в ту сторону, потерять данные или неожиданно задеть соседние окружения. Это не паранойя. Это типичная проблема зрелости инфраструктурного кода: модульность не заведена, а состояние (state) и стратегия развёртывания не формализованы.
В этой статье разберём, как сделать Terraform предсказуемым:
- проектируем модули так, чтобы изменения были локальными;
- выстраиваем работу с remote state (и понимаем, почему он вообще нужен);
- добавляем блокировки, чтобы параллельные деплои не порвали один и тот же state;
- формируем стратегию развёртывания, чтобы инфраструктура не ломалась от каждого коммита.
Материал ориентирован на тех, кто уже “настроил”, но чувствует, что дальше идти страшно: хочется порядка, а не очередного набора хаотичных практик из заметок в чатах.
Почему “страшно” — это не про Terraform, а про жизненный цикл state
Terraform хранит “смысл” текущей инфраструктуры в файле состояния: state. В нём фиксируются связи между конфигурацией и реальными ресурсами: какие ресурсы созданы, какие атрибуты Terraform ожидает, какие ID у объектов в облаке. Без state Terraform вынужден угадывать, что уже существует, а что нужно создать — и это ведёт к лишним изменениям.
Ключевой момент: state — это не просто “кэш”. Это источник правды для Terraform, и если он повреждён, рассинхроен или перезаписан двумя запусками подряд — вы получаете именно тот эффект, который пугает.
Отсюда вытекают требования:
- State должен быть единым и доступным команде (remote state вместо локального файла).
- Нужно защищать state от одновременных изменений (lock).
- Деплой должен выполняться упорядоченно (стратегия apply/plan и разграничение окружений).
Модульность: как уменьшить “радиус удара” от изменений
Модульность в Terraform — не про “красоту кода”. Это способ ограничить, насколько широкими могут быть последствия одной правки. В инфраструктуре “ошибка в одном файле” часто превращается в “пересоздание половины окружения”. Модульность должна помочь этого избежать.
Разделяйте по границам ответственности
Хорошая декомпозиция начинается с вопроса: что должно меняться независимо? Типичные границы:
- сеть и маршрутизация;
- вычислительные окружения (ASG/instances, k8s node groups);
- базы данных;
- очереди/шины/хранилища;
- внешние интеграции (DNS, сертификаты, identity).
Пример структуры репозитория:
infra/
  modules/
    vpc/
      main.tf
      variables.tf
      outputs.tf
    rds/
      main.tf
      variables.tf
      outputs.tf
  envs/
    dev/
      main.tf
      variables.tf
      backend.tf
    prod/
      main.tf
      variables.tf
      backend.tf
Каждый envs/<env> описывает “сборку” окружения, а модули — конкретные строительные блоки.
Модули должны быть “тонкими”: входы-выходы без скрытых зависимостей
Один из источников боли — модуль, который “знает” слишком много. Например, модуль базы данных использует hard-coded имя VPC, аккаунт или security group. На практике это вынуждает править модуль ради изменений окружения, и последствия становятся непредсказуемыми.
Старайтесь делать так:
- все внешние зависимости — через
variables; - все полезные атрибуты — через
outputs.
Пример переменных для RDS-модуля:
variable "vpc_id" {
  type = string
}

variable "subnet_ids" {
  type = list(string)
}

variable "engine_version" {
  type = string
}

variable "db_name" {
  type = string
}
И пример вызова модуля из envs/dev/main.tf:
module "db" {
  source = "../../modules/rds"

  vpc_id         = module.network.vpc_id
  subnet_ids    = module.network.private_subnet_ids
  engine_version = "16.3"
  db_name       = "app_dev"
}
Так вы получаете важное свойство: модули переиспользуются без правок, а значит — вы реже провоцируете масштабные diffs.
Используйте outputs, а не “проходите наружу” ресурсами
Если модуль наружу экспонирует только IDs, то вы снижаете вероятность того, что кто-то “влезет” внутрь логики модуля с неочевидным эффектом.
Например, в modules/vpc/outputs.tf:
output "vpc_id" {
  value = aws_vpc.this.id
}

output "private_subnet_ids" {
  value = aws_subnet.private[*].id
}
Remote state: почему локальный state — это “триггер для беды”
Самая частая причина “страшно” после появления команды — локальный terraform.tfstate. Даже если каждый запускает Terraform только “у себя”, есть несколько проблем:
- вы теряете согласованность: кто-то применил изменения, а у вас state ещё старый;
- при пулл-реквестах state не обновляется автоматически;
- при конфликте перезапись state приводит к разъезду ресурсов.
Backend: единое хранилище state и управление доступом
Remote backend — это часть конфигурации, которая говорит Terraform, где хранить state.
Типичный пример для AWS S3 + DynamoDB lock (если вы в AWS):
terraform {
  backend "s3" {
    bucket         = "my-terraform-state-bucket"
    key            = "envs/dev/terraform.tfstate"
    region         = "eu-central-1"
    dynamodb_table = "my-terraform-locks"
    encrypt        = true
  }
}
Если вы используете другой облачный провайдер или toolchain, идеи те же: state хранится удалённо, а lock — в отдельном механизме.
Критически важно: ключ (key) должен включать окружение. Иначе dev/prod будут писать в один и тот же state, и “применить один коммит” станет эквивалентно применению “по всем окружениям сразу”.
Схема state по принципу “одна зона изменений — один state”
Подход “один общий state на весь проект” выглядит удобно, но быстро становится миной. Terraform, как правило, считает resources в рамках одного state связанными: diff может затронуть много чего при малых изменениях.
Практичнее разделять state по границам:
- либо по окружениям (dev/prod отдельно);
- либо по доменам (network отдельно, database отдельно);
- либо по обоим параметрам.
Если вы строите платформу с несколькими командами, разумно делать отдельные state для независимых доменов. Но тогда появляется ещё одна тема: как передавать данные между доменами.
Блокировки (lock): защита от параллельных apply
Даже при remote state параллельные операции остаются риском. Представьте: в CI одновременно запустились два job’а, оба сделали plan, и оба пытаются выполнить apply. Если lock не используется — state может оказаться повреждённым или частично обновлённым.
Remote backend обычно поддерживает lock. На AWS это DynamoDB; на других — аналогичные механизмы.
Что реально важно для команды
- Lock должен быть включён в backend.
- Политики CI должны предотвращать параллельные applies на один и тот же key state. Lock — это последняя линия обороны, но лучше организовать пайплайн так, чтобы конфликтов не было.
- Если вы делаете manual apply “руками”, договоритесь, что вы не запускаете второй apply поверх первого.
Пара слов о том, что делать при проблемах
Если Terraform “завис” на lock — обычно это означает, что предыдущий процесс мог завершиться аварийно или lock остался. Действия зависят от backend (например, для AWS это может требовать удаления записи lock из DynamoDB), но это стоит делать строго по инструкции вашей команды/провайдера, чтобы не сломать консистентность.
Стратегия развёртывания: планируемость важнее “быстрого apply”
Существует распространённая ошибка: “будем применяться на каждый коммит”. В маленьком проекте это иногда живёт. В зрелости — становится источником хаоса. Правильная стратегия зависит от того, насколько вы доверяете CI и как часто меняются конфиги.
Базовый паттерн: план в PR, apply в отдельном шаге
Смысл:
- В pull request запускаем
terraform planи публикуем результат. terraform applyвыполняем либо:- только после merge и только в определённой ветке,
- либо вручную с подтверждением,
- либо через workflow “approve gate” (например, через ручное одобрение).
Это создаёт “контур безопасности”: вы хотя бы видите, что Terraform хочет сделать, прежде чем он что-то изменит.
Пример логики для CI (условно, без привязки к конкретной платформе):
- PR:
terraform init -backend=false(если вы не хотите трогать backend на PR)terraform validateterraform plan -out=tfplan- публикуем
tfplanкак артефакт
- Merge/Manual:
terraform initterraform apply tfplan
Планируйте изменения, а не “действуйте сразу”
Команда часто начинает делать apply в CI “на лету”, но тогда вы теряете возможность остановиться на неожиданном diff. Кроме того, когда state уже удалённый, вы ограничены консистентностью и lock’ами; значит, более сложные стратегии (например, staged apply) становятся оправданными.
Staged rollout: если ресурсы критичны
Для базовых элементов инфраструктуры (например, VPC, сетевые ресурсы, IAM) полезно:
- применять их отдельно и реже;
- делать изменения более “крупными” релизами;
- придерживаться versioning концепции модулей (см. ниже).
Для приложений можно обновлять чаще — но отдельно.
Версионирование модулей и контроль изменений
В Terraform модули часто живут “как есть” в modules/. Это удобно, но не даёт гарантии, что изменение модуля не сломает окружения внезапно.
Вариант 1: дисциплина “не трогать модуль без причины”
Если модули обновляются только осознанно, вы можете держать их в одной ветке и применять изменения через PR. Но на практике люди всё равно иногда делают “быструю правку” в модуле, которая внезапно запускает перестройку.
Вариант 2: версионирование модулей как у библиотек
Если модуль хранится в реестре или git-репозитории, используйте версии (теги). Тогда окружение фиксирует зависимость:
module "network" {
  source  = "git::ssh://git.example.com/infra-modules.git//vpc"
  version = "1.4.0"

  # inputs...
}
Смысл: изменение модуля само по себе не меняет окружение. Окружение меняется только тогда, когда вы обновляете версию зависимости.
Даже если у вас не “реестр модулей”, а просто git, подход “фиксируй версию” снижает страх: вы знаете, почему что-то изменилось.
Практические примеры структуры репозитория: минимальный рабочий шаблон
Окружение dev/prod с раздельным backend
envs/dev/backend.tf:
terraform {
  backend "s3" {
    bucket         = "my-terraform-state-bucket"
    key            = "envs/dev/terraform.tfstate"
    region         = "eu-central-1"
    dynamodb_table = "my-terraform-locks"
    encrypt        = true
  }
}
envs/prod/backend.tf отличается только key.
Вызов модулей в envs/dev/main.tf
module "network" {
  source = "../../modules/vpc"

  cidr_block = "10.10.0.0/16"
  name       = "dev"
}

module "db" {
  source = "../../modules/rds"

  vpc_id       = module.network.vpc_id
  subnet_ids  = module.network.private_subnet_ids
  db_name     = "app_dev"
  engine_version = "16.3"
}
Outputs для связки доменов
Если вы разделяете state по доменам, возможно потребуется “сквозная” интеграция через remote state data source. Но здесь важно не превращать это в зависимость “туда-сюда”. Лучше определить понятные контракты: например, vpc_id и списки subnet IDs.
Remote state как контракты между доменами: полезно, но с осторожностью
Terraform позволяет читать outputs другого state:
data "terraform_remote_state" "network" {
  backend = "s3"
  config = {
    bucket = "my-terraform-state-bucket"
    key    = "envs/dev/terraform.tfstate"
    region = "eu-central-1"
  }
}

output "vpc_id_from_network" {
  value = data.terraform_remote_state.network.outputs.vpc_id
}
Где здесь опасность? Если домены начать менять независимо без координации:
- можно попасть в ситуацию, когда downstream-модуль получил “старые” outputs;
- поменявший upstream commit не применился, но downstream уже планируется.
Поэтому важна дисциплина:
- либо применяйте upstream перед downstream;
- либо используйте разные ветки релизов и отдельные workflow’и;
- либо обеспечьте возможность согласованного deploy (хотя бы через порядок шагов в pipeline).
Типичные ошибки, которые усиливают страх
1) Один state на всё сразу
Это почти гарантирует большие diffs и непредсказуемость при рефакторинге конфигов.
2) Общий backend key для нескольких окружений
Ошибка выглядит “мелкой”, последствия — огромные: dev применит изменения и затронет prod или наоборот.
3) Применение в CI без контроля
Параллельные apply без блокировок или без gating — рецепт конфликтов state.
4) Модули со скрытыми зависимостями
Hard-coded значения (VPC, регионы, names) заставляют “подкручивать” модули и делают изменения трудноотслеживаемыми.
5) Отсутствие outputs как контракта
Если вместо outputs вы “перетаскиваете” внутренние ресурсы напрямую или полагаетесь на совпадение имён — Terraform теряет ясность, а вы — контроль.
Как уменьшить риск от каждого коммита: практическая политика команды
Если вы хотите, чтобы “страшно” превратилось в “контролируемо”, обычно помогает формализовать политику:
- Окружение dev/prod — всегда разное state (разные key).
- Apply только после plan (и лучше — после merge/approval).
- Ограничьте изменения модулей:
- модули меняйте через PR,
- используйте версионирование или хотя бы дисциплину review.
- Сделайте правила для state:
- remote state обязателен;
- lock должен быть активен;
- запрет на параллельные apply на один key.
- Разделяйте домены:
- network отдельно от app,
- db отдельно от compute,
- внешние интеграции отдельно.
Вывод: предсказуемая инфраструктура начинается с архитектуры, а не с магии CI
Terraform перестаёт пугать, когда вы перестаёте относиться к нему как к “набору .tf файлов”, а начинаете относиться как к системе с жизненным циклом:
- модули уменьшают область влияния изменений и превращают конфиги в повторяемые контракты;
- remote state обеспечивает консистентность и совместную работу команды;
- блокировки защищают от параллельных конфликтов;
- стратегия развёртывания (plan в PR, apply после контроля) делает изменения наблюдаемыми.
Если хочется углубиться в структурирование инфраструктуры и практики безопасной работы с state, полезным продолжением может стать материал по подходу, близкому к тому, что мы разобрали в этой статье: курс /course/.
Главная мысль простая: вы не убираете риск полностью — вы делаете его управляемым. И это как раз то, что позволяет инфраструктуре переживать коммиты без чувства, что “сейчас что-то сломается”.