Кэш и инвалидация на практике: write-through, write-back и дедупликация запросов
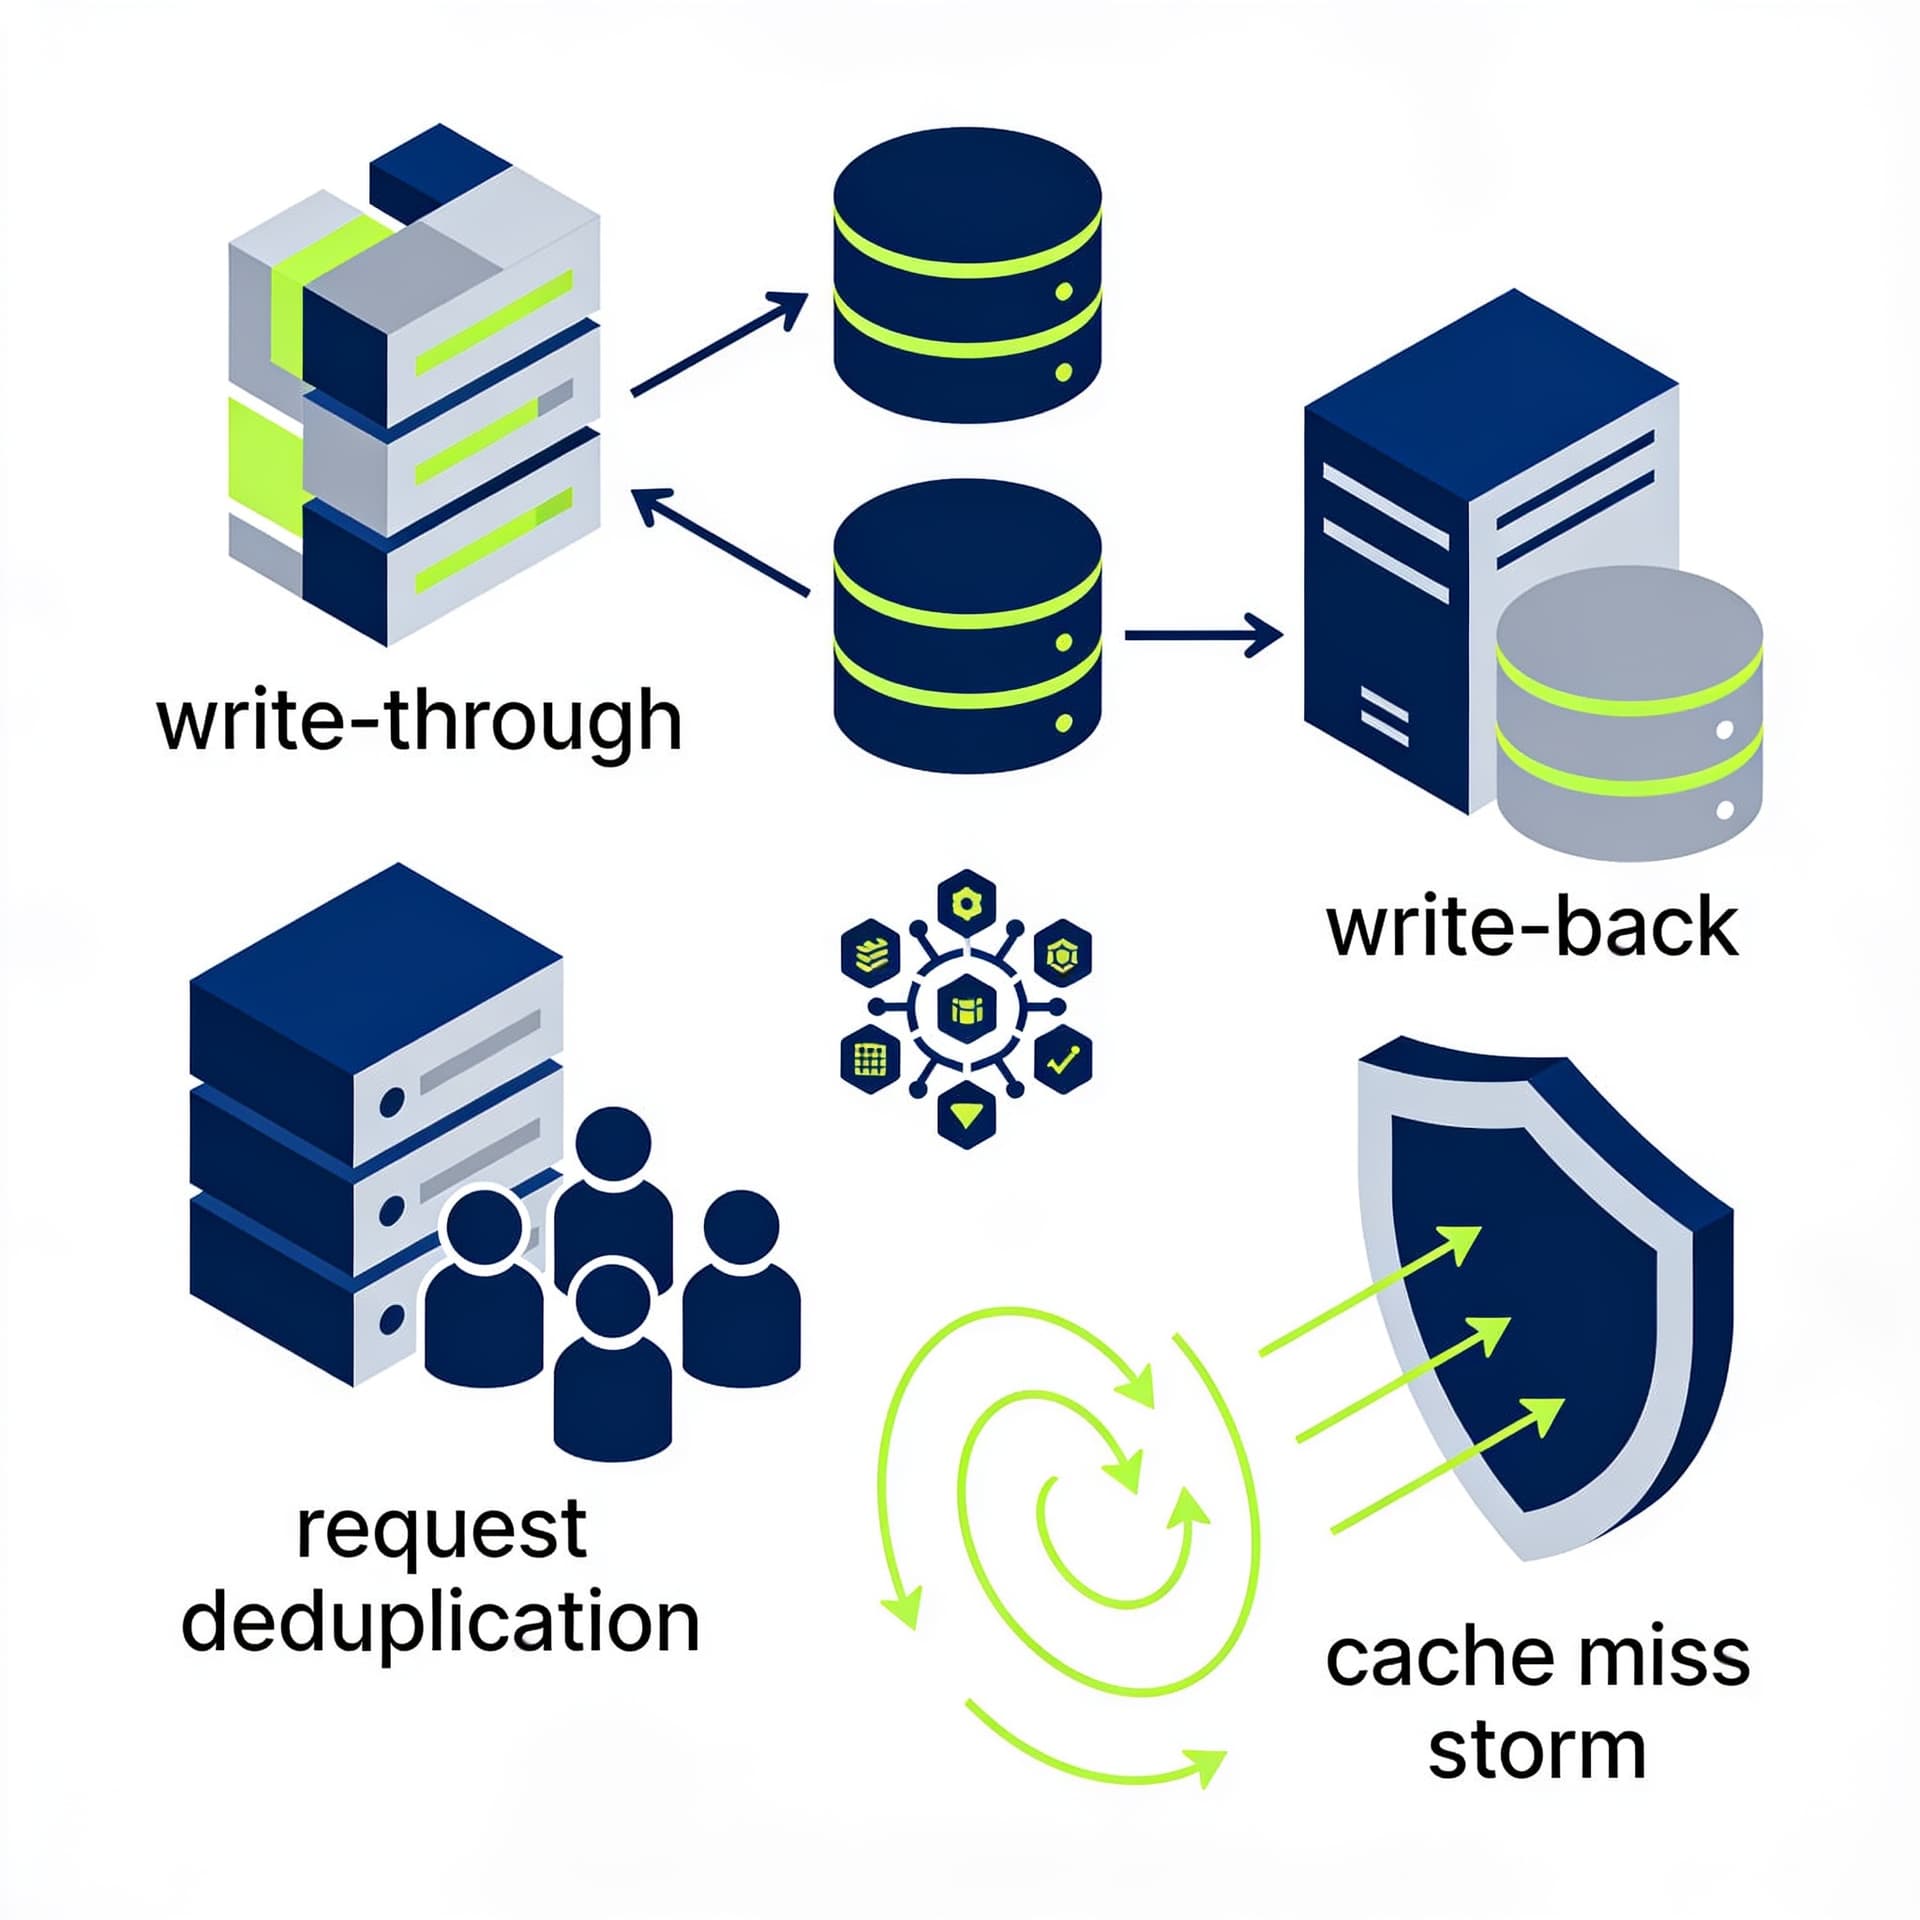
Разберём рабочие паттерны кэширования для конкурентных обновлений и покажем, как предотвращать «шторм» при промахе кэша.
Содержание
Кэширование в высоконагруженных системах — не про «ускорить на пару процентов». Это про контроль над поведением сервиса в моменты неопределённости: промахи кэша, всплески трафика, конкурентные обновления одних и тех же ключей, гонки между чтением и записью, эффекты каскадных ретраев. Именно тогда проявляется разница между «кэшем, который работает в тестах» и «кэшем, который держит прод».
В этой статье разберём три практических аспекта кэширования:
- Как выбирать стратегию записи:
write-throughvswrite-back(и почему обе могут быть опасны при неправильной инвалидации). - Как делать инвалидацию корректно: где ошибаются команды, которые «просто чистят ключи».
- Как предотвращать “шторм” промахов: паттерн дедупликации запросов (single-flight / request coalescing) и смежные техники.
Цель — чтобы вы могли не гадать, а проектировать поведение кэша как часть системы согласования данных.
1. Термины и модель: что именно кэшируем
Прежде чем выбирать паттерн, полезно зафиксировать, что кэш хранит и какие отношения должны соблюдаться между «истиной» (источник данных) и кэшем.
1.1. Кэш как копия с заданной семантикой
В большинстве приложений кэш — это:
- либо копия данных с оговорённым временем жизни (TTL),
- либо результат дорогой операции (например, сборка профиля),
- либо агрегат/вычисление, обновляемое по событию.
Главный вопрос: насколько допустимо видеть устаревшие данные и на каком уровне.
- Strong consistency требует обновлять все чтения синхронно — на практике дорого и не всегда возможно.
- Eventual consistency допускает кратковременную рассинхронизацию, компенсируя её TTL/версией/событиями.
1.2. Инвалидация vs вытеснение по TTL
Есть два фундаментальных механизма:
- TTL (expiration): кэш протухает сам. Простота, но возможны «гонки» при одновременном протухании.
- Инвалидация: мы явным образом помечаем ключ как невалидный (удаляем, обновляем версию, публикуем событие).
Проблема начинается, когда комбинируют TTL и ручную инвалидацию, не понимая, что происходит при гонках.
2. Стратегии записи: write-through и write-back
2.1. Write-through: запись в кэш и источник одновременно
write-through означает, что при обновлении данных приложение делает:
- запись в источник (БД/сервис),
- синхронную/полусинхронную запись в кэш (или наоборот, но чаще источник и кэш должны завершиться «как часть одной логики»).
Плюсы:
- кэш быстро отражает изменения,
- меньше случаев чтения устаревшего.
Минусы:
- выше задержка на запись (кэш становится частью критического пути),
- при отказах кэша или проблемах с сетью можно получить каскадные эффекты.
Практический рецепт
Write-through чаще применяют, когда:
- чтение в разы чаще записи,
- кэш надёжен (например, локальный инстанс/кластер с хорошей отказоустойчивостью),
- допускается увеличение latency на write.
Но важно: кэш не должен «переписать» более новые данные более старыми. Для этого часто используют версионирование/ETag/временные метки.
2.2. Write-back: запись только в источник, а кэш догоняет позже
write-back — это стратегия, при которой запись обновляет источник, а кэш либо:
- не трогается, пока не будет промах/инвалидация,
- обновляется лениво (например, при следующем чтении).
Плюсы:
- запись дешевле,
- меньше зависимости кэша в момент обновления.
Минусы:
- риск чтения устаревших значений между обновлением в источнике и обновлением/инвалидацией кэша,
- сложнее бороться с «штормом» после TTL/инвалидации.
Где чаще всего ломается write-back
Типичный сценарий:
- ключ протухает (TTL истёк) или его инвалидация сработала,
- приходит много запросов на чтение,
- каждый делает обращение к источнику (БД/сервису),
- источник перегружается и начинает отвечать медленно/с ошибками,
- клиенты ретраят, усиливая нагрузку.
Это и есть тот самый кэш-шторма при промахе кэша.
3. Инвалидация: “почистить ключ” — недостаточно
Инвалидация — это не действие «delete key». Это часть протокола согласования между источником и кэшем.
3.1. Два подхода к инвалидации
(A) Удаление (delete) ключа
После обновления данных вы удаляете запись в кэше:
- просто,
- эффективно устраняет устаревшие значения,
- но может привести к шторму, если ключ протухает/удаляется массово.
(B) Версионирование (versioned keys)
Вместо удаления вы меняете «версию» ключа:
- храните
cache_version[userId], - формируете кэш-ключ как
profile:{userId}:v{version}, - при обновлении инкрементируете версию или публикуете событие.
Плюсы:
- отсутствие гонок «удалили, пока кто-то читает»,
- легче обеспечивать атомарность через CAS/Redis Lua,
- можно держать несколько версий на время.
Минусы:
- рост количества ключей (нужно GC/TTL на старые версии),
- усложнение дизайна.
3.2. Гонка чтения и записи: сценарий, который сложно увидеть
Рассмотрим без версионирования:
- Поток A делает обновление в БД.
- Поток A удаляет ключ в кэше.
- Поток B в этот момент читает ключ:
Варианты:
- B успел прочитать кэш до удаления — получит старое значение.
- B успел прочитать кэш после удаления — получит промах и пойдёт в БД.
- B пришёл между записью в БД и удалением из кэша — получит старое значение, если ключ ещё не удалён.
Если вы используете write-back с инвалидацией, критична порядковость событий: инвалидация должна отражать момент истины. На практике это означает либо транзакционную связь, либо «временной маркер» (версии/лейблы) и проверку при записи в кэш.
4. Предотвращение “штормов”: дедупликация запросов (single-flight)
Когда кэш промахнулся, особенно на горячих ключах, возникает проблема: параллельные одинаковые запросы умножаются в нагрузке на источник. Дедупликация решает это: один вычислитель на ключ, остальные ждут результат.
4.1. Что такое single-flight
Идея: при промахе кэша создаётся «координация» для конкретного ключа:
- первый запрос запускает дорогое вычисление/чтение,
- остальные запросы на тот же ключ не запускают повторно, а ждут тот же future/promise,
- по завершении результата кэш заполняется, и все возвращают одно значение.
Подводные камни:
- время ожидания (таймауты),
- обработка ошибок (если вычисление упало — как отвечать всем?),
- очистка ожиданий (чтобы не протечь память/локи).
4.2. Паттерн дедупликации поверх Redis/кэша
Есть несколько уровней реализации:
- Внутри процесса (локальный single-flight): хорошо для одного инстанса.
- В масштабе (распределённый single-flight): сложнее, но правильно для нескольких инстансов.
Для распределённого варианта обычно используют:
- распределённый lock (Redis
SET NX PX), - Pub/Sub или Streams для ожидания результата,
- либо специальные конструкции в приложении (например, “promise registry” в shared store).
Ниже — рабочие примеры на уровне приложения с Redis как координацией.
5. Write-through + инвалидация + дедупликация: практический сценарий
Представим API: GET /profile/{userId} собирает профиль из БД (дорого), а POST /profile/{userId} обновляет данные.
5.1. Модель данных для кэша
- key:
profile:{userId}:v{version} - версию храним в отдельном ключе или в метаданных источника.
- при обновлении данных увеличиваем версию и инвалидируем старую.
Если вы не хотите версионирование — можно делать delete, но тогда больше шансов словить гонки и шторм.
5.2. Пример: дедупликация при промахе (JavaScript/TypeScript)
Ниже пример логики на Node.js. Он показывает идею single-flight через Redis lock. Это не единственный путь, но он понятный и рабочий.
Утилиты: чтение/запись кэша и lock
import { createClient } from "redis";

const redis = createClient({ url: process.env.REDIS_URL });
await redis.connect();

const CACHE_TTL_SECONDS = 300;
const LOCK_TTL_MS = 5000;
const WAIT_POLL_MS = 50;

async function getCachedProfile(key: string) {
  const raw = await redis.get(key);
  if (!raw) return null;
  return JSON.parse(raw);
}

async function setCachedProfile(key: string, value: any) {
  await redis.set(key, JSON.stringify(value), { EX: CACHE_TTL_SECONDS });
}

async function acquireLock(lockKey: string, token: string) {
  // SET key value NX PX ttl
  const res = await redis.set(lockKey, token, { NX: true, PX: LOCK_TTL_MS });
  return res === "OK";
}

async function releaseLock(lockKey: string, token: string) {
  // Снять lock безопасно через Lua, проверив токен
  const lua = `
    if redis.call("get", KEYS[1]) == ARGV[1] then
      return redis.call("del", KEYS[1])
    else
      return 0
    end
  `;
  await redis.eval(lua, { keys: [lockKey], arguments: [token] });
}
Handler чтения с дедупликацией
function sleep(ms: number) {
  return new Promise(resolve => setTimeout(resolve, ms));
}

async function waitForCache(key: string, timeoutMs: number) {
  const start = Date.now();
  while (Date.now() - start < timeoutMs) {
    const cached = await getCachedProfile(key);
    if (cached) return cached;
    await sleep(WAIT_POLL_MS);
  }
  return null;
}

async function computeProfileFromDB(userId: string) {
  // имитация дорогого вычисления
  await sleep(200);
  return { userId, name: "Alice", updatedAt: Date.now() };
}

export async function getProfile(userId: string) {
  // Предположим, version берётся из источника/метаданных
  const version = await redis.get(`profile_version:${userId}`) ?? "1";
  const cacheKey = `profile:${userId}:v${version}`;

  const cached = await getCachedProfile(cacheKey);
  if (cached) return cached;

  // Дедупликация: один вычислитель на ключ
  const lockKey = `lock:profile:${userId}:v${version}`;
  const token = `${process.pid}:${Date.now()}:${Math.random()}`;

  const hasLock = await acquireLock(lockKey, token);

  if (hasLock) {
    try {
      // Делаем реальную работу
      const value = await computeProfileFromDB(userId);
      await setCachedProfile(cacheKey, value);
      return value;
    } finally {
      await releaseLock(lockKey, token);
    }
  } else {
    // Другие запросы ждут, когда первый заполнит кэш
    const value = await waitForCache(cacheKey, 3000);
    if (value) return value;

    // Если таймаут — можно решать по стратегии:
    // 1) снова попытаться,
    // 2) один раз сделать вычисление,
    // 3) вернуть ошибку/статус.
    // Здесь — ещё одна попытка чтения напрямую (осторожно!)
    const fallback = await computeProfileFromDB(userId);
    await setCachedProfile(cacheKey, fallback);
    return fallback;
  }
}
Почему это работает
- В момент промаха только один инстанс держит lock.
- Остальные не стучат в БД — они ждут заполнения кэша.
- TTL lock ограничивает зависшие вычисления.
5.3. Ограничения и улучшения
- Lock TTL должен покрывать worst-case время вычисления плюс запас. Иначе вы получите ситуацию, когда второй инстанс тоже начнёт вычисление.
- Поллинг (waitForCache) может добавить нагрузку. Более изящно — использовать Pub/Sub/Streams: первый вычислитель публикует событие, остальные ждут.
- Пустые значения. Если профиль отсутствует, лучше кэшировать “not found” с коротким TTL, иначе шторм при повторяющихся запросах на несуществующий ключ гарантирован.
6. Комбинации write-through/write-back с дедупликацией
Теперь свяжем стратегии записи с тем, как инвалидация и дедупликация влияют на поведение.
6.1. Write-through + дедупликация: меньше промахов, но lock всё равно нужен
Если при обновлении вы синхронно обновляете кэш, то промахов меньше. Однако промахи всё равно бывают:
- ключи впервые запрашиваются после деплоя,
- инвалидация отработала,
- сбой кэша/сети потерял запись,
- истёк TTL.
Значит single-flight остаётся полезным, просто реже включается.
6.2. Write-back + дедупликация: критически важно
При write-back вы сознательно позволяете кэшу быть устаревшим на коротком интервале. Если вы делаете инвалидацию через delete, то после инвалидации кэш гарантированно промахнётся и будет нужен single-flight, чтобы не устроить лавину на БД.
Версионирование может снизить число промахов (старую версию можно держать, пока новая не соберётся), но при первом запросе на новую версию всё равно будет промах.
6.3. Инвалидация как триггер штормов
Есть распространённая ошибка: вы удаляете много ключей разом (например, “очистим профиль пользователя во всех местах”). В момент массового удаления кэш станет пустым, и дедупликация по одному ключу не спасёт, если у вас миллион уникальных ключей одновременно.
Тут помогают:
- плавные обновления (batching, rate limiting инвалидации),
- версионирование вместо массового delete,
- pre-warm горячих ключей (иногда),
- корректный TTL: не синхронизировать экспирацию на одну секунду.
7. Подводные камни инвалидации и дедупликации
7.1. Неправильный порядок действий при обновлении
Если вы обновляете источник и затем удаляете кэш, но без гарантии, что запись в БД стала видна, то читатели могут:
- увидеть старое значение (если кэш ещё не удалён),
- или попасть в промах и загрузить старые данные (если кэш-вычисление читает из источника, который в процессе обновления ещё не завершён).
Решения:
- версионирование: кэш-ключ соответствует версии данных,
- транзакционная схема, где версия меняется атомарно с данными,
- outbox pattern + фоновой публикацией событий.
7.2. “Слепая” дедупликация без учёта версии
Если вы дедуплицируете по userId, но версия могла смениться, то второй поток может ждать вычисления для старой версии и затем записать её обратно в кэш (если ключ одинаковый по логике). Важно, чтобы lock и кэш-ключ включали версию/инвалидационный маркер.
Правило: координация вычислений должна быть привязана к точной цели кэша, а не к абстрактному “профиль пользователя”.
7.3. Кэширование ошибок
Если вычисление падает (ошибка БД), лучше не кэшировать “ошибку навсегда”, но полезно:
- быстро отвечать одинаковой ошибкой всем ожидающим,
- кэшировать временный “fallback” или “circuit breaker” на короткий срок,
- чтобы избежать повторного шторма, пока источник не восстановился.
7.4. TTL и “края” событий
Если TTL равен 300 секунд и вы удаляете ключи вручную, моменты протухания могут совпасть. Типичная техника — jitter: слегка рандомизировать TTL, чтобы экспирации распределялись.
Например: EX = baseTTL * (0.9 + random*0.2). Для больших систем это существенно снижает вероятность одновременного промаха.
8. Набор практических решений (checklist)
Ни