CI-подход для новичков: настройка тестов и проверок качества на GitHub Actions, чтобы всё проходило стабильно
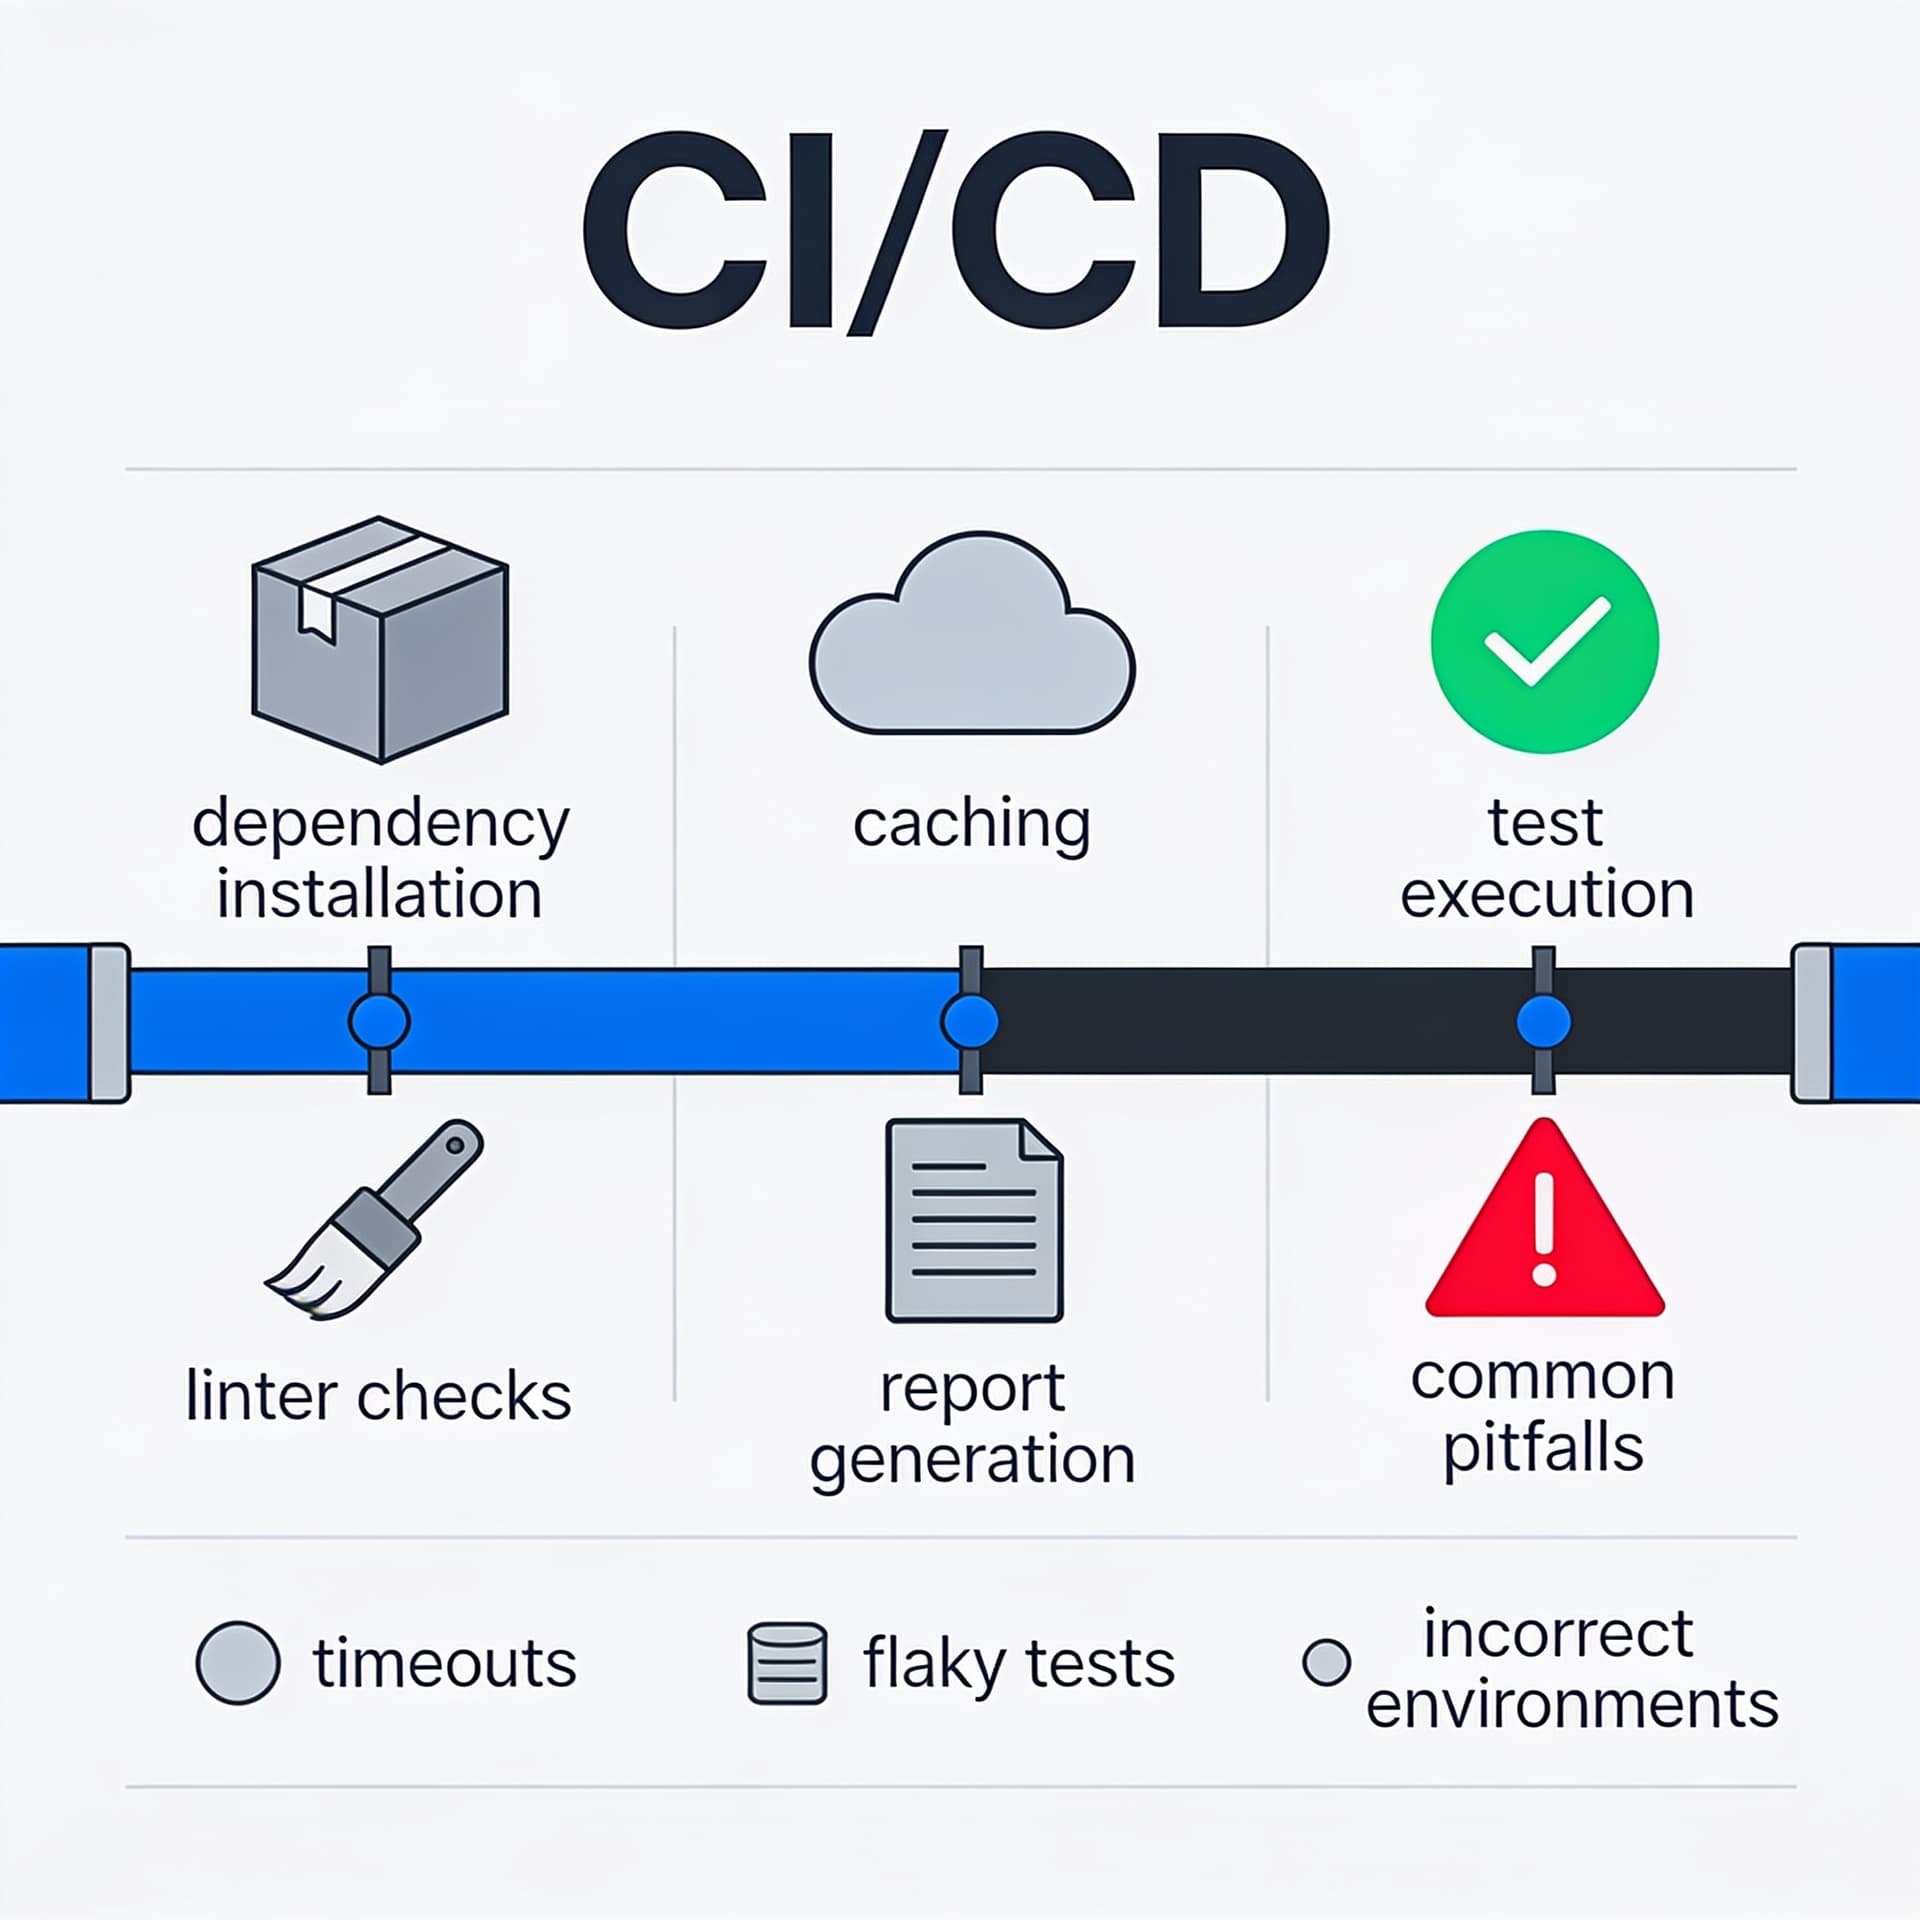
Соберём понятный пайплайн: установка зависимостей, кэш, прогон тестов, линтеров и отчётов, плюс типовые грабли (таймауты, флаки-тесты, неверные окружения). Будет шаблонный план, который легко применить к любому проекту.
Содержание
CI (Continuous Integration) — это автоматизация проверки кода при каждом коммите или PR. Для новичка CI часто выглядит как набор магии: “добавил workflow — и всё заработало”. На практике стабильный CI — это инженерная дисциплина: правильно собирать окружение, ускорять прогон, делать отчёты читаемыми и избегать флаки (random-fail тестов) и таймаутов, которые превращают рабочий инструмент в источник хаоса.
Ниже — пошаговый, “прикладной” план CI-пайплайна на GitHub Actions для типичного проекта (Python/Node/другие экосистемы можно подстроить). Мы разберём:
- как настроить workflow под PR и коммиты;
- как организовать установку зависимостей и кэширование;
- как прогонять тесты, линтеры и статический анализ;
- как собирать артефакты и отчёты;
- типовые грабли и способы сделать проверки стабильными;
- шаблонный план, который легко перенести на любой репозиторий.
В конце — несколько рекомендаций, как углубиться в CI/CD без лишней теории. В частности, полезно посмотреть курс «CI-CD от теории до практики», если хочется системно собрать картину: как из “проверок на PR” получается продакшн-процесс.
Почему CI “ломается” — и что нужно стабилизировать
Большинство проблем со стабильностью CI делятся на категории:
-
Неповторяемое окружение
Сегодня тесты проходят из‑за “случайных” глобальных зависимостей или локальных файлов, а в CI — падают. Причина: нет фиксации версий, нет нормальной загрузки зависимостей, разные OS/версии runtime. -
Нестабильные тесты (флаки-тесты)
Тесты зависят от времени, сети, порядка выполнения, ресурсоёмкости, параллелизма или гонок. Результат: иногда всё зелёное, иногда красное. -
Слишком строгие или неправильно настроенные ожидания
Линтеры/форматтеры запускаются в режиме, отличном от локального. Или тесты предполагают “идеальную” конфигурацию, которую CI не выставляет. -
Таймауты и ограничения ресурсов
GitHub Actions даёт лимиты по времени/памяти, и если пайплайн “тяжёлый” или плохо кэширован — всё может не успевать. -
Слабая диагностика
Когда тесты падают, разработчик не понимает причину: нет логов, нет отчётов, артефакты не публикуются. Падает “красиво”, но бесполезно.
CI нужно строить как систему: воспроизводимость + предсказуемость + скорость + качество диагностики.
Базовый каркас workflow на GitHub Actions
Начнём с общей идеи. У вас будет один workflow (или несколько), который:
- срабатывает на
pull_request(и при необходимости наpush); - ставит зависимости;
- запускает тесты;
- запускает линтеры/форматтеры;
- сохраняет отчёты (хотя бы логи и, по возможности, JUnit/coverage).
Рекомендуемая структура
Рекомендуемая практика для новичков: один YAML — один “слой” проверок. Внутри можно делать несколько job’ов, но начните с одного, чтобы быстро получить результат.
Например, файл:
.github/workflows/ci.yml
Ниже — шаблон “скелета” (универсальный подход, под конкретную технологию ниже добавим детали).
name: CI

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

jobs:
  quality:
    runs-on: ubuntu-latest
    timeout-minutes: 20

    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Set up runtime
        # Например: setup-python или setup-node
        uses: actions/setup-python@v5
        with:
          python-version: "3.12"

      - name: Install dependencies
        run: |
          echo "Install step goes here"

      - name: Run tests
        run: |
          echo "Run tests step goes here"

      - name: Run linters / format checks
        run: |
          echo "Run linters step goes here"
Ключевые моменты:
timeout-minutes— чтобы не зависнуть “навсегда”. Но лучше сначала измерить реальные времена, иначе можно случайно отсечь корректную сборку.permissions: contents: read— минимизируйте права.runs-on: ubuntu-latest— стабильно (хотя “latest” может обновляться; если нужна максимальная воспроизводимость — закрепляйте версию образа, напримерubuntu-22.04).
Установка зависимостей и кэш: как ускорять без риска
Один из главных практических способов ускорить CI — кэширование зависимостей. Но важно кэшировать правильно: “вкусный” кэш может стать источником флаки, если ключ не соответствует состоянию lockfile.
Общая логика кэш-ключа
Кэш должен зависеть от того, что меняется вместе с зависимостями:
- для Python:
requirements*.txtи/илиpoetry.lock/Pipfile.lock; - для Node:
package-lock.json/yarn.lock/pnpm-lock.yaml+ версия node; - для других экосистем — их lockfile аналогично.
Принцип: если lockfile меняется — кэш не должен “подхватить старьё”.
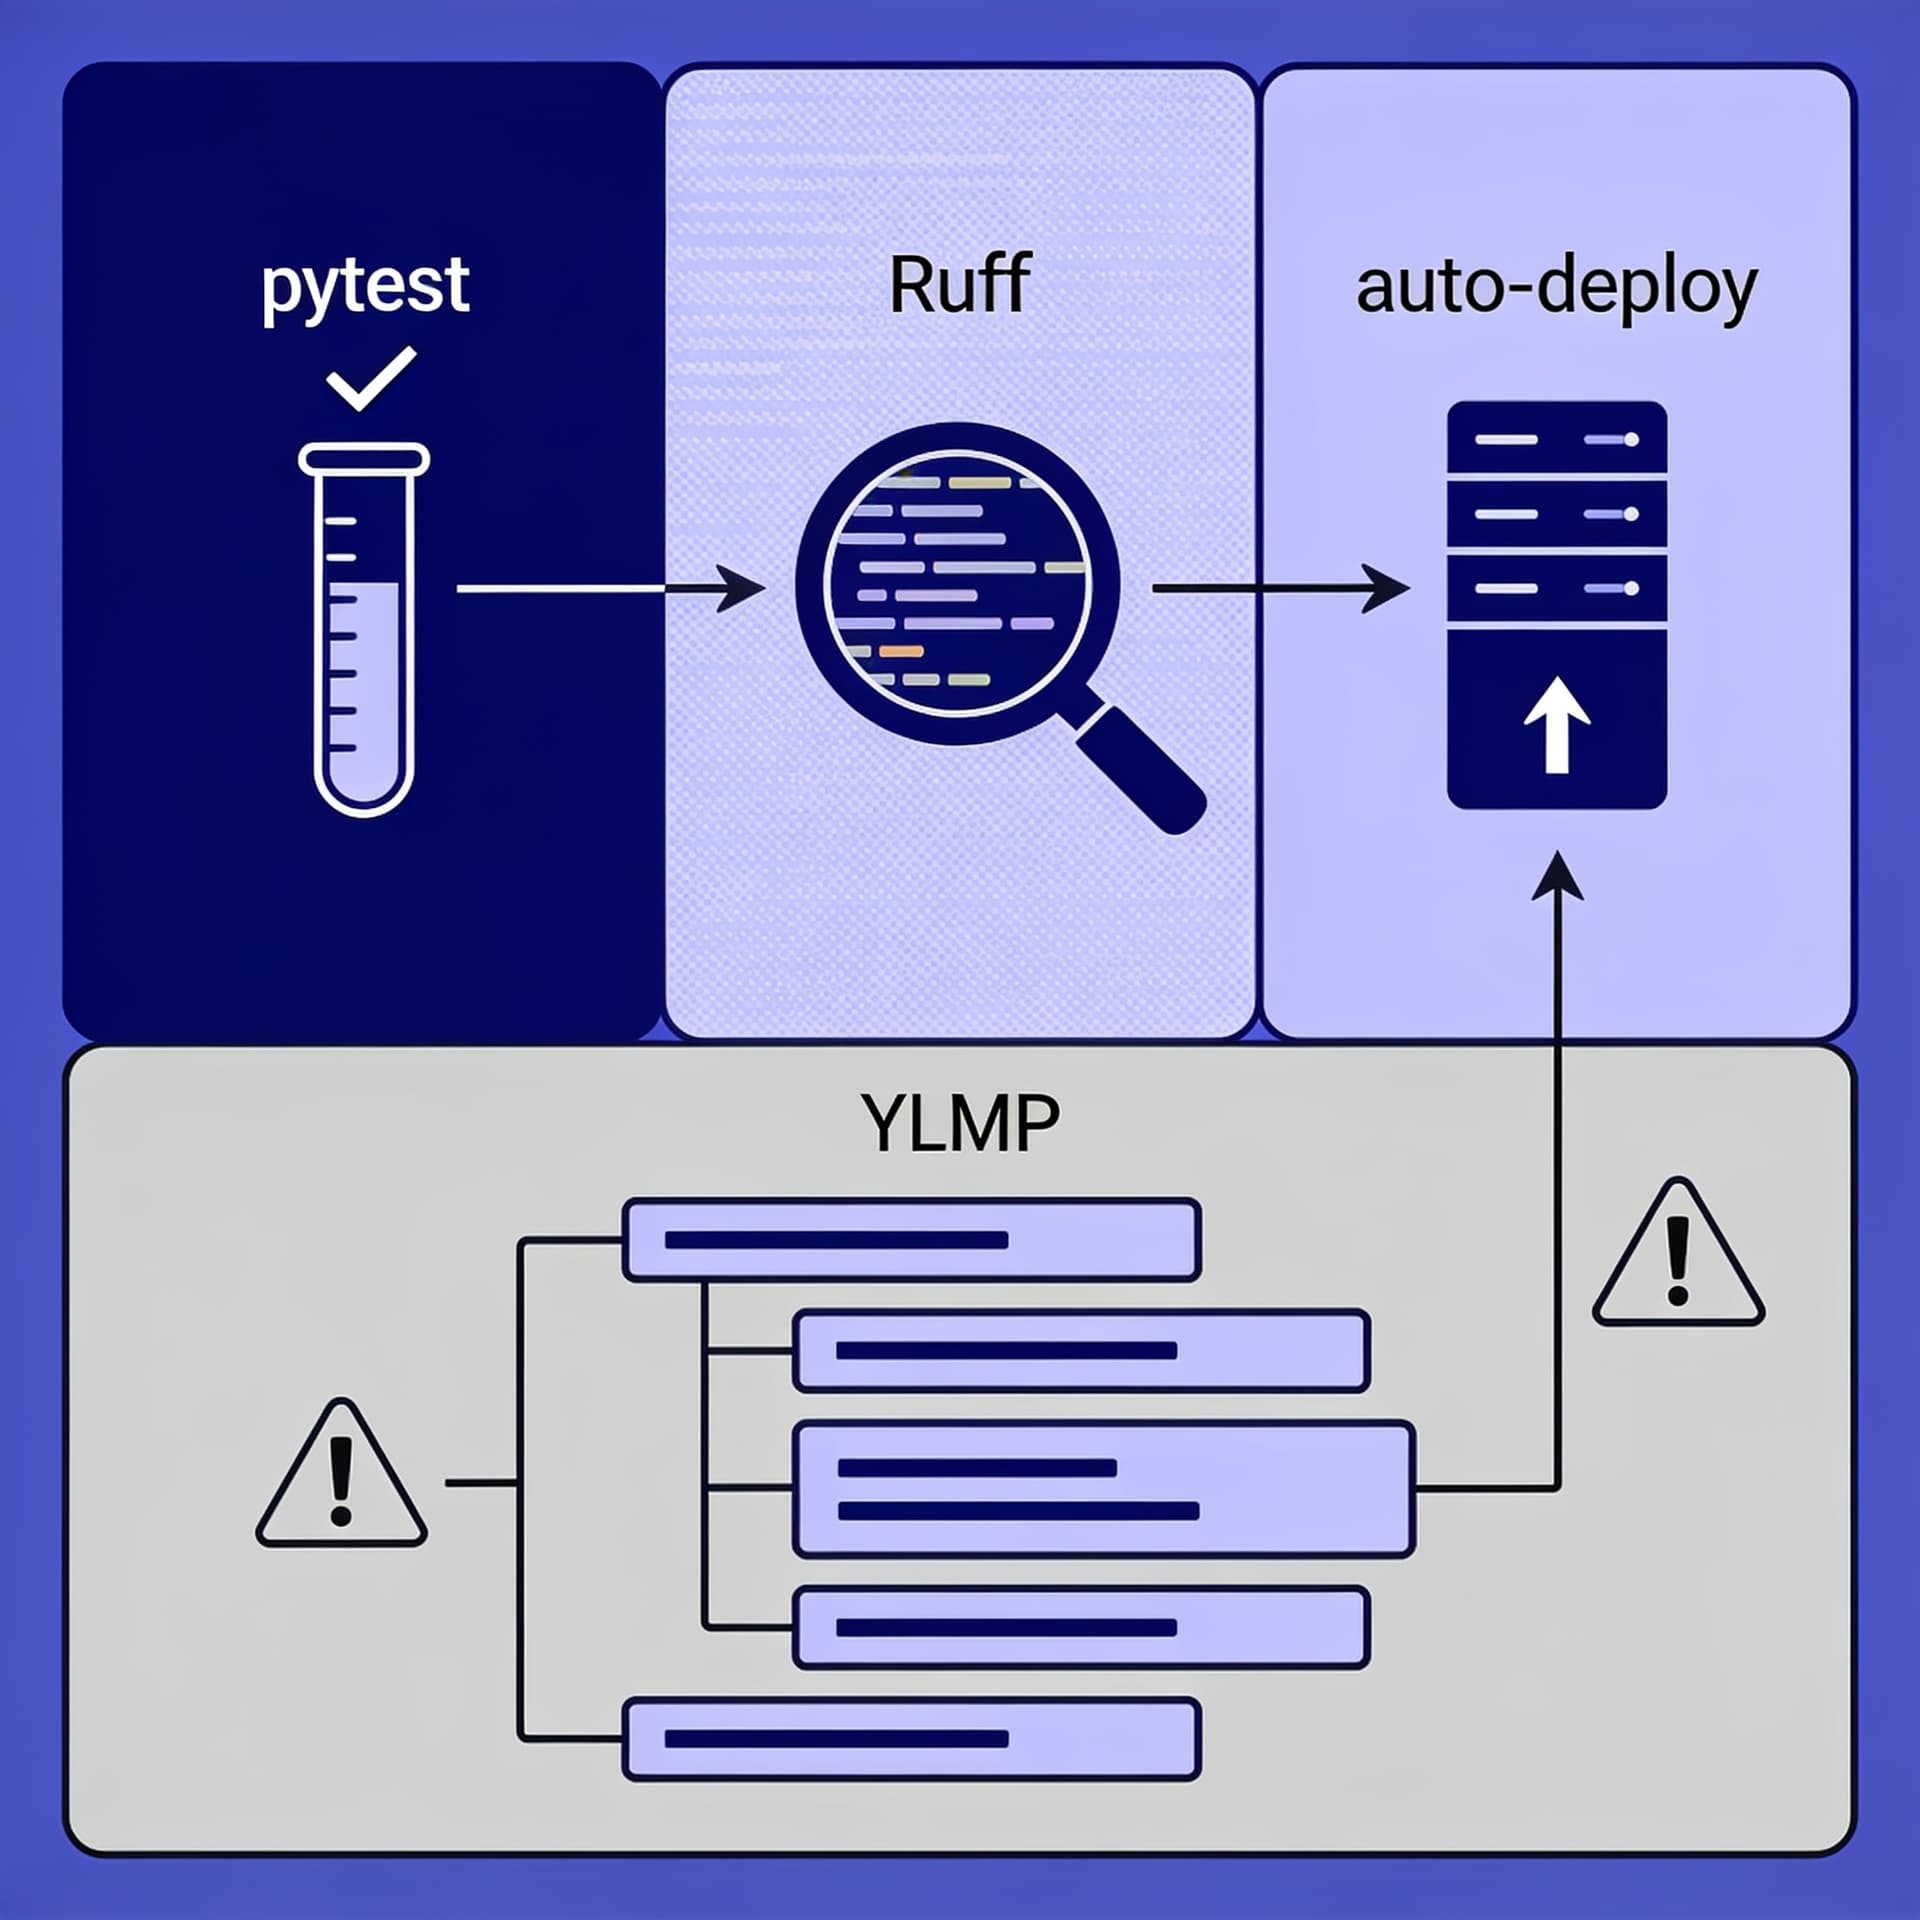
Пример: CI для Python (pytest + линтеры + coverage)
Давайте соберём рабочий пайплайн для типичного Python-проекта:
- установка через
pipилиpoetry; - прогон
pytestс отчётомJUnit XMLи coverage; - формат/линтер:
ruff(часто удобнее, чем “зоопарк” из flake8/black/isort, но можно заменить); - публикация артефактов отчётов.
Установка: pip + requirements.txt (с кэшем)
Предположим, у вас:
requirements.txtилиrequirements-dev.txt;- тесты в
tests/; pytest.iniнастроен под--junitxmlи/или coverage.
Workflow:
.github/workflows/ci.yml
name: CI

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

jobs:
  test-and-quality:
    runs-on: ubuntu-22.04
    timeout-minutes: 20

    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Set up Python
        uses: actions/setup-python@v5
        with:
          python-version: "3.12"

      - name: Cache pip
        uses: actions/cache@v4
        with:
          path: |
            ~/.cache/pip
          key: ${{ runner.os }}-pip-${{ hashFiles('**/requirements*.txt') }}
          restore-keys: |
            ${{ runner.os }}-pip-

      - name: Install dependencies
        run: |
          python -m pip install --upgrade pip
          pip install -r requirements.txt
          # Если есть dev-зависимости отдельно:
          if [ -f requirements-dev.txt ]; then pip install -r requirements-dev.txt; fi

      - name: Run tests (pytest) with JUnit + coverage
        run: |
          pytest \
            --junitxml=reports/junit.xml \
            --cov=. \
            --cov-report=xml:reports/coverage.xml \
            --cov-report=term-missing
        env:
          # Часто полезно зафиксировать часовой пояс и переменные окружения
          TZ: UTC

      - name: Run linters (ruff)
        run: |
          # Проверка форматирования/стиля
          ruff check .
          # Проверка, что код соответствует форматированию (если используете ruff format)
          ruff format --check .

      - name: Upload test reports
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: reports
          path: |
            reports/
          retention-days: 7
Что здесь важно
hashFiles('**/requirements*.txt')— кэш привязан к зависимостям.if: always()у upload — даже при падении тестов отчёты сохранятся. Это сильно ускоряет расследование.TZ: UTC— иногда помогает, если у вас тесты зависят от времени/таймзоны. Это простой шаг к уменьшению флаки.
Частая проблема: “pytest падает только в CI”
Если тесты флаки — сначала выключите параллелизм (если он используется) и соберите максимум артефактов. Затем добавьте воспроизводимость.
Например, если тесты используют внешние сервисы, в CI нужно:
- либо использовать локальные заглушки,
- либо явно поднимать контейнеры (docker compose) или mock,
- либо фиксировать режим (например,
USE_MOCKS=true).
Пример: CI для Node.js (npm/yarn/pnpm + jest + ESLint)
Для Node тоже есть устойчивый шаблон. Допустим, вы используете package-lock.json и npm, тесты — jest, линтер — eslint.
name: CI

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

jobs:
  test-and-quality:
    runs-on: ubuntu-22.04
    timeout-minutes: 25

    steps:
      - name: Checkout
        uses: actions/checkout@v4

      - name: Set up Node
        uses: actions/setup-node@v4
        with:
          node-version: "20"
          cache: "npm"
          cache-dependency-path: package-lock.json

      - name: Install dependencies
        run: npm ci

      - name: Run tests (Jest)
        run: |
          mkdir -p reports
          npm test -- --ci --reporters=default --reporters=jest-junit
        env:
          JEST_JUNIT_OUTPUT: reports/junit.xml
          # Пример фиксации времени/окружения:
          TZ: UTC

      - name: Lint (ESLint)
        run: npm run lint

      - name: Upload reports
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: reports
          path: reports/
          retention-days: 7
Заметьте: npm ci предпочтительнее npm install для повторяемости. npm ci строго следует lockfile.
Отчёты: зачем они новичкам и как сделать их “доступными”
Линтеры и тесты — это хорошо, но без артефактов расследование превращается в “угадайку”.
Минимальный набор, который почти всегда полезен:
junit.xmlдля тестов (пусть даже вы не подключаете визуализацию в UI — артефакты можно скачать и открыть).- coverage в XML (если вы используете сервисы для coverage или хотите отправлять в отчёты локально).
- логи линтера (обычно они печатаются в stdout, но можно добавить
--output-file).
GitHub UI по артефактам не всегда удобен для мгновенного просмотра, но скачать и посмотреть — легко. А главное — вы получаете доказательства, что именно происходило в конкретном прогоне.
Параллельные job’ы и матрицы: быстрее, но осторожно
Когда проверки набирают объём, один job начинает “тащить всё”. Тогда имеет смысл разделить:
tests— прогон тестов;lint— линтеры;typecheck— статическая типизация (TypeScript/mypy);security— SCA/сканирование зависимостей (опционально).
Пример разбиения (концептуально):
jobs:
  tests:
    runs-on: ubuntu-22.04
    steps: [...]
  lint:
    runs-on: ubuntu-22.04
    steps: [...]
Важно: параллельные job’ы ускоряют, но увеличивают суммарную стоимость минут/ресурсов. Новичкам полезно начать с одного job’а, а потом разнести по мере роста.
Матрица версий (например, Python 3.10/3.11/3.12) — полезно, но она может усилить флаки и усложнить диагностику. Делайте матрицу только тогда, когда есть реальная необходимость поддерживать несколько runtime-версий.
Типовые грабли: таймауты, флаки, неверные окружения
Ниже — самые частые причины “CI работает у всех, но у меня нет” и практические способы борьбы.
Грабель #1: зависимость от сетевых ресурсов
Если тесты ходят в интернет, CI может падать из‑за:
- временной недоступности сети;
- ограничения запросов;
- нестабильности внешнего API.
Решение:
- mock на уровне приложения;
- фикстуры данных вместо live-запросов;
- отключение интеграционных тестов “по умолчанию” и отдельный job для них.
Пример переключателя окружения:
pytest -m "not integration"
# или
pytest -m "integration" --run-integration
Грабель #2: “время” и “таймзоны” в тестах
Случаи: тесты сравнивают даты, зависят от datetime.now() без фиксации. В локальной среде у вас может быть другая TZ.
Решение:
- фиксировать TZ в CI (
TZ: UTC); - в тестах использовать time-freezing (в Python —
freezegun, в JS — аналогичные библиотеки); - избегать “точных” проверок миллисекунд.
Грабель #3: порядок тестов и параллелизм
Некоторые тесты могут менять глобальные состояния (файлы, переменные окружения, singleton’ы). При параллельном запуске они начинают конфликтовать.
Решение:
- минимизировать глобальные состояния;
- изолировать временные файлы (в Python —
tmp_path, в Jest —--runInBandпри диагностике); - включать параллельность только после того, как тесты перестанут “флакать”.
Грабель #4: кэш, который “вредит”
Если ключ кэша слишком общий (например, только npm-cache) — можно получить ситуацию: зависимости соответствуют старому lockfile.
Решение:
- включайте lockfile в ключ (как минимум
hashFiles('package-lock.json')или используйте built-in cache как вsetup-node cache: "npm"). - не кэшируйте то, что зависит от окружения без учёта (например, сборки с различными архитектурами/версией компилятора).
Грабель #5: отсутствие “готовности” сервисов (DB/Redis)
Если тесты используют БД/очереди, нужно поднимать их. GitHub Actions умеет service containers.
Пример для PostgreSQL (концептуально):
services:
  postgres:
    image: postgres:16
    env:
      POSTGRES_PASSWORD: postgres
      POSTGRES_USER: postgres
      POSTGRES_DB: test
    ports:
      - 5432:5432
    options: >-
      --health-cmd "pg_isready -U postgres"
      --health-interval 10s
      --health-timeout 5s
      --health-retries 5
Но даже с сервисами важна и настройка подключения в тестах: host обычно localhost для job-контейнера, но иногда логика зависит от network mode.
Грабель #6: таймауты из-за медленных тестов
Типичный симптом: тесты вроде “нормальные”, но иногда упираются в лимит минут.
Решение по шагам:
- Добавьте замер времени: в логах видно, где именно “тормозит”.
- Ускорьте зависимости (кэш).
- Уберите лишние линтеры или перенесите тяжёлые шаги в отдельный workflow “nightly”.
- Уменьшите объём прогонов: smoke-тесты на PR, полный прогон — по расписанию или при релизе.
Практический шаблон: как перенести на любой проект
Если вы хотите универсальный план, держите “чеклист”, который подойдёт почти для любого языка:
Шаг 1. Определите, что именно должно быть зелёным на PR
Обычно минимум:
- тесты (unit + базовые интеграционные, если они быстрые и стабильные);
- линтер/форматтер (чтобы PR не превращался в “код не по стилю”);
- при наличии — статическая проверка типов.
Шаг 2. Зафиксируйте окружение
- конкретная версия runtime (Python/Node и т.п.);
- lockfile для зависимостей и установка через “строгую” команду (
pip install -r+ pinned,npm ci,poetry install --no-rootи т.д.); - минимизируйте “магические” системные зависимости.
Шаг 3. Сделайте кэш осмысленным
- ключ кэша должен зависеть от lockfile;
- кэшировать имеет смысл:
- скачивание пакетов,
- иногда каталоги сборки (но осторожно с совместимостью).
Шаг 4. Добавьте отчёты и артефакты
junit.xmlдля тестов;- coverage (XML или HTML, хотя HTML обычно артефактами);
- в случае падений — всегда upload артефактов.
Шаг 5. Обработайте флаки как инженерную проблему
- уберите внешние зависимости;
- фиксируйте время/окружение;
- изолируйте тесты от глобального состояния;
- добавьте диагностические артефакты (логи, дампы при падении).
Шаг 6. Включите “разумную” скорость
- параллелите job’ы только когда это нужно;
- тяжёлые шаги выносите в отдельный workflow (например, security scan/nightly).
Небольшая, но важная деталь: статусы и правила слияния
Чтобы CI реально помогал, лучше включить branch protection rules в репозитории:
- требовать успешного прохождения workflow для
main; - ограничить возможность мержа без зелёных проверок;
- при необходимости — настроить линт/тесты как обязательные для PR.
Это организационный слой, но он напрямую влияет на стабильность: иначе CI становится “просто отчётом”, который никто не воспринимает всерьёз.
Вывод: стабильный CI — это про воспроизводимость и диагностику
Хороший CI-пайплайн для новичка — это не “сложная конфигурация”, а дисциплина: контролируемое окружение, корректный кэш, понятные проверки и отчёты, плюс системная работа с флаки и таймаутами. Если CI часто “краснеет без причины”, проблема почти всегда в воспроизводимости или зависимости от внешних факторов. Начинайте с простого шаблона, добавляйте шаги постепенно и обязательно сохраняйте артефакты, чтобы расследование занимало минуты, а не часы.
Если хотите углубиться в CI/CD не только как набор YAML-команд, а как целостный инженерный процесс (от теории до практики пайплайнов, окружений и релизов), можно посмотреть программу «CI-CD от теории до практики» — это удобный следующий шаг после того, как вы собрали базовый пайплайн и упёрлись в более “системные” вопросы.