FastAPI под нагрузкой: как проектировать фоновые задачи, idempotency key и ретраи для внешних интеграций
Соберём рабочий шаблон для интеграций: очередь vs BackgroundTasks, как хранить состояние задачи, как избежать дублей через идемпотентность и как правильно строить ретраи с ограничением по попыткам. Статья ориентирована на продакшн и наблюдаемость результа
Содержание
В продакшене FastAPI рано или поздно упирается не в скорость обработчика HTTP, а в архитектуру интеграций: как надежно дергать внешние системы, как переживать таймауты и частичные отказы, как избегать дублей и как при этом сохранять наблюдаемость. Три типовые проблемы всплывают почти в каждом проекте:
- Фоновые задачи нужно выполнять вне запроса, но так, чтобы они не “потерялись” при перезапуске процесса.
- Повторы запросов (из‑за ретраев клиента, сетевых глюков, конкуренции экземпляров) часто приводят к дубликатам во внешних системах.
- Ретраи без дисциплины превращаются в ураган: слишком часто, слишком долго, без ограничений и без явного “гаранта” остановки.
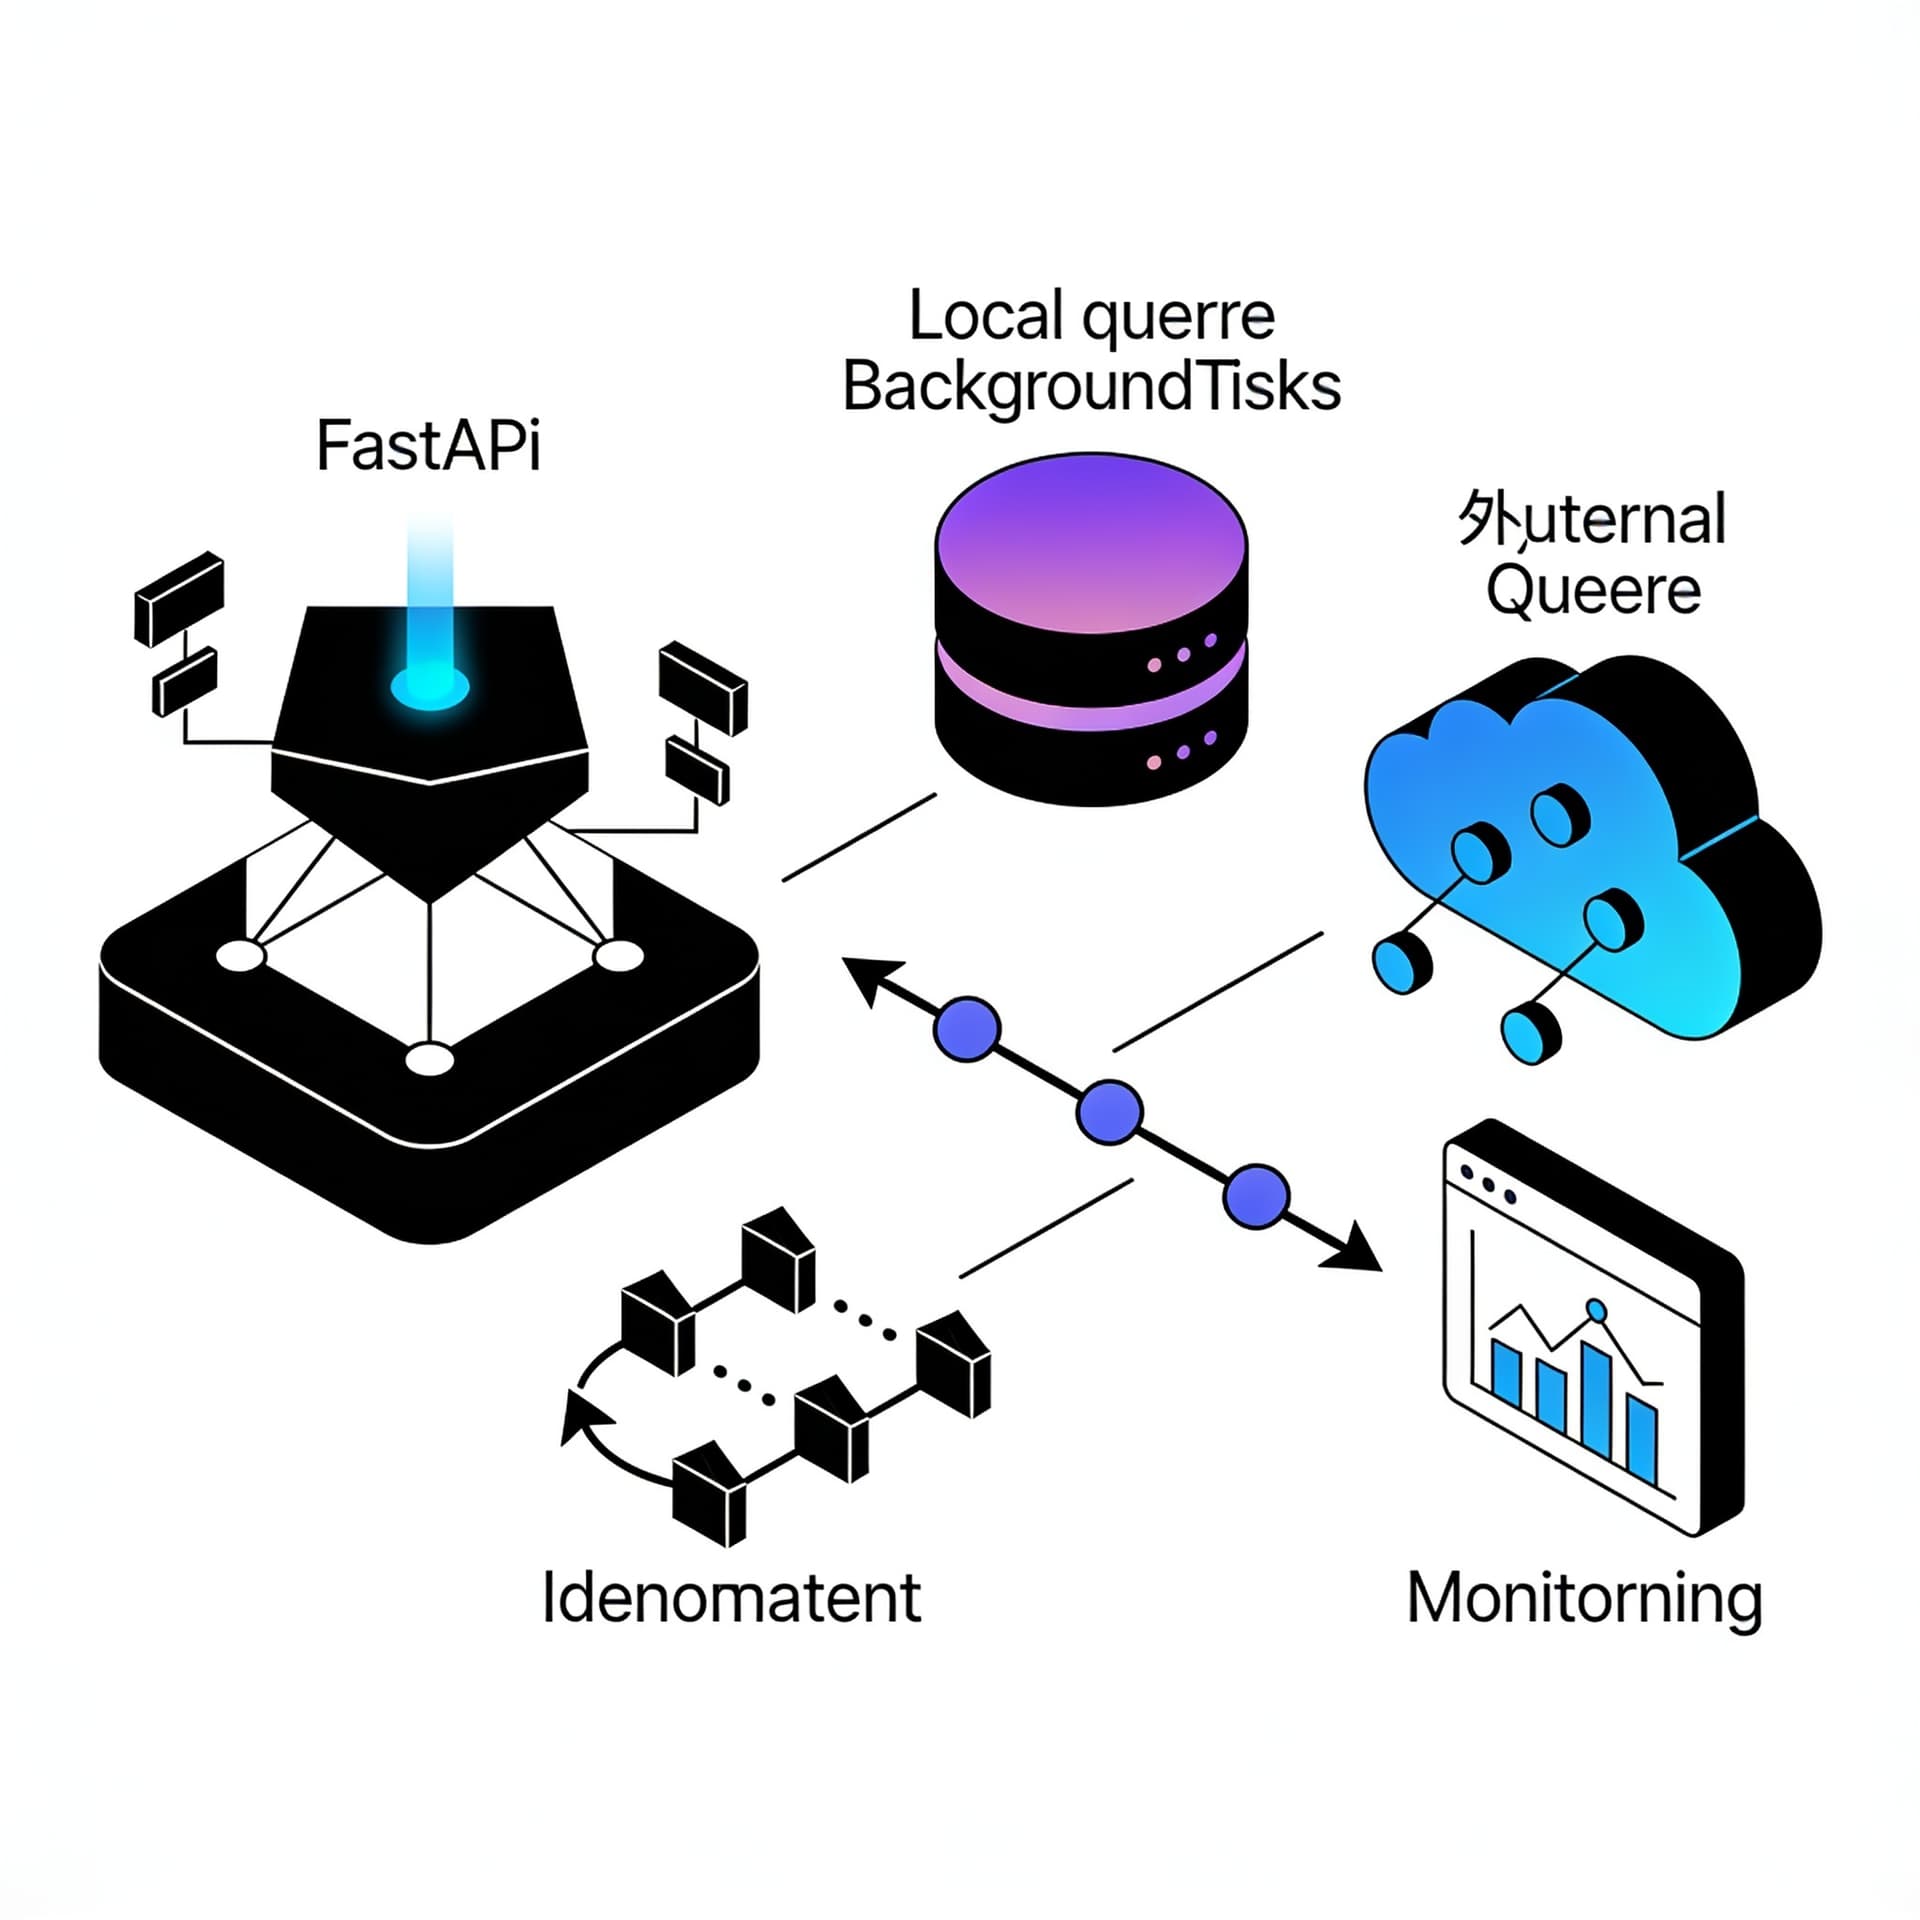
Ниже соберу рабочий шаблон, ориентированный на продакшн: сравним очередь vs FastAPI BackgroundTasks, покажем как хранить состояние задачи, как реализовать idempotency key, и как строить ретраи с ограничением по попыткам так, чтобы это было управляемо и наблюдаемо.
Почему BackgroundTasks часто недостаточно
FastAPI предоставляет BackgroundTasks, чтобы выполнить функцию после отправки HTTP‑ответа. Для простых задач (уведомление по e‑mail, запись в аналитическую таблицу) этого хватает. Но в нагрузке и при сбоях проявляются ограничения:
- Нет устойчивости к рестартам процесса. Если worker перезапустили, фоновые задачи исчезают (они живут в памяти процесса).
- Сложно обеспечить доставку “ровно один раз”. Если обработчик вернул
200, а фоновой задачe не дали завершиться — вы получаете расхождение между “считали, что сделали” и реальным состоянием. - Ретраи становятся хаотичными. Повторять можно, но без централизованного механизма контроля прогресса и попыток легко уйти в неконтролируемую рекурсию.
- Наблюдаемость слабее. Можно логировать, но нет единого контура “задача №N в статусе succeeded/failed, с попытками k, с last_error”.
BackgroundTasks остаются удобными как быстрый мост (например, для постановки задачи в очередь), но в качестве core‑механизма для интеграций обычно проигрывают устойчивому фоновому исполнению через очередь.
Очередь: базовая модель для продакшна
В устойчивом варианте фоновая работа опирается на внешний компонент: очередь/лог/таск‑брокер (Redis Streams, RabbitMQ, Kafka) либо хотя бы на “табличную” очередь в БД. Логика повторяется во многих системах:
- HTTP‑эндпоинт принимает запрос.
- В БД регистрируется задача интеграции в статусе
pendingи связывается с idempotency key. - Задача ставится в очередь (опционально) или доступна исполнителю через периодический polling.
- Отдельный воркер забирает задачу, выполняет вызов внешней системы.
- Результат записывается в БД:
succeededилиfailed, сохраняются попытки и ошибка. - При необходимости планируется следующий ретрай с backoff.
Ключевая мысль: источник истины — БД (или другой персистентный журнал). Очередь — это транспорт для ускорения, а не “память о том, что делать”.
Шаблон данных: задача, попытки и идемпотентность
Чтобы “собрать пазл” правильно, удобно выделить минимум двух сущностей:
- idempotency table (или столбцы в задаче) — связывает входной ключ с результатом.
- integration_tasks — хранит состояние и прогресс исполнения.
Рассмотрим практичный вариант в PostgreSQL.
Таблица integration_tasks
Нужны поля:
id— внутренний идентификаторidempotency_key— ключ идемпотентностиidempotency_scope— чтобы один и тот же ключ не конфликтовал между разными типами операций (напримерpayment:create,webhook:deliver)status—pending | running | succeeded | failedattempts— сколько попыток уже сделаноmax_attempts— лимитnext_attempt_at— когда можно делать следующую попыткуexternal_request_id— идентификатор на стороне внешней системы (если есть)request_payload— сохраняем исходные данные (осторожно с PII)last_error— текст/код последней ошибкиcreated_at,updated_at
Таблица idempotency_results (опционально)
Иногда удобнее хранить результат отдельной таблицей, особенно если запросов много и payload тяжелый. Но для простоты можно объединить в integration_tasks.
Idempotency key: как именно его использовать
Idempotency key — это контракт: клиент гарантирует, что при повторной отправке с одинаковым ключом система должна вернуть тот же результат, а внешняя операция должна быть выполнена не более одного раза (в логическом смысле).
Важно:
- idempotency key обычно задают клиентом, но вы должны валидационно трактовать его:
- ключ должен быть непустым
- ограничить длину
- отличать операции по
idempotency_scope
- система должна быть устойчива к гонкам при параллельных запросах.
Самая частая ошибка: проверка “в памяти”
Если вы делаете SELECT и затем INSERT без уникального ограничения, при нагрузке два параллельных запроса могут оба не увидеть запись и оба создать задачи. Поэтому нужны:
- уникальный индекс на
(idempotency_scope, idempotency_key) - транзакционная логика “insert-on-conflict”
Уникальный индекс
Например:
- уникальность на
(scope, key)гарантирует, что на один идемпотентный запрос вы заведете максимум одну задачу.
Ретраи: дисциплина попыток и backoff
Ретраи должны удовлетворять трем условиям:
- Ограничение по попыткам (
max_attempts) — чтобы не зависнуть бесконечно. - Ограничение по частоте через
next_attempt_atи backoff — чтобы не устроить DDOS внешней системы. - Классификация ошибок — не все ошибки ретраить одинаково:
- ретраить: таймауты, временная недоступность (5xx), network errors
- не ретраить: 4xx ошибки, которые означают неверные данные (обычно 400, 401, 403, 422)
- частный случай: 429 — ретраить с учетом
Retry-After(если есть)
Переходим к коду: FastAPI + БД как источник истины
Ниже пример на основе asyncpg/SQLAlchemy не обязательно, поэтому покажу концептуально на SQL и псевдо-слое репозитория. Формат кода будет таким, чтобы его легко адаптировать.
API: прием запроса и постановка задачи
Предположим, клиент шлет Idempotency-Key в заголовке и JSON payload. Мы хотим:
- при новом ключе создать запись в БД со статусом
pending - при повторе вернуть текущий статус или уже итог
- не выполнять внешнюю интеграцию внутри HTTP‑запроса
Модель входа
from pydantic import BaseModel, Field
from uuid import UUID
from datetime import datetime

class CreateOrderPayload(BaseModel):
    customer_id: UUID
    currency: str = Field(min_length=3, max_length=3)
    amount: int
Схема ответа
class IdempotencyResponse(BaseModel):
    task_id: str
    status: str
    external_request_id: str | None = None
    detail: str | None = None
Эндпоинт
Ключевой момент — INSERT ... ON CONFLICT DO NOTHING/UPDATE и чтение результата. Мы можем использовать RETURNING чтобы избежать двойных запросов.
from fastapi import FastAPI, Header, HTTPException
from uuid import uuid4
from datetime import datetime, timedelta, timezone

app = FastAPI()

# Предположим, что есть async функция exec_db(query, params) и метод fetch_one.
# Для примера я опишу логику, а SQL вставлю прямо в код.

@app.post("/integrations/orders", response_model=IdempotencyResponse)
async def create_order_integration(
    payload: CreateOrderPayload,
    idempotency_key: str = Header(..., alias="Idempotency-Key"),
):
    scope = "order:create"

    if not idempotency_key or len(idempotency_key) > 200:
        raise HTTPException(status_code=400, detail="Invalid Idempotency-Key")

    # 1) Создаем задачу идемпотентно
    # Таблица: integration_tasks(scope, idempotency_key) уникальна.
    now = datetime.now(timezone.utc)
    max_attempts = 5

    insert_sql = """
    WITH new_task AS (
        INSERT INTO integration_tasks (
            id, idempotency_scope, idempotency_key,
            status, attempts, max_attempts,
            next_attempt_at, request_payload, created_at, updated_at
        )
        VALUES (
            gen_random_uuid(),
            $1, $2,
            'pending', 0, $3,
            $4, $5, $6, $6
        )
        ON CONFLICT (idempotency_scope, idempotency_key)
        DO NOTHING
        RETURNING id
    )
    SELECT id FROM new_task
    UNION ALL
    SELECT id FROM integration_tasks
    WHERE idempotency_scope = $1 AND idempotency_key = $2
    LIMIT 1;
    """

    # next_attempt_at сразу сейчас
    next_attempt_at = now
    task_id = await fetch_one(
        insert_sql,
        scope, idempotency_key, max_attempts, next_attempt_at, payload.model_dump_json(), now
    )

    # 2) Читаем текущий статус
    task = await fetch_one(
        """
        SELECT id, status, external_request_id, last_error
        FROM integration_tasks
        WHERE id = $1
        """,
        task_id
    )

    # 3) В реальном проекте на pending обычно ставим в очередь.
    # Но если используете polling, можно пропустить это.
    # Здесь: отправка события в очередь (условно).
    if task["status"] == "pending":
        await enqueue_task(str(task["id"]))

    return IdempotencyResponse(
        task_id=str(task["id"]),
        status=task["status"],
        external_request_id=task["external_request_id"],
        detail=task["last_error"],
    )
SQL-уникальность и DDL
Важно закрепить уникальность на уровне БД:
CREATE TABLE integration_tasks (
  id uuid PRIMARY KEY,
  idempotency_scope text NOT NULL,
  idempotency_key text NOT NULL,
  status text NOT NULL CHECK (status IN ('pending','running','succeeded','failed')),
  attempts int NOT NULL DEFAULT 0,
  max_attempts int NOT NULL DEFAULT 5,
  next_attempt_at timestamptz NOT NULL,
  external_request_id text,
  request_payload jsonb NOT NULL,
  last_error text,
  created_at timestamptz NOT NULL,
  updated_at timestamptz NOT NULL,
  UNIQUE (idempotency_scope, idempotency_key)
);
Очередь/воркер: как безопасно выполнять задачу и фиксировать статус
Теперь нужен воркер. Для простоты представим “исполнителя” как отдельный процесс, который:
- берет задачу в статусе
pendingс учетомnext_attempt_at - переводит ее в
runningатомарно - вызывает внешнюю систему
- записывает
succeededили планирует ретрай
Атомарный переход pending → running
Чтобы несколько воркеров не взяли одну и ту же задачу, используйте SELECT ... FOR UPDATE SKIP LOCKED или update‑проверки статуса.
Пример через UPDATE ... RETURNING (часто удобнее):
async def claim_task(batch_limit: int = 10):
    sql = """
    UPDATE integration_tasks
    SET status='running', updated_at=now()
    WHERE id = (
        SELECT id
        FROM integration_tasks
        WHERE status='pending'
          AND next_attempt_at <= now()
        ORDER BY created_at
        LIMIT 1
        FOR UPDATE SKIP LOCKED
    )
    RETURNING id, request_payload, attempts, max_attempts;
    """
    return await fetch_one(sql)
Вызов внешнего API и классификация ошибок
Ретраи должны учитывать тип ошибки. Условно:
TimeoutError,ConnectError,ReadTimeout→ ретрайHTTP 429/5xx→ ретрайHTTP 4xx(кроме 429) → failed без ретраев
Реализация ретрая: backoff и лимит попыток
Логика для задачи:
- Если задача неуспешна и
attempts < max_attempts, увеличиваем попытки, рассчитываемnext_attempt_atи оставляемpending. - Если
attempts == max_attempts, ставимfailed.
Расчет backoff
Практичный подход: экспоненциальный backoff с джиттером.
import random
from datetime import timedelta

def compute_backoff(attempt: int) -> timedelta:
    # attempt: 1..N
    base = 2  # секунды
    cap = 60  # максимум 60 сек
    exp = min(cap, base * (2 ** (attempt - 1)))
    jitter = random.uniform(0.5, 1.5)
    return timedelta(seconds=exp * jitter)
Полный цикл воркера (упрощенный, но рабочий по концепции)
import httpx
import json
from datetime import datetime, timezone

EXTERNAL_URL = "https://api.partner.example/v1/orders"

async def worker_loop():
    async with httpx.AsyncClient(timeout=10) as client:
        while True:
            task = await claim_task()
            if not task:
                await sleep(1)
                continue

            task_id = task["id"]
            payload = task["request_payload"]
            attempts = task["attempts"]
            max_attempts = task["max_attempts"]

            try:
                # Внешний вызов
                resp = await client.post(EXTERNAL_URL, json=payload)

                if resp.status_code in (200, 201):
                    data = resp.json()
                    external_request_id = data.get("id")

                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='succeeded',
                            external_request_id=$2,
                            last_error=NULL,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, external_request_id
                    )
                    continue

                if resp.status_code == 429 or 500 <= resp.status_code < 600:
                    # ретраим
                    raise RetriableHTTPError(resp.status_code, resp.text)

                # 4xx (кроме 429) не ретраим
                await exec_db(
                    """
                    UPDATE integration_tasks
                    SET status='failed',
                        last_error=$2,
                        updated_at=now()
                    WHERE id=$1
                    """,
                    task_id, f"Non-retriable HTTP {resp.status_code}: {resp.text}"
                )

            except RetriableHTTPError as e:
                attempts_next = attempts + 1
                if attempts_next >= max_attempts:
                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='failed',
                            last_error=$2,
                            attempts=$3,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, f"{e}", attempts_next
                    )
                else:
                    delay = compute_backoff(attempts_next)
                    next_at = datetime.now(timezone.utc) + delay

                    # Иногда полезно учитывать Retry-After из 429.
                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='pending',
                            attempts=$2,
                            next_attempt_at=$3,
                            last_error=$4,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, attempts_next, next_at, f"{e}"
                    )

            except (httpx.TimeoutException, httpx.TransportError) as e:
                # ретраим транспортные/таймаут ошибки
                attempts_next = attempts + 1
                if attempts_next >= max_attempts:
                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='failed',
                            last_error=$2,
                            attempts=$3,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, repr(e), attempts_next
                    )
                else:
                    delay = compute_backoff(attempts_next)
                    next_at = datetime.now(timezone.utc) + delay
                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='pending',
                            attempts=$2,
                            next_attempt_at=$3,
                            last_error=$4,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, attempts_next, next_at, repr(e)
                    )

            except Exception as e:
                # “неизвестные” ошибки: тоже лучше ретраить аккуратно,
                # но типологию можно расширить.
                attempts_next = attempts + 1
                if attempts_next >= max_attempts:
                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='failed',
                            last_error=$2,
                            attempts=$3,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, f"Unexpected: {repr(e)}", attempts_next
                    )
                else:
                    delay = compute_backoff(attempts_next)
                    next_at = datetime.now(timezone.utc) + delay
                    await exec_db(
                        """
                        UPDATE integration_tasks
                        SET status='pending',
                            attempts=$2,
                            next_attempt_at=$3,
                            last_error=$4,
                            updated_at=now()
                        WHERE id=$1
                        """,
                        task_id, attempts_next, next_at, f"Unexpected: {repr(e)}"
                    )

class RetriableHTTPError(Exception):
    pass

async def enqueue_task(task_id: str):
    # Заглушка: в реальном проекте отправляете в очередь/stream.
    return
Этот код — не “магия”, а дисциплина:
- status меняется явно
- attempts увеличиваются строго по событию
- backoff ограничивает скорость ретраев
- last_error сохраняет контекст для диагностики
Как избежать дублей во внешних системах: идемпотентность + внешний request id
Внешние системы часто поддерживают собственные идемпотентные механизмы (например, Idempotency-Key заголовок или Idempotency-Key в теле). Если внешняя API умеет “ровно один раз” — это сильно упрощает задачу.
Если внешняя система не поддерживает идемпотентность, у вас остаются варианты:
- Хранить внешние идентификаторы и повторять с ними.
Если внешний API возвращаетrequest_id, сохраняйте его и при ретраях старайтесь повторно обращаться к конкретной записи. - Использовать “dedup keys” на своей стороне и не вызывать внешнее более одного раза в логическом контуре.
Это решает часть “дублей” внутри вашей системы, но не защитит от ситуации “мы вызвали, но не сохранили успех из-за таймаута”. - Сценарное проектирование: при сетевых сбоях делайте “соглашение” — например, при ретраях используйте безопасный запрос статуса или “upsert” вместо create, если API это позволяет.
Надежный компромисс для продакшена: ваша идемпотентность (idempotency key) + сохранение внешнего request id + аккуратные ретраи.
Наблюдаемость: что логировать и как отлаживать
В интеграциях наблюдаемость важнее “красивого кода”. Минимальный набор:
idempotency_scope,idempotency_key— чтобы понять, почему задача была создана/не созданаtask_id— корреляция между API и воркером- статус:
pending/running/succeeded/failed - attempts, max_attempts, next_attempt_at
- last_error: код/сообщение и классификация (retriable/non-retriable)
- latency внешнего вызова
- trace-id (если используете OpenTelemetry)
Корреляция логов
В FastAPI полезно добавить middleware/зависимость, которая подхватывает task_id или idempotency_key и вставляет в контекст логирования. Для воркера — сериализуйте это в логи по task_id.
Очередь vs polling по БД: что выбрать
Вариант 1: очередь
Плюсы:
- меньше лишних запросов к БД
- быстрее старт воркера
Минусы:
- еще один компонент, надежность которого тоже надо поддерживать
- требуется согласование “сделали в БД/поставили в очередь”
Вариант 2: polling по БД
Плюсы:
- простая архитектура, меньше интеграций
- БД уже источник истины
Минусы:
- нужно подобрать интервал polling
- при высоких нагрузках надо тщательно оптимизировать запросы и индексы
На практике часто делают гибрид:
- API пишет в БД
- воркер забирает задачи через очередь (быстрее)
- но если очередь “тихо умерла”, БД-поллинг может быть аварийным режимом
Типичные подводные камни
-
Отсутствие уникального индекса по идемпотентности
Без него вы неизбежно получите дубликаты при конкурентных запросах. -
Слишком ранний
200клиенту при отсутствии фиксации состояния
Если вы ответили “успех”, но не записали состояние в БД какsucceeded, вы потеряете согласованность. -
Ретраи на ошибки данных (4xx)
Это превращает систему в генератор неуспехов и нагрузку на партнеров. -
Ретраи без backoff и без джиттера
При массовых сбоях вы получите “синхронный шторм”. -
Попытка сделать “ровно один раз” только в коде, без уровня БД
Сеть и перезапуски реальны. Нужны транзакции и персистентное состояние. -
Игнорирование идемпотентности внешнего API
Если партнер дает механизм идемпотентности — используйте его. Не усложняйте.
Практический чек-лист перед релизом
- Есть уникальный индекс для
(scope, key)в БД - API не выполняет внешнюю интеграцию в рамках HTTP‑запроса
- Воркер атомарно переводит
pending -> running - Есть
max_attempts,next_attempt_at, backoff - Ошибки классифицируются (retriable/non-retriable)
- Успех и провал фиксируются в БД с
updated_at,attemptsиlast_error - Логи/метрики содержат корреляцию по
task_idи/илиidempotency_key - Есть план, что делать с
failedзадачами (ручной replay, dead-letter очередь, алерты)
Вывод
FastAPI хорошо подходит как слой API, но надежные интеграции требуют системного подхода: фоновые задачи должны быть персистентными, состояние — хранимым, идемпотентность — зафиксированной на уровне БД, а ретраи — ограниченными и классифицированными. BackgroundTasks как “встроенный после ответа обработчик” удобны, но в сценариях с сетью и сбоями чаще всего лучше строить отдельный воркер и единый контур статуса.
Если вы хотите углубиться в детали проектирования фоновых процессов, надежности и наблюдаемости, полезным продолжением может стать разбор темы в рамках материала по /course/, где обычно рассматривают архитектурные паттерны для продакшн‑интеграций и практики для снижения риска дублей и потерь задач.