GIL в CPython: почему многопоточность не всегда ускоряет ваш Python-код
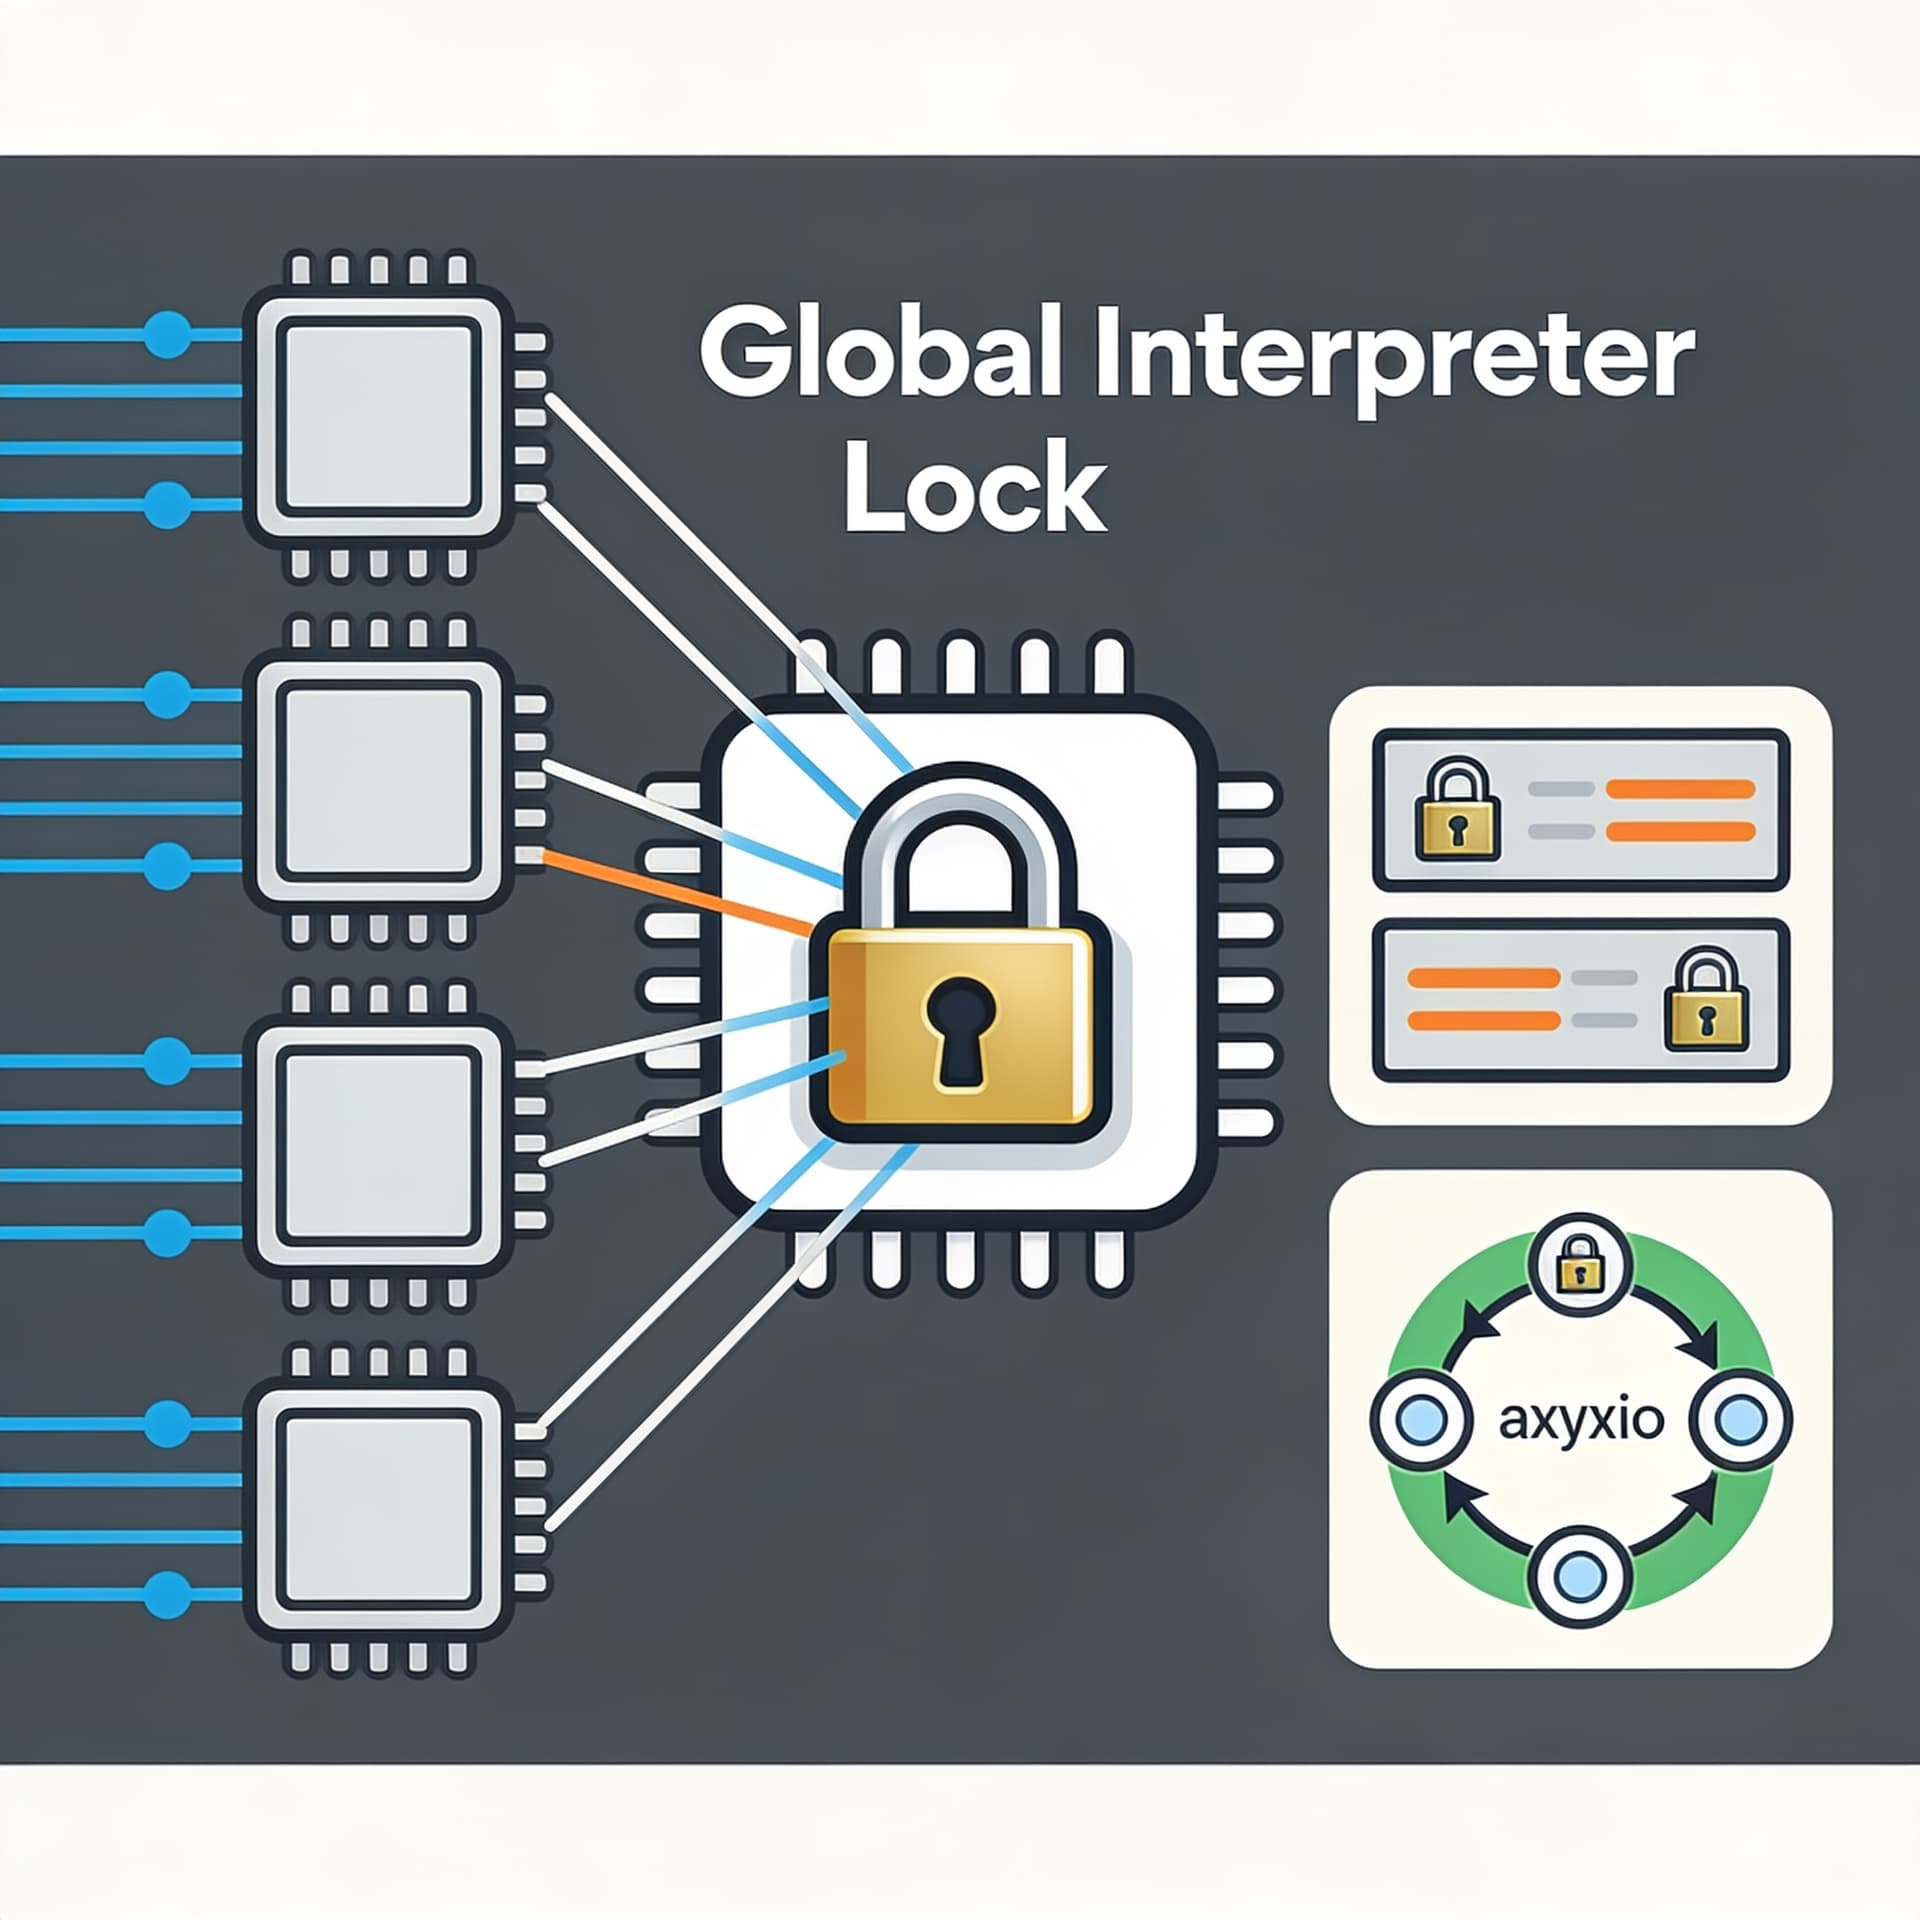
Разбираем, как устроен Global Interpreter Lock, почему потоки в Python не работают параллельно на CPU-задачах и когда стоит переключиться на multiprocessing или asyncio.
Содержание
Один из самых распространённых сюрпризов для разработчиков, переходящих с Java или C++ на Python, — это поведение многопоточного кода. Вы запускаете несколько потоков, ожидаете линейного прироста производительности, а в итоге получаете примерно то же самое время выполнения, что и в однопоточном варианте. Иногда даже чуть хуже. Причина — Global Interpreter Lock, или GIL.
GIL — не баг и не недосмотр. Это осознанное архитектурное решение, которое существует в CPython с самых ранних версий и по сей день определяет поведение Python в многопоточных сценариях. Разобраться в том, как он работает, почему он нужен и когда его ограничения действительно важны, — значит стать заметно более зрелым Python-разработчиком.
Что такое GIL и зачем он нужен
GIL — это мьютекс (mutual exclusion lock), который защищает доступ к внутренним структурам данных интерпретатора CPython. Он гарантирует, что в каждый момент времени только один поток выполняет байт-код Python.
Звучит как ограничение — и это так. Но у него есть конкретная причина.
CPython управляет памятью через подсчёт ссылок (reference counting). Каждый объект хранит счётчик того, сколько ссылок на него существует. Когда счётчик падает до нуля, объект удаляется. Это простая и предсказуемая модель управления памятью, но она абсолютно не thread-safe без дополнительной синхронизации: если два потока одновременно изменяют счётчик ссылок одного объекта, возникает гонка данных (race condition), которая может привести к преждевременному удалению объекта или утечке памяти.
Теоретически можно было бы защитить каждый счётчик ссылок отдельным мьютексом. Именно так устроены некоторые другие реализации Python — например, Jython или IronPython. Но в CPython разработчики выбрали более простой путь: один глобальный лок на весь интерпретатор. Это упрощает реализацию, облегчает интеграцию C-расширений и исторически хорошо работало в то время, когда многоядерные процессоры были редкостью.
Как GIL работает на практике
Рассмотрим простой пример: CPU-bound задача, которую мы пытаемся распараллелить с помощью потоков.
import threading
import time


def cpu_bound_task(n):
    """Считаем сумму квадратов — типичная CPU-нагрузка."""
    total = 0
    for i in range(n):
        total += i * i
    return total


def run_single_thread(n, iterations):
    for _ in range(iterations):
        cpu_bound_task(n)


def run_multi_thread(n, iterations, num_threads):
    threads = []
    chunk = iterations // num_threads
    for _ in range(num_threads):
        t = threading.Thread(target=run_single_thread, args=(n, chunk))
        threads.append(t)
    for t in threads:
        t.start()
    for t in threads:
        t.join()


N = 500_000
ITERATIONS = 8

start = time.perf_counter()
run_single_thread(N, ITERATIONS)
single_time = time.perf_counter() - start
print(f"Single thread: {single_time:.2f}s")

start = time.perf_counter()
run_multi_thread(N, ITERATIONS, num_threads=4)
multi_time = time.perf_counter() - start
print(f"4 threads:     {multi_time:.2f}s")
На типичной машине результат будет примерно таким:
Single thread: 3.41s
4 threads:     3.58s
Четыре потока не только не ускорили выполнение — они немного замедлили его из-за накладных расходов на переключение контекста и конкуренцию за GIL. Это не интуитивно, но полностью объяснимо.
Механизм переключения GIL
До Python 3.2 GIL переключался каждые 100 байт-кодовых инструкций (так называемый sys.checkinterval). Это создавало проблемы: потоки могли «голодать», а переключения происходили в неудачные моменты.
Начиная с Python 3.2, механизм был переработан Антуаном Питру. Теперь GIL переключается на основе времени: каждые 5 миллисекунд (настраивается через sys.setswitchinterval). Поток, удерживающий GIL, выполняется, затем сигнализирует остальным, что готов его отдать. Если другой поток ждёт — он захватывает лок.
import sys

# Текущий интервал переключения (в секундах)
print(sys.getswitchinterval())  # 0.005 — то есть 5 мс
Это улучшило честность распределения GIL между потоками, но не решило фундаментальную проблему: в каждый момент времени CPU-код выполняется только в одном потоке.
Когда потоки всё-таки работают
GIL не делает потоки бесполезными. Он блокирует параллельное выполнение Python-байткода, но не блокирует параллельное ожидание.
Когда поток выполняет I/O-операцию — читает файл, ждёт ответа от сети, делает запрос к базе данных — он освобождает GIL. Пока один поток ждёт, другой может выполнять Python-код. Это делает потоки вполне разумным инструментом для I/O-bound задач.
import threading
import urllib.request
import time

URLS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
]


def fetch(url):
    with urllib.request.urlopen(url, timeout=10) as response:
        return response.read()


# Последовательно
start = time.perf_counter()
for url in URLS:
    fetch(url)
print(f"Sequential: {time.perf_counter() - start:.2f}s")  # ~4s

# Параллельно через потоки
start = time.perf_counter()
threads = [threading.Thread(target=fetch, args=(url,)) for url in URLS]
for t in threads:
    t.start()
for t in threads:
    t.join()
print(f"Threaded:   {time.perf_counter() - start:.2f}s")  # ~1s
Здесь потоки дают реальный выигрыш — потому что большую часть времени они ждут сети, а не занимают CPU.
Аналогично работают многие C-расширения: NumPy, например, при выполнении тяжёлых вычислений внутри своих C-функций может освобождать GIL, позволяя другим потокам работать параллельно.
CPU-bound задачи: переходим на multiprocessing
Если вам нужно реально распараллелить вычислительно тяжёлые задачи, стандартный ответ в Python — модуль multiprocessing. Каждый процесс получает собственный интерпретатор и собственный GIL, поэтому они действительно работают параллельно.
from multiprocessing import Pool
import time


def cpu_bound_task(n):
    total = 0
    for i in range(n):
        total += i * i
    return total


if __name__ == "__main__":
    N = 500_000
    ITERATIONS = 8

    # Последовательно
    start = time.perf_counter()
    for _ in range(ITERATIONS):
        cpu_bound_task(N)
    print(f"Sequential:      {time.perf_counter() - start:.2f}s")

    # Параллельно через процессы
    start = time.perf_counter()
    with Pool(processes=4) as pool:
        pool.starmap(cpu_bound_task, [(N,)] * ITERATIONS)
    print(f"Multiprocessing: {time.perf_counter() - start:.2f}s")
Результат будет уже другим:
Sequential:      3.41s
Multiprocessing: 0.97s
Прирост близок к теоретическому максимуму для 4 ядер.
Подводные камни multiprocessing
Процессы — не серебряная пуля. У них есть существенные издержки:
- Запуск процесса значительно дороже запуска потока. На Windows это особенно заметно, потому что там используется
spawnпо умолчанию (полный запуск нового интерпретатора), а неfork. - Передача данных между процессами происходит через сериализацию (pickle). Большие объекты передаются медленно, а некоторые вещи (например, лямбды или локальные функции) вообще не сериализуются.
- Разделяемое состояние требует явной синхронизации через
multiprocessing.Value,QueueилиManager.
Поэтому multiprocessing хорошо работает тогда, когда задача хорошо разбивается на независимые куски с небольшими входными/выходными данными.
I/O-bound задачи: asyncio как альтернатива потокам
Для I/O-bound задач у потоков есть более элегантная альтернатива — асинхронное программирование через asyncio. Вместо того чтобы держать несколько потоков, которые большую часть времени спят в ожидании I/O, asyncio использует один поток с кооперативной многозадачностью.
import asyncio
import aiohttp
import time

URLS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/1",
]


async def fetch(session, url):
    async with session.get(url) as response:
        return await response.read()


async def main():
    async with aiohttp.ClientSession() as session:
        tasks = [fetch(session, url) for url in URLS]
        return await asyncio.gather(*tasks)


start = time.perf_counter()
asyncio.run(main())
print(f"asyncio: {time.perf_counter() - start:.2f}s")  # ~1s
asyncio не обходит GIL — он просто не нуждается в параллельном выполнении кода. Пока одна корутина ждёт ответа сети, event loop переключается на другую. Всё это происходит в одном потоке, без накладных расходов на синхронизацию.
Для разработчиков, которые хотят глубоко разобраться в этих механизмах в контексте production-разработки, полезным ориентиром может служить курс «Senior Python» — там эти темы рассматриваются в связке с реальными архитектурными решениями, а не как изолированные концепции.
Что меняется в Python 3.13 и далее
Разговоры об удалении GIL ведутся давно, но конкретные шаги начались относительно недавно. В октябре 2023 года был принят PEP 703 («Making the Global Interpreter Lock Optional in CPython»), написанный Сэмом Гроссом. В Python 3.13 появилась экспериментальная сборка без GIL (--disable-gil).
Это значительный шаг, но с оговорками:
- «Без GIL» пока является опциональным режимом, а не дефолтным.
- Производительность однопоточного кода в no-GIL сборке немного ниже из-за более тонкой синхронизации счётчиков ссылок.
- Многие C-расширения ещё не адаптированы к работе без GIL и могут вести себя непредсказуемо.
Реалистичный прогноз: no-GIL Python станет стабильным и дефолтным не раньше Python 3.15–3.16. До тех пор понимание GIL остаётся обязательным для любого серьёзного Python-разработчика.
Практические рекомендации: что выбрать
Чтобы не теряться в выборе инструмента, полезно держать в голове простую матрицу:
| Тип задачи | Рекомендуемый подход |
|---|---|
| CPU-bound, независимые задачи | multiprocessing, concurrent.futures.ProcessPoolExecutor |
| CPU-bound, NumPy/SciPy вычисления | threading (NumPy освобождает GIL) или multiprocessing |
| I/O-bound, много соединений | asyncio + асинхронные библиотеки |
| I/O-bound, legacy-код без async | threading, concurrent.futures.ThreadPoolExecutor |
| Смешанная нагрузка | Комбинация: asyncio + run_in_executor для CPU-частей |
Типичные ошибки
Ошибка 1: Использовать threading для CPU-bound задач. Это не только не ускорит код, но и добавит накладные расходы. Проверяйте профилировщиком, является ли ваша задача CPU-bound или I/O-bound, прежде чем выбирать инструмент.
Ошибка 2: Игнорировать concurrent.futures. Этот модуль предоставляет удобный единый интерфейс над threading и multiprocessing. ThreadPoolExecutor и ProcessPoolExecutor — часто более удобный выбор, чем работа с потоками и процессами напрямую.
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor

# CPU-bound
with ProcessPoolExecutor(max_workers=4) as executor:
    results = list(executor.map(cpu_bound_task, [500_000] * 8))

# I/O-bound
with ThreadPoolExecutor(max_workers=10) as executor:
    futures = [executor.submit(fetch_url, url) for url in urls]
    results = [f.result() for f in futures]
Ошибка 3: Смешивать asyncio и блокирующие вызовы. Если в асинхронном коде вызвать блокирующую функцию напрямую (например, requests.get), она заблокирует весь event loop. Для таких случаев используйте loop.run_in_executor.
import asyncio
import requests
from concurrent.futures import ThreadPoolExecutor

executor = ThreadPoolExecutor()

async def fetch_sync_in_async(url):
    loop = asyncio.get_event_loop()
    # Выполняем блокирующий вызов в пуле потоков
    response = await loop.run_in_executor(executor, requests.get, url)
    return response.content
Вывод
GIL — это компромисс, сделанный в конкретных исторических и технических условиях. Он упрощает реализацию CPython и интеграцию C-расширений, но ограничивает параллельное выполнение Python-кода на нескольких ядрах.
Понимание GIL позволяет принимать осознанные архитектурные решения: использовать multiprocessing там, где нужна реальная параллельность на CPU, и asyncio там, где узкое место — это ожидание I/O. Потоки при этом не становятся бесполезными — они хорошо работают для I/O-bound задач и для интеграции с C-расширениями, которые умеют освобождать GIL.
Если вы хотите разобраться в этих темах системно — с пониманием внутреннего устройства CPython, паттернов конкурентности и их применения в реальных проектах — стоит посмотреть на курс «Senior Python». Это один из немногих форматов, где подобные вещи разбираются не поверхностно, а с необходимой глубиной.
Python продолжает развиваться: PEP 703 и работа над no-GIL сборкой — это серьёзный сигнал о том, что ограничения GIL осознаны и решаются. Но пока это будущее, а не настоящее. Сегодня знание того, как GIL влияет на ваш код, — это не академическая деталь, а практический навык.