моделирование
Моделирование данных для API: как выбрать сущности, агрегаты и границы ответственности
Покажем подход к проектированию доменной модели под API: где делать преобразования, как избежать «анемичных» сервисов.
20 июля 2026 г.
660
Новости индустрии, разборы технологий и практические гайды для разработчиков.
Покажем подход к проектированию доменной модели под API: где делать преобразования, как избежать «анемичных» сервисов.
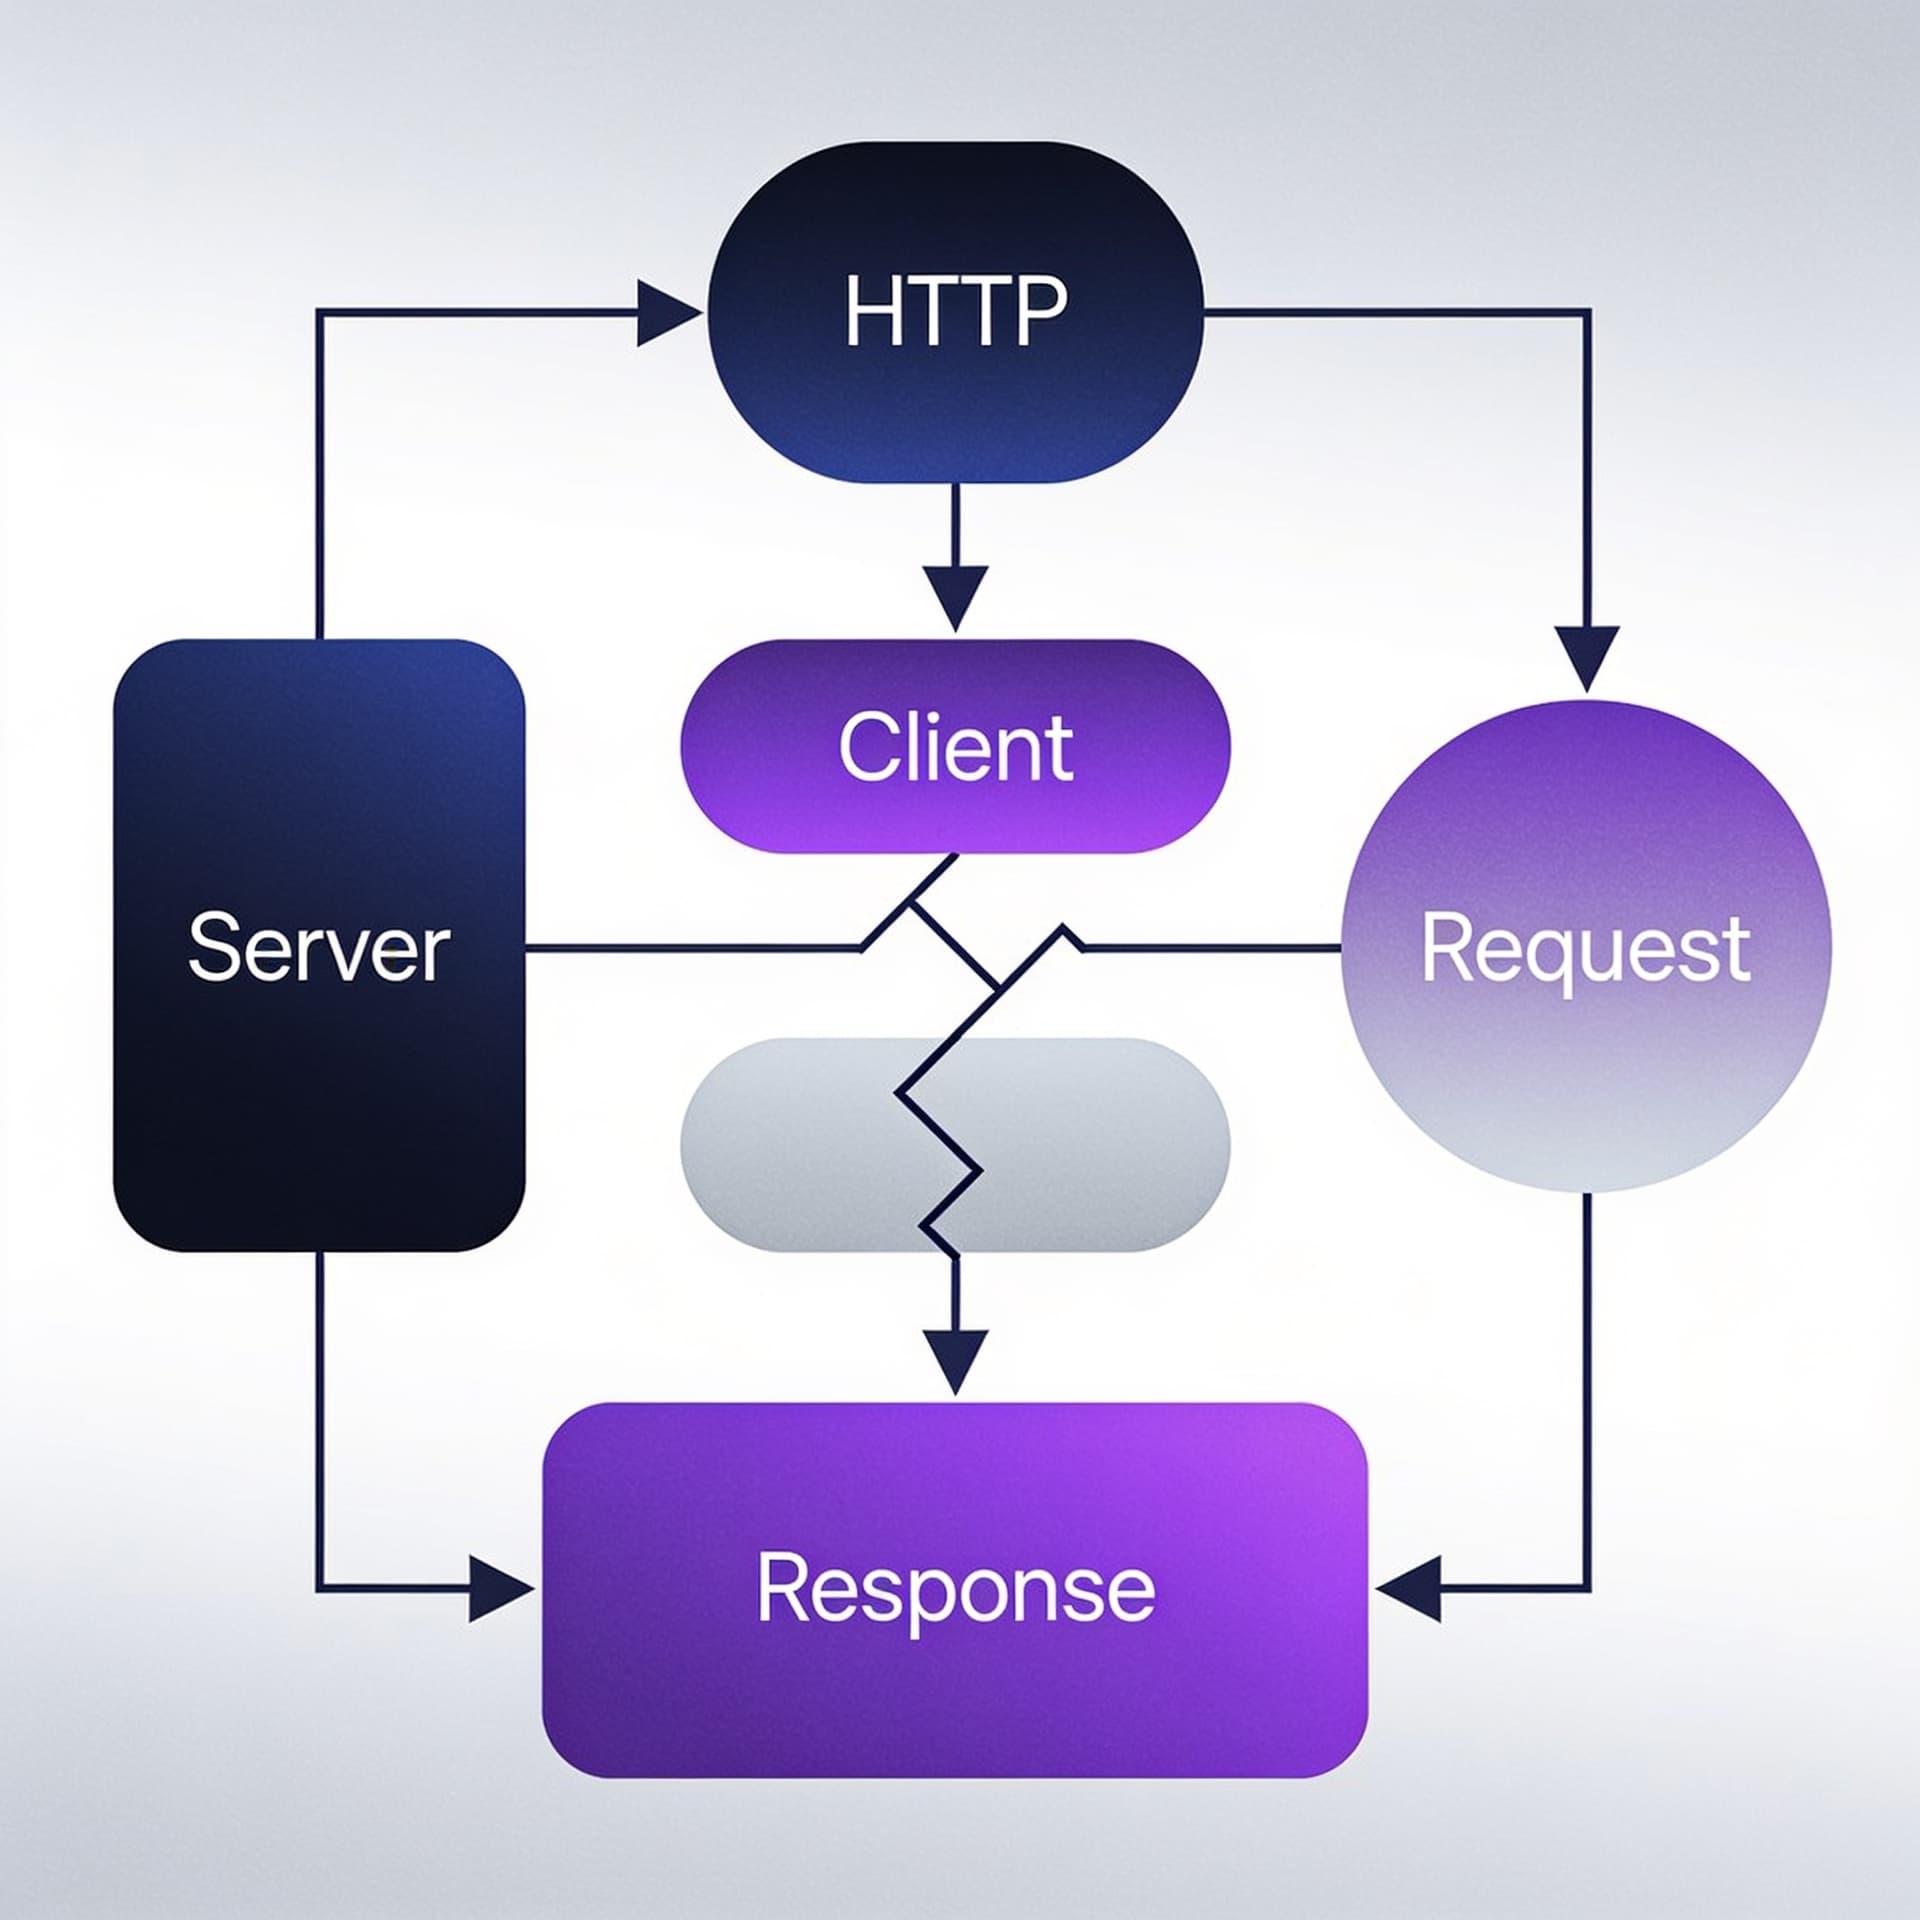
Соберём ментальную модель HTTP и разберём, как правильно строить запросы, что читать в ответах и где чаще всего ломается интеграция.
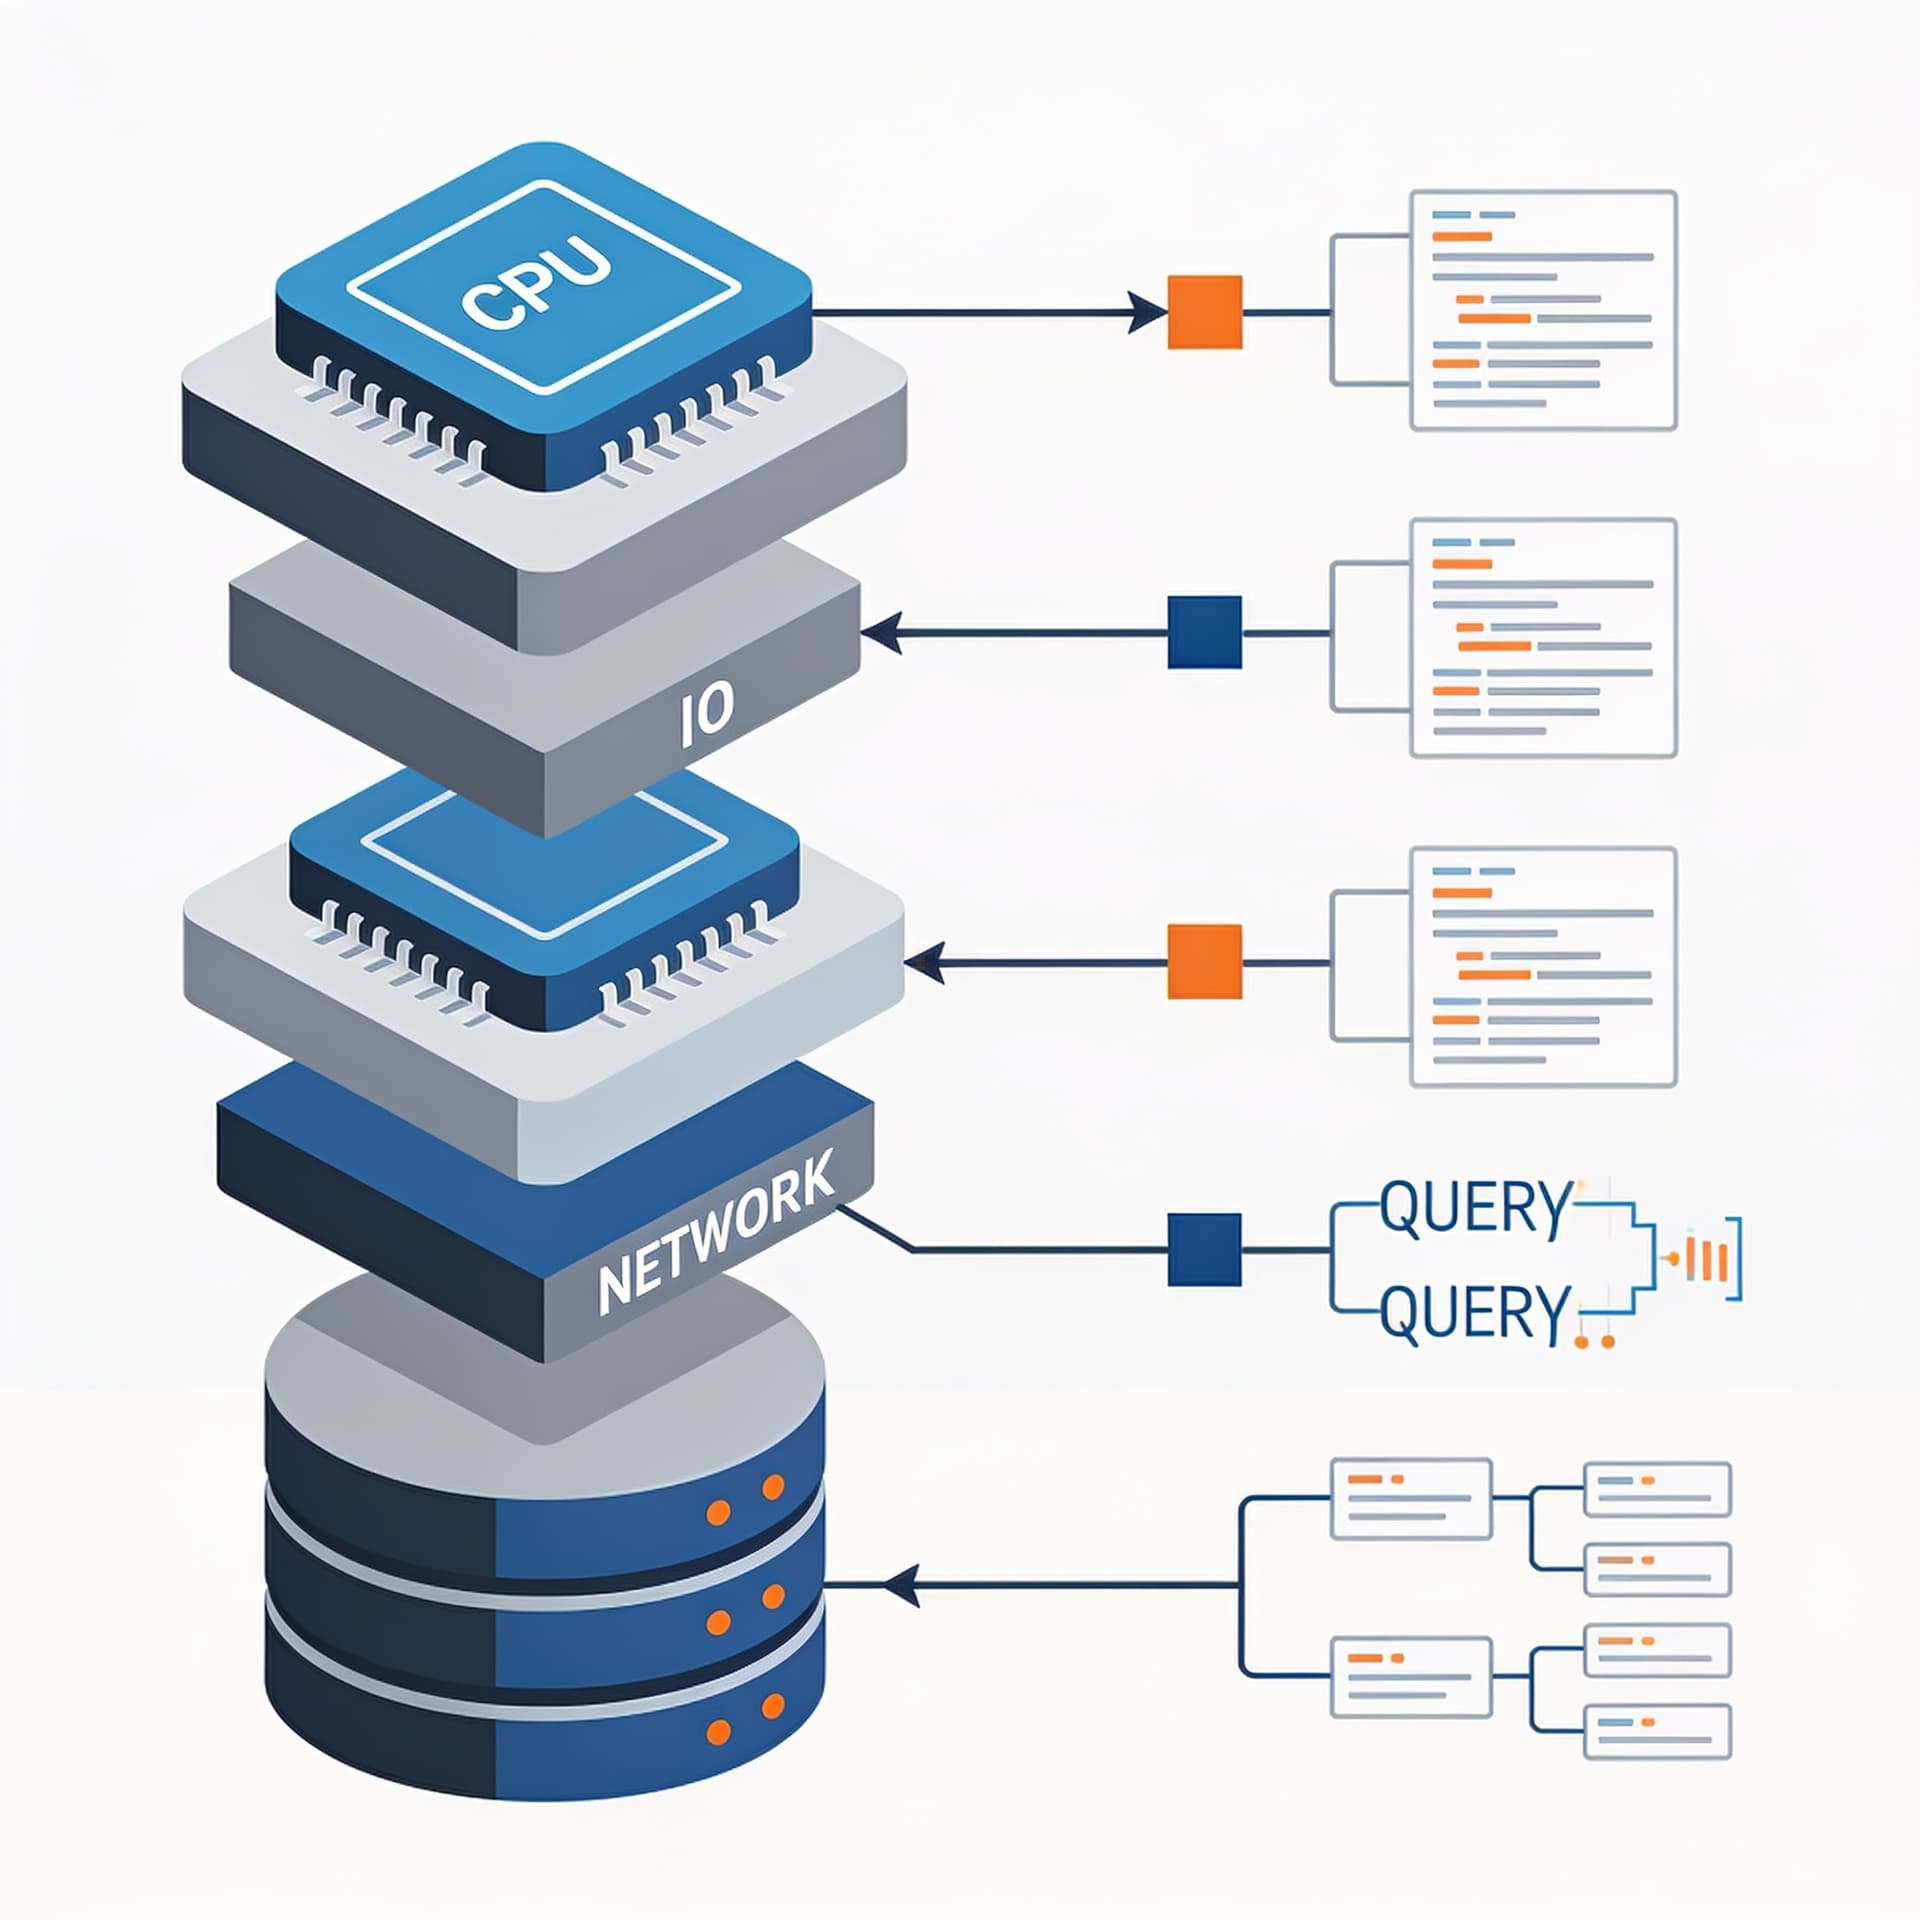
На чек-листе научимся диагностировать проблему по профилированию и метрикам: от логов и трейсинга до планов запросов.
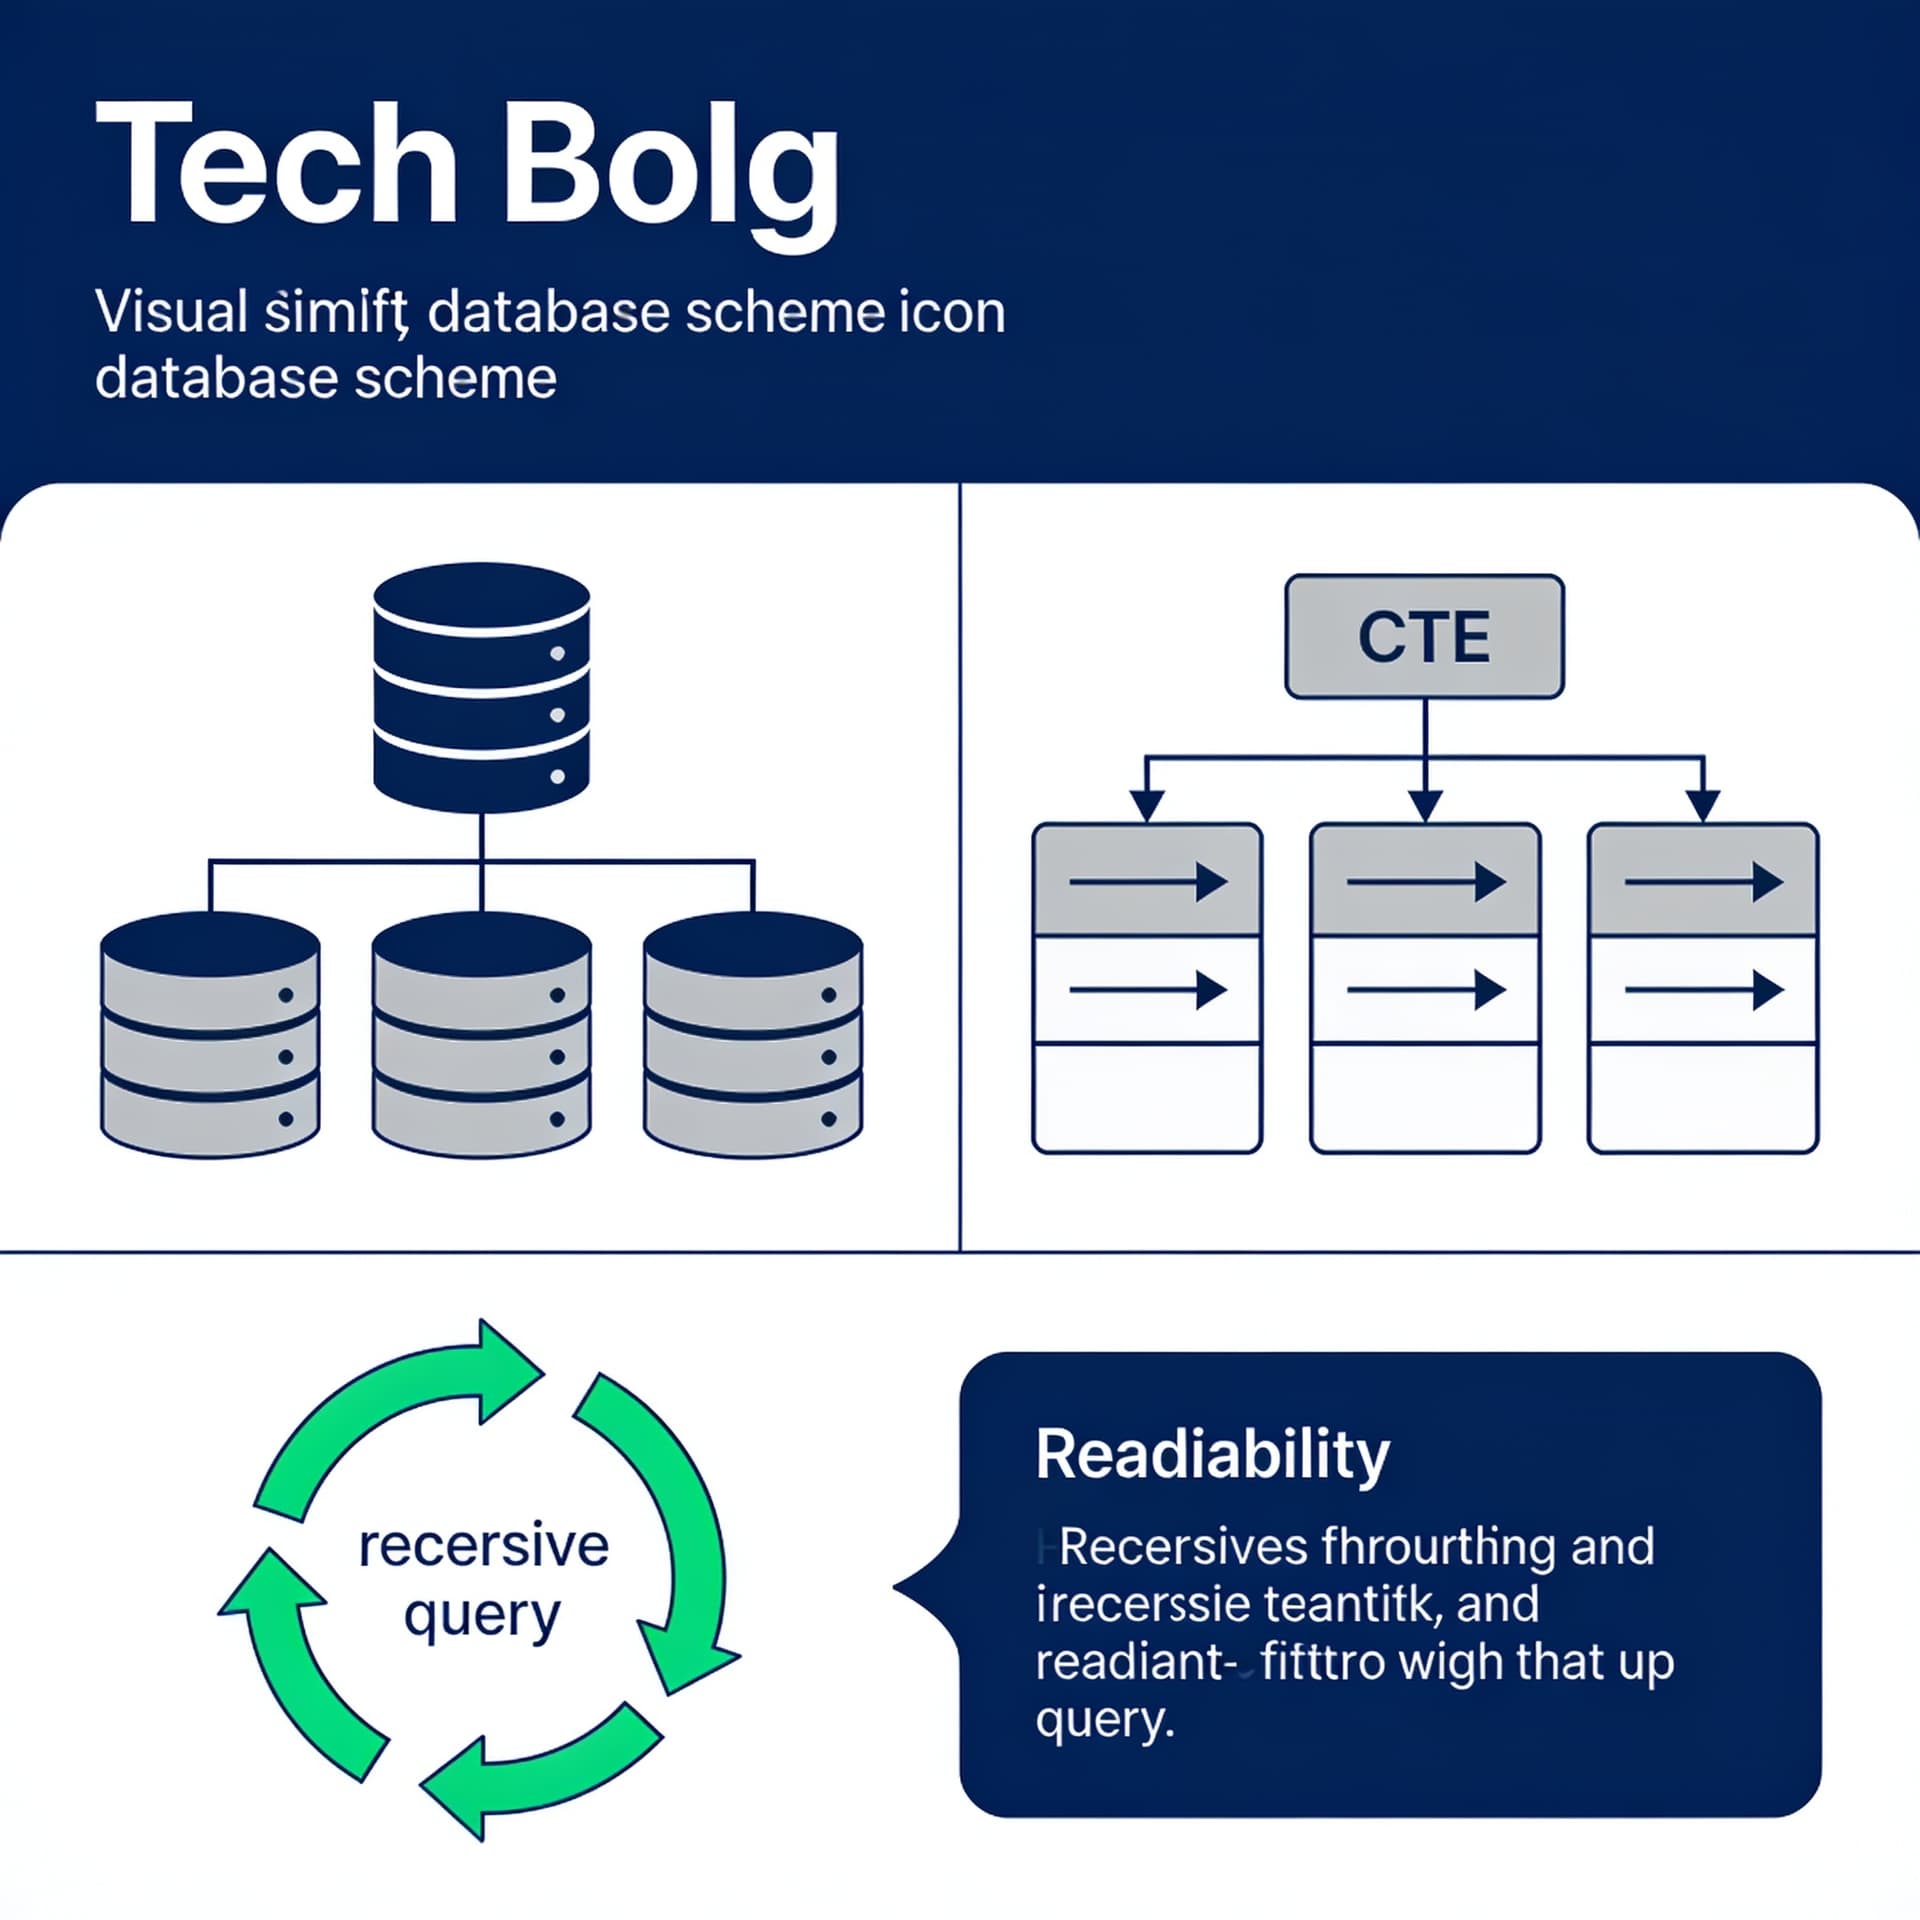
На практических задачах построим запросы через CTE, поймём как работают рекурсивные CTE и как сделать SQL поддерживаемым.
Разберём dependencies и lifespan, как безопасно управлять ресурсами и как добиться предсказуемой валидации входных данных.
На реальных примерах разберём, как проектировать безопасные модели данных и извлекать пользу из narrowing вместо кастов.
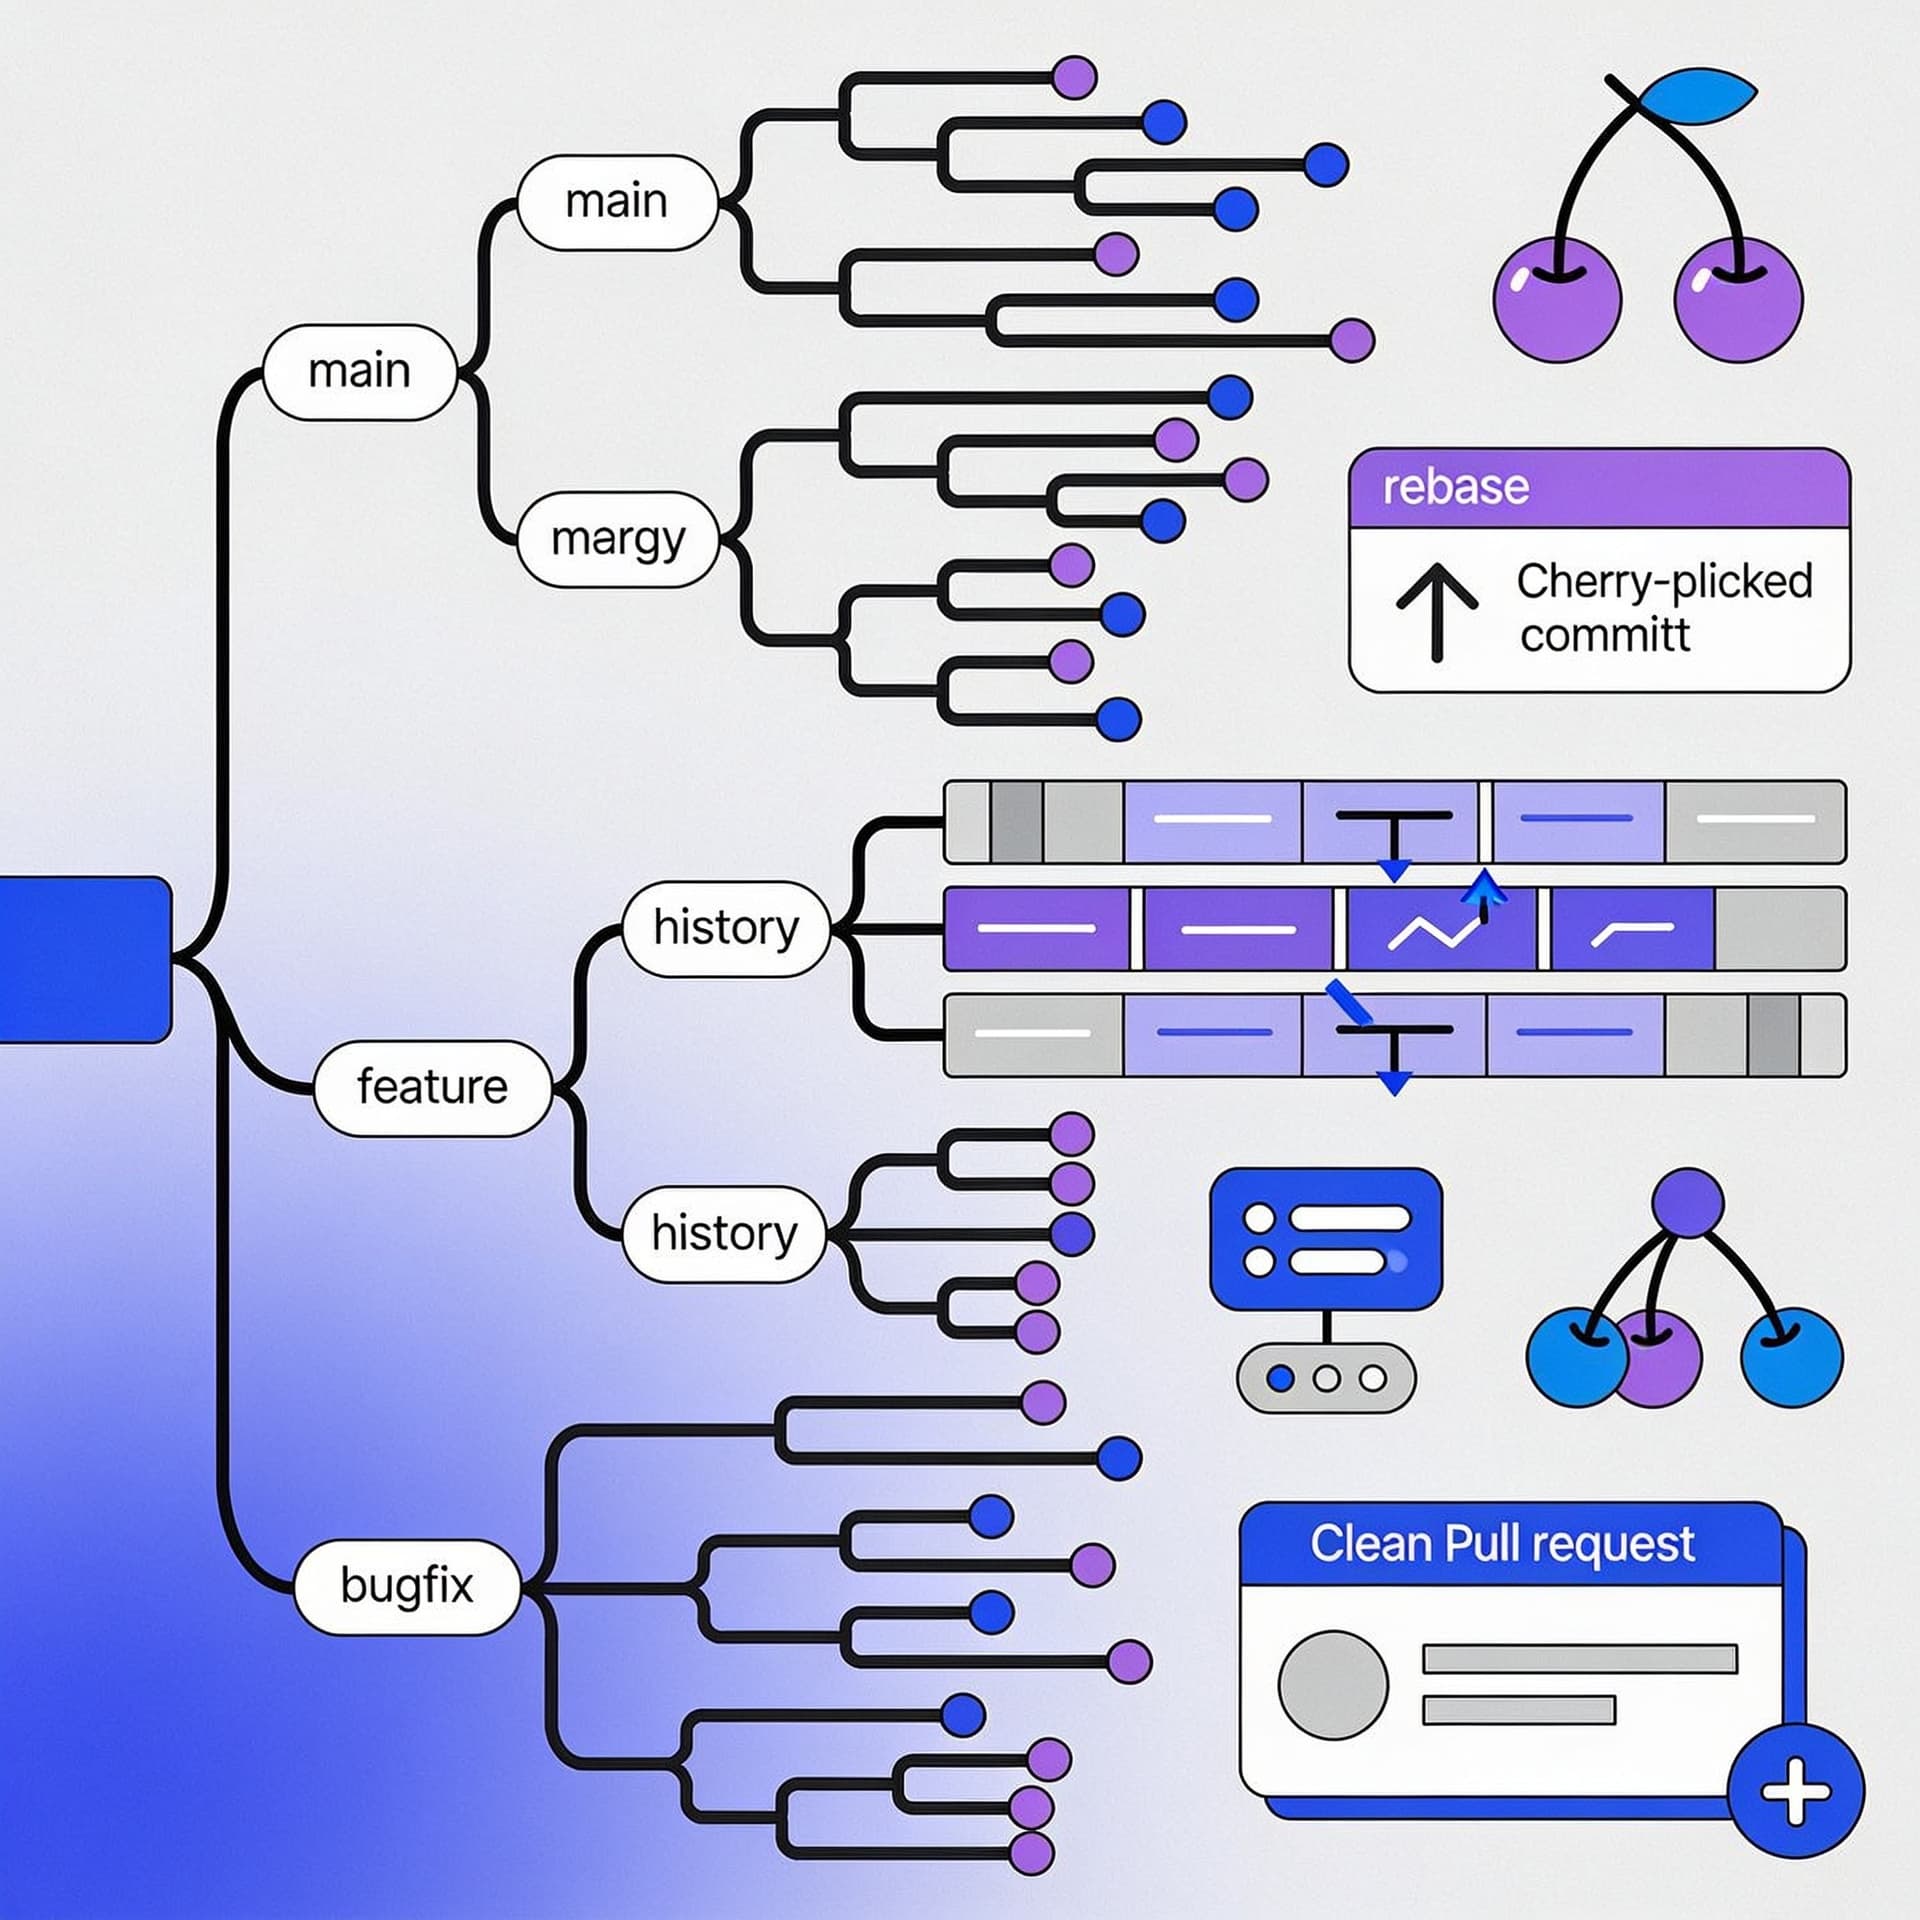
Покажем рабочие паттерны ветвления и истории коммитов, чтобы быстрее проходить code review и не ломать общую разработку.
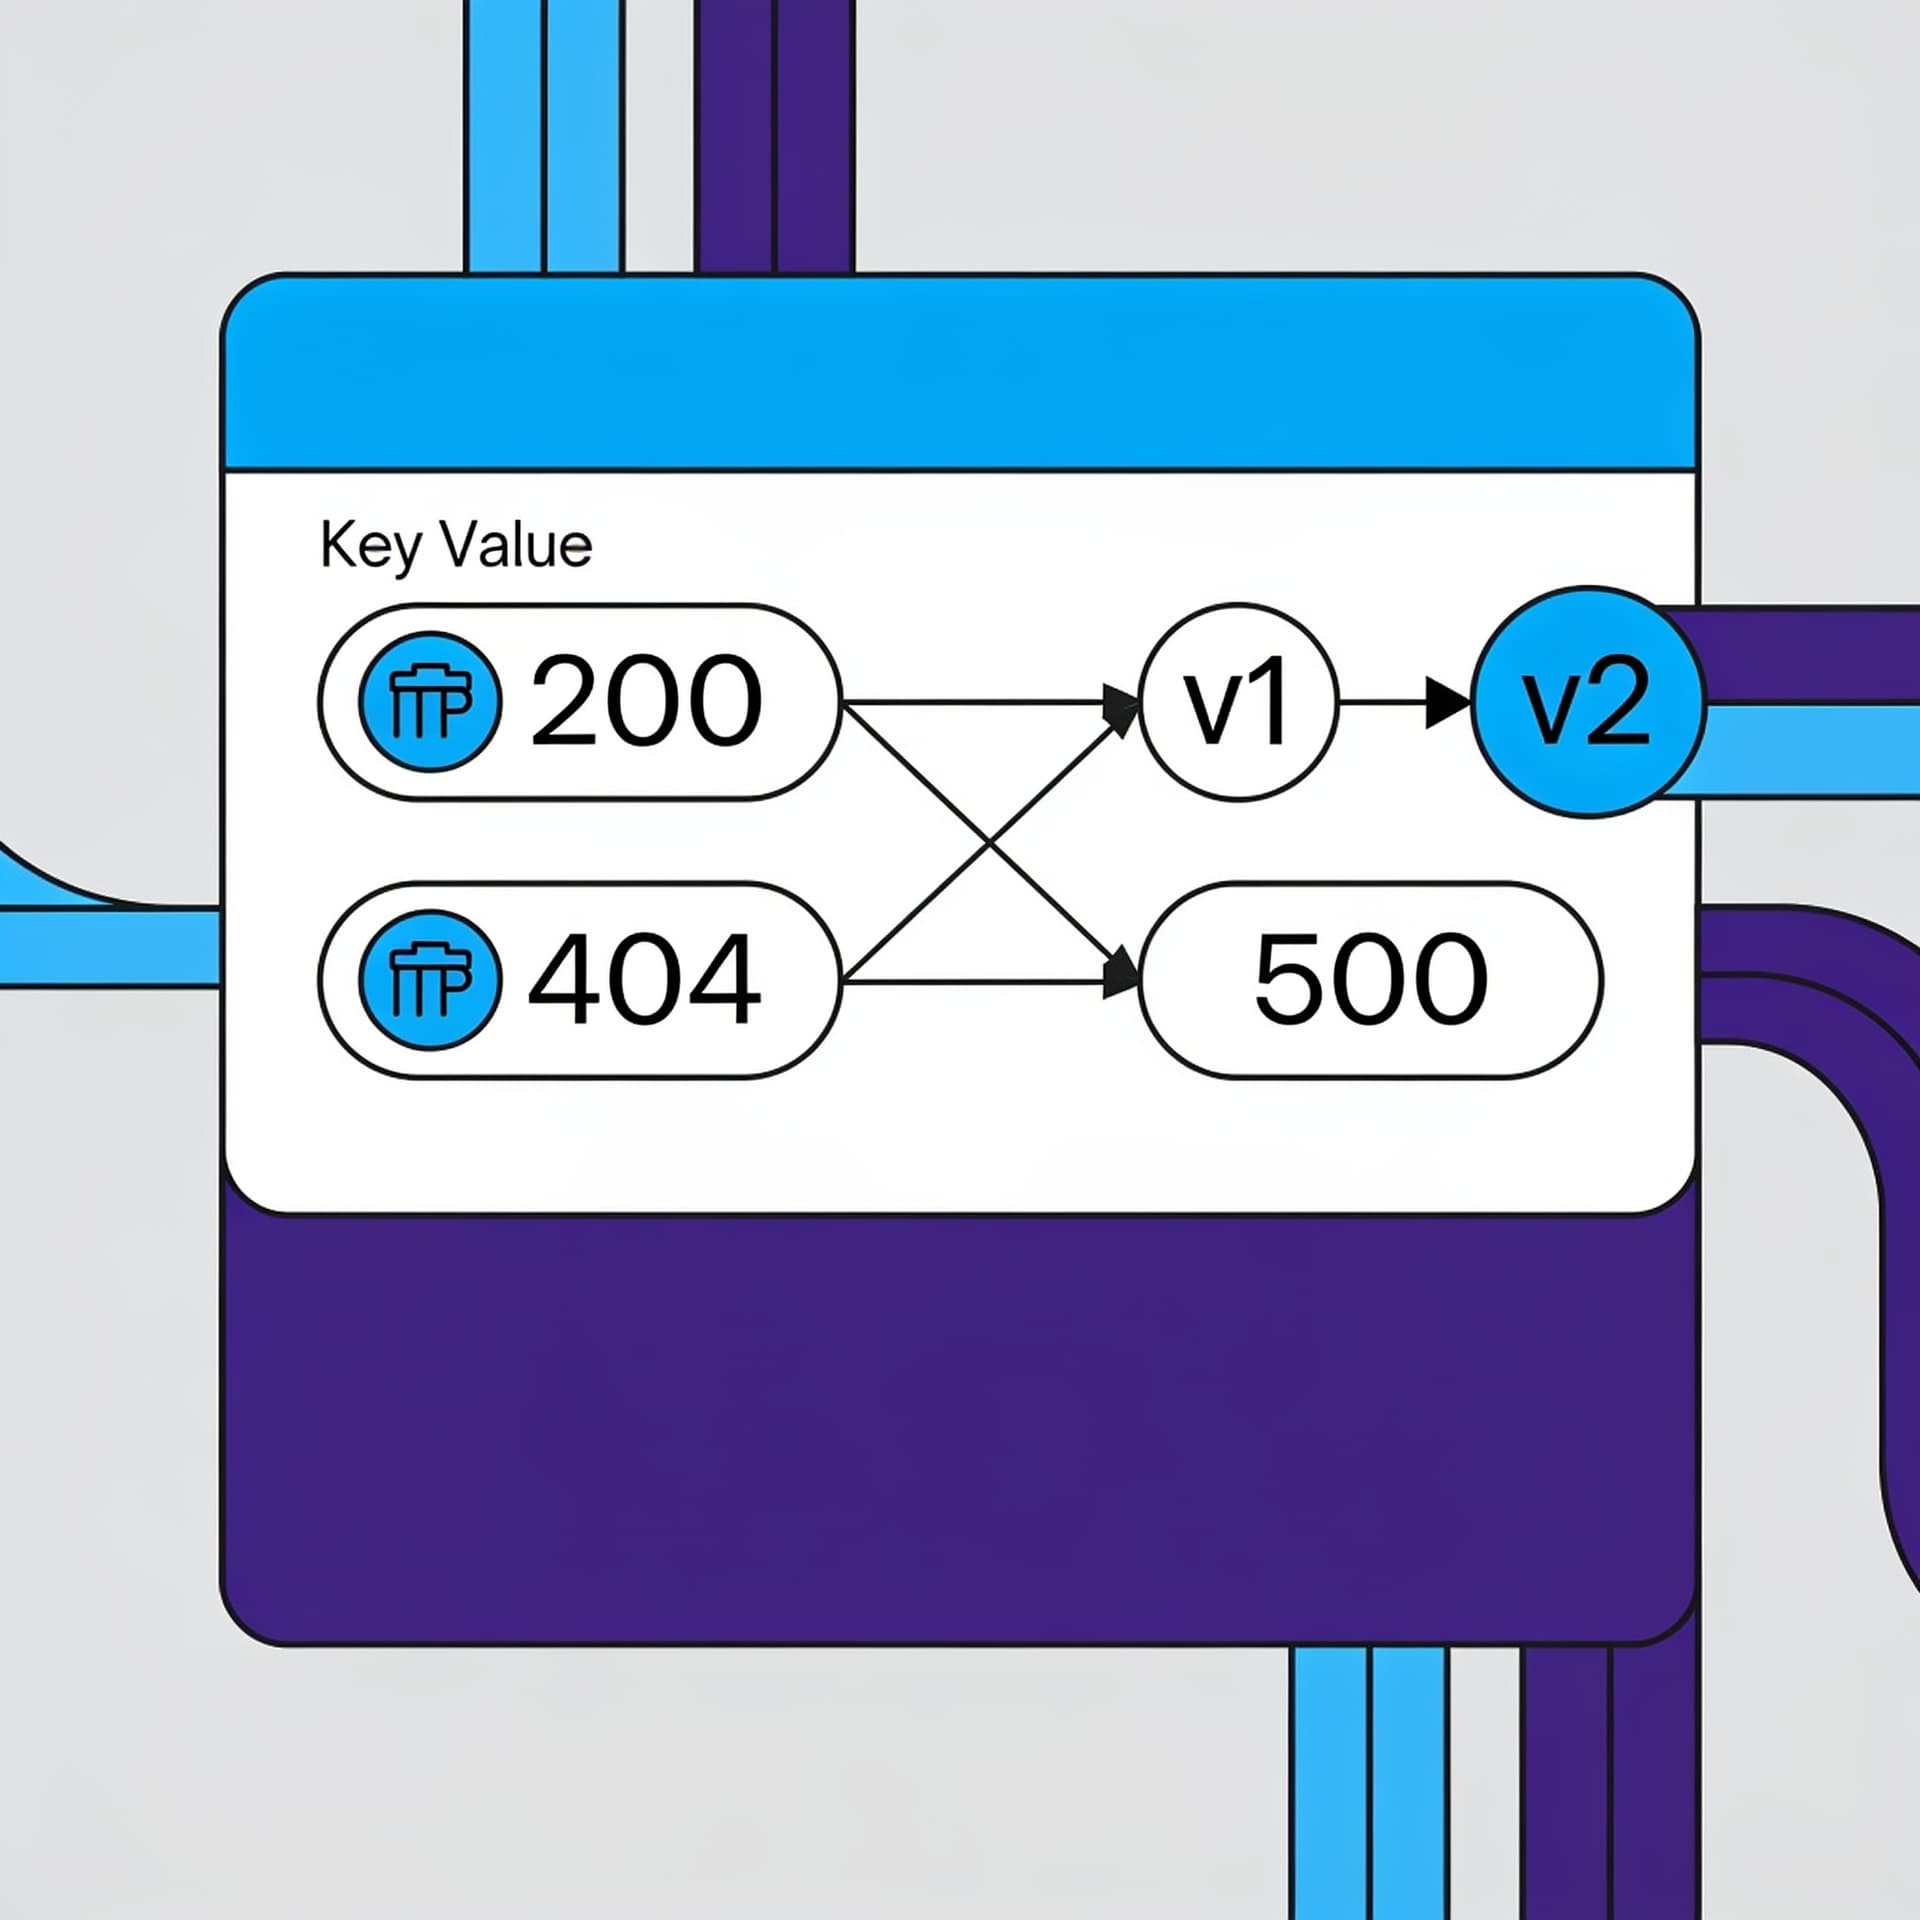
Разберём типовые ошибки в дизайне API и научимся фиксировать контракт: коды HTTP, формат ошибок, версионирование и примеры запросов/ответов.
Соберём рабочий процесс решения задач: декомпозиция, выбор структуры данных, оценка сложности и тестирование на граничных случаях. Особое внимание — практикам из интервью.
Покажем, как включить строгий режим, использовать типы для доменной модели и уменьшить ошибки в рантайме. Разберём практические примеры улучшения кода.

Сравним подходы и сценарии: где удобнее матрицы сборок, как организовать кэш, тесты и артефакты. Дадим шаблоны принятия решений.
Разберём, какие метрики выбирать для сервисов, как строить meaningful дашборды и как формировать алерты, чтобы не утонуть в ложных срабатываниях.