Как проектировать фоновые задания для асинхронных Python-сервисов: очереди, ретраи и дедлайны
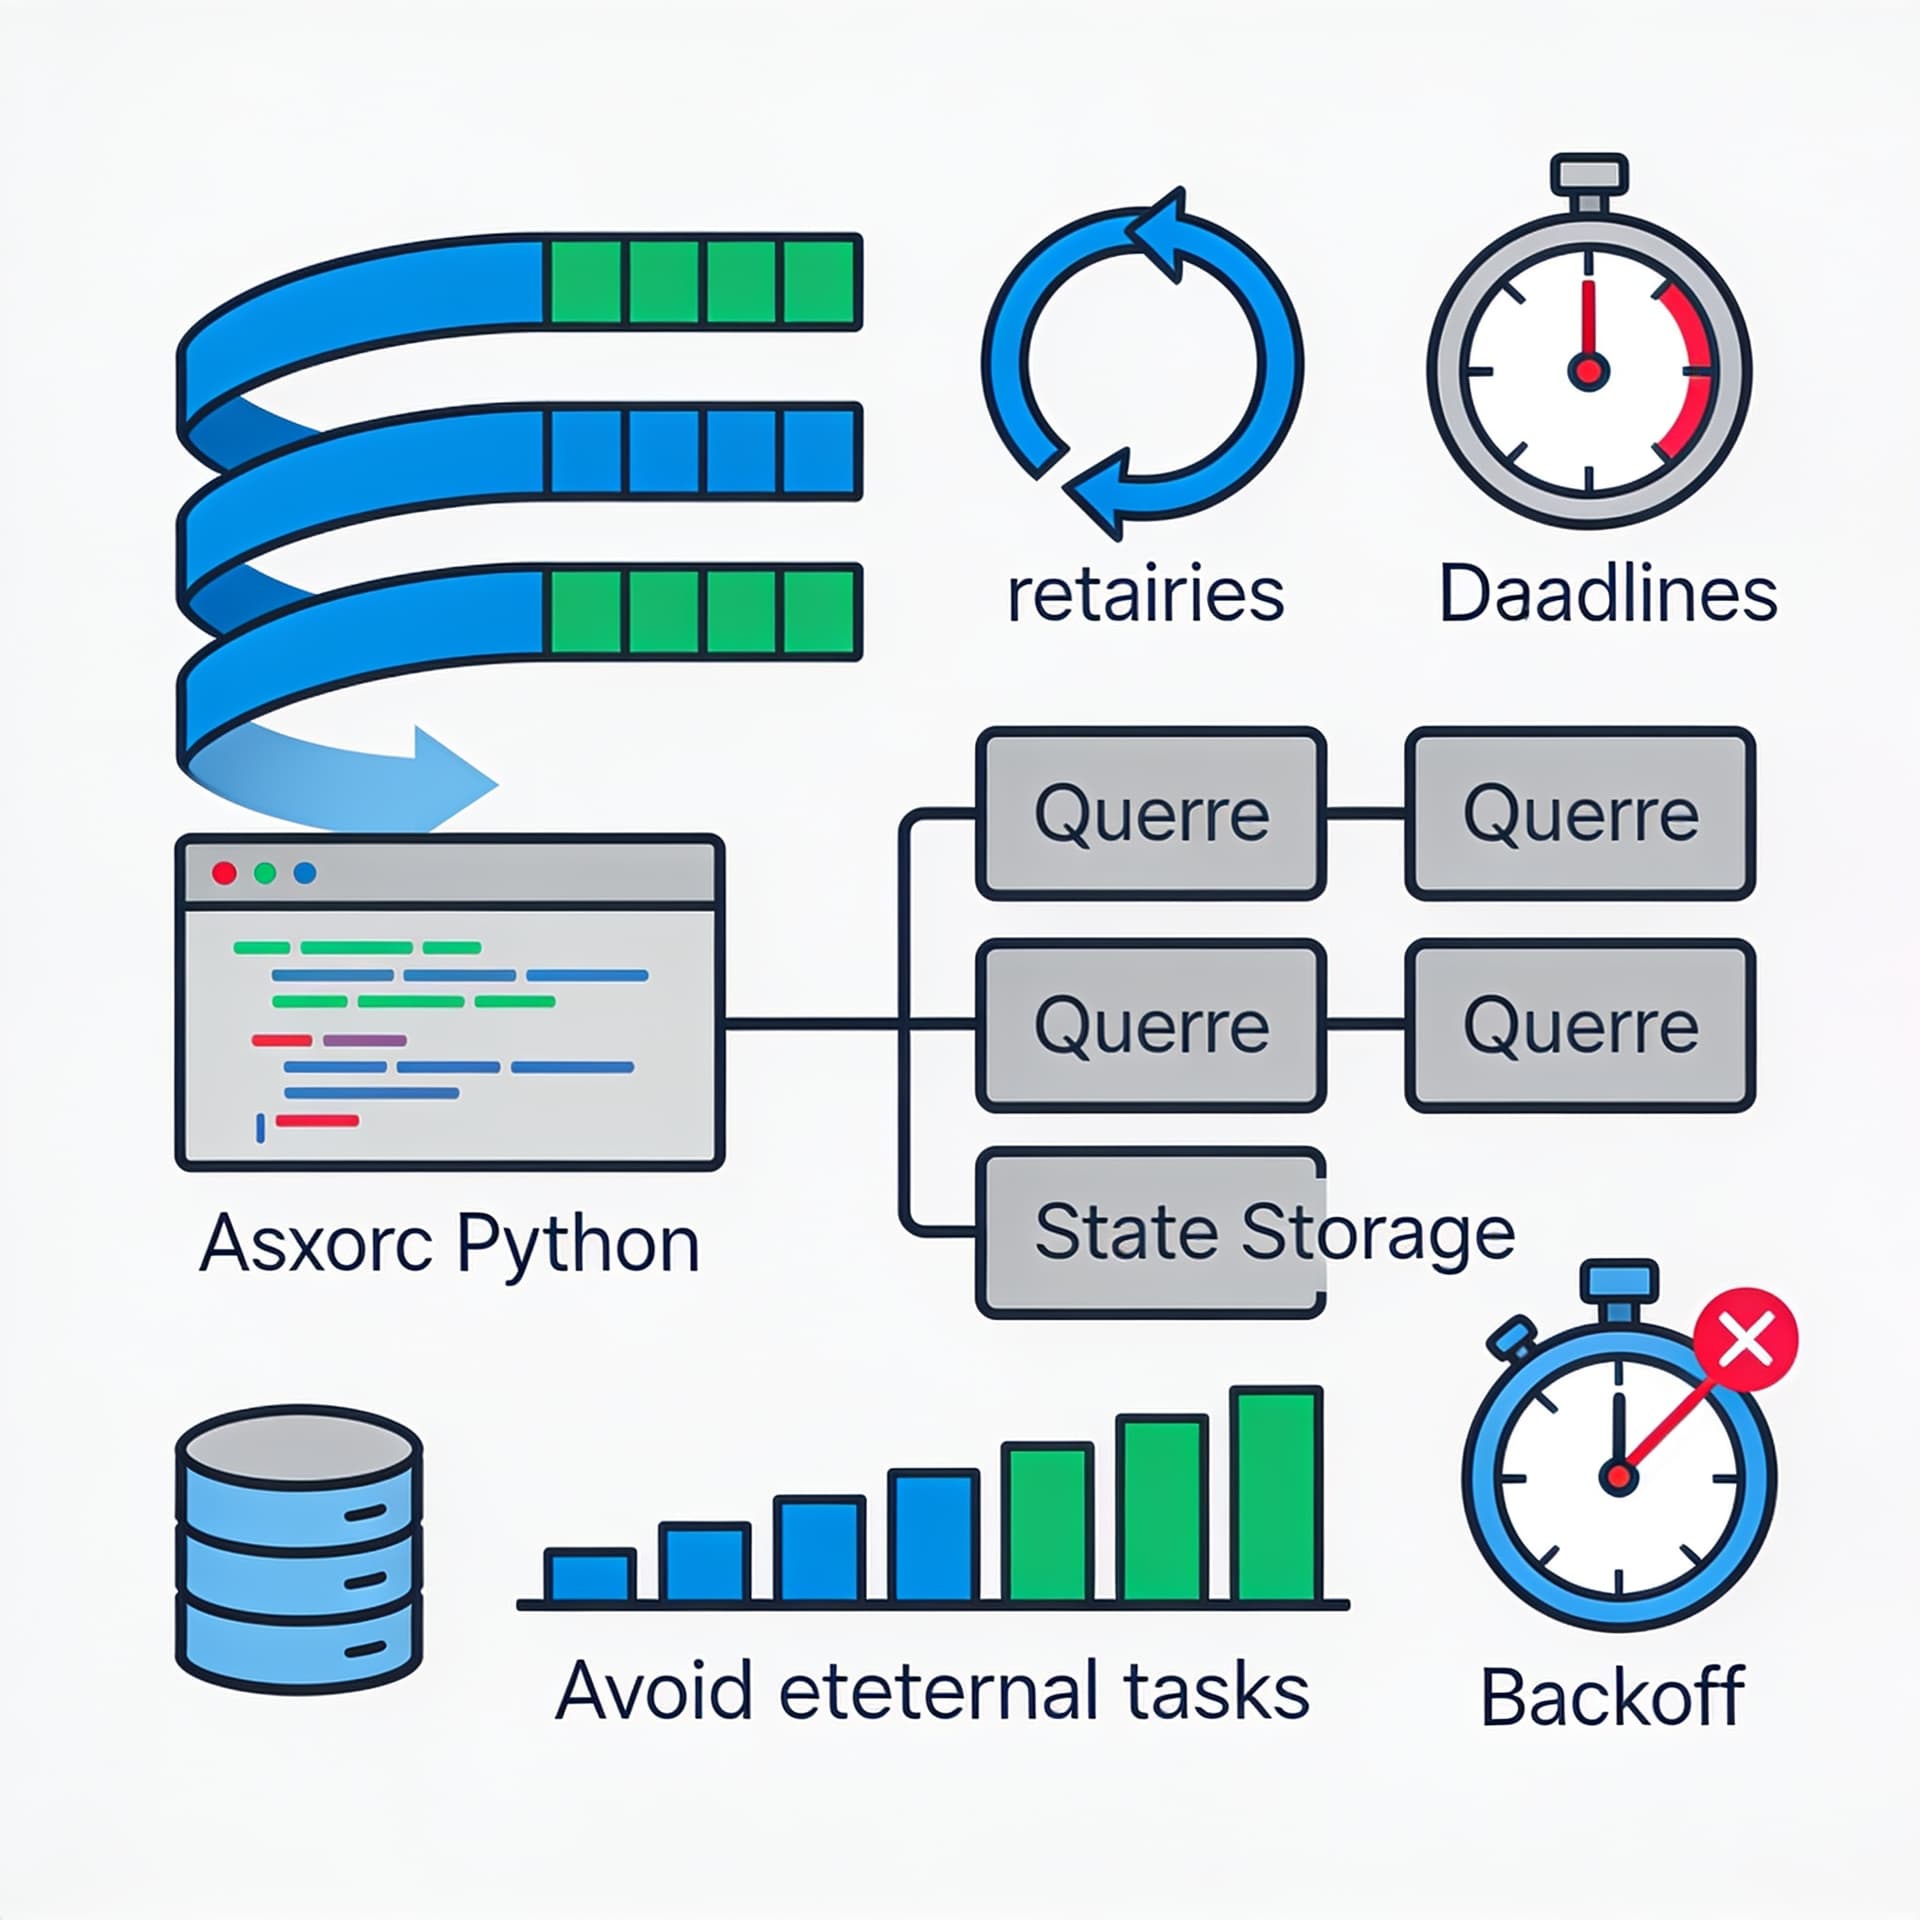
Разберём практический подход к построению фоновых воркеров в async-архитектуре: как выбирать модель (in-process vs очередь), где хранить состояние, как делать ретраи с backoff и как не допускать “вечных” задач без дедлайна.
Содержание
Фоновые задания в async-сервисах — это не «поставить задачу в очередь и забыть». Это проектирование распределённого механизма: кто и когда выполняет работу, как сервис переживает сбои, как он ограничивает нагрузку, как гарантирует прогресс и как отличает «надо повторить» от «надо прекратить».
На практике большинство проблем с воркерами в Python возникает не из-за очередей как таковых, а из-за отсутствия явной модели жизненного цикла задания: нет дедлайна, нет статусов, ретраи сделаны без учета типа ошибки, а «состояние» размазано по памяти воркера. В итоге появляются “вечные” задачи, дубликаты, гонки и «тихие» сбои, которые проявляются спустя дни.
Ниже — практический подход к проектированию фоновых задач для async-архитектуры: выбор модели (in-process vs очередь), хранение состояния, ретраи с backoff, дедлайны и способы не допускать бесконечных заданий.
1. Определяем требования: что именно вы называете «фоновой задачей»
Прежде чем выбирать инструмент, нужно зафиксировать свойства задания. Для проектирования важно не «как запустить корутину», а то, какие гарантии вам нужны.
1.1. Время жизни: должно ли задание быть актуальным всегда или «сейчас»?
Классическая ошибка — считать ретраи бесконечными, хотя бизнес-логика часто требует актуальности, например:
- отправить уведомление пользователю не позже N минут;
- синхронизировать данные с внешней системой, пока они ещё «живые»;
- построить отчёт, который не имеет смысла через час после запроса.
Для таких кейсов дедлайн — базовый параметр.
1.2. Идемпотентность: допустимы ли повторы?
Если задача неидемпотентная (например, делает списание денег), повтор при сбое приводит к ошибкам. Тогда либо:
- делаем операцию идемпотентной на уровне хранилища (уникальные ключи, транзакции),
- либо вводим deduplication (отдельный механизм «один и тот же request_id исполняется один раз»),
- либо гарантируем «at most once» через сложные протоколы (обычно не стоит).
1.3. Семантика очереди: вам важнее «каждому — по разу» или «лучше потерять, чем зависнуть»?
Нередко бизнес принимает «at-least-once» с идемпотентностью и корректным дедупом. Но если вы не готовы к повторам, архитектура меняется.
2. Выбор модели выполнения: in-process воркеры или внешняя очередь
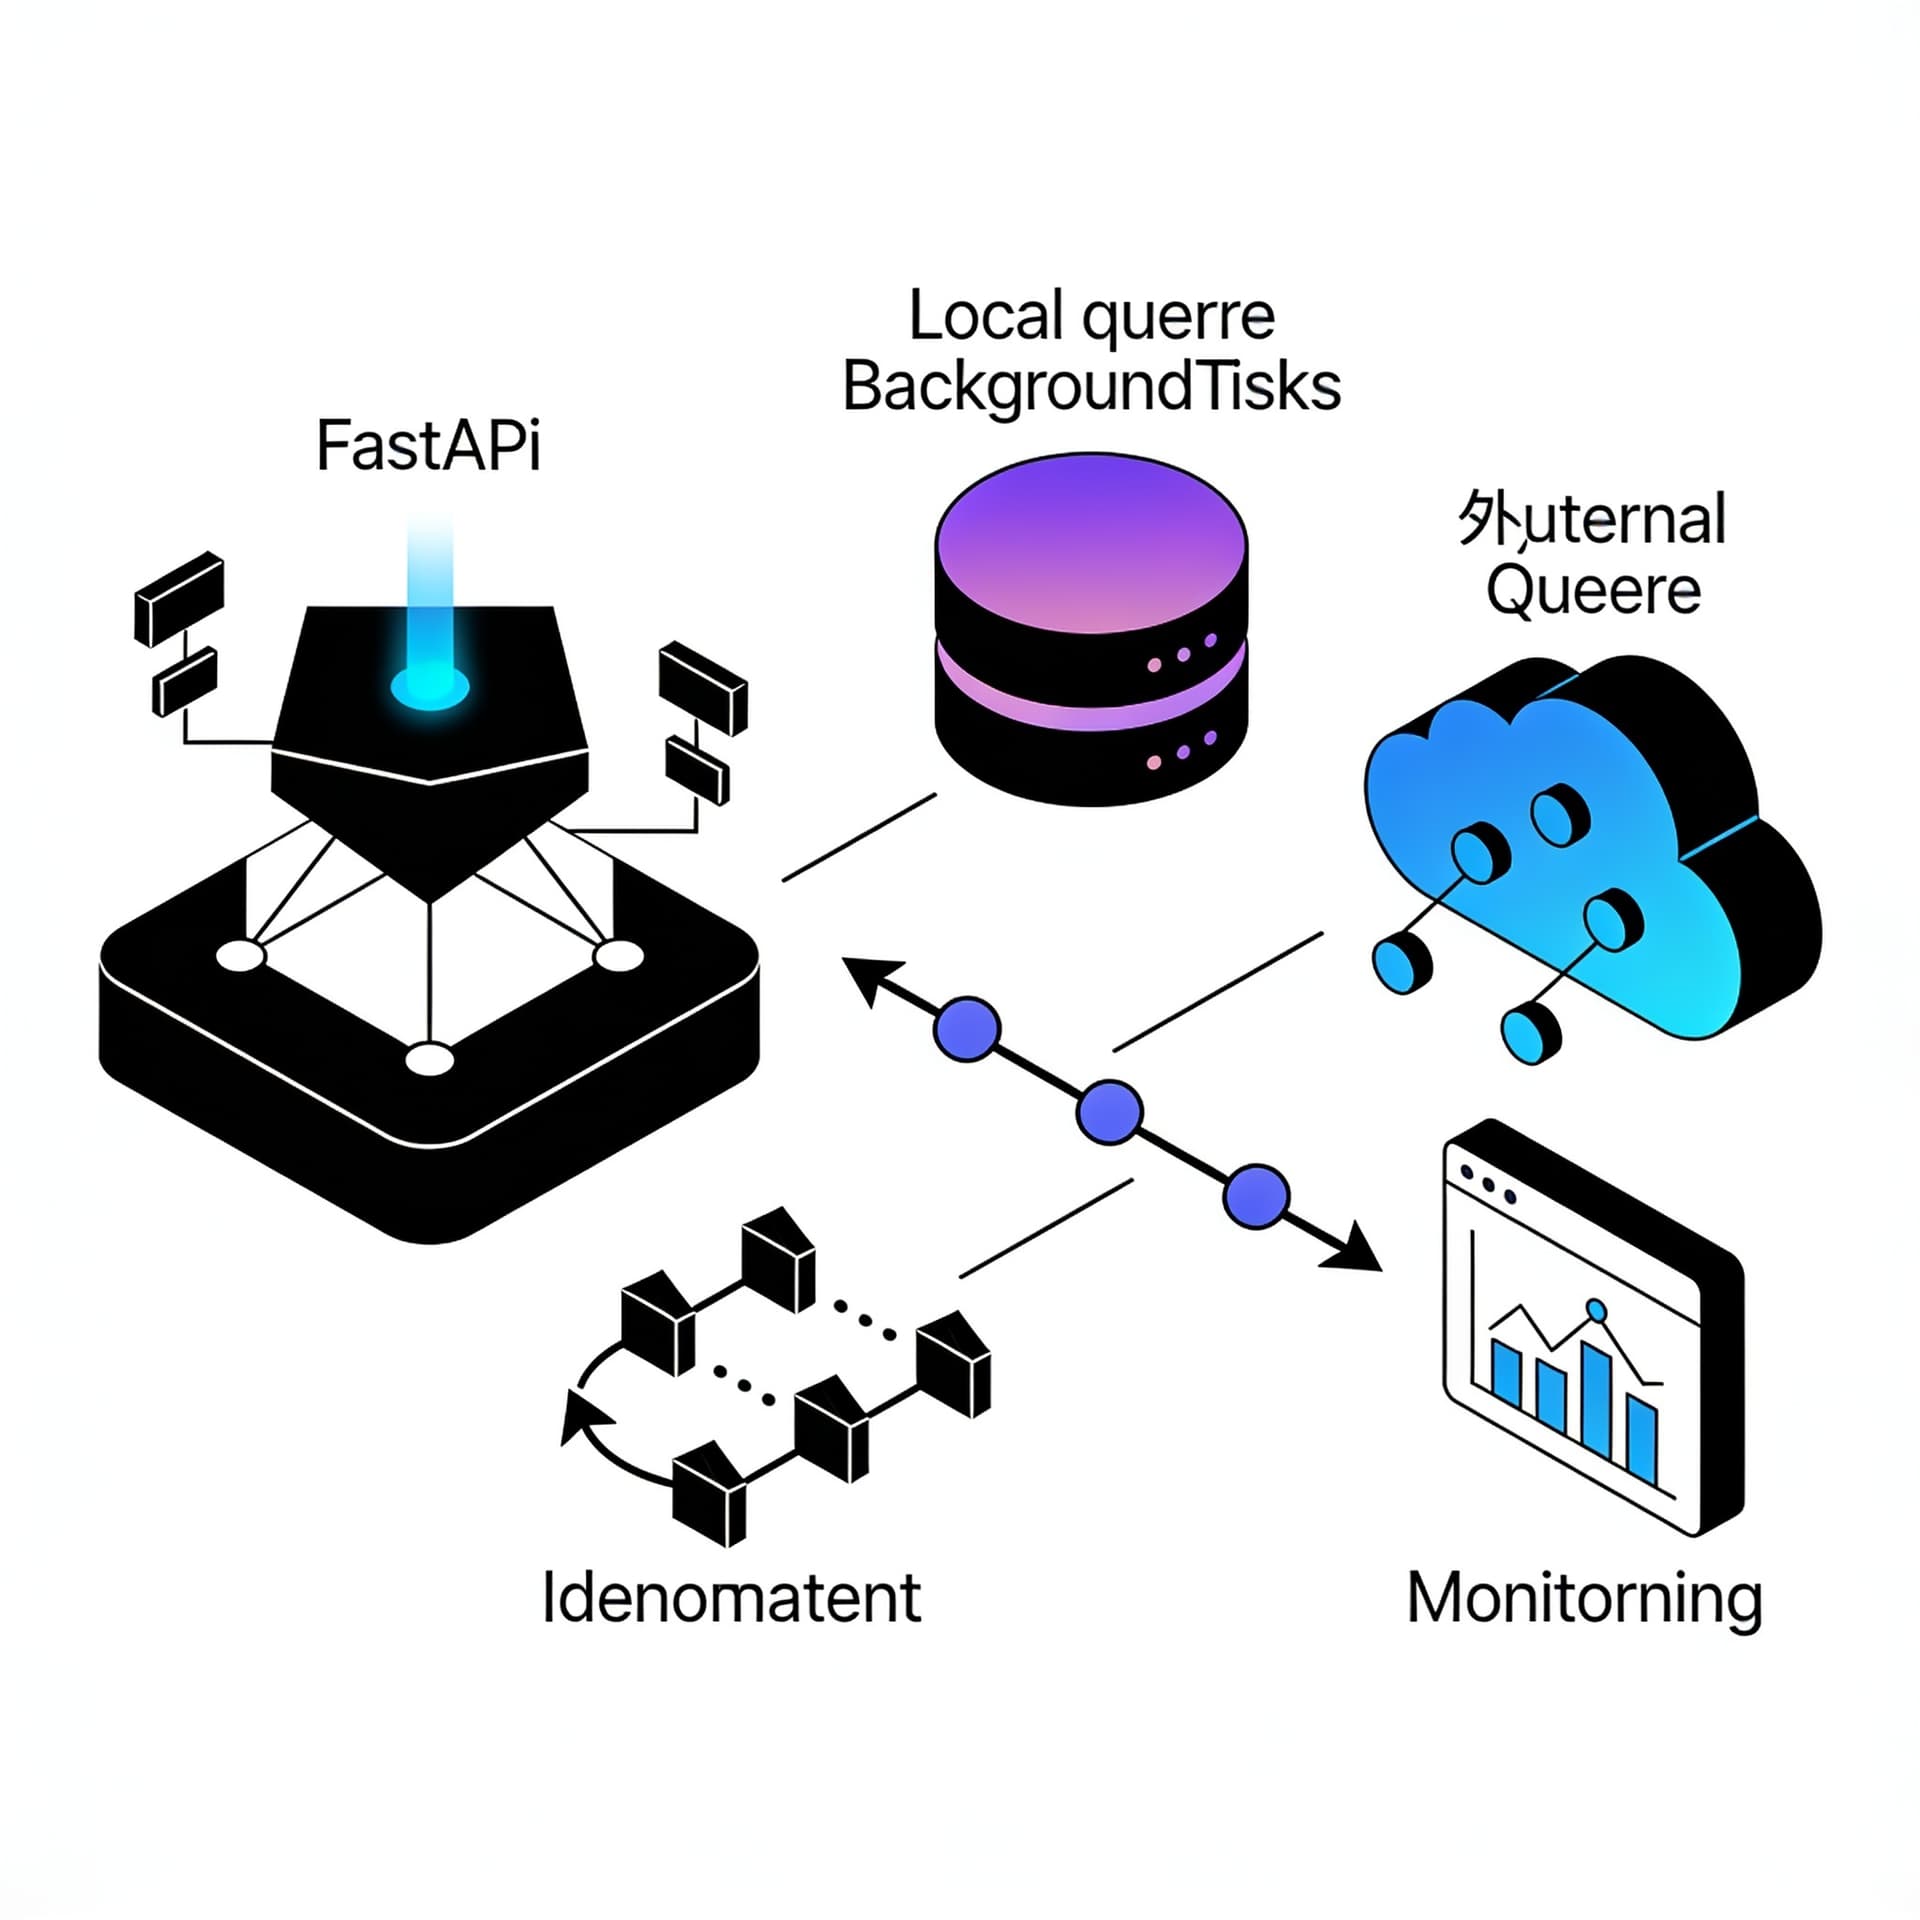
В async-сервисе есть два уровня: обработка фоновых задач внутри процесса и обработка через внешнюю очередь/брокер.
2.1. In-process: когда достаточно корутин и внутренней очереди
In-process модель подразумевает, что фоновые задания обрабатываются воркерами внутри одного процесса приложения.
Плюсы:
- минимальная сложность;
- быстрый путь без внешней инфраструктуры;
- хорошо подходит для коротких задач, не критичных к гарантии доставки.
Минусы:
- при рестарте процесса вы теряете задания (если нет персистентности);
- нет естественной масштабируемости по горизонтали;
- трудно гарантировать дедлайны и ретраи «сквозь сбои» без хранилища.
Практический критерий выбора
Используйте in-process, если:
- задачи можно безопасно повторить или они идемпотентны;
- приемлема потеря при рестарте либо вы сами умеете это компенсировать;
- длительность небольшая и вы контролируете нагрузку.
2.2. Очередь (broker): когда нужен устойчивый фон
Внешняя очередь нужна, когда:
- важно переживать падения процессов;
- вы хотите масштабировать воркеры независимо от API;
- нужны предсказуемые ретраи с политиками;
- вы хотите централизованный мониторинг очередей.
Типичные реализации: Redis Streams, RabbitMQ, Kafka, SQS и др. Выбор зависит от требований к порядку, ретраям и стоимости инфраструктуры.
Важный нюанс
Даже при наличии брокера состояние задания (сколько попыток, дедлайн, статус) лучше хранить не только в сообщении, а в своей модели данных (БД). Иначе вы получите сложности с консистентностью, повторными доставками и обновлением метаданных.
3. Модель данных задания: состояния, попытки и «когда можно умирать»
Независимо от очереди, вам нужна сущность задания. Условно: task_run (или job_execution), где хранится всё, что требуется для управления жизненным циклом.
3.1. Минимальный набор полей
Обычно достаточно:
id— уникальный идентификатор исполнения (важно для дедупликации);type— тип задания (например,send_email,sync_contact);payload— данные для выполнения (лучше сериализовать стабильно);state— статус:queued,running,succeeded,failed,dead;attempt— номер попытки;max_attempts— ограничение числа попыток;next_retry_at— когда можно сделать следующую попытку;deadline_at— окончательный дедлайн (жёсткий);created_at,updated_at;last_error— усечённое описание ошибки (для диагностики);idempotency_key— ключ идемпотентности (опционально, но часто нужен).
3.2. Почему deadline_at нужно хранить явно
Дедлайн часто ошибочно вычисляют «на лету» и теряют при повторных доставках. Поскольку ретраи могут приходить с задержкой, вы должны хранить жёсткую границу в persistent-хранилище.
При очередях вы также сталкиваетесь с тем, что сообщение может быть доставлено позже deadline_at из-за перегрузки, ретраев или политики брокера. Поэтому решение “отмена без исполнения” должно быть частью бизнес-логики.
4. Жизненный цикл и маршрутизация: от API до воркера
4.1. Создание задания
При запросе API вы:
- создаёте запись в БД со статусом
queuedи дедлайном; - публикуете в брокер (или кладёте в in-process очередь) «уведомление», что задача готова.
Если вы используете broker, стоит помнить о транзакционности: «записали в БД, но не отправили сообщение» и обратная ситуация. На практике применяют one of:
- Outbox pattern (таблица outbox + фоновой процесс синхронизации);
- транзакции с поддержкой конкретного брокера (редко);
- идемпотентность воркера + периодический reconciler (“подобрать застрявшие”).
На уровне статьи важно: не рассчитывайте, что публикация сообщения и запись в БД всегда синхронны без дополнительных гарантий.
4.2. Выбор задачи воркером
Если вы храните next_retry_at в БД, то воркер может забирать задачи по схеме:
state in ('queued','retrying')next_retry_at <= now()deadline_at > now()(иначе — сразуdeadилиfailed_due_deadline)- лимит по количеству на тик.
При этом воркер выставляет state=running и дальше выполняет работу.
5. Ретраи с backoff: как повторять, не превращая систему в самосвал ошибок
Ретраи — это не “повторить всегда”. Это политика, которая зависит от:
- типа ошибки;
- допустимого времени и количества попыток;
- состояния внешних систем;
- ограничений нагрузки.
5.1. Классификация ошибок: retryable vs non-retryable
Разделяйте ошибки на группы:
- retryable: временные сетевые проблемы, таймауты, 429 rate limit, 5xx от внешней системы (с оговорками);
- non-retryable: валидация входных данных, 4xx ошибки бизнес-уровня, ошибки формата;
- unknown: по умолчанию осторожно — часто лучше ограничить ретраи и логировать.
В Python это удобно сделать через маппинг исключений или коды ответов.
5.2. Exponential backoff с jitter
Классическая схема: delay = base * 2^(attempt-1). Но без jitter вы получите синхронизацию ретраев и «удар» по внешней системе.
Добавьте случайную составляющую:
- full jitter:
delay = random(0, cap)на основе попытки - или equal jitter:
delay = (cap + random(0, base)) / 2
Рассмотрим рабочую функцию.
import random
from datetime import timedelta

def compute_backoff_delay(
    attempt: int,
    base_seconds: float = 1.0,
    cap_seconds: float = 60.0,
    jitter: float = 0.5,  # 0..1: насколько сильно размываем
) -> timedelta:
    """
    attempt starts from 1.
    Example: attempt=1 -> ~1s, attempt=2 -> ~2s, ...
    """
    exp = base_seconds * (2 ** (attempt - 1))
    capped = min(exp, cap_seconds)

    # Полу-джиттер: слегка рандомизируем delay
    # delay_final = capped*(1-jitter) .. capped*(1+jitter)
    spread = capped * jitter
    delay_seconds = capped + random.uniform(-spread, spread)
    delay_seconds = max(0.0, delay_seconds)

    return timedelta(seconds=delay_seconds)
5.3. Ретраить до дедлайна, а не до бесконечности
Правильная формула: даже если политика backoff предлагает “ещё чуть-чуть”, нужно остановиться, если now + delay > deadline_at.
Алгоритм для воркера:
- проверить
now > deadline_at→ пометить какdead; - иначе проверить
attempt < max_attempts; - иначе вычислить
delayиnext_retry_at = min(deadline_at, now + delay)по правилам (обычно: если next_retry_at <= deadline_at — ставим ретрай, иначе — dead); - сохранить
attempt += 1иstate='retrying'.
6. Как не допустить “вечных” задач без дедлайна
Это один из самых частых провалов. “Вечная” задача появляется из-за одной из причин:
- дедлайн не хранится и вычисляется неправильно;
- дедлайн есть, но воркер его не проверяет (или делает проверку до планирования ретрая, а потом забывает);
- лимит попыток отсутствует;
- ошибка классифицирована как retryable всегда, включая перманентные;
- сообщения могут возвращаться в очередь повторно, а состояние задачи не обновляется транзакционно.
6.1. Жёсткая дисциплина: дедлайн — обязательный атрибут
С точки зрения дизайна, любые задания должны иметь deadline_at. Если бизнес не задаёт дедлайн — вы вводите технический по умолчанию (например, 24 часа) и чётко документируете.
Также держите отдельные причины остановки:
failed_due_deadline;failed_due_max_attempts;failed_non_retryable.
Это сильно улучшает диагностику.
6.2. Воркер должен быть “ленивым” к ошибкам: проверять состояние до попытки
Перед выполнением:
- задача может уже быть
succeededдругим воркером (если вы допускаете конкуренцию); - дедлайн мог пройти;
- attempt мог увеличиться из-за параллельных ретраев.
Проверяйте актуальность: идемпотентность — отдельная тема, но минимальная проверка статуса и дедлайна помогает избежать лишних действий.
6.3. Конкуренция воркеров: lock или атомарное обновление
Когда несколько воркеров выбирают задачи, без атомарности вы рискуете выполнить одно и то же дважды.
Одна из практик: атомарное “захватить задачу” через условный update в БД:
- update где
state='queued'иnext_retry_at <= nowиdeadline_at > now; - если
rowcount == 1, вы “взяли” задачу; - дальше выполняете.
Пример на SQLAlchemy Core (идея, адаптируйте под ваш стек):
from datetime import datetime, timezone
from sqlalchemy import update, and_
from sqlalchemy.ext.asyncio import AsyncSession

async def try_acquire_task(session: AsyncSession, now: datetime):
    """
    Пытается атомарно перевести задачу из queued -> running.
    Должна возвращать task_id или None.
    """
    # Допустим, у вас есть таблица task_run с нужными полями.
    # tasks = Table('task_run', ...)

    stmt = (
        update(tasks)
        .where(
            and_(
                tasks.c.state == "queued",
                tasks.c.next_retry_at <= now,
                tasks.c.deadline_at > now,
            )
        )
        .values(
            state="running",
            updated_at=now,
        )
        .returning(tasks.c.id)
    )

    # В зависимости от СУБД: может потребоваться limit/ordering через select-for-update.
    result = await session.execute(stmt)
    row = result.first()
    await session.commit()
    return row[0] if row else None
В реальности под Postgres/SQL Server обычно делают SELECT ... FOR UPDATE SKIP LOCKED или используют “пакетный” отбор с ограничением по времени и статусу. Смысл: захват должен быть атомарным.
7. Конструкция воркера: структура кода без скрытых ловушек
Ниже — скелет воркера, который:
- забирает задачу из БД (с учётом дедлайна и next_retry_at),
- выполняет,
- делает ретрай или завершает.
Для краткости будем считать, что вы используете БД как источник истины и периодический цикл.
import asyncio
from datetime import datetime, timezone
from dataclasses import dataclass

@dataclass
class TaskResult:
    ok: bool
    error_type: str | None = None  # "retryable" / "non_retryable"
    error_message: str | None = None

class RetryableError(Exception):
    pass

class NonRetryableError(Exception):
    pass

async def run_task_logic(task_type: str, payload: dict) -> None:
    """
    Тут ваша бизнес-логика.
    Важно: классифицируйте ошибки.
    """
    # пример:
    # await httpx.get(...)
    # если таймаут/5xx -> raise RetryableError
    # если валидация -> raise NonRetryableError
    raise NotImplementedError

async def worker_loop(session_factory, backoff_params):
    while True:
        now = datetime.now(timezone.utc)

        async with session_factory() as session:
            task_id = await try_acquire_task(session, now)

            if task_id is None:
                await asyncio.sleep(0.5)
                continue

            # загрузите задачу (payload, attempt, deadline, max_attempts)
            task = await load_task(session, task_id)

            try:
                await run_task_logic(task.type, task.payload)
            except RetryableError as e:
                await handle_retry(session, task, e, now, backoff_params)
            except NonRetryableError as e:
                await mark_dead_non_retryable(session, task, e, now)
            except Exception as e:
                # по умолчанию: ограниченные ретраи как "unknown retryable/partial"
                await handle_retry(session, task, e, now, backoff_params, unknown=True)
            else:
                await mark_succeeded(session, task, now)

        # ограничение нагрузки на цикл — отдельно регулируется пулом воркеров
        await asyncio.sleep(0)  # можно убрать или оставить

async def handle_retry(session, task, exc, now, backoff_params, unknown=False):
    # 1) дедлайн обязателен
    if now >= task.deadline_at:
        await mark_dead_deadline(session, task, exc, now)
        return

    # 2) ограничение попыток
    if task.attempt >= task.max_attempts:
        await mark_dead_max_attempts(session, task, exc, now)
        return

    # 3) планируем next_retry_at
    next_attempt = task.attempt + 1
    delay = compute_backoff_delay(next_attempt, **backoff_params)

    candidate = now + delay
    if candidate > task.deadline_at:
        # если следующий ретрай не успевает до дедлайна — не делаем
        await mark_dead_deadline(session, task, exc, now)
        return

    await schedule_retry(session, task, next_attempt, candidate, exc, now)
Ключевые моменты:
- дедлайн проверяется на обработке ретрая, а не только при захвате;
- retry классифицирован по исключениям;
- в
handle_retryрешение об остановке/планировании — централизовано.
8. Где хранить состояние: БД как источник истины или брокер как буфер
Есть соблазн: «пусть состояние живёт в сообщении». Это приводит к двум проблемам:
- сложно обновлять попытки и next_retry_at;
- сложно анализировать и повторно запускать с корректной истории.
Практика: БД — источник истины, брокер — средство сигнализации.
8.1. Что хранить в сообщении
В сообщении в очередь достаточно:
task_id(илиexecution_id),event_type(например,created),- опционально версию/хэш payload.
Тогда воркер:
- берёт задачу из БД по
task_id; - выполняет с учётом актуальных полей (deadline, attempt, state).
Это снижает риски гонок и рассинхронизаций.
8.2. Если вы выбираете in-process модель
Даже во внутренней очереди состояние лучше держать в БД для задач, где важна надёжность. В противном случае вы зависите от uptime процесса и теряете контроль над “забытыми” задачами после рестарта.
9. Дедлайны: не только поле, а поведение системы
Дедлайн — это контракт: что происходит, когда время вышло.
9.1. “Прекратить и пометить” vs “попытаться частично”
Для большинства задач выбирают “прекратить и пометить dead”. Это снижает риски и упрощает аудит.
Если бизнес требует частичного результата, это нужно оформлять как отдельные типы задач или сценарии, где промежуточные шаги имеют собственные дедлайны.
9.2. Таймауты внутри выполнения
Дедлайн верхнего уровня не заменяет таймауты I/O. В воркере всё равно нужно ограничивать:
- HTTP timeout;
- операции к внешним системам;
- CPU bound этапы.
Иначе задача “в дедлайн” может висеть на одном запросе и заблокировать воркер.
10. Масштабирование и контроль нагрузки: сколько воркеров нужно и как ограничить скорость
10.1. Параллелизм — через ограничение
В async-архитектуре важно ограничить число одновременных задач, иначе вы упрётесь в:
- лимиты БД,
- лимиты внешних API,
- собственные ресурсы.
Решение:
- фиксированное число воркеров (процессов/потоков);
- в каждом воркере — семафор или лимит concurrency.
10.2. Backpressure на уровне очереди/БД
Если очереди растёт, ретраи усиливают нагрузку. Поэтому:
- используйте
next_retry_atи сортировку/пакетный отбор, чтобы ретраи “расползались во времени”; - ограничивайте количество ретраев в период времени при деградации.
11. Наблюдаемость: без неё вы не узнаете, что система сломалась
Фоновые системы часто “молчат”. Поэтому минимальный набор метрик и логов обязателен.
11.1. Метрики
- число задач по статусам (
queued/running/succeeded/failed/dead); - попытки (attempt distribution);
- время до выполнения и время до дедлайна;
- ошибки по категориям retryable/non-retryable;
- глубина очереди/количество ожидающих в БД.
11.2. Логи с корреляцией
Логируйте task_id, type, attempt, deadline_at, next_retry_at, error_type. Это превращает расследование из “где-то что-то не так” в конкретную цепочку событий.
12. Практический чек-лист перед запуском
Перед тем как деплоить систему ретраев и воркеров, проверьте:
- Есть ли
deadline_atу каждой задачи (не “иногда”)? - Воркер всегда проверяет дедлайн перед выполнением и при планировании ретрая?
- Есть ли
max_attempts? - Ошибки строго классифицированы (retryable/non-retryable)?
- Backoff имеет jitter?
- Захват задачи атомарный (нет двойного выполнения)?
- Состояние хранится в БД, а в очереди только уведомления (
task_id)? - Есть таймауты внутри выполнения (I/O, сети)?
- Идемпотентность/дедупlication предусмотрены для критичных операций?
- Есть метрики/логи, позволяющие понять причину роста “dead” или “running”?
13. Вывод: фоновые задания — это архитектурная дисциплина
Проектирование фоновых задач в async-сервисах — это не вопрос библиотеки, а вопрос дисциплины жизненного цикла. Надёжная система почти всегда включает:
- явную модель состояния задания в persistent-хранилище;
- строгие дедлайны и лимиты попыток;
- ретраи с backoff и jitter, завязанные на классифицированные ошибки;
- атомарный захват задачи воркерами и продуманную идемпотентность;
- наблюдаемость, чтобы система не «падала в тишине».
Если вам хочется системно разобраться в том, как это связывать с async-подходом, очередями и практиками построения надёжных фоновых пайплайнов, полезно посмотреть тематические материалы, например учебный курс по этой зоне знаний: "/course/". Он может быть удобной точкой входа, но архитектурные принципы всё равно остаются неизменными: дедлайны, ретраи по правилам и управляемое состояние — основа устойчивости.