Python для аналитики на практике: как строить признаки и проверять их воспроизводимость
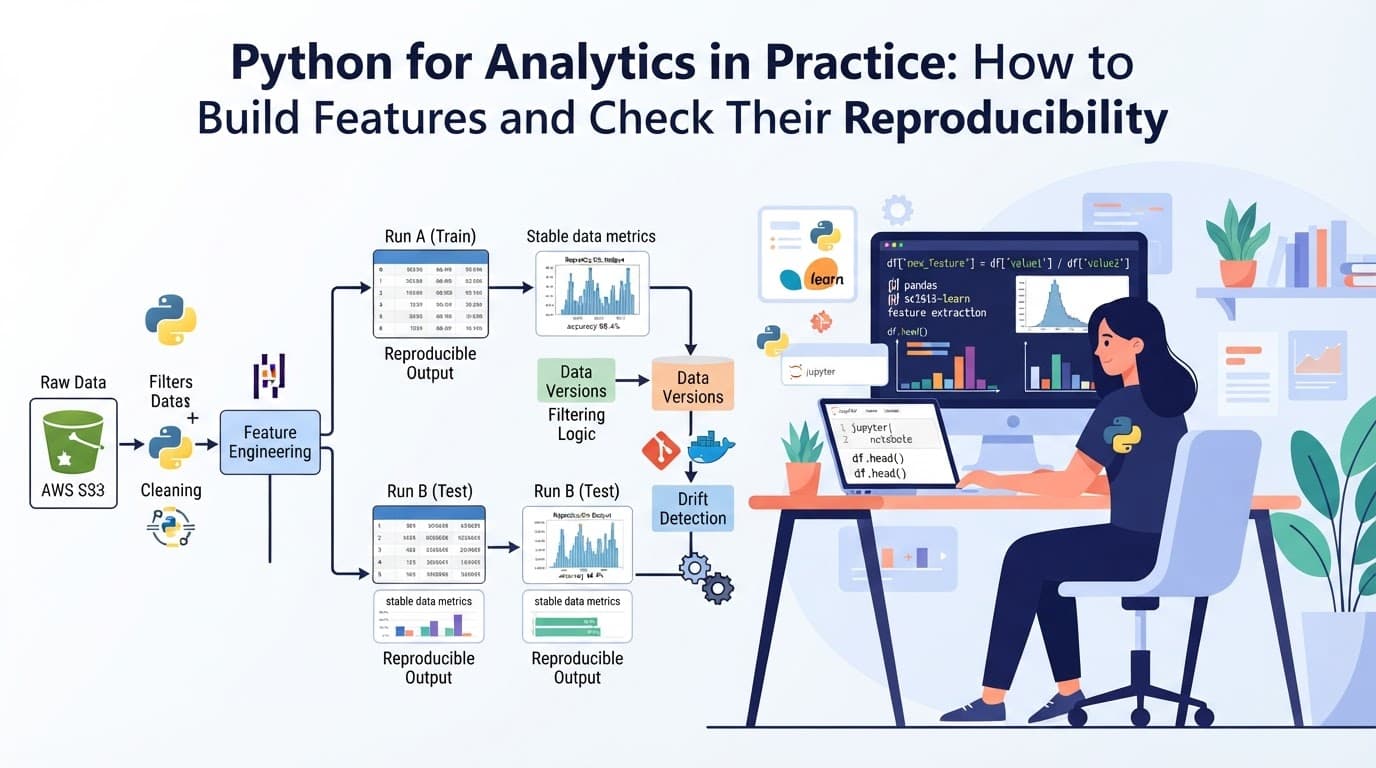
Поймём, где чаще всего ломается воспроизводимость (версии данных, фильтры, дрейф) и как оформить пайплайн признаков так, чтобы результаты совпадали между запусками и окружениями.
Содержание
Воспроизводимость в аналитике — не академическое требование, а прикладная необходимость. Если вы строите модель или отчет, а через неделю/на другом ноутбуке/на обновленном датасете получаете другие числа — проблема почти всегда находится не в «формуле метрики», а в том, как устроен пайплайн признаков: от версий данных и фильтров до обработки пропусков, сортировок и временных окон.
В этой статье разберём, где именно чаще всего ломается воспроизводимость при построении признаков в Python и как оформить признаки и их генерацию так, чтобы результаты совпадали между запусками и окружениями. Будем говорить не только про ML, но и про любую аналитическую задачу: скоринг, сегментацию, фичи для BI, подготовку данных для статистического анализа.
Почему воспроизводимость ломается чаще всего
Признаки — это не «вычисления в вакууме». Они зависят от:
- версии входных данных (и даже от того, когда именно вы считали фичи);
- правил фильтрации (набор строк, который «не явно» меняется);
- порядка и агрегаций (особенно при группировках и сортировках);
- тайм-логики (границы окна, часовые пояса, округления, включительность);
- пропусков и преобразований (NaN/None, типы данных, касты);
- окружения и зависимостей (версии pandas/numpy, поведение функций, float-представление);
- случайности (встраивание random-процессов, выборок, бутстрэп);
- скрытых «глобальных» состояний (кэш, файл-лоадер с latest, фоновые обновления).
Чтобы это стало управляемым, нужно перейти от «скриптов на ноутбуке» к пайплайну признаков с контролем входов, параметров и версий, плюс к проверкам воспроизводимости.
Базовые принципы воспроизводимого пайплайна признаков
Фиксируйте вход: данные, фильтры и параметры как артефакты
Воспроизводимость начинается с ответа на вопросы:
- Какая версия таблицы/файлов была использована?
- Какие фильтры применялись (и где они записаны)?
- Какой диапазон времени был включён?
- Какие константы и гиперпараметры использовались (например, минимальная длительность истории, сглаживание, пороги биннинга)?
- В каком формате и типах данные поступили на вход?
Практика: создавайте объект FeatureConfig, который содержит все параметры. Затем логируйте этот конфиг вместе с хешами входов. Это можно делать как в файле JSON, так и в метаданных (для MLOps/ELT — это обычно отдельный слой).
Делайте преобразования детерминированными
Даже если код «очевидно детерминированный», в реальности встречаются источники недетерминизма:
- использование
setбез сортировки при обходе; groupby+ преобразования, где порядок строк может влиять на результат (например, при оконных вычислениях);- выборочные сэмплинги (
sample(frac=..., random_state=None)); - неоднозначность типов при чтении (
read_csvс разной обработкой дат/NA).
Правило: в местах, где может появиться недетерминизм, вводите явные сортировки и random_state.
Самые частые причины несовпадений между запусками
1) Незаметные различия версий данных
Самый распространённый сценарий: вы запускаете пайплайн снова, а данные уже обновились. Даже если «таблица та же», изменились:
- несколько событий на границе окна;
- статусы клиентов;
- задержка доставки (late arriving data);
- дедупликация на upstream.
Что делать:
- фиксируйте snapshot: по дате/времени формирования или по версии выгрузки;
- включайте в конфиг параметр
as_of(cutoff time) илиsnapshot_id; - сохраняйте локальные копии входов для отладки (хотя бы хеш и схему).
Пример: храните as_of и используйте его в запросе, а не «берёте последнюю таблицу».
2) Расхождения в фильтрах и правилах отбора
Ломается воспроизводимость, когда фильтры задаются «в нескольких местах»:
- часть — в SQL, часть — в pandas;
- дата-фильтр в одном месте трактуется как
>=, а в другом как>; - часовой пояс в одном месте учитывается, в другом нет.
Что делать:
- храните фильтры централизованно;
- отдельно фиксируйте логику включительности границ;
- документируйте правило дедупликации (какой ключ и какая «победа» при дублях).
3) Дрифты в данных (concept/data drift)
Дрифт — это не ошибка пайплайна, но он выглядит как «не воспроизводится». Отличие тонкое:
- воспроизводимость нарушена из-за того, что входы меняются;
- или воспроизводимость нарушена при тех же входах, потому что пайплайн недетерминирован.
Что делать на практике:
- различайте два класса проблем:
- «меняются входы» — тогда числа могут меняться, это нормально, и нужно фиксировать snapshot;
- «входы одинаковы» — тогда числа должны совпадать; это уже проблема кода/окружения/логики.
Отдельная проверка: воспроизводимость на одном и том же snapshot.
4) Нестабильность сортировок, группировок и агрегаций
Когда вы делаете groupby, а затем используете методы зависящие от порядка (например, rolling, shift, cumcount), отсутствие явной сортировки часто приводит к различиям.
Что делать:
- сортируйте по ключам перед оконными вычислениями;
- фиксируйте порядок при агрегации, где это важно.
5) Различия типов данных и обработка пропусков
В pandas различия между:
NaN(float),None(object),pd.NA,- и различными dtype при чтении из CSV/Parquet
могут приводить к разным результатам, особенно если вы применяете fillna, сравнения ==, isnull, касты.
Что делать:
- после загрузки приводите типы к ожидаемым;
- централизованно описывайте правила пропусков: где мы оставляем NA, где заполняем, как трактуем «пустой строковый» vs «нет значения».
6) Окружение: версии библиотек и различия float-арифметики
Разные версии pandas/numpy иногда меняют:
- порядок сортировки при равных значениях;
- поведение некоторых функций;
- точность float в промежуточных шагах.
На практике «полностью бит-в-бит» чаще всего сложно, но воспроизводимость в пределах заданной толерантности вполне достижима.
Что делать:
- зафиксируйте версии зависимостей (lockfile, Docker);
- сравнивайте результаты с допуском (например, для чисел — относительная/абсолютная погрешность).
Как оформить пайплайн признаков: от конфигурации до детерминированного выполнения
Шаг 1. Опишите конфиг и правила
from dataclasses import dataclass
from typing import Optional, Tuple

@dataclass(frozen=True)
class FeatureConfig:
    as_of: str                  # cutoff, например "2026-09-01"
    min_history_days: int = 30
    time_zone: str = "UTC"
    dedup_key: Tuple[str, ...] = ("user_id", "event_id")
    numeric_fill: float = 0.0
    # правила фильтров
    include_event_types: Optional[Tuple[str, ...]] = None
Ключевое: frozen=True и явные параметры. Это снижает риск незаметных изменений.
Шаг 2. Логируйте входы и конфиг (хотя бы локально)
Минимальный уровень: хешируйте конфиг и сохраняйте его рядом с артефактами.
import hashlib, json
from dataclasses import asdict

def stable_json_dumps(obj) -> str:
    return json.dumps(obj, ensure_ascii=False, sort_keys=True, separators=(",", ":"))

def config_hash(cfg: FeatureConfig) -> str:
    payload = stable_json_dumps(asdict(cfg))
    return hashlib.sha256(payload.encode("utf-8")).hexdigest()
Если у вас есть возможность — добавьте хеш схемы и/или данных (например, по primary key + версии/дата снапшота).
Шаг 3. Сделайте преобразования детерминированными
Ниже пример детерминированной генерации признаков на событиях пользователя. Идея: строгая типизация, явная сортировка, консистентная логика временных окон.
import pandas as pd
import numpy as np

def build_user_features(
    events: pd.DataFrame,
    cfg: FeatureConfig
) -> pd.DataFrame:
    # Ожидаемые колонки: user_id, event_time, event_type, amount, event_id
    df = events.copy()

    # 1) Типы и нормализация
    df["event_time"] = pd.to_datetime(df["event_time"], utc=True)  # единый tz: UTC
    df["user_id"] = df["user_id"].astype("int64")
    df["event_type"] = df["event_type"].astype("string")
    df["amount"] = pd.to_numeric(df["amount"], errors="coerce")

    # 2) Дедупликация детерминированным способом
    # Допустим, при дублях оставляем событие с минимальным event_id (как детерминированное правило)
    dedup_cols = list(cfg.dedup_key)
    df = df.sort_values(dedup_cols + ["event_time"]).drop_duplicates(dedup_cols, keep="first")

    # 3) Фильтры
    as_of_ts = pd.Timestamp(cfg.as_of, tz="UTC")
    df = df[df["event_time"] < as_of_ts]

    if cfg.include_event_types is not None:
        df = df[df["event_type"].isin(cfg.include_event_types)]

    # 4) Ограничение истории: только события не старше заданного окна
    min_ts = as_of_ts - pd.Timedelta(days=cfg.min_history_days)
    df = df[df["event_time"] >= min_ts]

    # 5) Явная сортировка перед groupby/окнами (на всякий случай)
    df = df.sort_values(["user_id", "event_time"])

    # 6) Генерация признаков
    agg = df.groupby("user_id", as_index=False).agg(
        events_count=("event_type", "count"),
        total_amount=("amount", "sum"),
        mean_amount=("amount", "mean"),
        max_amount=("amount", "max"),
    )

    # 7) Заполнение пропусков строго по конфигу
    for col in ["total_amount", "mean_amount", "max_amount"]:
        agg[col] = agg[col].fillna(cfg.numeric_fill)

    # 8) Признаки должны иметь стабильные типы
    agg["events_count"] = agg["events_count"].astype("int64")

    return agg
Здесь воспроизводимость зависит от:
- детерминированной дедупликации (мы сортируем перед
drop_duplicates); - фиксированного cut-off
as_of; - явной временной логики;
- единых типах и tz.
Важно: это пример на pandas. Но те же принципы применимы к Spark/SQL: фиксируйте окна и сортировки, минимизируйте неявные преобразования.
Проверка воспроизводимости: что именно сравнивать
Проверять «что всё совпало» — слишком грубо. Лучше разделить контроль на уровни:
- Сходство набора строк (сколько пользователей/строк, сколько пропусков).
- Сходство распределений (например, через статистики: mean/quantiles).
- Точечное сравнение значений (с допуском для float).
- Ковариация и стабильность признаков (корреляции, ранговые метрики).
- Проверки метаданных: хеш конфигов, snapshot_id, версии окружения.
Практический подход: “детерминированный тест”
Ниже — пример функции сравнения двух датафреймов признаков.
def compare_feature_frames(
    a: pd.DataFrame,
    b: pd.DataFrame,
    key: str = "user_id",
    float_rtol: float = 1e-7,
    float_atol: float = 1e-9
) -> dict:
    # 1) Сравнение ключей
    a_sorted = a.sort_values(key).reset_index(drop=True)
    b_sorted = b.sort_values(key).reset_index(drop=True)

    if len(a_sorted) != len(b_sorted):
        return {"ok": False, "error": "row_count_diff", "a_len": len(a_sorted), "b_len": len(b_sorted)}
    if not (a_sorted[key].values == b_sorted[key].values).all():
        return {"ok": False, "error": "key_mismatch"}

    # 2) Сравнение колонок
    cols = [c for c in a_sorted.columns if c != key]
    diffs = {}

    for c in cols:
        a_col = a_sorted[c].values
        b_col = b_sorted[c].values

        if np.issubdtype(a_col.dtype, np.floating) or np.issubdtype(b_col.dtype, np.floating):
            close = np.isclose(a_col, b_col, rtol=float_rtol, atol=float_atol, equal_nan=True)
            if not close.all():
                # оценим “масштаб” расхождений
                delta = np.nanmax(np.abs(a_col - b_col))
                diffs[c] = {"type": "float", "max_abs_delta": float(delta)}
        else:
            eq = (a_col == b_col) | (pd.isna(a_col) & pd.isna(b_col))
            if not eq.all():
                diffs[c] = {"type": "exact"}

    ok = len(diffs) == 0
    return {"ok": ok, "diffs": diffs}
Эту проверку имеет смысл запускать:
- на одинаковом snapshot (должна пройти),
- на “почти одинаковом” наборе (должна показать ожидаемые отличия),
- и в CI/регрессиях при изменениях кода.
Проверка воспроизводимости по сценариям (а не одной кнопкой)
Сценарий A: “Та же версия данных, тот же конфиг”
Это основной тест на корректность воспроизводимости.
- фиксируйте
as_of/ snapshot; - запускайте пайплайн дважды;
- сравнивайте результат.
Если не совпадает — ищите:
- недетерминированную обработку;
- разницу типов и NA;
- зависящие от порядка вычисления;
- различия в версиях библиотек.
Сценарий B: “Тот же код, новый snapshot”
Здесь несовпадение — допустимо. Но полезно измерять:
- сколько пользователей добавилось/исчезло;
- насколько изменились распределения признаков.
Это уже контроль качества данных и сигнал о дрифте, но не «баг воспроизводимости».
Сценарий C: “Тот же snapshot, но другое окружение”
Это тест на переносимость.
- запускайте в Docker/CI с фиксированными версиями.
- если разница есть — вероятны проблемы с версиями numpy/pandas или с обработкой типов.
Частые подводные камни при построении признаков
1) “Временные” ошибки: границы окон и tz
Пример типичного бага: фильтр event_time < as_of vs <=, или разный tz в исходных данных. Симптом: меняются тысячи строк на границе дня.
Практика:
- переводите всё в один tz;
- фиксируйте точность cut-off (дата vs datetime);
- храните as_of как ISO-строку и применяйте единообразно.
2) Дедупликация “как получится”
Если вы делаете drop_duplicates без сортировки/критерия победителя, результат зависит от порядка строк — а порядок может меняться между загрузками.
Правило: дедуплицируйте детерминированно:
- сортировка по ключам + tie-breaker (например, минимальный event_id);
- или правило “последний по времени” — но тоже с явным sort.
3) Использование случайности для feature engineering
Иногда признаки зависят от:
- случайных выборок клиентов;
- бутстрэпа;
- инициализаций.
Если это нужно — фиксируйте random_state и документируйте. Для воспроизводимости лучше передавать seed через конфиг.
4) Невидимые преобразования в чтении данных
CSV vs Parquet может дать различия:
- dtype;
- округления;
- интерпретацию пустых значений;
- формат дат.
Решение:
- стандартизируйте формат входа;
- или делайте явное приведение dtype после чтения.
Рекомендованная структура проекта признаков
Даже если вы делаете анализ «для себя», структура сильно помогает воспроизводимости.
Минимальный каркас
configs/— JSON/YAML сFeatureConfig(или его аналогом);data/— входы (или хотя бы ссылки на snapshot);features/— код генерации;tests/— тесты воспроизводимости (на одинаковых снапшотах);runs/— артефакты (результаты, логи, метаданные).
Принцип “один источник правды” для логики фильтров
Фильтры должны жить в одном месте. Если часть логики растворена в SQL и частично в pandas, воспроизводимость становится хрупкой.
Как встроить воспроизводимость в регулярную разработку
Делайте “регрессионные” проверки
При каждом изменении кода признаков прогоняйте:
- тест “та же версия данных” (должны совпасть);
- тест “контрольные статистики” (допуск по float);
- проверки схемы (колонки, dtype).
Отдельно фиксируйте зависимости
Реально полезный минимум:
requirements.txt/poetry.lock;- либо контейнер Docker.
Воспроизводимость — это не только ваш код, но и версия вычислителей.
Практический пример: небольшой пайплайн с конфигом, хешом и тестом
Ниже объединённый скелет: конфиг → построение признаков → сравнение результатов двух запусков на одном и том же events.
# 1) Конфиг
cfg = FeatureConfig(
    as_of="2026-09-01",
    min_history_days=30,
    include_event_types=("click", "purchase"),
)

print("cfg_hash:", config_hash(cfg))

# 2) Допустим, events уже загружены из snapshot (важно!)
# events = load_events_snapshot(snapshot_id=...)

features_1 = build_user_features(events, cfg)
features_2 = build_user_features(events, cfg)

result = compare_feature_frames(features_1, features_2, key="user_id")

print(result)
Если result["ok"] окажется False, дальше нужно локализовать расхождение:
- какие именно колонки отличаются;
- отличаются ли ключи/количество строк;
- зависят ли расхождения от порядка;
- есть ли проблемы в конкретном шаге (дедупликация, fillna, окна).
Что делать, если результаты совпадают, но “чуть-чуть разные” по float
В практической аналитике часто возникают расхождения порядка 1e-10 — 1e-7. Это может быть нормально, если:
- меняется только знак/округление в пределах допустимого;
- логические признаки (категории, флаги) совпадают;
- метрики моделей не “ломаются”.
Тогда вместо требования “бит-в-бит” вводят допуск и сравнение распределений.
Но если отклонение большое — ищите конкретный источник:
- другой dtype (float32 vs float64);
- другой порядок агрегации (коммутативность нарушается из-за потоков/суммирования);
- разная обработка NaN.
Как аккуратно выстроить обучение и углубить тему
Если вы хотите системно закрепить подходы к данным, признакам и воспроизводимости именно на Python-практике, часто полезно иметь структурированную программу и разбор реальных задач. В этом плане стоит обратить внимание на курс Python для аналитиков — как на способ собрать в один пайплайн навыки подготовки данных, feature engineering и инженерных практик, включая контроль качества и проверяемость результатов.
Выводы: чеклист воспроизводимых признаков
Воспроизводимость при построении признаков ломается в основном там, где:
- меняются входные данные (snapshot/версии);
- фильтры и временные окна применяются неодинаково;
- есть недетерминированность порядка строк (особенно перед дедупликацией/окнами);
- отличаются типы данных и трактовка пропусков;
- не фиксированы версии библиотек или есть различия окружений;
- присутствует случайность без seed.
Чтобы результаты совпадали между запусками и окружениями, придерживайтесь принципов:
- Фиксируйте входы и параметры (snapshot_id/as_of + конфиг).
- Сделайте преобразования детерминированными (сортировки, правила дедупликации, единая tz).
- Логируйте метаданные (хеш конфига, версии зависимостей).
- Проводите проверки воспроизводимости: сравнение строк/ключей/значений с допуском и статистики.
- Разделяйте два класса проблем: “изменились входы” vs “код недетерминирован”.
Если внедрить это в обычный аналитический workflow, то признаковое “плавающее качество” превращается в управляемую инженерную систему: вы быстрее находите причины расхождений, надежнее повторяете эксперименты и меньше времени тратите на “почему цифры поменялись”.