Статьи по теме
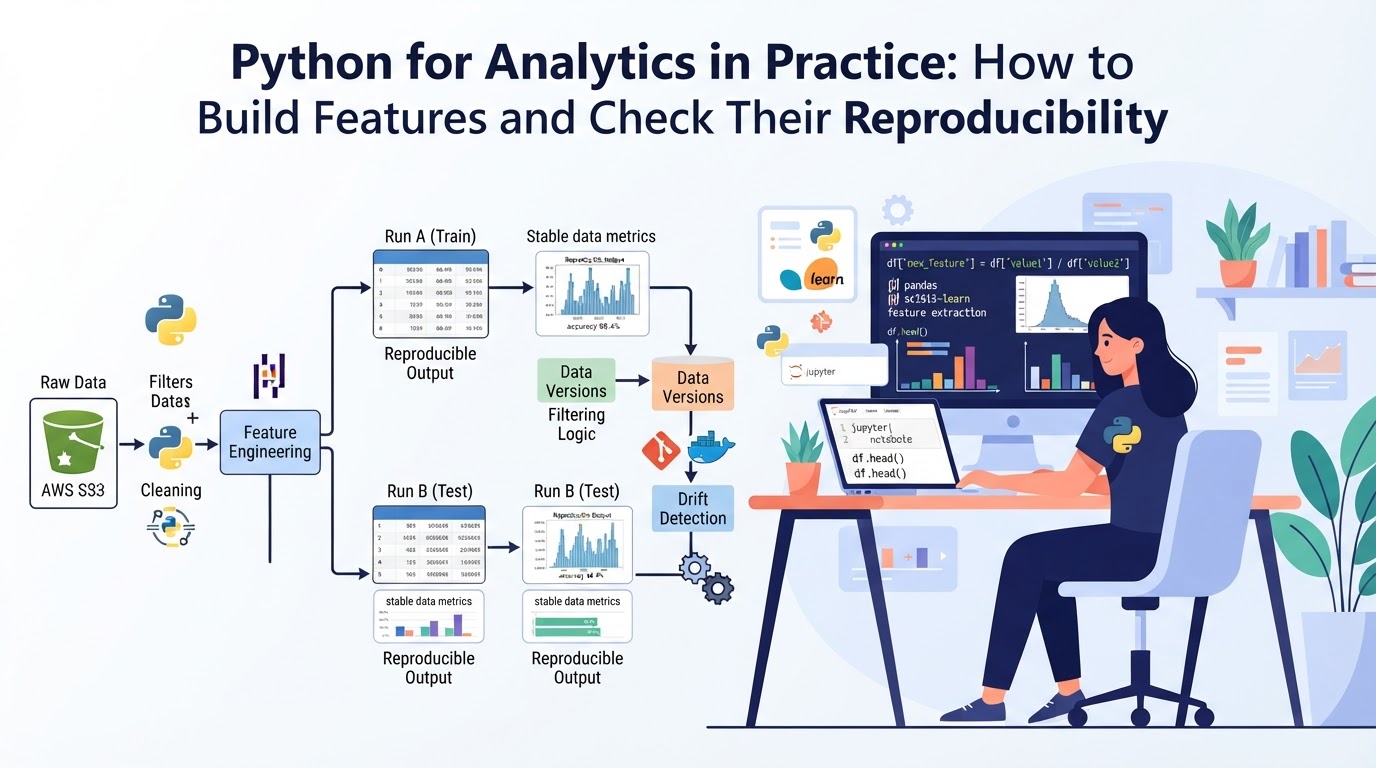
Python для аналитики на практике: как строить признаки и проверять их воспроизводимость
Поймём, где чаще всего ломается воспроизводимость (версии данных, фильтры, дрейф) и как оформить пайплайн признаков так, чтобы результаты совпадали между запусками и окружениями.
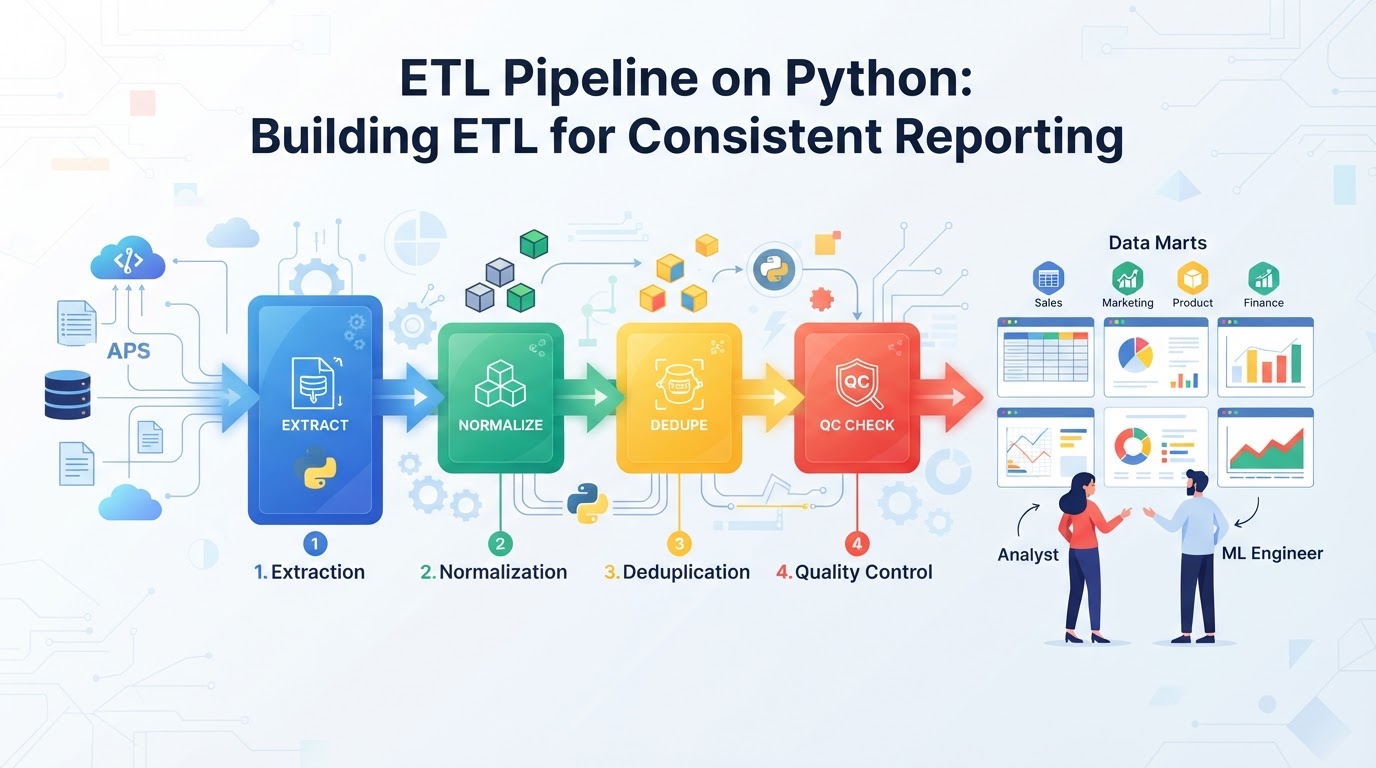
Аналитический пайплайн на Python: как собрать ETL так, чтобы отчёты сходились
Покажем практический подход к построению ETL: извлечение, нормализация данных, дедупликация, витрины и контроль качества. Статья будет полезна аналитикам и ML-инженерам, которым важно, чтобы метрики не расходились между командами.