Аналитический пайплайн на Python: как собрать ETL так, чтобы отчёты сходились
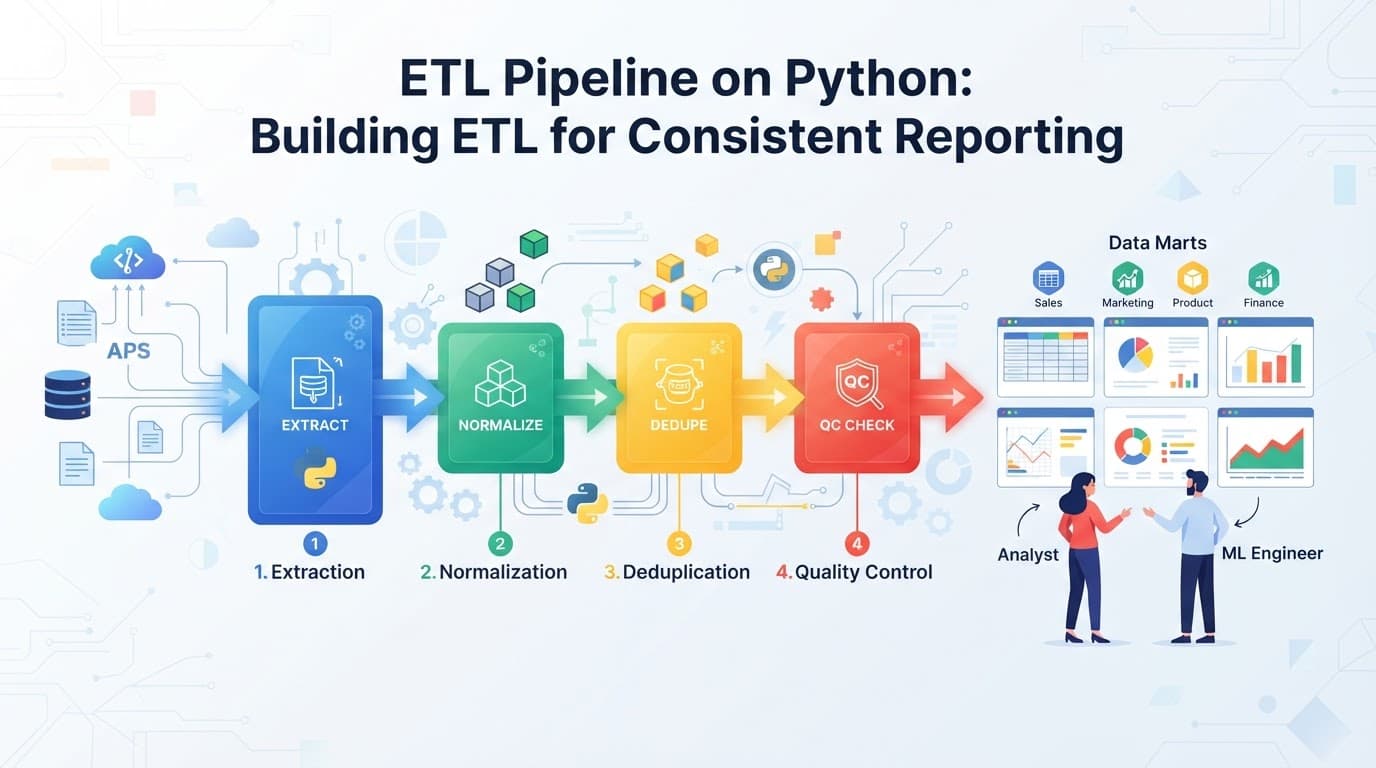
Покажем практический подход к построению ETL: извлечение, нормализация данных, дедупликация, витрины и контроль качества. Статья будет полезна аналитикам и ML-инженерам, которым важно, чтобы метрики не расходились между командами.
Содержание
ETL для аналитики — это не «вытащить данные, положить в таблицу и сделать дашборд». На практике аналитические метрики расходятся между командами чаще всего не потому, что кто-то «плохо посчитал», а потому, что у разных пайплайнов разный смысл вычислений: в одном месте даты обрезаются по UTC, в другом — по локальному времени; где-то дедупликация производится по user_id, а где-то — по паре (user_id, event_id); где-то замеры идут по факту поступления, а где-то — по времени события.
Чтобы отчёты сходились, ETL должен быть построен как система с явными правилами нормализации, воспроизводимыми идентификаторами сущностей, управляемой дедупликацией, понятными витринами (слоями) и измеримым контролем качества. Ниже — практический подход, который можно реализовать на Python и затем адаптировать под конкретные хранилища данных.
Проблемы «несходящихся» метрик: что обычно идёт не так
Прежде чем строить пайплайн, полезно зафиксировать, какие именно расхождения чаще всего возникают.
Таймзоны, границы периодов и «скользящие» окна
Одна команда считает «день» по локальному времени, другая — по UTC. В результате события на границе суток оказываются в разных днях. Аналогично, «неделя» может трактоваться как ISO-неделя или календарная, а фильтр может быть «включительно/исключительно».
Разные определения сущностей
Частая история: в одном отчёте «активный пользователь» определяется как events >= 1 за сутки, в другом — как distinct sessions >= 1. Если слой «сущностей» не стандартизирован, витрины будут расходиться.
Нечёткая дедупликация
Если события реплицируются (повторная доставка из очереди, повторные выгрузки из источника), без дедупликации вы получите завышенные метрики. Но «правильная» дедупликация зависит от ключа и политики.
Несогласованные маппинги и нормализация
В источниках встречаются:
- пустые строки и
NULLв разных формах; - разные нейминги категорий;
- разные форматы идентификаторов (например, UUID в верхнем/нижнем регистре).
Если нормализация не стандартизирована, вы начинаете «считать разные вещи», даже если внешне поля одинаковые.
Отсутствие контроля качества
Без контрольных метрик пайплайн часто работает «в целом», но по одной из веток начинает терять события или загружать дубль. Разница на 0.1–1% метрик может быть незаметна на уровне одного дашборда, но станет большой проблемой при сопоставлении между командами.
Архитектура ETL для сходящихся отчётов: слои и контракты
Устойчивые аналитические пайплайны обычно строятся по слоистой модели. Мы будем говорить про ETL, но важно понимать: «слои» — это не только про БД, это про контракты данных и ответственность на каждом шаге.
Рекомендуемые слои
- Landing / Raw — сохраняем данные как есть (в идеале — неизменяемо).
Цель: воспроизводимость и аудит. - Staging / Normalized — приводим поля к единому формату: типы, ключи, нормализованные строки, стандартизируем времена и т.д.
- Dedup / Clean — устраняем дубликаты и приводим к единственному представлению события/сущности.
- Mart / Analytics — витрины под аналитические задачи: факты и измерения.
- Quality / Metrics — отдельные таблицы/логи качества: контрольные суммы, счётчики, отклонения, выборки для расследования.
Контракты (что фиксируем заранее)
- Схема источника: какие поля должны быть, какие могут отсутствовать, какие форматы ожидаются.
- Правила нормализации: например, как приводим
user_id, как трактуем пустые значения, как округляем суммы. - Ключ дедупликации: чем различаются события и какие повторения считаются дублем.
- Политика инкрементов: как обрабатываем «догон» и поздние события.
- Витринные определения: что такое факт активности, что входит в «заказ», как считается ретеншн, и т.д.
Извлечение (Extract): стратегии загрузки и инкрементальность
Извлечение может быть разным: API, файлы, БД, очереди. Ключевая идея для сходимости отчётов — управлять тем, какие именно данные учтены.
Batch vs Incremental
- Batch (полная перезагрузка) прост, но часто дорог и нестабилен по времени.
- Incremental (частичная загрузка) сложнее, зато лучше контролирует стоимость и задержки.
На практике часто используют гибрид:
- ежедневно — инкремент;
- раз в неделю/месяц — бэкфилл (пересборка последних N дней).
Маркер загрузки и идемпотентность
Независимо от источника, пайплайн должен быть идемпотентным: повторный запуск на том же периоде не должен менять конечные витрины (или должен менять предсказуемо).
Для этого обычно вводят:
batch_id/run_id,- временное окно (
from_ts,to_ts), - таблицу контроля загрузок (сколько строк пришло, сколько обработали, что осталось в ошибках).
Нормализация данных (Transform): унификация типов, ключей и времени
Большая часть «расходящихся» метрик начинается здесь. На этом шаге вы должны превратить «сырые» поля в стандартизованные.
Практический набор нормализации
Рассмотрим типовую таблицу событий events_raw со столбцами:
event_id— уникальный идентификатор события (как заявляет источник),user_id— идентификатор пользователя (может быть строкой),event_ts— timestamp события (может прийти как строка),event_type— тип события,amount— сумма (может быть строкой),currency— валюта,source— источник.
Пример нормализации на pandas
import pandas as pd

def normalize_events(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()

    # 1) Унификация типов
    df["event_id"] = df["event_id"].astype(str).str.strip()
    df["user_id"] = df["user_id"].astype(str).str.strip().str.lower()

    # 2) Нормализация event_type
    df["event_type"] = (
        df["event_type"].astype(str).str.strip().str.lower()
    )

    # 3) Приведение чисел
    df["amount"] = pd.to_numeric(df["amount"], errors="coerce")

    # 4) Валюта: верхний регистр, пустые -> NULL
    df["currency"] = df["currency"].astype(str).str.strip().str.upper()
    df.loc[df["currency"] == "", "currency"] = None

    # 5) Время: парсинг + единая временная зона
    # Предположим, что source присылает UTC-таймстемпы строками
    df["event_ts"] = pd.to_datetime(df["event_ts"], errors="coerce", utc=True)

    # 6) Фильтруем явный мусор (но с фиксацией качества!)
    df = df.dropna(subset=["event_id", "user_id", "event_type", "event_ts"])

    return df
Важно: в реальных пайплайнах удаление строк «напрямую» без учёта качества — это путь к скрытым расхождениям. Лучше отправлять «плохие» записи в отдельный error-контур.
Нормализация дат для витрин
Если вы строите дневные отчёты, вы должны однозначно определить:
- по какой timezone считать день,
- как трактовать события без валидного времени.
Например, если отчетность ведётся по UTC-дню, делаем:
def add_event_date_utc(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()
    df["event_date"] = df["event_ts"].dt.floor("D")
    return df
Если бизнесу нужен локальный часовой пояс (например, Europe/Moscow), то правило должно быть единым и явно зафиксированным.
Дедупликация (Dedup): ключи, окна и детерминированность
Дедупликация — второй по важности источник расхождений. Здесь критично правильно выбрать ключ события и определить, что считать дублем.
Варианты дублей
- Полные дубли: одинаковые
event_idи поля. - Повторная доставка: тот же
event_id, но поля могут отличаться из-за поздней калибровки. - Неустойчивые идентификаторы:
event_idне гарантированно уникален (редко, но бывает). - Дубли по содержимому: возможно, стоит собирать хэш и дедупить по нему.
Практическая политика дедупликации
Хорошая политика обычно выглядит так:
- основной ключ:
event_id; - если
event_idпуст/невалиден — используем fallback: хэш от(user_id, event_type, event_ts, amount); - при конфликтах выбираем «наиболее свежую» запись по
ingest_tsили выбираем запись с непустыми полями.
Пример дедупликации в pandas
import hashlib

def deduplicate_events(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()

    # Введём ingest_ts как время загрузки (в нормализованных данных оно должно быть)
    # Если в ваших данных нет ingest_ts, добавьте его на этапе Extract или Landing.
    # df["ingest_ts"] = pd.to_datetime(df["ingest_ts"], utc=True)

    # Хэш для fallback, если event_id невалиден
    def row_hash(r) -> str:
        s = f"{r['user_id']}|{r['event_type']}|{r['event_ts'].isoformat()}|{r.get('amount')}|{r.get('currency')}"
        return hashlib.sha256(s.encode("utf-8")).hexdigest()

    mask_bad_id = df["event_id"].isna() | (df["event_id"].str.len() == 0)
    df.loc[mask_bad_id, "event_id"] = df[mask_bad_id].apply(row_hash, axis=1)

    # Дедуп по event_id: оставляем запись с максимальным ingest_ts
    df = df.sort_values("ingest_ts").drop_duplicates(subset=["event_id"], keep="last")

    return df
Подводный камень: дедупликация должна быть детерминированной. Если вы сортируете по полю, которое одинаково для нескольких записей, результат может меняться от прогона к прогону. Тогда добавьте вторичный критерий (например, batch_id).
Окна дедупликации для инкрементов
Инкрементальная загрузка часто вызывает ситуацию: событие могло прийти повторно в более поздней выгрузке, и тогда оно должно быть учтено в дедуп-представлении. Практика:
- делайте дедупликацию на уровне «последних N дней» (или по периоду инкремента плюс буфер),
- храните
event_id(или ключ) в отдельной уникальной таблице, чтобы быстро отсеивать ранее обработанные.
Построение витрин (Mart): факты, измерения и единые определения
Витрины — это не просто «агрегации на лету». Чтобы команды считали одинаковые метрики, витрины должны отражать согласованные определения и быть источником правды.
Факты и измерения
Типовой подход:
- dim_user: справочник пользователей (атрибуты, с историчностью или без),
- fact_events: нормализованные события,
- fact_orders / fact_facts: агрегаты по доменной логике,
- dim_date: календарная таблица (иногда генерация).
Стабилизация гранулярности
Частый источник расхождений — разные уровни детализации:
- команда 1 агрегирует прямо из событий;
- команда 2 сначала дедупит и строит промежуточные факты, а потом агрегирует.
На уровне архитектуры лучше сделать витрину фактов в единой гранулярности. Например:
- витрина фактов по событиям: по
event_id(атомарно), - витрина метрик: дневные/недельные агрегаты, построенные из этой витрины, а не из raw.
Пример построения дневной витрины
Допустим, у нас уже есть events_clean с полями event_date, event_type, user_id.
def build_daily_event_metrics(events_clean: pd.DataFrame) -> pd.DataFrame:
    df = events_clean.copy()

    # Пример: количество событий и число уникальных пользователей по типу события за день
    daily = (
        df.groupby(["event_date", "event_type"])
          .agg(
              events_count=("event_id", "count"),
              users_count=("user_id", "nunique"),
          )
          .reset_index()
    )

    return daily
Если в аналитике метрика «активность пользователя» определяется как наличие хотя бы одного события определённых типов в день, делайте это централизованно:
ACTIVE_TYPES = {"page_view", "login", "purchase"}

def build_daily_active_users(events_clean: pd.DataFrame) -> pd.DataFrame:
    df = events_clean.copy()
    df = df[df["event_type"].isin(ACTIVE_TYPES)]

    active = (
        df.groupby("event_date")
          .agg(active_users=("user_id", "nunique"))
          .reset_index()
    )

    return active
Так вы минимизируете риск, что разные команды по-разному трактуют активность.
Контроль качества (Quality): как заставить пайплайн «доказывать» корректность
Контроль качества — это не только «проверки на пустоту». Для сходящихся отчётов нужны количественные метрики качества и механизмы расследования.
Какие проверки полезны
- Схемные проверки: наличие обязательных колонок, типы, допустимые значения.
- Дедуп-проверки: доля дублей по ключу, количество конфликтов.
- Объёмные проверки: сколько строк на входе и на выходе, соотношение «ожидается/получено».
- Проверки распределений: например, доля
NULLв ключевых полях не должна расти. - Контроль инкрементов: суммарное количество обработанных событий по
batch_idдолжно совпадать с Landing. - Согласование агрегатов: сравнить дневные итоги с предыдущей версией (в пределах допуска).
Метрики качества на уровне кода
Пример каркаса, который собирает результаты проверок в структуру, пригодную для записи в отдельную таблицу:
from dataclasses import dataclass, asdict
import pandas as pd

@dataclass
class QualityCheckResult:
    check_name: str
    passed: bool
    detail: str

def quality_checks(raw_df: pd.DataFrame, clean_df: pd.DataFrame) -> list[QualityCheckResult]:
    results = []

    # 1) Доля пропусков ключей
    key_cols = ["event_id", "user_id", "event_type", "event_ts"]
    missing_rate = clean_df[key_cols].isna().mean().mean()
    results.append(QualityCheckResult(
        check_name="missing_rate_keys",
        passed=missing_rate < 0.001,
        detail=f"missing_rate_keys={missing_rate:.6f}"
    ))

    # 2) Дедуп: уникальность event_id
    dup_rate = 1.0 - (clean_df["event_id"].nunique() / len(clean_df)) if len(clean_df) else 0
    results.append(QualityCheckResult(
        check_name="dedup_event_id_rate",
        passed=dup_rate < 0.001,
        detail=f"dup_rate={dup_rate:.6f}"
    ))

    # 3) Объём: нет ли резкого падения после нормализации
    raw_cnt = len(raw_df)
    clean_cnt = len(clean_df)
    drop_ratio = (raw_cnt - clean_cnt) / raw_cnt if raw_cnt else 0
    results.append(QualityCheckResult(
        check_name="row_drop_ratio",
        passed=drop_ratio < 0.05,
        detail=f"raw_cnt={raw_cnt}, clean_cnt={clean_cnt}, drop_ratio={drop_ratio:.4f}"
    ))

    return results
Ключевой момент: пороги (например, < 0.001) должны быть основаны на истории данных и бизнесе. Если вы ставите «жёстко 0» без учёта реальной природы источника, пайплайн будет часто падать по нормальным колебаниям.
Бэктест качества: сравнение версии витрин
Для сходящихся отчётов полезно поддерживать версионирование пайплайна (или хотя бы контроль параметров). Тогда вы можете:
- пересобрать витрину для конкретного периода,
- сравнить агрегаты (например,
active_usersпо дням) с предыдущей версией, - при отклонениях — сохранить diff для анализа.
Инкрементальные пересчёты и поздние события: как не «отстрелить себе ноги»
В реальности события могут приходить с задержкой. Если вы агрегируете «закрытые» дни раз и навсегда, то дневные метрики будут корректны только на момент сборки.
Практика: backfill window
Решение — держать окно переобработки, например:
- ежедневно пересчитывать последние 3–7 дней,
- для старых дней не менять витрину (или пересчитывать раз в неделю).
Так вы учтёте поздние события и всё равно ограничите нагрузку.
Контракт по времени
Вы должны определить:
- агрегаты строятся по
event_ts(время события) или поingest_ts(время поступления)? - для аналитики обычно берут
event_ts, но для оперативных метрик может быть иначе.
Главное — сделать правило явным и неизменным.
Типичные ошибки и как их избежать
1) Считать метрики «в разных местах»
Если одна команда собирает активность через raw, а другая — через cleaned, вы гарантированно получите расхождения. Решение: одна витрина как источник правды.
2) «Удалили мусор и забыли»
Если нормализация отбрасывает записи, но вы не фиксируете сколько и почему — несходство метрик станет «необъяснимым». Решение: error-таблица + качество-метрики.
3) Недиетерминированные операции дедупликации
Если при дедупе равные ключи выбираются непредсказуемо, результаты со временем могут меняться. Решение: детерминированный порядок и явный tie-breaker.
4) Изменение правил нормализации без версионирования
Переименовали типы события или поменяли маппинг currency — и метрики «поплыли». Решение: версионируйте правила трансформаций и фиксируйте их в метаданных пайплайна.
5) Нет возможности быстро расследовать
Пайплайн должен давать ответы на вопросы:
- сколько событий пришло,
- сколько стало валидными,
- сколько выпало,
- где именно произошла потеря,
- какие события попали в дедуп конфликт.
Минимальный рабочий пайплайн: каркас на Python
Ниже — упрощённый пример «скелета» пайплайна: extract → normalize → dedup → build mart → quality log. Он не привязан к конкретной БД, но демонстрирует связность шагов.
from datetime import datetime, timezone
import pandas as pd

def extract_events(source_conn, from_ts: datetime, to_ts: datetime) -> pd.DataFrame:
    # Заглушка: здесь должен быть запрос к источнику
    # Важно: возвращайте ingest_ts и event_ts в едином формате/часовом поясе
    raise NotImplementedError

def load_to_landing(df: pd.DataFrame, batch_id: str):
    # Заглушка: сохранение в Landing/Raw
    pass

def save_quality(results: list[dict], run_id: str):
    # Заглушка: запись результатов в таблицу quality
    pass

def build_pipeline(source_conn, batch_id: str, from_ts: datetime, to_ts: datetime):
    run_id = f"run_{batch_id}"
    raw = extract_events(source_conn, from_ts, to_ts)

    load_to_landing(raw, batch_id=batch_id)

    normalized = normalize_events(raw)          # см. выше
    normalized = add_event_date_utc(normalized)

    # В production ingest_ts должен существовать
    if "ingest_ts" not in normalized.columns:
        normalized["ingest_ts"] = pd.Timestamp.now(tz="UTC")

    clean = deduplicate_events(normalized)     # см. выше

    mart_daily = build_daily_event_metrics(clean)

    # Качество: сравнение raw vs clean
    qc_results = quality_checks(raw, clean)
    save_quality([asdict(r) for r in qc_results], run_id=run_id)

    # Заглушки: запись в витрины
    # save_to_fact_events(clean)
    # save_to_mart_daily(mart_daily)
    return mart_daily
Здесь важнее не конкретная технология хранения, а принципы:
Landingотделён отMart;- нормализация и дедуп выполняются до витрин;
- качество считается и сохраняется как сущность пайплайна;
- инкремент обрабатывает окно данных с определёнными правилами.
Как организовать совместную работу аналитиков и ML-инженеров
Сходимость метрик — это ещё и организационная инженерия.
Единый слой определения метрик
Сделайте так, чтобы «метрика» была связана с:
- витриной (таблицей),
- формулой,
- версией пайплайна,
- параметрами окна/часового пояса.
Тогда ML и аналитика не будут спорить о том, что такое “active user”: они будут работать с одной таблицей.
Документация и метаданные
Минимум:
- README к каждому витринному слою,
- схема полей,
- правила нормализации и дедупликации,
- как обрабатываются late events.
Согласованные тесты на качество
Когда команды делят пайплайн, они должны разделять и ответственность за качество:
- какие отклонения допустимы,
- что считается блокером,
- какие расследования требуют участия данных.
Вывод: ETL как инженерная дисциплина, а не скрипт
ETL, который делает отчёты сходящимися, должен быть построен вокруг строгих правил и воспроизводимости:
- нормализация фиксирует единый смысл полей и времени;
- дедупликация устраняет повторные доставки детерминированно;
- витрины становятся источником правды с согласованной гранулярностью;
- контроль качества превращает «угадывания» в измеримые проверки.
Если вы хотите глубже разобраться именно в том, как структурировать пайплайны на Python (от прототипов до поддерживаемых модулей, тестов данных и качественных агрегаций), полезной опорой может стать курс Python для аналитиков — как один из способов систематизировать практики, которые здесь мы рассмотрели на уровне архитектуры.
Если хотите, могу адаптировать пример под вашу конкретную схему данных (какие поля есть, как устроен event stream, какое хранилище используется) и предложить набор витрин и проверок качества под ваши метрики.