SQL: диаграмма жизненного цикла индекса — от EXPLAIN до теста на регрессию производительности
Покажем практический процесс: как определить, какой индекс реально используется, когда он бесполезен, как проверить влияние после изменений схемы и как не словить деградацию запросов в будущем.
Содержание
Индекс в SQL — это не “галочка для ускорения”. Это артефакт, который появляется, используется, стареет и иногда становится вредным. В крупных проектах индексная политика — часть инженерной дисциплины: вы должны уметь доказать, что индекс реально помогает именно вашим запросам, предсказать эффект от изменений схемы и не получить деградацию производительности “вчера всё было быстрее”.
Ниже — практическая диаграмма жизненного цикла индекса и пошаговый процесс, который помогает пройти путь от гипотезы до регрессионного теста. Материал ориентирован на PostgreSQL, но логика применима и к другим СУБД (MySQL, SQL Server, Oracle) с поправкой на детали планировщика и статистики.
1) Инвентарь: откуда берётся индекс и что считать “используется”
1.1. На что смотреть в первую очередь: планы запросов и фактическое исполнение
Жизненный цикл индекса начинается с понимания: какой запрос и в каком сценарии он должен ускорять. Важно различать:
- Как планировщик считает (estimated): план, полученный через
EXPLAIN, отражает оценку стоимости. - Как реально происходит (actual): фактические метрики, полученные через
EXPLAIN ANALYZE(или аналоги в конкретной СУБД).
Вам нужно уметь отвечать на вопросы:
- Используется ли индекс?
- Если используется — это “выгодное” использование или индекc под капотом не даёт выигрыша?
- Что изменится после обновления статистики / добавления новых данных?
- Как проверить, что после правок индекс не перестал работать?
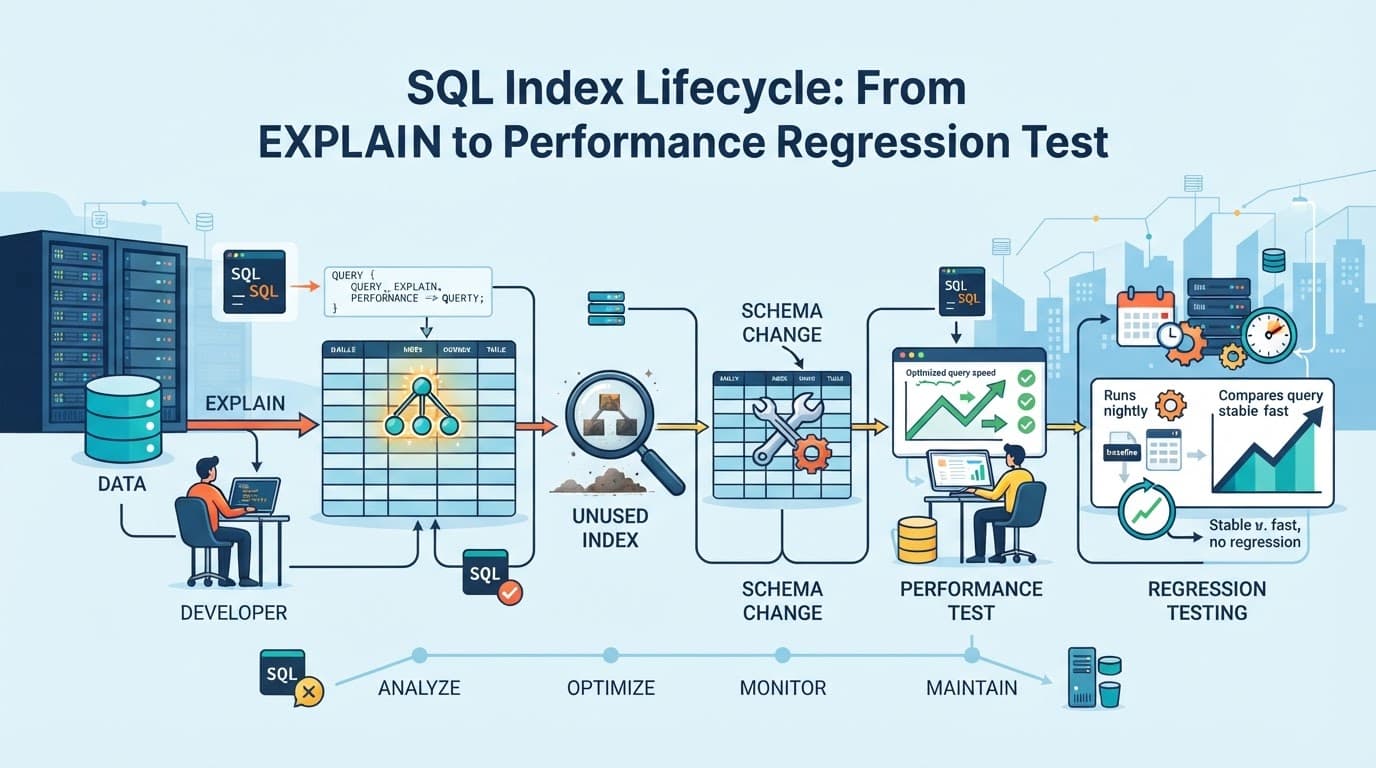
1.2. Базовая диаграмма жизненного цикла
Удобно мыслить процессом состояний:
- Идея → “индекс должен помочь этому запросу”
- Проектирование → определяем ключи индекса, порядок колонок, состав (если поддерживается), частичные индексы, условия
- Верификация на плане →
EXPLAIN/EXPLAIN ANALYZE, сравнение до/после - Наблюдение в бою → сбор фактических метрик, анализ
pg_stat_statements, log-based анализ, корреляция с нагрузкой - Поддержка → обновление статистики, reindex при необходимости, реакция на миграции и изменения данных
- Риск-менеджмент → мониторинг регрессий, контроль деградации
- Утилизация → удаление или замена индекса, если он не приносит пользы
Именно шаг 3–6 чаще всего “ломается”: индекс создают по учебнику или по предположению, а затем он либо не используется, либо используется, но не приносит выигрыша, либо деградирует со временем.
2) EXPLAIN как точка контроля: как понять, какой индекс реально задействован
2.1. EXPLAIN vs EXPLAIN ANALYZE: почему одного плана недостаточно
EXPLAIN показывает план и оценки. Он полезен на этапе проектирования индекса, но не гарантирует, что на реальных данных вы получите то же поведение.
EXPLAIN ANALYZE выполняет запрос и показывает фактические значения: actual time, rows, иногда loops. Это позволяет выявить сценарии, где оценка сильно ошиблась — и планировщик выберет другой путь.
Пример (PostgreSQL):
EXPLAIN
SELECT *
FROM orders
WHERE customer_id = 42
  AND created_at >= '2026-01-01';
Чтобы проверить фактическую картину:
EXPLAIN ANALYZE
SELECT *
FROM orders
WHERE customer_id = 42
  AND created_at >= '2026-01-01';
Смотрите на строки плана вроде Index Scan, Index Only Scan, Bitmap Index Scan, Bitmap Heap Scan. Они говорят не только “использован индекс”, но и как он используется.
2.2. Как распознать используемый индекс
В PostgreSQL в выводе EXPLAIN обычно видно имя индекса:
Index Scan using orders_customer_id_created_at_idx on ordersBitmap Index Scan on orders_customer_id_created_at_idx
Если вы не видите имени индекса, значит план не использует индекс в этом шаге или СУБД скрывает подробности в формате вывода. Тогда полезно:
- запустить
EXPLAIN (ANALYZE, BUFFERS, VERBOSE) - включить расширенный формат
Пример:
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT *
FROM orders
WHERE customer_id = 42
  AND created_at >= '2026-01-01';
BUFFERS покажет обращения к страницам (в том числе “сколько чтений из cache/диска”), что часто важнее абстрактной “стоимости”.
2.3. “Индекс есть, но он не работает”: типовые причины
Даже если индекс подходит “логически”, планировщик может его не выбрать. Частые причины:
- Статистика устарела: распределение значений изменилось, оценки селективности неверны.
- Не та форма запроса: выражения в
WHEREне совпадают с форматом условия индекса (например, функция от колонки). - Неподходящий порядок колонок (для составных индексов).
- Слишком широкий запрос: например, индекс помогает фильтровать, но не покрывает нужные колонки → много возвращаемых строк и дорогое “do the work”.
- Неподходящий тип индекса: B-tree vs hash, partial index не попадает под условие запроса.
- Конкуренция с другой стратегией: иногда
Bitmap-сканирование или последовательный скан выгоднее.
Важный вывод: индекс нужно оценивать не “в вакууме”, а по фактическому плану на репрезентативных данных.
3) Проектирование: как формулировать индекс, чтобы он действительно соответствовал запросу
3.1. Составной индекс: порядок колонок — это не косметика
Рассмотрим запрос:
SELECT *
FROM orders
WHERE customer_id = 42
  AND created_at >= '2026-01-01'
ORDER BY created_at DESC
LIMIT 50;
Предположим, вы создаёте индекс:
CREATE INDEX ON orders (created_at, customer_id);
На практике это может быть слабым вариантом: фильтрация по customer_id становится “вторичной” для индекса. Лучший вариант часто — поставить более селективную и “ведущую” колонку первой:
CREATE INDEX ON orders (customer_id, created_at DESC);
Почему так: B-tree индекс упорядочивает ключи слева направо. Если первая колонка ограничена равенством (customer_id = 42), планировщик получает более компактный диапазон. Если ограничение по первой колонке отсутствует, эффективность падает.
3.2. Частичные индексы: когда “всё равно” не равно “всё”
Если запросы часто используют условие, по которому можно “отрезать” часть данных, частичный индекс может быть сильным компромиссом: меньше размер индекса, меньше обслуживания.
Например, у вас есть “активные” заказы:
SELECT *
FROM orders
WHERE customer_id = 42
  AND status = 'ACTIVE';
Частичный индекс:
CREATE INDEX orders_active_by_customer
ON orders (customer_id)
WHERE status = 'ACTIVE';
Но важный нюанс: запрос должен попадать под условие частичного индекса. Иначе планировщик просто не сможет его применить.
3.3. Покрывающие индексы и “Index Only Scan”
В PostgreSQL Index Only Scan появляется, если:
- запрос может получить нужные колонки из индекса,
- и данные видимы с учётом visibility map (в зависимости от состояния таблицы).
Покрывающий индекс не всегда уменьшает стоимость, потому что увеличивает ширину индекса и может ухудшить кеширование. Это баланс.
Например, запрос выбирает только поля, которые можно хранить в индексе:
SELECT id, created_at
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 50;
Индекс:
CREATE INDEX orders_customer_cover
ON orders (customer_id, created_at DESC) INCLUDE (id);
Снова: нужно проверять EXPLAIN (ANALYZE) и метрики чтения страниц.
3.4. Функциональные индексы и выражения
Если в запросе часто используется выражение от колонки, обычный индекс может не помочь. Пример:
SELECT *
FROM users
WHERE lower(email) = lower('Test@Example.com');
Тогда нужен функциональный индекс:
CREATE INDEX users_email_lower_idx
ON users (lower(email));
Иначе планировщик может быть вынужден сканировать таблицу, потому что условие не сопоставимо напрямую с индексным ключом.
4) Верификация “до/после”: как понять, что индекс действительно ускорил
4.1. Простой метод сравнения: один и тот же запрос на одинаковом окружении
Чтобы доказать пользу индекса, вам нужна дисциплина сравнения:
- одинаковый запрос (без изменения параметров, если они существенны)
- одинаковый набор данных (или хотя бы близкая загрузка)
- одинаковая настройка уровня изоляции/параметров планировщика (частично)
- повторение (учитывайте кэширование)
На уровне базы вы начинаете с плана и фактических метрик:
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT *
FROM orders
WHERE customer_id = 42
  AND created_at >= '2026-01-01'
ORDER BY created_at DESC
LIMIT 50;
Запишите:
actual time(лучше не один раз, а несколько)- количество строк
rows - что за оператор (Index Scan/Bitmap/Seq Scan)
- чтения
Buffers: shared hit/read/dirtied
Затем создаёте индекс и повторяете.
4.2. Не путайте “ускорилось” с “снизилась стоимость, но реально не стало быстрее”
Индекс может уменьшить оценку, но не изменить итоговую реальную задержку. Это происходит, например, когда:
- запрос возвращает слишком много строк (индекс ускоряет поиск, но итоговая сортировка/передача данных остаётся доминирующей)
- узкое место — сеть или сериализация результата
- ограничение
ORDER BYиLIMITтребует дополнительные шаги
В таких случаях индекс полезен теоретически, но на практике выигрыша нет.
4.3. Важный метрик-чек: влияние на запись
Индекс ускоряет чтение, но замедляет INSERT/UPDATE/DELETE, потому что каждое изменение таблицы должно обновлять индекс.
Поэтому в жизненном цикле индекса всегда есть компромисс:
- больше индексов → чаще конфликты на записи, больше WAL и I/O
- меньше индексов → сложнее планы и выше стоимость чтения
Тестирование “только SELECT” — частая ошибка. В индустрии обычно делают хотя бы минимальные нагрузочные проверки на операции записи, затронутые индексами.
5) Когда индекс бесполезен: признаки и алгоритм принятия решения
5.1. Индекс не используется вообще
Если план для критических запросов не показывает использование индекса, вопрос “зачем он” становится практическим. Но важно проверить две вещи:
- вы смотрите план “в статике”, а реальная нагрузка использует другие параметры (например, другой диапазон дат)
- статистика и кэш могли повлиять на выбор плана
Подход:
- Соберите набор запросов из production (ограниченный, но релевантный).
- Для каждого проверьте фактический план с актуальными статистиками.
- Сравните влияние на latency и на число чтений.
5.2. Индекс используется, но не уменьшает затраты
Иногда индекс присутствует в плане (Index Scan), но:
actual rowsпочти равноestimated rowsи они велики,- индексный скан превращается в “почти полный проход”, где последовательный скан был бы не хуже,
- или
BUFFERSпоказывает, что всё равно читается много страниц таблицы.
Критический критерий: уменьшилось ли реальное время и/или снизилась нагрузка на I/O.
5.3. Индекс помогает одному запросу, но ломает другие
Индексы могут менять статистику и выбор плана для соседних запросов. Это называется “эффект вторичного порядка”: добавили индекс под Query A — а Query B внезапно пошёл иначе.
Поэтому решение об индексе должно учитывать набор затронутых запросов, а не только точечный пример из тикета.
6) Обновление схемы и статистики: как избежать “индекс устарел” (и внезапно перестал помогать)
6.1. Почему после миграций планы меняются
После изменений схемы может измениться:
- распределение значений в колонках
- корреляции между колонками
- размеры таблиц
- видимость индекса/таблицы (в Postgres — visibility map после VACUUM)
- параметры планировщика или способ обновления статистики
Поэтому жизненный цикл индекса включает регулярную валидацию после:
- миграций данных (бэкапы/реимпорты)
- больших обновлений (bulk updates/deletes)
- изменения ключей и ограничений
- добавления новых индексов (иногда даже для соседних таблиц)
6.2. Практика: контролируемая корректировка статистики
В PostgreSQL обычно делают:
ANALYZEпосле больших измененийVACUUM (ANALYZE)по расписанию
Пример:
ANALYZE orders;
Если запросы чувствительны к распределениям, можно точечно использовать ALTER TABLE ... ALTER COLUMN ... SET STATISTICS и затем ANALYZE, но это уже уровень тонкой настройки.
Главное — не делать выводы по EXPLAIN, пока статистика может быть существенно устаревшей.
7) Риск деградации: как строить регрессию производительности на уровне инженерного процесса
7.1. Почему нужен тест на регрессию
Планировщик — адаптивный. С ростом данных даже “правильный” индекс может перестать быть выгодным. Появляются новые паттерны данных, меняется селективность, растёт число строк и стоимость операций.
Без регрессионного теста вы узнаете о деградации слишком поздно: по увеличившимся p95/p99 или по всплеску нагрузки.
7.2. Сценарии регрессии, которые реально ловят инциденты
Минимальный набор:
- Критические read-запросы (по latency и частоте)
- Значимые write-профили (bulk insert/update/delete), потому что индексы влияют на них
- Типовые параметры:
- узкие диапазоны дат и широкие
- разные значения customer_id (частые/редкие)
- запросы, которые возвращают мало/много строк
Частая ошибка — взять один “репрезентативный” запрос и один набор параметров. В реальности селективность и параметры решают всё.
7.3. Методы запуска теста
Варианты:
- локальный стенд с клонированными данными и идентичной версией СУБД
- pre-prod окружение с “похожей” нагрузкой
- оффлайн бенчмаркинг с фиксированными параметрами
Для каждого сценария важно:
- контролировать warm-up (кэш)
- повторять замеры (несколько прогонов)
- использовать тайминг на сервере, а не только клиентское время
7.4. Практический шаблон проверки с pgbench (пример)
Допустим, у вас PostgreSQL. Вы можете подготовить сценарии в SQL и запускать их до/после изменений индексов.
Пример команды:
pgbench -c 10 -j 4 -t 60 -n -U user -d mydb -f test_orders.sql
А в файле test_orders.sql можно зафиксировать типовые запросы. Например, имитировать два диапазона:
\set customer_id 42
SELECT *
FROM orders
WHERE customer_id = :customer_id
  AND created_at >= '2026-01-01'
ORDER BY created_at DESC
LIMIT 50;

SELECT *
FROM orders
WHERE customer_id = :customer_id
  AND created_at >= '2025-01-01'
ORDER BY created_at DESC
LIMIT 50;
Потом вы сравниваете статистику: tps/latency и поведенческие метрики на уровне БД (из EXPLAIN ANALYZE, BUFFERS, журналов).
7.5. Как формализовать “порог регрессии”
Без порогов тест превращается в шум.
Практический подход:
- установить допустимый рост времени (например, +10% для p95)
- отдельно учитывать рост I/O и рост времени на write-операции
- если регрессия локальная (только один запрос), нужно понимать: это приемлемо или требует отката
Идеально — проводить сравнение по нескольким метрикам, потому что иногда “время” улучшается, но растёт нагрузка на CPU или I/O, что в будущем приведёт к проблемам.
8) Как поддерживать индексную политику: наблюдаемость, уборка, re-evaluation
8.1. Индексы — живые: нужна периодическая ревизия
Индекс, созданный “под одну задачу”, постепенно перестаёт быть актуальным:
- бизнес-логика меняется
- запросы оптимизируются на уровне приложения
- появляются новые фильтры
- меняется распределение данных
Поэтому часть жизненного цикла — регулярная ревизия:
- Индексы, которые не используются в критических запросах — кандидат на удаление.
- Индексы, которые используются, но не дают ожидаемого сокращения — кандидат на пересборку (изменение ключей, partial/cover).
- Индексы, которые ухудшили write-нагрузку — кандидат на пересмотр числа индексов на таблице.
8.2. Наблюдение: “использование” ≠ “помощь”
Даже если индекс фигурирует в плане, это может быть не ключевой оператор в критическом пути. Поэтому наблюдаемость должна соединять:
- фактический план
- метрики времени/буферов
- статистику по частоте вызовов запросов (сколько раз запрос выполняется)
В PostgreSQL часто используют pg_stat_statements для контекстной оценки, а EXPLAIN — для объяснения причины выбора плана.
9) Типичная последовательность работ (чеклист) перед внедрением индекса
Ниже — рабочая схема, которую можно взять как “pipeline” для команды.
9.1. Чеклист: создание индекса
- Выберите конкретный запрос (или малый набор).
- Зафиксируйте baseline:
EXPLAIN (ANALYZE, BUFFERS)до изменений- 3–5 повторов замера (с учётом warm-up)
- Определите ограничения:
- какой тип фильтрации (равенство/диапазон)
- есть ли
ORDER BY/GROUP BY/LIMIT - возвращаемые колонки
- Спроектируйте индекс с учётом формы запроса:
- порядок колонок
- partial index при необходимости
- INCLUDE/покрытие (если оправдано)
- функциональные индексы для выражений
- Верификация:
EXPLAIN/EXPLAIN ANALYZEпосле создания- проверка планировщика на нескольких параметрах
- Проверка влияния на запись:
- хотя бы базовые микротесты на UPDATE/INSERT (для затронутых таблиц)
9.2. Чеклист: интеграция в процесс релиза
- После миграции и обновления статистики повторить планы для критичных запросов.
- Запустить регрессионный тест на производительность:
- read-сценарии
- write-сценарии
- Зафиксировать результаты и принять решение:
- оставить/доработать/откатить индекс
10) Путь от новичка до уверенной индексной инженерии
Если вы только начинаете с SQL и хотите понимать, почему “индекс есть — а быстрее не стало”, стоит идти от базовых конструкций к планам и статистике: как формируются запросы, какие операторы внутри плана появляются и от чего они зависят. Для этого обычно не хватает “знания синтаксиса” — нужна практика чтения планов и осознанное изменение запросов/индексов.
Хороший стартовый маршрут для новичков — курс вроде SQL – для начинающих!, но полезность там максимальна, если дальше вы применяете знания в реальных упражнениях: прогоняете EXPLAIN, пробуете индексы разных форматов и обязательно сравниваете результаты.
Вывод: диаграмма жизненного цикла индекса — это дисциплина, а не разовая оптимизация
Индекс проходит путь: идея → проектирование → верификация планом → проверка фактических метрик → наблюдение и поддержка → риск-менеджмент → возможное удаление. Главная мысль проста: индекс должен доказывать свою пользу на ваших запросах и в ваших данных.
С практической точки зрения “правильный” процесс выглядит так:
- начинаете с
EXPLAINи обязательно переходите кEXPLAIN ANALYZEсBUFFERS; - проверяете, что индекс не просто присутствует, а улучшает реальные метрики;
- учитываете влияние на запись;
- после миграций следите за тем, как меняется выбор плана;
- защищаетесь от регрессии тестами производительности с повторяемыми сценариями.
Если внедрять индексы по этой логике, вы снижаете вероятность деградаций и перестаёте угадывать. Индекс становится инженерным инструментом, а не случайным набором B-tree страниц.