Глубокая оптимизация SQL: EXPLAIN ANALYZE как инструмент мышления
Покажем, как читать план выполнения, находить узкие места и формулировать запросы заново. Разберём случаи, где индекс “есть”, но ускорения нет.
Содержание
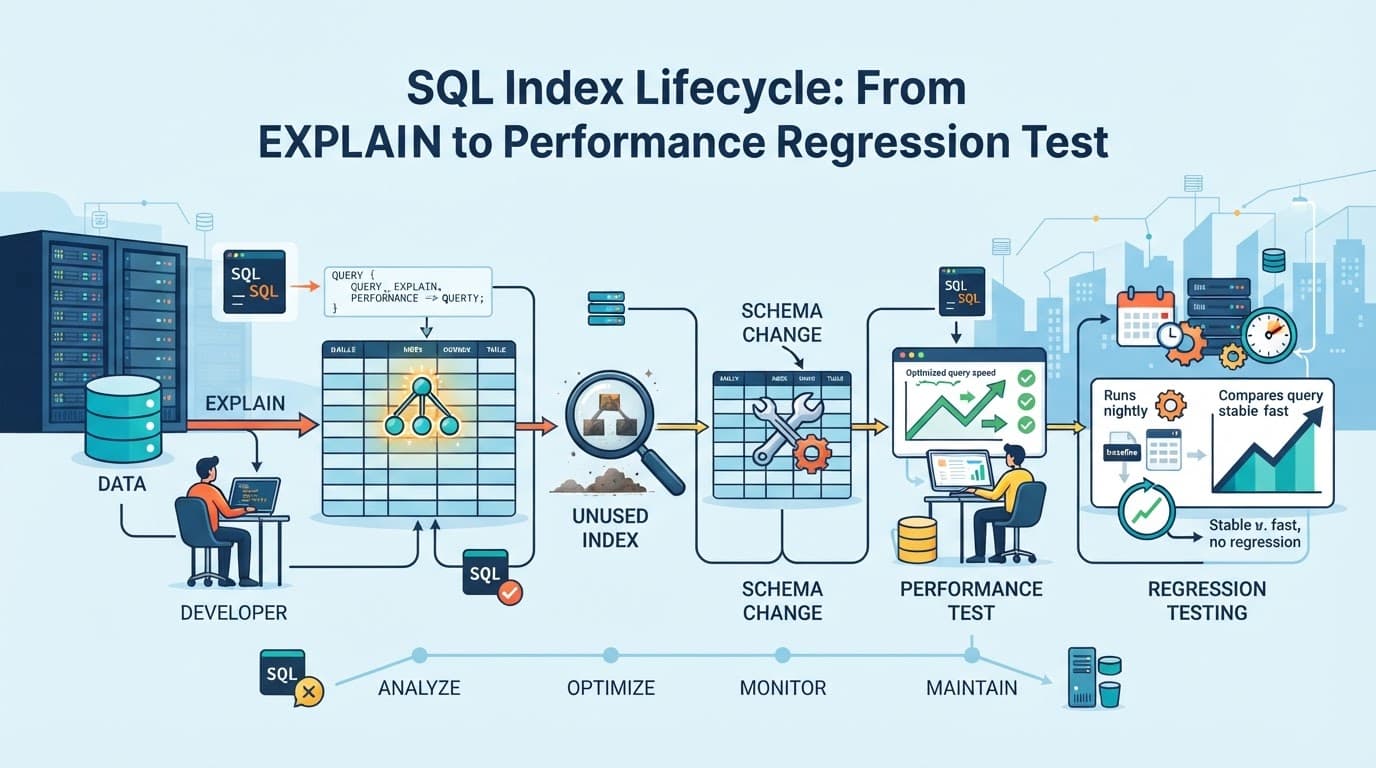
Оптимизация запросов — это не «угадай индекс» и не магия настройками. Это дисциплина: вы формулируете гипотезу о том, как база выполняет ваш SQL, проверяете её на реальных данных и корректируете запрос/схему/индексы. Ключевой инструмент в этой цепочке — EXPLAIN ANALYZE: он показывает не только план (как движок хочет выполнять), но и фактические метрики (как он выполнил). Именно поэтому EXPLAIN ANALYZE полезен не как отчёт, а как инструмент мышления.
В этой статье разберём, как читать план выполнения, как находить узкие места, как переписывать запросы, и — отдельно — почему индекс «есть», но ускорения нет. В конце — практический чек-лист и рекомендации, как прокачаться глубже. Для начала курса, который системно закрывает базовую опору и помогает перейти к осознанной оптимизации, можно посмотреть «SQL – для начинающих!» — как способ структурировать фундамент перед углублением в планы и индексы.
Что даёт EXPLAIN ANALYZE и почему без него легко ошибиться
План vs. факт: главная ловушка оптимизации
В большинстве СУБД (например, PostgreSQL, MySQL 8+, MariaDB, SQL Server) есть механика «оценка стоимости» плана. Движок анализирует статистику и оценивает: сколько строк вернёт операция, сколько времени займёт, выгодно ли использовать индекс и т.д. Эти оценки не всегда совпадают с реальностью.
EXPLAIN показывает именно оценки и выбранную стратегию. Но EXPLAIN ANALYZE запускает запрос и измеряет фактические значения, включая время, фактические числа строк на каждом шаге и дополнительные детали.
Типичные случаи, где расхождение критично:
- Плохая/устаревшая статистика. Оценки по кардинальности могут быть сильно неверными.
- Параметризация и «план на основе предположений». Один и тот же запрос с разными параметрами может вести себя радикально по-разному.
- Сильная неоднородность данных. Например, 99% строк имеют одно значение, а 1% — редкое; оценки «среднего» могут ломать выбор индекса.
- Ошибки в запросе, когда индекс формально применим, но фактически не помогает. Например, индекс используется для сортировки/фильтра не так, как вы ожидали, или есть дорогие операции выше по дереву.
Почему это важно для мышления
Оптимизация часто происходит «в голове»: мы предполагаем, что индекс сделает всё быстро. Но индекс — лишь один из факторов. EXPLAIN ANALYZE позволяет переключиться с «кажется» на «видно»: какой узел на самом деле съедает время и почему он такой дорогой.
Как читать план выполнения: от верхушки к узкому месту
У разных СУБД план формируется по-разному, но концептуально он похож: дерево операций, где листья — таблицы/индексы, а корень — результат.
1) Начинайте с корня: что в итоге дорого
Скорее всего, корневой узел покажет общее время выполнения (в PostgreSQL это будет на уровне Execution Time). Но корень обычно «вбирает» время всех подопераций. Поэтому дальше ищите:
- Самые большие по времени узлы (часто — вблизи корня или в ветках фильтра/джойна).
- Узлы с большим количеством «loops» (многократное выполнение подзапроса или части плана).
- Узлы, где разница оценка/факт (если отображается) может объяснить выбор стратегии.
В PostgreSQL полезны поля:
actual time=...rows=...loops=...- иногда
cost=...иrows=...для оценок.
2) Следуйте по цепочке операций, которые уменьшают или наращивают объём
План — это история о том, как меняется количество строк на пути к результату. Типичные узкие места:
- Фильтр (
Filter) применяется слишком поздно. Вы «набрали» много строк, а отсекли только потом. - Сортировка (
Sort) иORDER BY. Часто сортировка дорогая из-за большого объёма данных или потому что не хватает индекса под нужный порядок. - Агрегации (
Aggregate,GroupAggregate): если вы группируете по полю без подходящего доступа. - Джойны (
Nested Loop,Hash Join,Merge Join): выбор алгоритма и кардинальность решают.
3) Обращайте внимание на разницу оценка/факт
В PostgreSQL рядом часто отображаются rows=... (оценка) и actual rows=.... Когда факт сильно отличается, план может быть неоптимальным.
Пример симптома (упрощённо):
- оценка: ожидали 10 000 строк,
- факт: получили 1 000 000 строк.
Тогда, даже если индекс «вроде используется», план может стать неэффективным: алгоритм джойна выбирается исходя из неверной кардинальности.
Пошаговый разбор: как найти узкое место в реальном запросе
Рассмотрим типичный запрос с фильтром и сортировкой. Предположим, PostgreSQL.
Исходная версия запроса
SELECT
  u.id,
  u.email,
  o.created_at
FROM users u
JOIN orders o ON o.user_id = u.id
WHERE u.status = 'active'
ORDER BY o.created_at DESC
LIMIT 50;
На практике это часто превращается в тяжёлый план, если:
- данные в orders велики,
- join выбирает неудачную стратегию,
- или сортировка вынуждена.
Запускаем анализ
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT
  u.id,
  u.email,
  o.created_at
FROM users u
JOIN orders o ON o.user_id = u.id
WHERE u.status = 'active'
ORDER BY o.created_at DESC
LIMIT 50;
На что смотреть в плане
-
Где начинается «раздувание» количества строк?
Если фильтрu.status='active'применяется не очень эффективно и в join уходит слишком много пользователей — дальше всё становится дороже. -
Есть ли сортировка?
Если в плане появляется узелSort, это тревожный сигнал. ДляORDER BY ... DESC LIMIT 50оптимально, когда план может использовать индексный доступ, позволяющий избежать сортировки. -
Как устроен join?
Nested Loopпри больших объёмах часто плох, если внутренняя часть выполняется много раз.Hash Joinиногда хорош для больших наборов, но может требовать много памяти.Merge Joinхорош, если входные данные отсортированы по ключам джойна.
- Счётчик
loops.
Если вы видите, что внутренняя операция выполнена десятки/сотни тысяч раз — даже небольшая стоимость внутри может суммарно дать «боль».
Первая гипотеза: индекс под ORDER BY
Если сортировка присутствует, а индекс на orders(created_at DESC) отсутствует или не согласован с условием/ключом джойна, план может вынужденно сортировать.
Но важная деталь: индекс на orders(created_at) сам по себе может не помочь, если фильтрация и join происходят так, что вы всё равно тянете много строк, а затем сортируете.
Это подводит к общей мысли: индексы работают «в связке» с логикой доступа. Чтобы уйти от сортировки при ORDER BY ... LIMIT, обычно нужен индекс, который соответствует:
- сортировочному ключу,
- и (часто) селективному фильтру,
- и/или может ограничить число строк до джойна.
Сценарии: индекс есть, а ускорения нет
Это один из самых частых вопросов на практике. Рассмотрим типовые причины.
1) Индекс есть, но запрос обращается к нему не в том месте дерева
Предположим, у вас есть индекс orders(created_at DESC), но план делает следующее:
- выбирает много строк
ordersпоuser_id(или наоборот), - потом выполняет
join, - затем сортирует уже результат.
В таком плане индекс по created_at может использоваться редко или вовсе не применяться для сортировки финального набора.
Как это заметить: в плане вы увидите Sort над результатом узла, который уже содержит данные после join.
2) Индекс используется, но не уменьшает число строк достаточно
В PostgreSQL индекс может быть использован как Index Scan, но если условие селективно слабо (например, возвращает 30–70% таблицы), то индексный доступ превращается в «дорогу с объездом»: БД всё равно читает много страниц.
Симптомы в плане:
Index Scan/Index Only Scan, но фактическое число строк велико,- узлы чтения (
Buffers) показывают, что данных читается много, - разница оценок и факта часто указывает, что выбор стратегии мог быть не лучшим.
3) Индекс не покрывает нужные колонки (и приходится ходить в таблицу)
Даже если индекс используется, может оказаться, что запрос «не закрывается» индексом целиком.
В PostgreSQL концептуально:
Index Only Scanвозможно только при подходящих условиях visibility map и корректных настройках.- иначе будет
Index Scanс последующимHeap Fetch.
Симптом: вы видите в плане «index scan», но фактически много обращений к таблице по heap.
4) Джойн ломает ожидания: индексная стратегия невозможна без правильной формы запроса
Иногда индекс существует на ключ джойна, но запрос написан так, что движок выбирает другой путь.
Например, джойн может выполняться до фильтра — и тогда индекс на внешнем фильтре не помогает. Решение — часто переписать запрос так, чтобы фильтр применялся раньше (или использовать CTE/подзапрос — но аккуратно: CTE в PostgreSQL теперь не всегда «гарантирует» порядок выполнения).
5) Фактический план выбирает другую стратегию из-за кардинальности
Если статистика неправильная, оптимизатор может думать, что индексный план выгоднее или наоборот. Тогда вы получите ситуацию:
- «индекс есть»
- но в плане другой узел (например,
Seq ScanилиHash Join), который фактически и определяет время.
Решение обычно начинается с проверки статистики и понимания, почему оптимизатор выбрал именно так.
Как формулировать запросы заново: приёмы, которые реально меняют план
Ниже — приёмы не «ради красоты», а ради контроля над тем, как именно движок сможет использовать индексы.
1) Применяйте фильтры раньше и яснее
В SQL логика обычно «декларативная», но оптимизатор может иначе переставить операции. Ваша задача — дать ему возможность сделать выгодные перестановки.
Пример: вместо того чтобы джойнить «всё», лучше максимально сузить один из наборов.
Было:
SELECT ...
FROM users u
JOIN orders o ON o.user_id = u.id
WHERE o.status = 'paid'
  AND u.status = 'active';
Иногда полезно явно выделить отфильтрованный набор orders или users (зависит от СУБД и версии оптимизатора):
SELECT ...
FROM (
  SELECT id, email
  FROM users
  WHERE status = 'active'
) u
JOIN orders o ON o.user_id = u.id
WHERE o.status = 'paid';
В PostgreSQL это не всегда строго «заморозит порядок», но часто улучшает понятность для оптимизатора или помогает использовать индексы на подусловиях.
2) Смотрите на ORDER BY ... LIMIT: часто это ключевой индикатор
Если вы хотите «последние N записей», а план содержит Sort, стоит проверять:
- есть ли составной индекс под (фильтр, сортировка),
- согласованы ли направления (ASC/DESC),
- применяется ли сортировка к тому набору, который вы хотите.
В примере выше цель — получить последние заказы для активных пользователей. Возможный индекс-ориентир (концептуально):
orders(user_id, created_at DESC)илиorders(user_id, created_at)в зависимости от СУБД и того, как она оптимизирует сортировку.
Важно: один индекс по created_at иногда недостаточен, если для каждого пользователя нужно «своё» последнее — тогда лучше составной индекс с ведущим ключом user_id.
3) Не допускайте лишних ширин: выбирайте только нужные колонки
Широкие выборки (много колонок, особенно текст/JSON) увеличивают стоимость чтения. Даже если доступ ускорился, вы можете упираться в I/O.
Пример:
SELECT *
FROM ...
Переход к выбору только нужных полей часто уменьшает:
- объём данных,
- цену heap fetch,
- и иногда помогает перейти к
Index Only Scan.
4) Агрегации: группируйте по тем, что реально индексируем
Запрос вида:
SELECT customer_id, count(*)
FROM events
WHERE ...
GROUP BY customer_id;
будет существенно быстрее, если есть индекс по ключам, которые позволяют оптимизатору агрегировать через более дешевый путь (например, упорядоченный доступ или предварительную фильтрацию).
EXPLAIN ANALYZE покажет, если агрегатор становится узким местом.
5) Джойны: проверяйте форму и условия
Один и тот же логический запрос может быть выполнен по-разному в зависимости от:
- типа условия в
JOIN(равенства vs диапазоны), - наличия дополнительных фильтров,
- и того, как оптимизатор трактует подзапросы/выражения.
Если вы используете LEFT JOIN ради «флагов», иногда имеет смысл перепроверить, не превращается ли это в лишнее размножение строк.
Практический диагностический набор: как действовать по шагам
Ниже — логика, которую удобно применять к любому медленному запросу.
Шаг 1. Зафиксируйте запрос и прогоните EXPLAIN ANALYZE
Всегда используйте один и тот же запрос и одинаковые параметры (или конкретный набор параметров), иначе вы будете диагностировать разные сценарии.
Пример (PostgreSQL-стиль):
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT ...
;
Если есть возможность, делайте это в «близкое к бою» время и на реальном объёме данных. Иначе вы диагностируете не то.
Шаг 2. Найдите узел с максимальным вкладом во время
Обычно достаточно пройтись по плану и найти самые тяжёлые операции. Смотрите не только на «среднее» время, но и на loops.
Если узел повторяется много раз — даже при малом времени внутри он может доминировать.
Шаг 3. Проверьте, совпадают ли ожидания с фактом
Если в плане видна разница оценок и actual rows, это прямой повод:
- обновить статистику (
ANALYZEв PostgreSQL), - пересмотреть индексы/форму запроса,
- убедиться, что вы не загоняете план в ловушку оценок.
Шаг 4. Проверьте, соответствует ли индекс тому, что вам нужно
Частая ошибка: «у нас есть индекс на колонку X, значит запрос должен ускориться».
Но индекс ускоряет только в контексте:
- какой предикат,
- какой набор данных,
- есть ли сортировка/группировка,
- как построен join,
- покрывает ли индекс выборку.
Шаг 5. Перепишите запрос так, чтобы план стал логичнее
Переупорядочивание условий, сужение наборов, корректный ORDER BY, аккуратная работа с джойнами — всё это может изменить план. Важно: не делайте переписывание хаотичным. Всегда привязывайте изменения к наблюдаемым симптомам из плана.
Пример: индекс есть, но узкое место — сортировка после джойна
Возьмём запрос на последних заказах активных пользователей.
Допустим, в плане видны:
Hash Joinмеждуusersиorders,- большой промежуточный результат,
- затем
Sortпоo.created_at DESC, - и только потом
Limit 50.
Это классический сценарий: индекс на orders(created_at) сам по себе не спасает, потому что сортируют уже «склеенный» набор, а не исходный индексный диапазон.
Как переписать подход
Один из направлений — попытаться получить «первую страницу» через индексированный доступ к заказам, а затем джойнить с пользователями. Концептуально:
- взять топ-50
ordersпоcreated_at(или с фильтром поorders), - затем присоединить
usersи отфильтроватьstatus.
В SQL это может выглядеть как подзапрос/CTE:
WITH recent_orders AS (
  SELECT id, user_id, created_at
  FROM orders
  ORDER BY created_at DESC
  LIMIT 500
)
SELECT
  u.id,
  u.email,
  ro.created_at
FROM recent_orders ro
JOIN users u ON u.id = ro.user_id
WHERE u.status = 'active'
ORDER BY ro.created_at DESC
LIMIT 50;
Почему LIMIT 500, а не LIMIT 50? Потому что