Идемпотентность на уровне данных: схемы ключей, уникальные ограничения и upsert
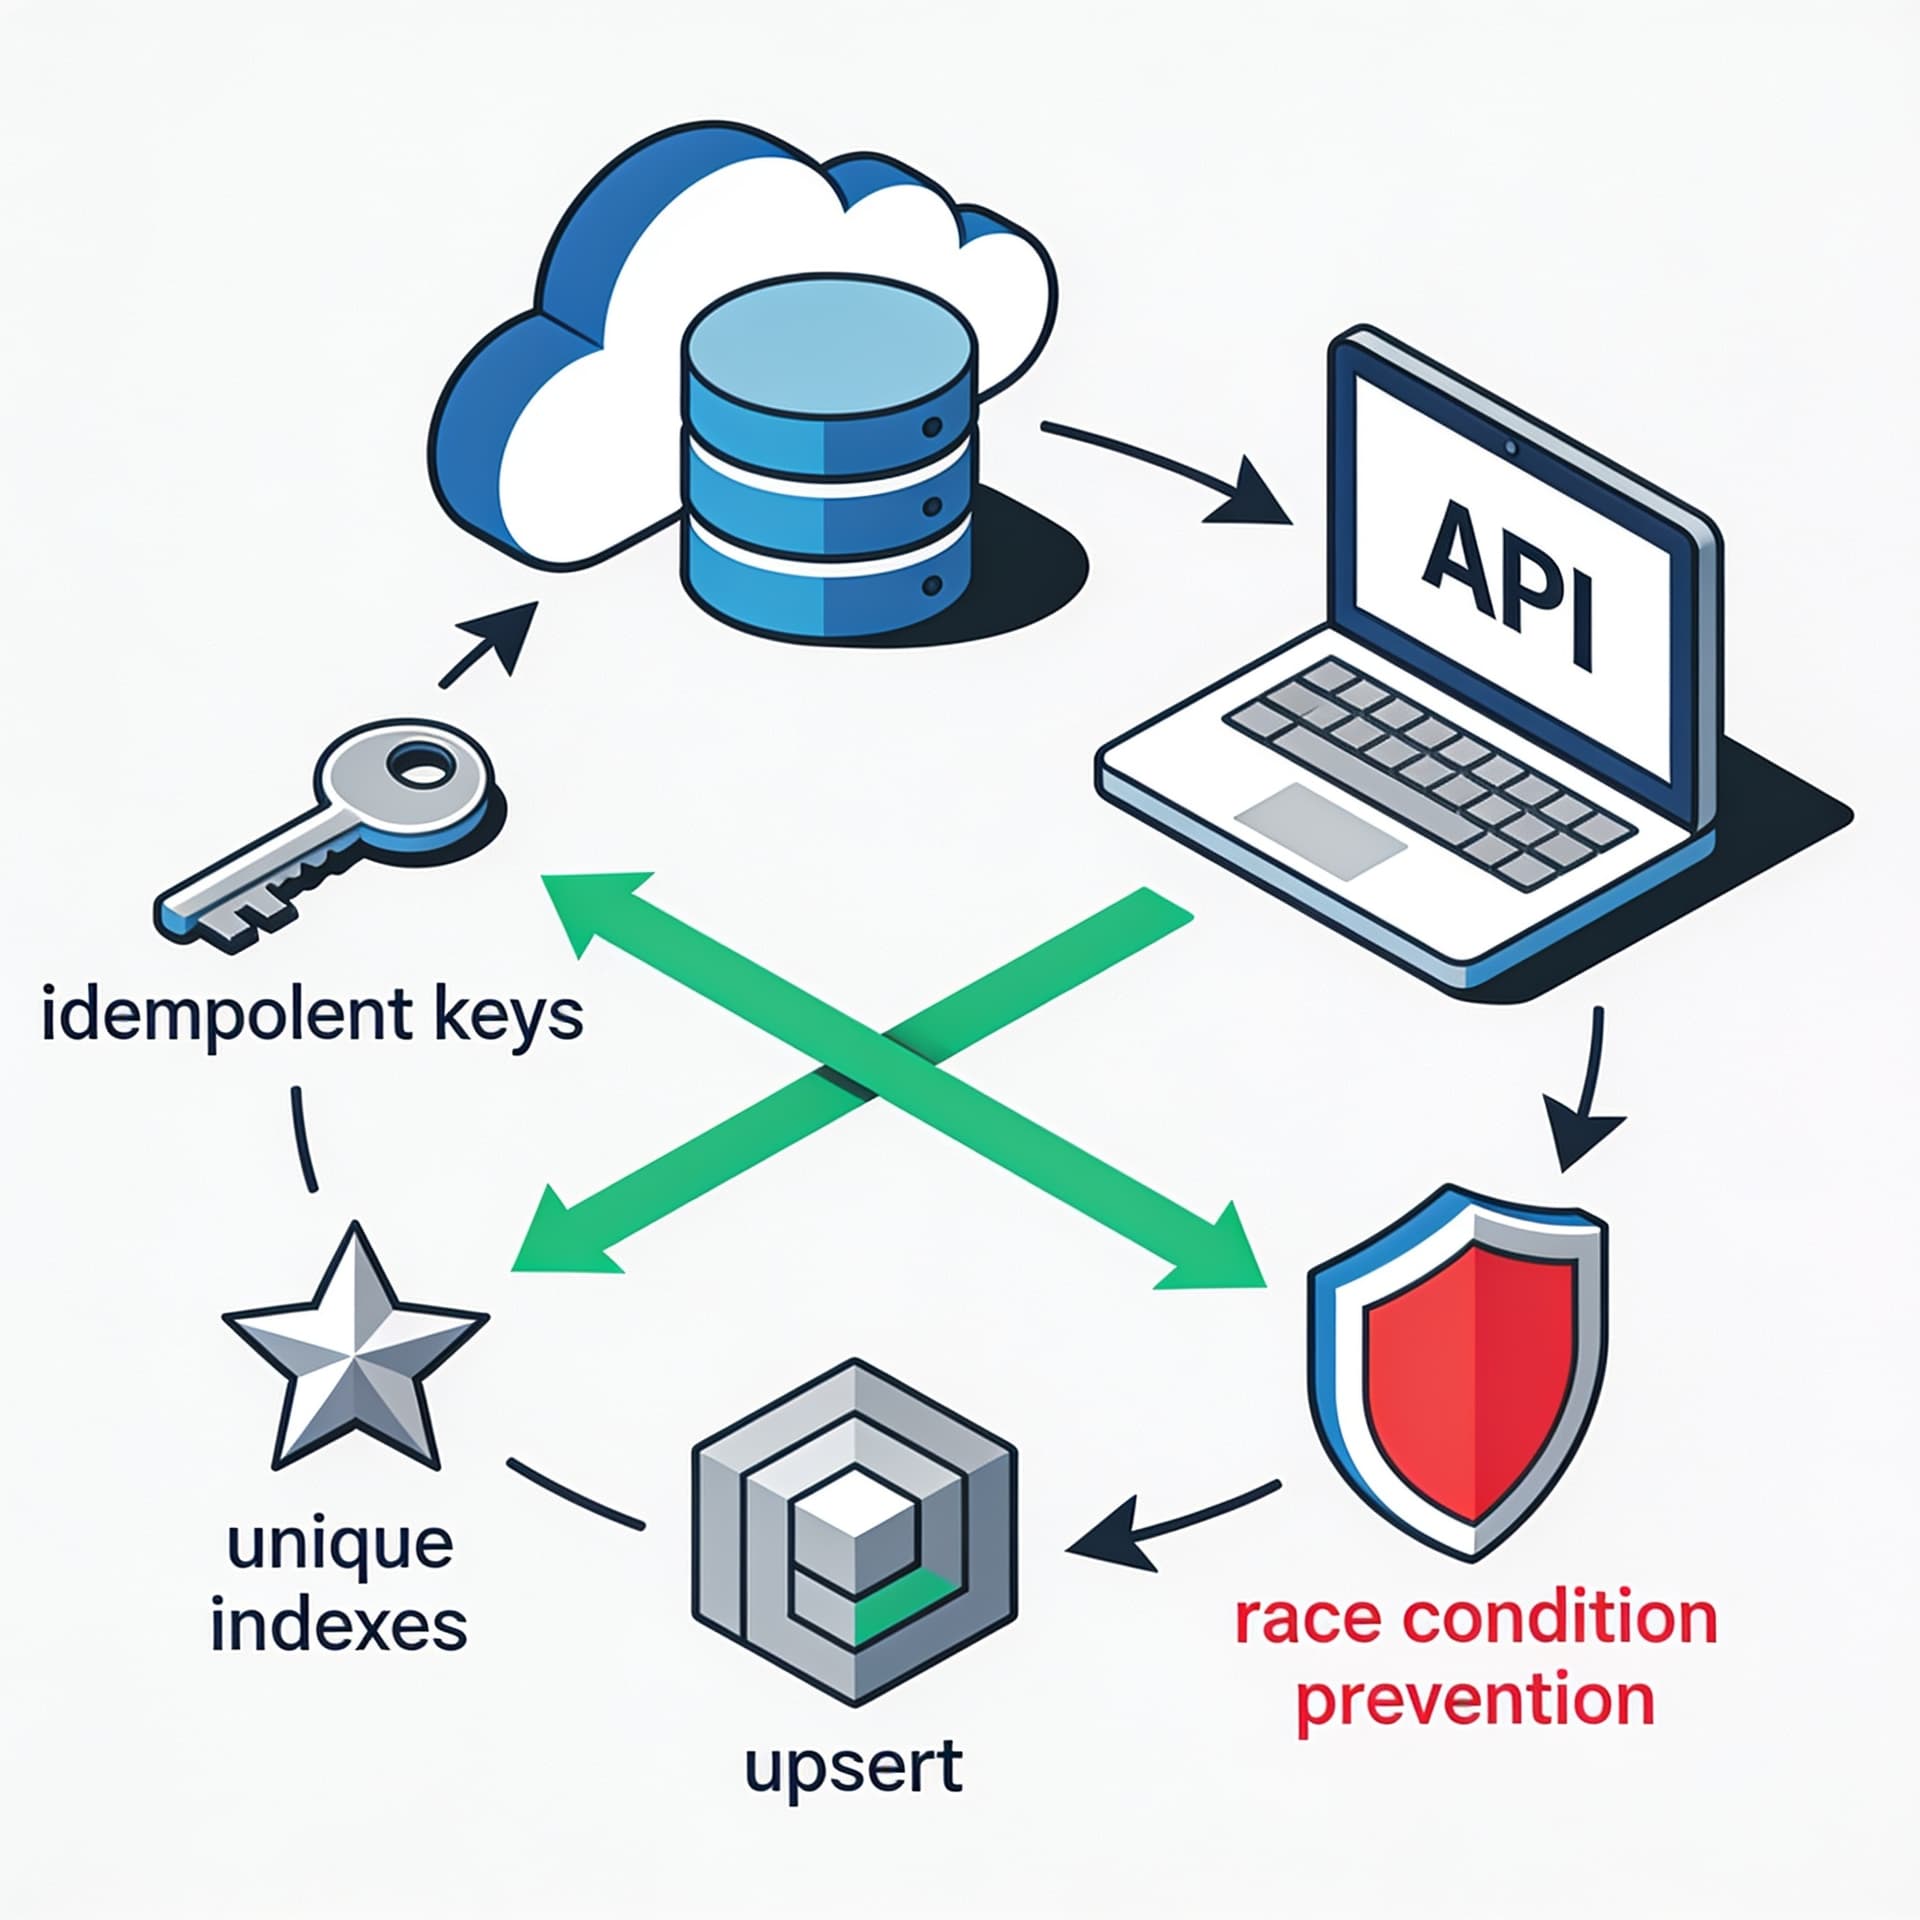
Покажем, как строить устойчивые повторные запросы не только в API, но и в базе: идемпотентные ключи, уникальные индексы, транзакции и upsert-паттерны. Отдельно разберём типовые гонки и как их предотвратить.
Содержание
Идемпотентность — это способность операции давать один и тот же результат при повторном выполнении с одинаковыми входными данными. В API это обычно решают идемпотентными ключами или ретраями с контролем состояния. Но в реальных системах самый надежный слой — база данных: именно она фиксирует факт «операция уже выполнена» или «сущность создана ровно один раз». Если переложить идемпотентность только на приложение, вы неизбежно столкнетесь с гонками, частично записанными данными и редкими инцидентами, которые трудно воспроизвести.
В этой статье разберем, как проектировать идемпотентность на уровне данных: как выбирать ключи, когда нужны уникальные ограничения, как устроены транзакции и что именно означает паттерн upsert. Плюс разберем типовые гонки и практические способы их предотвращать. Материал ориентирован на разработчиков, которые пишут backend и проектируют схемы данных, а не только «запускают запросы».
Что ломается, когда идемпотентность “только в API”
Представим, что клиент отправляет запрос POST /orders на создание заказа. Со стороны API возможны сценарии:
- клиент повторил запрос из‑за таймаута;
- ретрай произошел по сети, хотя сервер уже успел создать запись;
- нагрузка привела к задержке обработки, и клиент решил, что запрос не дошел;
- сервис-посредник повторил запрос при частичном успехе (например, при падении после записи в БД, но до отправки ответа).
Если приложение не хранит маркер «этот запрос уже обработан», то повторный запрос может создать второй заказ — или частично обновить данные, оставив систему в неконсистентном состоянии.
Ключевой тезис: идемпотентность нужно “прибить гвоздями” к данным. Не просто в логике приложения, а в схеме и транзакционной модели БД.
Идемпотентность как модель “факт + проверка”
На уровне данных идемпотентность обычно реализуется через одну из двух моделей:
-
Идемпотентный ключ операции
Мы сохраняем факт обработки:operation_id→ результат (или хотя бы факт). Повторный запрос проверяет наличие этого ключа и возвращает одинаковый результат. -
Идемпотентность по доменной сущности
Мы делаем так, чтобы повторный запрос приводил к одному и тому же состоянию сущности за счет уникальных ограничений иupsert. Например: “одна заявка на один email и тип” или “один платеж по transaction_id”.
В большинстве бизнес-систем обе модели встречаются одновременно: операция может повторяться, а сущность должна быть уникальной по доменным признакам.
Схемы ключей: что выбирать для идемпотентности
Идемпотентный ключ операции (operation_id)
Хороший operation_id обычно:
- генерируется клиентом (или шлюзом) и стабилен между повторами;
- достаточно уникален (UUID/ULID);
- связан с конкретным намерением (например, “создать заказ по корзине X”).
Типичный компромисс: если operation_id порождается клиентом, вы должны доверять его стабильности. Если генерируется сервером — повторный запрос уже не сможет его угадать без дополнительного протокола.
Где хранить факт операции?
В отдельной таблице “идемпотентности” (outbox/idempotency table) или в журнальной таблице бизнес-операций.
Доменный ключ сущности (natural key)
Если повтор запроса означает повтор того же “объекта” (например, “создай пользователя по email”), то проще и надежнее сделать уникальный ключ сущности:
users(email)сUNIQUE,orders(external_order_id)сUNIQUE,payments(provider_tx_id)сUNIQUE.
Тогда повторный запрос либо:
- упадет из‑за уникальности (и вы сможете обработать это предсказуемо),
- либо выполнится через
upsertи не создаст дубликаты.
Уникальные ограничения: фундамент, а не “защита на всякий случай”
Уникальные ограничения — это не “страховка от багов”, а центральный механизм корректности. Они дают БД право решать конфликт: два параллельных потока не смогут одновременно вставить одинаковый ключ.
Пример: уникальный индекс под доменный ключ
Допустим, внешняя система присылает платежи, у каждого есть provider_tx_id. Мы хотим гарантировать, что запись платежа появится один раз.
CREATE TABLE payments (
  id BIGSERIAL PRIMARY KEY,
  provider_tx_id TEXT NOT NULL,
  amount NUMERIC(12,2) NOT NULL,
  currency CHAR(3) NOT NULL,
  status TEXT NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  updated_at TIMESTAMPTZ NOT NULL DEFAULT now(),

  CONSTRAINT payments_provider_tx_id_uniq UNIQUE (provider_tx_id)
);
Теперь любые повторные попытки вставки с тем же provider_tx_id неизбежно встретят ограничение на уровне БД.
Частый нюанс: “уникальность по выражению”
Иногда нужно уникализировать не поле целиком, а нормализованное значение:
emailв нижнем регистре,- номер телефона без пробелов.
Тогда используйте уникальный индекс по выражению (в PostgreSQL):
CREATE UNIQUE INDEX payments_normalized_provider_tx_id_uniq
ON payments ((lower(provider_tx_id)));
Но тут важно понимать: нормализация должна быть детерминированной и одинаковой во всех точках, иначе вы получите ложные дубликаты или неожиданные конфликты.
Транзакции и изоляция: почему уникальность иногда “не спасает”
Уникальный индекс предотвращает появление двух строк с одинаковым ключом. Но он не гарантирует корректность бизнес-логики, если вы делаете сложные операции: проверили — затем вставили — затем записали связанные данные — и что-то падало посередине.
Рассмотрим типичный анти-паттерн:
SELECTпо ключу,- если нет строки —
INSERT, - затем
UPDATE/вставка в связанные таблицы.
В условиях параллельности два запроса могут одновременно увидеть “нет строки”, а затем оба попытаются вставить. В итоге один INSERT упадет по уникальности. Это еще не трагедия, но если вы не рассчитали обработку, транзакции разъедутся, часть данных может быть записана, а часть — нет.
Правило: идемпотентность лучше строить так, чтобы ключевые эффекты происходили в рамках одной транзакции и имели атомарный “insert-or-update” смысл.
Уровни изоляции: кратко по делу
- При
READ COMMITTEDв PostgreSQL повторное чтение может видеть свежие данные, которые появились между запросами в транзакции. - При
REPEATABLE READвы получите более стабильный снимок, но сложнее справляться с гонками обновления. - Для
upsertи уникальных индексов обычно достаточно стандартных гарантий БД, но важно не смешивать это с “двухфазной” логикой (select-then-insert) без корректного контроля.
Upsert: атомарная идемпотентность “одной командой”
upsert — это паттерн, когда команда вставляет строку, а при конфликте уникальности выполняет обновление или пропускает операцию. В PostgreSQL это выражается через INSERT ... ON CONFLICT.
Базовый upsert по уникальному ключу
INSERT INTO payments (provider_tx_id, amount, currency, status)
VALUES ('abc-123', 100.00, 'RUB', 'created')
ON CONFLICT (provider_tx_id)
DO UPDATE
SET
  amount = EXCLUDED.amount,
  currency = EXCLUDED.currency,
  status = EXCLUDED.status,
  updated_at = now();
Смысл:
- если записи нет — будет вставка;
- если запись с
provider_tx_idуже существует — она обновится по заранее заданному правилу.
Это и есть “идемпотентность на уровне данных” в простом виде: повторный вызов с теми же параметрами приведет к тем же результатам (или, как минимум, к одному и тому же состоянию в рамках вашего DO UPDATE).
Вариант: upsert без обновления (DO NOTHING)
Если повторный запрос должен быть нейтральным — не менять поля:
INSERT INTO orders (external_order_id, user_id, total)
VALUES ('ext-999', 42, 1490)
ON CONFLICT (external_order_id)
DO NOTHING;
Однако тогда вы должны решить, что возвращать пользователю/клиенту:
- “заказ существует” — и с каким набором данных,
- или “ничего не было изменено”.
Часто требуется сделать SELECT после upsert, чтобы вернуть актуальную запись. Но это уже дополнительный шаг — и он должен быть аккуратно оформлен в рамках транзакции или с учетом консистентности ответов.
Возвращение результата: RETURNING
В PostgreSQL можно сделать upsert и сразу получить результат:
INSERT INTO payments (provider_tx_id, amount, currency, status)
VALUES ('abc-123', 100.00, 'RUB', 'created')
ON CONFLICT (provider_tx_id)
DO UPDATE SET status = EXCLUDED.status, updated_at = now()
RETURNING id, provider_tx_id, status;
Это снижает количество запросов и упрощает построение идемпотентных ответов.
Как правильно выбрать логику обновления в upsert
Самая частая ошибка: в DO UPDATE вы бездумно перезаписываете поля, игнорируя то, что повторы могут приносить “старые” данные.
Например, повторный запрос со статусом created приходит позже, чем статус confirmed. Если вы обновляете status = EXCLUDED.status, вы можете откатить состояние.
Пример: “апдейт только если новый статус старше”
Предположим, у нас есть порядок статусов:
created<confirmed<captured
Можно закодировать приоритет и обновлять только в нужных случаях:
-- Допустим, priority определен так:
-- created=1, confirmed=2, captured=3
INSERT INTO payments (provider_tx_id, amount, currency, status)
VALUES ('abc-123', 100.00, 'RUB', 'confirmed')
ON CONFLICT (provider_tx_id)
DO UPDATE
SET
  status = EXCLUDED.status,
  updated_at = now()
WHERE payments.status IS DISTINCT FROM EXCLUDED.status
  AND (
    CASE EXCLUDED.status
      WHEN 'created' THEN 1
      WHEN 'confirmed' THEN 2
      WHEN 'captured' THEN 3
      ELSE 0
    END
  ) > (
    CASE payments.status
      WHEN 'created' THEN 1
      WHEN 'confirmed' THEN 2
      WHEN 'captured' THEN 3
      ELSE 0
    END
  );
Если статусы одинаковы — не меняем. Если новый статус “младше” — не откатываем.
Это делает upsert идемпотентным не только формально (повтор не создаст дубль), но и семантически (состояния не будут регрессировать).
Типовые гонки и как их предотвратить
Гонка №1: select-then-insert (TOCTOU)
Анти-паттерн:
SELECT ...по ключу- если не нашли —
INSERT ...
При параллельных запросах оба увидят “не найдено”, а затем столкнутся на уникальном ограничении. Даже если вы обработаете ошибку, вы усложните код и не гарантируете консистентность последующих операций.
Решение:
использовать INSERT ... ON CONFLICT или MERGE (в СУБД, где поддерживается) вместо “двух шагов”.
Гонка №2: частичная запись в транзакциях
Другой сценарий: в транзакции вы делаете несколько действий, одно из которых может упасть. Если обработка ошибки не учитывает, что часть данных уже создана/обновлена, вы получите “полуготовые” состояния.
Решение:
- ключевые изменения должны быть в одной транзакции;
- старайтесь, чтобы конфликт на уникальности был заранее “учтен” в запросе (upsert);
- при необходимости используйте внешние связи через FK и нужные ограничения, чтобы БД не позволила записать несогласованные данные.
Гонка №3: “апдейт перетирает более свежие данные”
Это уже не про дубли, а про правильность состояния. Два параллельных запроса могут прийти в разном порядке: один подтвердил, другой еще раз отправил создано.
Решение:
- обновляйте только при выполнении условий (приоритеты статусов, version/timestamp с проверкой, compare-and-set);
- храните
updated_at/versionи отклоняйте регрессию.
Паттерн с version:
ALTER TABLE payments ADD COLUMN version INT NOT NULL DEFAULT 0;

INSERT INTO payments (provider_tx_id, amount, currency, status, version)
VALUES ('abc-123', 100.00, 'RUB', 'created', 1)
ON CONFLICT (provider_tx_id)
DO UPDATE
SET
  amount = EXCLUDED.amount,
  currency = EXCLUDED.currency,
  status = EXCLUDED.status,
  version = payments.version + 1,
  updated_at = now()
WHERE payments.status IS DISTINCT FROM EXCLUDED.status;
Но если у вас есть внешний “номер версии” из события (например, event_sequence), лучше делать compare по нему, а не по текущему статусу.
Идемпотентность через таблицу операций (когда upsert не хватает)
upsert хорош, когда повторный запрос должен приводить к одному и тому же состоянию сущности. Но иногда повтор операции должен быть нейтральным целиком, включая все побочные эффекты: например, создать запись в журнале, отправить событие в очередь, начислить комиссию, записать несколько связанных сущностей.
Тогда удобно хранить отдельную таблицу:
operation_id(уникально),payload_hash(опционально),result(опционально),created_at.
Пример (PostgreSQL):
CREATE TABLE idempotent_operations (
  operation_id UUID PRIMARY KEY,
  kind TEXT NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  payload_hash BYTEA NOT NULL
);
Логика обработки:
- Начинаем транзакцию.
- Пытаемся вставить
operation_id. - Если конфликт — считаем, что операция уже сделана, и читаем нужные данные.
- Если вставка прошла — выполняем основной бизнес-код.
Ключевой момент: вставку в idempotent_operations делают первой и защищают уникальностью, чтобы любые повторные запросы гарантированно не выполняли побочные эффекты.
Как это выглядит на уровне SQL для “журнальной” части (upsert по operation_id):
INSERT INTO idempotent_operations (operation_id, kind, payload_hash)
VALUES ($1, $2, digest($3::text, 'sha256'))
ON CONFLICT (operation_id) DO NOTHING;
Дальше на уровне приложения вы решаете:
- если вставка произошла — выполняем остальную часть транзакции;
- если нет — просто возвращаем “как было”.
В некоторых системах это дополняют SELECT ... FOR SHARE/UPDATE для синхронизации чтения результата. Но базовая идея — та же: факт обработки хранится в БД, а уникальность защищает от повторов.
Дизайн схемы: практические рекомендации
1) Всегда фиксируйте, что именно уникально
Если вы не можете сформулировать уникальность — у вас будут “внезапные дубликаты” и хаотичная обработка ошибок. Варианты:
- внешний идентификатор из интеграции (
external_id); - доменной ключ (email/phone);
- номер события/поступления;
operation_id.
2) Ставьте уникальные индексы там, где должен быть “единственный факт”
Бизнес-правила должны быть выражены constraint’ами. Если “должно быть не больше одного” — это UNIQUE, а не “мы проверим в коде”.
3) Определите семантику upsert: что значит “обновить”
- Перезаписывать поля полностью?
- Обновлять только изменяемые атрибуты?
- Игнорировать повторные запросы (
DO NOTHING)? - Обновлять только вперед (по версии/приоритету)?
4) Схватывайте семантические гонки условиями
Уникальность предотвращает дубликаты, но не гарантирует, что вы не перезапишете “более свежие” данные старым событием.
5) Не смешивайте idempotency и “случайные” архитектурные компромиссы
Например, если вы возвращаете клиенту идентификатор созданной сущности, а upsert иногда делает DO NOTHING, вам придется обеспечить согласованный ответ (обычно через RETURNING или чтение после upsert).
Пример “правильного” upsert в транзакции (повторяемый запрос + корректный ответ)
Предположим, есть сценарий создания записи и одновременного обновления агрегата (например, сумма по пользователю). Если запрос повторяется, агрегат не должен удваиваться.
Есть два пути:
- делать агрегат производным от событий (и использовать строго возрастающий
event_id); - либо вести агрегацию с идемпотентным ключом.
Вариант: отдельная таблица обработанных событий + upsert для “строки события”.
BEGIN;

-- 1)