FastAPI под нагрузкой: как правильно организовать фоновые задачи, лимиты и graceful shutdown
Покажем практики для стабильной работы API под трафиком: что использовать для фоновых задач, как ввести лимиты одновременных операций, как отменять задачи при остановке и как избегать зависаний на shutdown. Будет упор на воспроизводимые проверки и наблюда
Содержание
Когда FastAPI «просто работает» в локальной среде, фоновые задачи выглядят как удобная мелочь: отправить письмо, обновить кэш, записать в очередь, запустить отчёт. Но под нагрузкой внезапно всплывают три класса проблем:
- Фоновые задачи продолжают выполняться после остановки приложения — процесс зависает на shutdown или, наоборот, завершается слишком рано и оставляет операции в неопределённом состоянии.
- Нет контроля параллелизма — десятки/сотни задач одновременно перегружают БД, файловую систему, внешние API и event loop.
- Поведение не наблюдаемо и не воспроизводимо — «на проде падает», а в тестах не видно, почему именно.
В этом материале разберём практики, которые помогают сделать FastAPI предсказуемым под трафиком: как организовать фоновые задачи, как ввести лимиты одновременных операций, как корректно отменять задачи при остановке, и как избежать зависаний на shutdown. Мы будем опираться на воспроизводимые проверки и наблюдаемое поведение, а не на «кажется, должно работать».
По пути коротко упомяну курс $ /course/ как один из вариантов углубиться в практики фоновой обработки и прод-эксплуатации, но основная часть материала — самостоятельное руководство.
Общая архитектура: где живут фоновые задачи в FastAPI
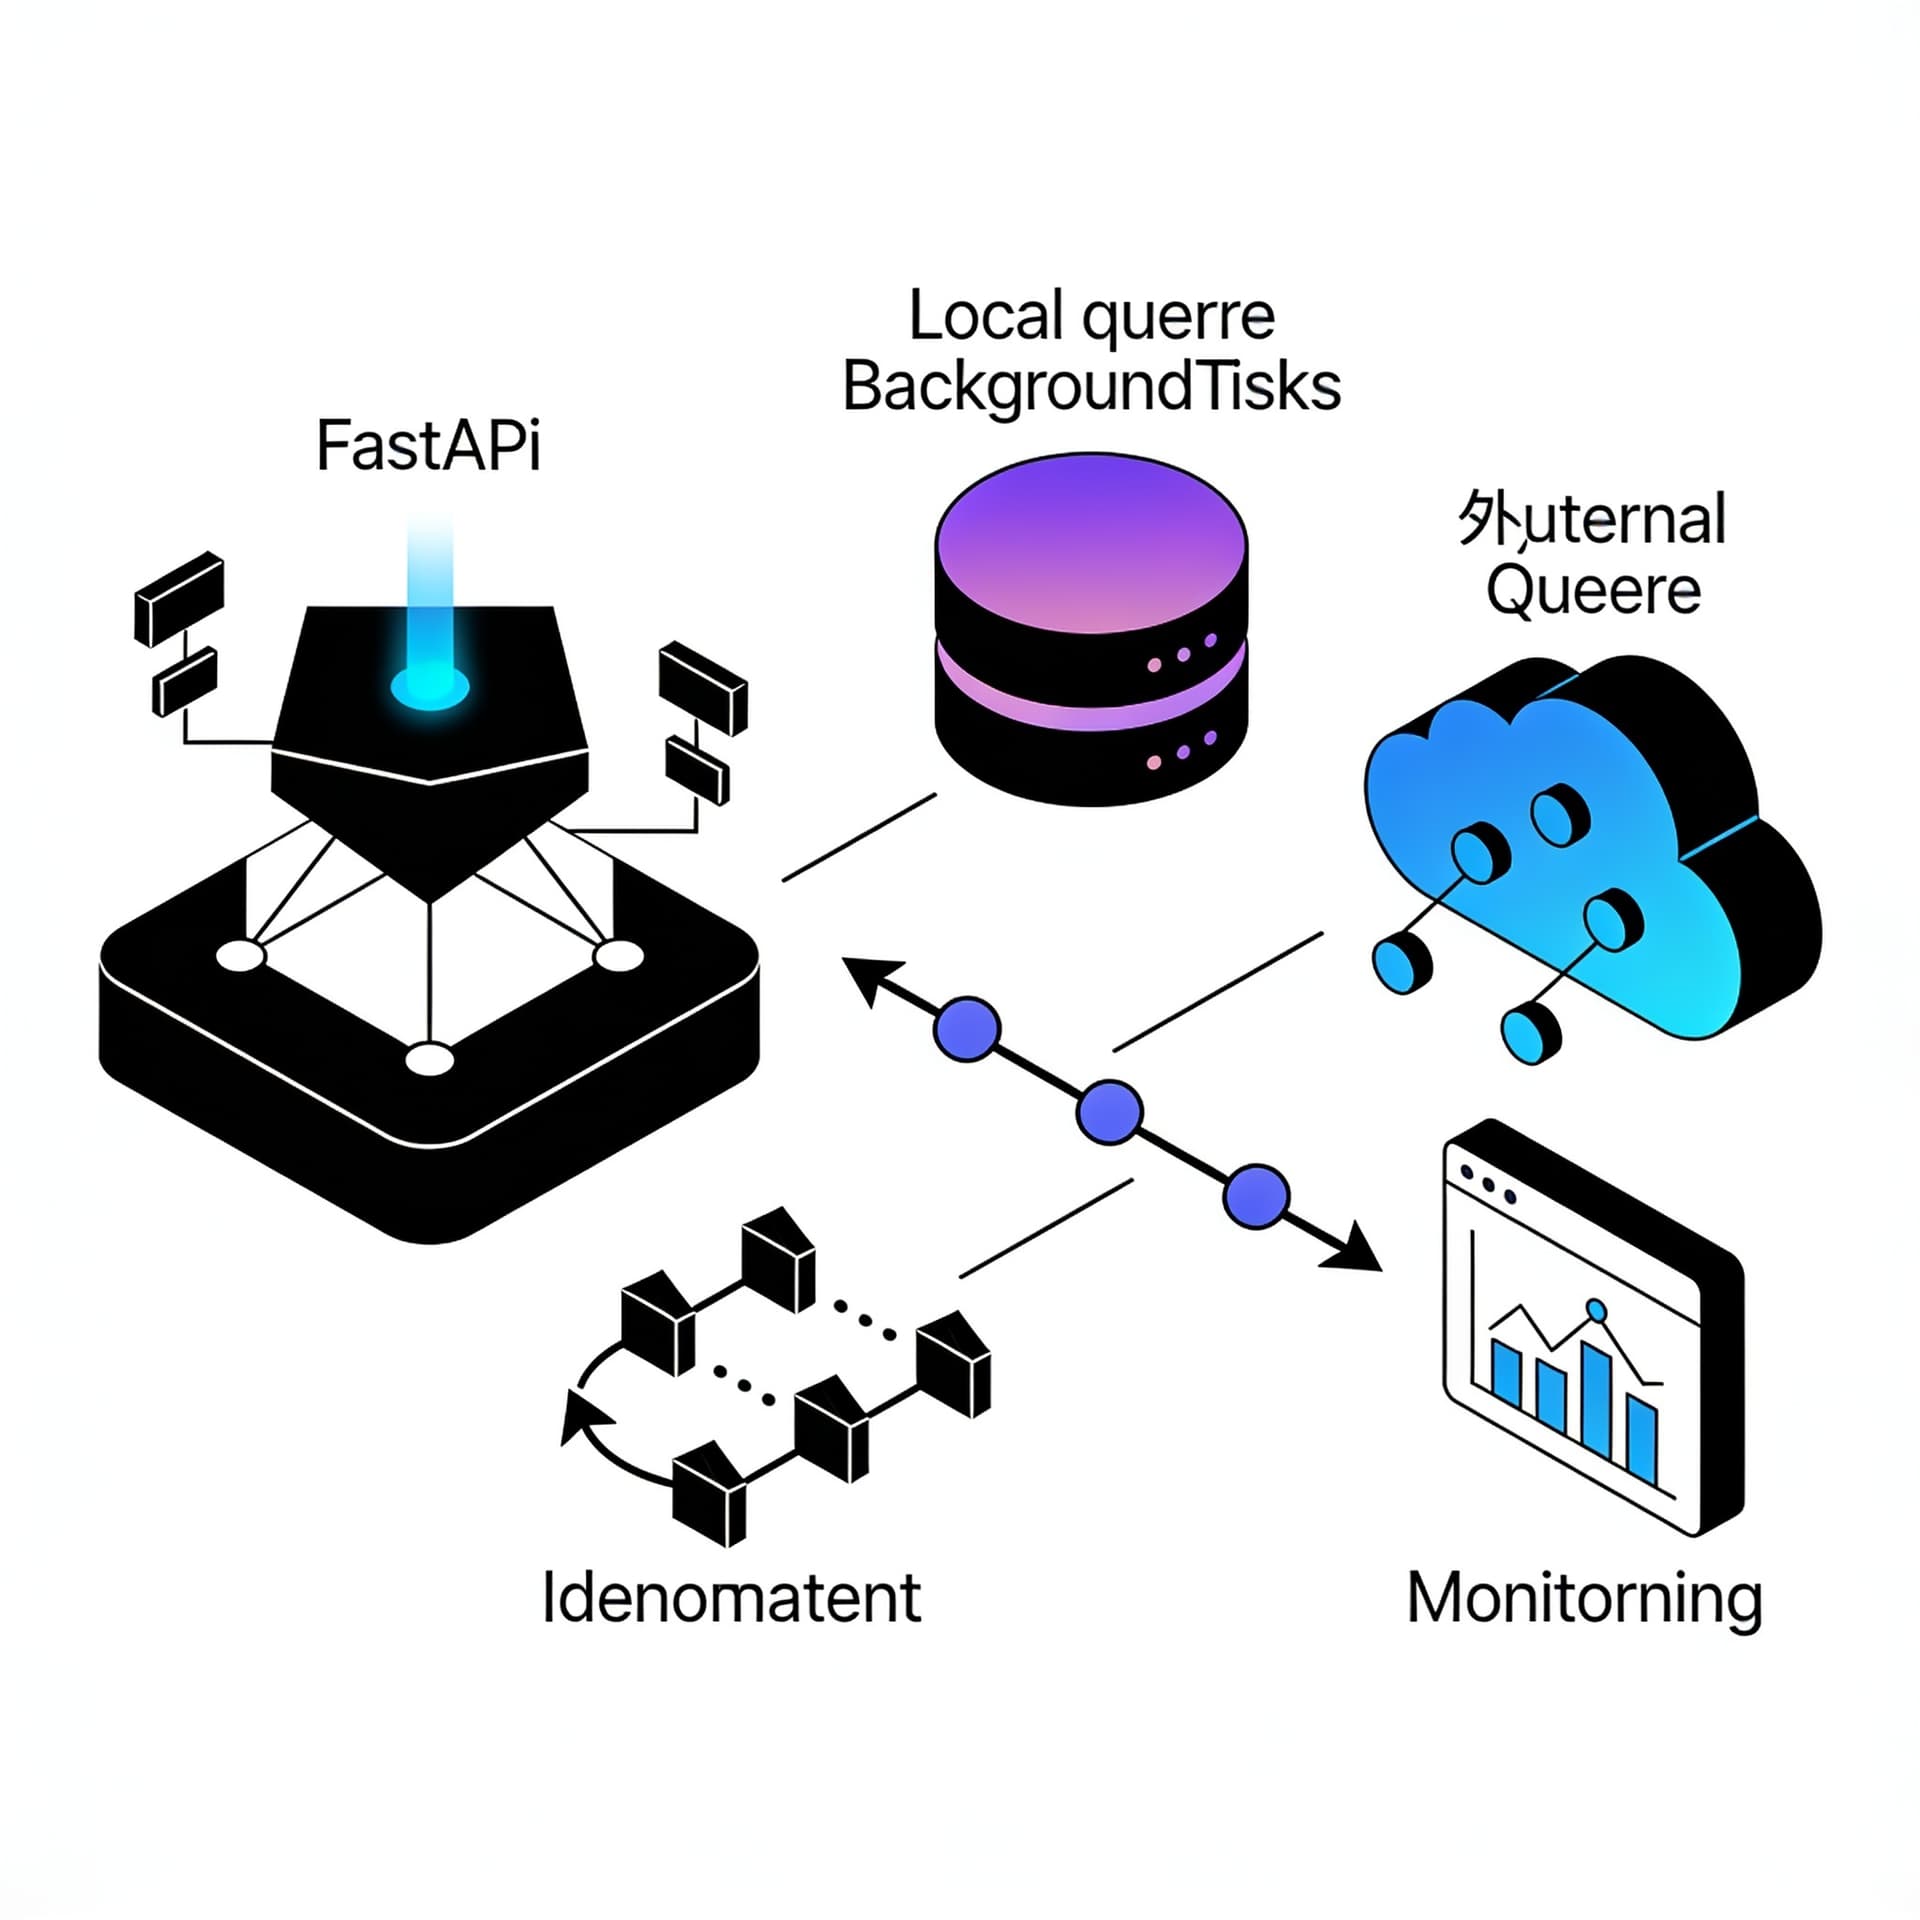
В FastAPI/Starlette фоновые задачи чаще всего делают одним из трёх путей:
1) BackgroundTasks — быстро, но со своими ограничениями
fastapi.BackgroundTasks позволяет зарегистрировать функцию, которая будет выполнена после ответа клиенту. Плюсы: простота. Минусы: фоновые задачи живут в рамках обработчика ответа и не всегда удобно управляются централизованно (лимиты, отмена, диагностика).
Для задач «в один клик» (например, логировать метрики) — нормально. Для фоновой работы под нагрузкой — обычно недостаточно.
2) Лёгкая очередь внутри приложения (asyncio task group / созданные задачи)
Часто делают так: при запросе создают asyncio.create_task(...), а затем хранят ссылки на задачи/семафоры и управляют ими. Плюсы: полный контроль. Минусы: нужно аккуратно обработать жизненный цикл приложения: запуск/остановка, отмена, ожидание завершения, защита от утечек задач.
3) Внешняя очередь (Redis/RabbitMQ/Kafka)
Это «правильнее» с архитектурной точки зрения для тяжёлой асинхронной обработки (воркеры отдельно от API). Но статья сфокусирована на внутрипроцессных практиках — там, где много приложений реально живут годами.
Что именно ломается под нагрузкой: характерные сценарии
Рассмотрим, как именно проявляются проблемы.
Сценарий A: shutdown зависает
Приложение получает сигнал остановки (SIGTERM), сервер начинает shutdown, но в это время фоновые tasks всё ещё:
- держат соединения к БД,
- ждут внешние HTTP,
- выполняют блокирующий код в event loop,
- не реагируют на отмену.
Результат: shutdown не завершается вовремя (часто это критично в Kubernetes), контейнер рестартится, а часть задач «обрывается» в середине.
Сценарий B: приложение падает от очередей задач
Если вы на каждый запрос создаёте новую задачу без лимитов, под всплеском трафика задачи копятся быстрее, чем успевают завершаться. Итог: рост памяти, рост числа активных соединений, перегрузка БД.
Сценарий C: непредсказуемое поведение при отмене
Отмена asyncio.Task.cancel() не является «гарантированной остановкой в любой момент». Задача должна:
- периодически проверять отмену,
- использовать await-операции, которые корректно выбрасывают
CancelledError, - не глотать
CancelledErrorслучайно.
Базовая стратегия: централизованный менеджер фоновых задач
Для воспроизводимого поведения нам нужен единый компонент, который:
- Отслеживает все созданные задачи.
- Ограничивает параллелизм через
asyncio.Semaphore. - Корректно отменяет задачи при shutdown и ждёт их завершения.
- Обеспечивает наблюдаемость: чтобы в тестах мы могли подтвердить, что задачи действительно отменены/завершены.
Минимальный каркас менеджера
Ниже — пример, который подходит как фундамент.
import asyncio
import logging
from contextlib import asynccontextmanager
from typing import Callable, Awaitable, Set

logger = logging.getLogger(__name__)


class BackgroundTaskManager:
    def __init__(self, *, concurrency_limit: int, stop_timeout: float = 10.0):
        self._semaphore = asyncio.Semaphore(concurrency_limit)
        self._stop_timeout = stop_timeout
        self._tasks: Set[asyncio.Task] = set()
        self._closing = asyncio.Event()

    async def start_job(self, coro: Awaitable, *, name: str = "job") -> None:
        if self._closing.is_set():
            # При закрытии не создаём новые задачи
            raise RuntimeError("Server is shutting down")

        async def runner():
            async with self._semaphore:
                try:
                    await coro
                except asyncio.CancelledError:
                    logger.info("Job %s cancelled", name)
                    raise
                except Exception:
                    logger.exception("Job %s failed", name)

        task = asyncio.create_task(runner(), name=name)
        self._tasks.add(task)
        task.add_done_callback(self._tasks.discard)

    async def shutdown(self) -> None:
        # Запрещаем новые задачи
        self._closing.set()

        tasks = list(self._tasks)
        if not tasks:
            return

        logger.info("Shutdown: cancelling %d background tasks", len(tasks))

        for t in tasks:
            t.cancel()

        # Ждём отмены, но ограничиваем таймаутом
        try:
            await asyncio.wait_for(
                asyncio.gather(*tasks, return_exceptions=True),
                timeout=self._stop_timeout,
            )
        except asyncio.TimeoutError:
            # Важно: не падать, но зафиксировать проблему.
            # В идеале, задачи должны быть отменяемыми.
            logger.warning("Shutdown timeout reached; some tasks may still be running")
Ключевые моменты:
- Семафор ограничивает количество одновременно выполняемых jobs внутри
async with. shutdown()отменяет задачи и ждёт их завершения, но с таймаутом, чтобы сервер не завис.CancelErrorне глотаем: даём ей «пройти» и отразить отмену в логах.
Интеграция с FastAPI: lifespan, middleware и контролируемые точки остановки
FastAPI поддерживает lifespan — удобный механизм для запуска/остановки ресурсов.
Подготовим приложение и маршруты
from fastapi import FastAPI, HTTPException
import asyncio
import httpx
import time

manager = BackgroundTaskManager(concurrency_limit=5, stop_timeout=10.0)


async def do_work(job_id: str) -> None:
    # Пример: внешнее HTTP + имитация нагрузки
    # Важно: используем await, чтобы отмена работала корректно.
    async with httpx.AsyncClient(timeout=5.0) as client:
        # имитация цепочки запросов
        await asyncio.sleep(0.2)
        await client.get("https://httpbin.org/delay/1", headers={"X-Job": job_id})


@asynccontextmanager
async def lifespan(app: FastAPI):
    # Можно здесь поднять ресурсы (БД, клиенты, очереди).
    yield
    # shutdown ресурсов в самом конце
    await manager.shutdown()


app = FastAPI(lifespan=lifespan)
Эндпоинт, который ставит задачу в менеджер
@app.post("/jobs")
async def create_job():
    job_id = str(time.time_ns())

    try:
        await manager.start_job(do_work(job_id), name=f"job-{job_id}")
    except RuntimeError:
        raise HTTPException(status_code=503, detail="Service is shutting down")

    # Быстро отвечаем, чтобы клиент не ждал фоновой работы
    return {"status": "accepted", "job_id": job_id}
С точки зрения API это выглядит как «fire and forget», но жизненный цикл под контролем: менеджер знает о задачах и отменит их на shutdown.
Лимиты: что и как лимитировать в реальных системах
Часто один семафор решает только часть проблемы. Под нагрузкой вам может понадобиться несколько слоёв лимитов:
- Параллелизм фоновых jobs (внутри приложения).
- Параллельные соединения в HTTP-клиенте/БД.
- Таймауты на внешние операции.
- Лимит очереди запросов/accept (например, если вы не хотите бесконечно принимать входящие).
Простой семафор — только первый шаг
В примере выше семафор ограничивает количество задач, которые реально выполняются одновременно. Это защищает БД/HTTP от «штормов» внутри приложения.
Но не забывайте: даже если job ограничен семафором, внутри do_work вы можете запускать параллельные подзадачи без лимитов. Тогда защита частично теряется.
HTTP-клиент: лимит соединений и backpressure
httpx.AsyncClient сам по себе держит пул соединений. Однако важно:
- задавать разумные
timeout, - не делать бесконечное число запросов внутри одного job,
- учитывать, что отмена должна прерывать ожидания в
await client.get(...).
Также имеет смысл добавлять ограничение на количество одновременных исходящих HTTP, если у вас есть несколько типов задач. Это можно сделать отдельными семафорами на каждую подсистему.
Отмена задач: как добиваться корректного graceful shutdown
Отмена Task.cancel() работает только если задача «cooperative». Правило простое:
- если внутри задачи есть
awaitна отменяемых операциях — отмена сработает. - если задача делает блокирующий код (например,
time.sleep, тяжёлая обработка CPU, синхронные запросы) — отмена будет ждать, пока блок завершится.
Практика: убедитесь, что нет блокировок
Пример неправильной задачи:
import time

async def bad_work():
    time.sleep(3)  # Блокирует event loop — отмена будет неактивной
Правильный вариант:
async def good_work():
    await asyncio.sleep(3)  # отмена сработает через CancelledError
Если есть CPU-нагрузка — выносите в thread/process pool или отдельный воркер.
Избегаем зависаний на shutdown: контроль времени и «неотменяемых» участков
Даже при корректном await некоторые операции могут быть «долго отменяемыми»: например, ожидание внешнего ответа с очень большим таймаутом.
Решение:
- таймауты на внешние запросы,
- ограничение времени shutdown в
BackgroundTaskManager.shutdown()(у нас он есть), - по возможности — быстрая реакция на cancellation.
Пример: явная проверка отмены
async def do_work(job_id: str) -> None:
    async with httpx.AsyncClient(timeout=5.0) as client:
        for step in range(10):
            # Периодически проверяем отмену
            await asyncio.sleep(0.2)
            # если отмена прилетела, здесь будет CancelledError
            await client.get("https://httpbin.org/delay/0.1", headers={"X-Job": job_id})
В большинстве случаев await достаточно, но явная логика помогает, когда вы делаете большие циклы или есть части кода без await.
Воспроизводимые проверки: как доказать, что shutdown работает
Обычно проблемы с отменой обнаруживают «вручную» на проде. Наша цель — уметь воспроизвести в тесте. Для этого удобно:
- использовать тестовый сервер (например,
httpx.AsyncClientилиTestClient), - запустить несколько job’ов,
- инициировать shutdown приложения,
- убедиться, что задачи отменены/завершены в пределах timeout.
Важный момент для тестов
В unit/integration тестах корректнее проверять не «внутренние логи», а наблюдаемые эффекты:
- количество завершившихся задач,
- что не осталось «зависших» задач в менеджере,
- что shutdown вернул управление за заданное время.
Чтобы это было возможно, менеджер стоит расширить счётчиками или хранилищем статусов.
Расширим менеджер для счётчиков
class BackgroundTaskManager:
    def __init__(self, *, concurrency_limit: int, stop_timeout: float = 10.0):
        self._semaphore = asyncio.Semaphore(concurrency_limit)
        self._stop_timeout = stop_timeout
        self._tasks: Set[asyncio.Task] = set()
        self._closing = asyncio.Event()

        self.started = 0
        self.cancelled = 0
        self.finished = 0

    async def start_job(self, coro: Awaitable, *, name: str = "job") -> None:
        if self._closing.is_set():
            raise RuntimeError("Server is shutting down")

        self.started += 1

        async def runner():
            async with self._semaphore:
                try:
                    await coro
                except asyncio.CancelledError:
                    self.cancelled += 1
                    raise
                except Exception:
                    # в тестах можно отдельно считать ошибки, но здесь опустим
                    pass
                finally:
                    # finished — только если задача реально отработала до конца,
                    # но в finally это смешает отмену и успех. Поэтому ниже — аккуратнее.
                    ...

        # Чтобы корректно различать завершение и отмену,
        # лучше считать finished в другом блоке:
Здесь важно не «усложнить» код ради примера. Практически: в runner делайте finished += 1 только после успешного await coro, а при CancelledError — cancelled += 1 и return без увеличения finished.
Тестовая задача, которая гарантированно отменяемая
async def cancellable_task():
    try:
        # Дольше, чем stop_timeout, чтобы проверить отмену
        await asyncio.sleep(60)
    except asyncio.CancelledError:
        # Это место — чтобы убедиться, что отмена доходит до задачи
        raise
Проверка shutdown по времени
Идея: вызвать manager.shutdown() с маленьким stop_timeout (например, 0.5 сек) и убедиться, что метод вернулся примерно за это время, а отмены были зафиксированы.
Псевдокод логики:
- создать менеджер с
stop_timeout=0.5 - стартовать 10 задач
cancellable_task() - вызвать
await manager.shutdown() - измерить длительность (должна быть около 0.5–0.7 секунд)
- убедиться, что
manager.cancelled > 0
На практике это делается через pytest и pytest-asyncio.
Тестирование поведения без ожидания 60 секунд: сокращаем время предсказуемости
В реальных тестах нельзя ждать секунды «в надежде». Лучше сделать задачу, которая ждёт событие:
- на shutdown менеджер отменяет задачу,
- задача выходит немедленно через
CancelledError.
Например:
async def wait_forever():
    try:
        await asyncio.Event().wait()  # никогда не будет установлено
    except asyncio.CancelledError:
        raise
Тогда тест не зависит от sleep и работает стабильно.
Частые ошибки
Ошибка 1: «Глотание» CancelledError
Если вы делаете except Exception: и туда же попадает CancelledError, отмена может не распространиться и shutdown начнёт «буксовать».
Правильно: отдельно ловить asyncio.CancelledError и пробрасывать дальше.
Ошибка 2: Блокирующий код в async-контексте
time.sleep, синхронные запросы, тяжёлая CPU-обработка внутри async def — всё это делает отмену неэффективной и может зависнуть shutdown.
Ошибка 3: Непредсказуемое создание задач
Создавать asyncio.create_task(...) внутри обработчика можно, но без централизованного учёта вы теряете контроль: при ошибках, утечках и остановке системы задачи останутся бесконтрольными.
Ошибка 4: Нет ответа клиенту при shutdown
Если вы прекращаете принимать новые задачи, лучше отвечать 503 или похожим кодом, а не позволять задачам создаваться «на границе» shutdown.
Что выбрать для прод-качества: практический чеклист
Ниже — краткий, но рабочий набор критериев, по которым можно оценить реализацию фоновых задач в FastAPI.
Для фоновых задач
- Все фоновые операции используют
awaitна отменяемых I/O. - Таймауты на внешние вызовы заданы.
- Есть лимиты параллелизма (как минимум один на уровень выполнения).
- Есть централизованный учёт задач (иначе отмена превращается в лотерею).
Для shutdown
- Используется
lifespanдля согласованного запуска/остановки. - На shutdown есть:
- отмена задач,
- ожидание с таймаутом,
- защита от зависаний.
- Не создаются новые задачи после начала закрытия.
Для наблюдаемости и тестов
- Есть воспроизводимая проверка: задачи отменяются и shutdown завершается в заданное время.
- Логи содержат идентификаторы задач и факт отмены/ошибок (хотя бы минимально).
Полная примерная схема: FastAPI + менеджер задач + graceful shutdown
Соберём в компактный цельный пример.
import asyncio
import logging
import time
from contextlib import asynccontextmanager
from typing import Awaitable, Set

import httpx
from fastapi import FastAPI, HTTPException

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("app")


class BackgroundTaskManager:
    def __init__(self, *, concurrency_limit: int, stop_timeout: float = 10.0):
        self._semaphore = asyncio.Semaphore(concurrency_limit)
        self._stop_timeout = stop_timeout
        self._tasks: Set[asyncio.Task] = set()
        self._closing = asyncio.Event()

    async def start_job(self, coro: Awaitable, *, name: str) -> None:
        if self._closing.is_set():
            raise RuntimeError("Server is shutting down")

        async def runner():
            async with self._semaphore:
                try:
                    await coro
                    logger.info("Job %s finished", name)
                except asyncio.CancelledError:
                    logger.info("Job %s cancelled", name)
                    raise
                except Exception:
                    logger.exception("Job %s failed", name)

        task = asyncio.create_task(runner(), name=name)
        self._tasks.add(task)
        task.add_done_callback(self._tasks.discard)

    async def shutdown(self) -> None:
        self._closing.set()

        tasks = list(self._tasks)
        if not tasks:
            return

        logger.info("Shutdown: cancelling %d tasks", len(tasks))

        for t in tasks:
            t.cancel()

        try:
            await asyncio.wait_for(
                asyncio.gather(*tasks, return_exceptions=True),
                timeout=self._stop_timeout,
            )
        except asyncio.TimeoutError:
            logger.warning("Shutdown timeout reached")


manager = BackgroundTaskManager(concurrency_limit=5, stop_timeout=5.0)


async def do_work(job_id: str) -> None:
    async with httpx.AsyncClient(timeout=3.0) as client:
        # Имитируем несколько шагов
        await client.get("https://httpbin.org/delay/0.8", headers={"X-Job": job_id})
        await asyncio.sleep(0.2)
        await client.get("https://httpbin.org/delay/0.8", headers={"X-Job": job_id})


@asynccontextmanager
async def lifespan(app: FastAPI):
    yield
    await manager.shutdown()


app = FastAPI(lifespan=lifespan)


@app.post("/jobs")
async def create_job():
    job_id = str(time.time_ns())
    try:
        await manager.start_job(do_work(job_id), name=f"job-{job_id}")
    except RuntimeError:
        raise HTTPException(status_code=503, detail="Server is shutting down")

    return {"status": "accepted", "job_id": job_id}
Куда копать глубже
Если вы хотите системно разобраться не только в «как сделать отмену», но и в том, как проектировать фоновые операции, наблюдаемость, ошибки и эксплуатационные сценарии (включая нагрузочное поведение), можно рассмотреть материал по теме в виде практического курса: [ /course/ ]. Это один из способов структурировать знания и получить больше готовых паттернов, а не собирать всё по кускам из документации.
Вывод
Под нагрузкой фоновые задачи в FastAPI — это не «добавка», а часть производственной модели приложения. Надёжность появляется не от уверенности автора, а от контроля:
- Менеджер задач + централизованный жизненный цикл (lifespan).
- Лимиты параллелизма (семафоры) там, где вы создаёте нагрузку.
- Graceful shutdown с отменой и ожиданием с таймаутом, чтобы не зависнуть при остановке.
- Отмена должна быть кооперативной: только async I/O, таймауты, никаких блокировок event loop.
- Воспроизводимые проверки — чтобы проблема не всплывала только на проде.
Если вы внедрите эти практики, FastAPI под трафиком станет заметно стабильнее: shutdown будет предсказуемым, а система — управляемой даже при «пике» и резком прекращении работы.
Если хотите, я могу дополнить статью примерами нагрузочных тестов (pytest + httpx, имитация SIGTERM, проверка количества активных tasks) и шаблоном для метрик (например, Prometheus) — чтобы наблюдаемость была не логом в консоли, а частью качества системы.