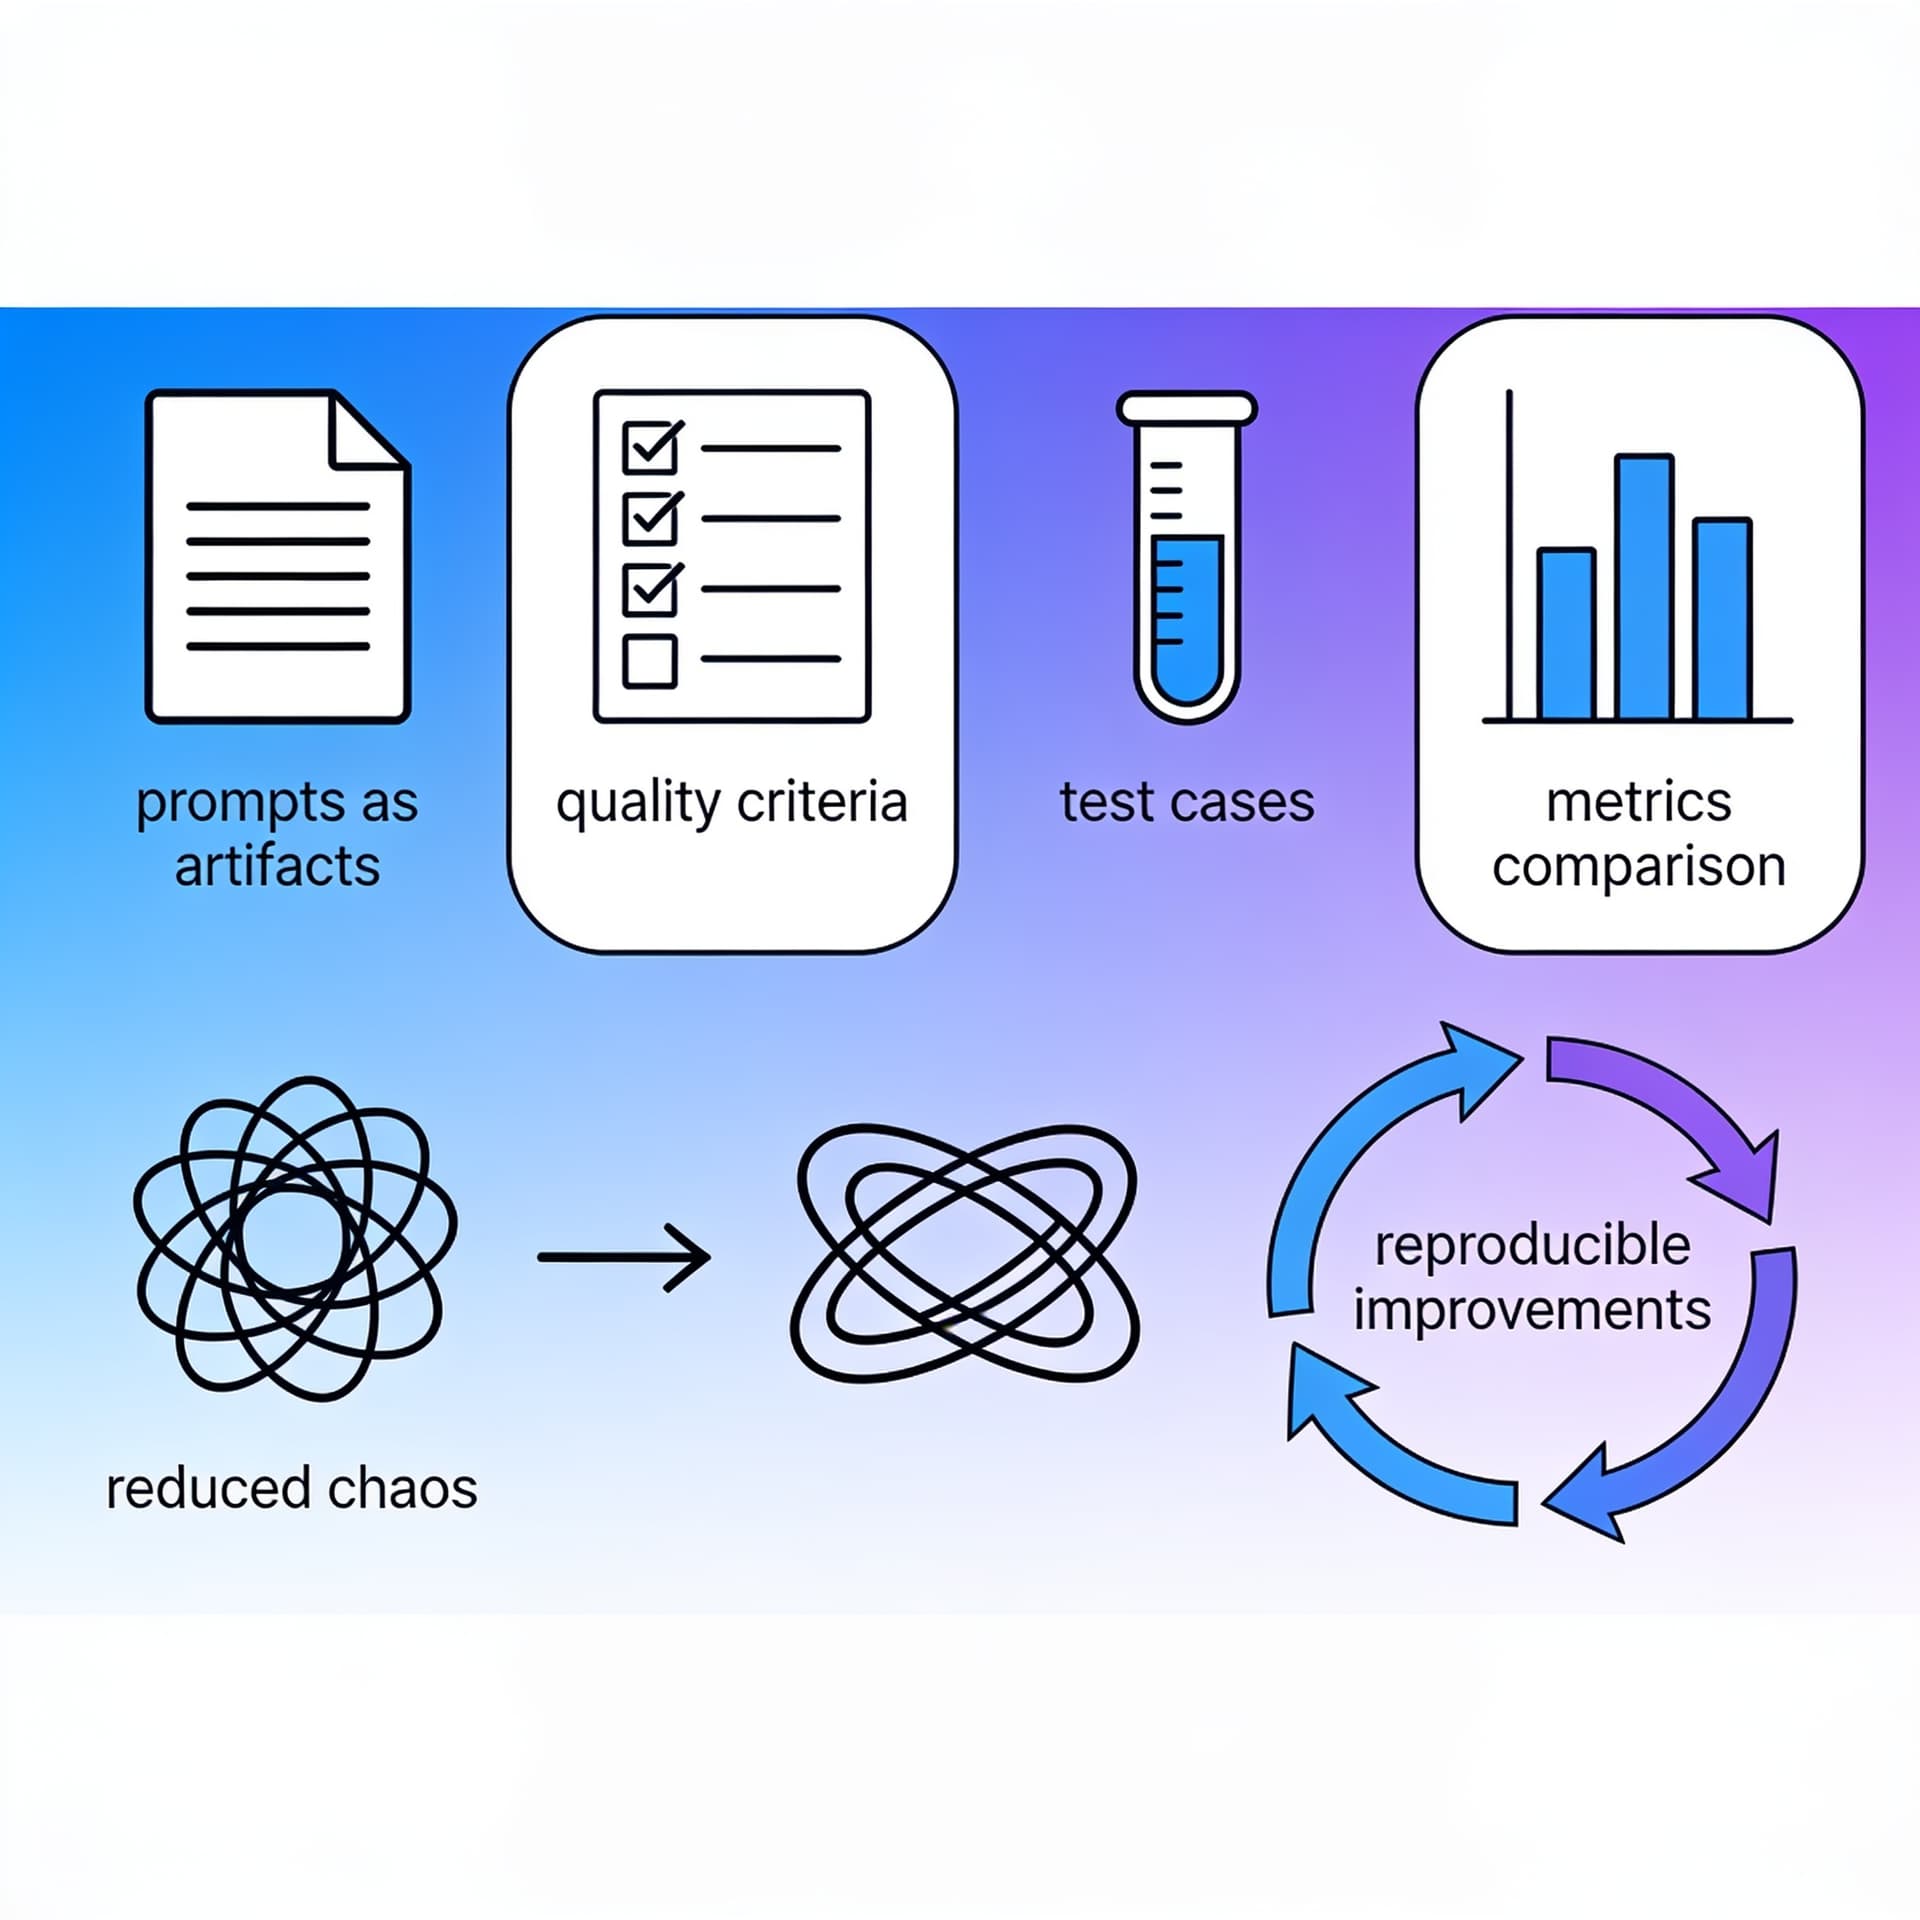
Структура промпт-пайплайна для прикладных LLM: маршрутизация, валидация, эвристики и регрессии
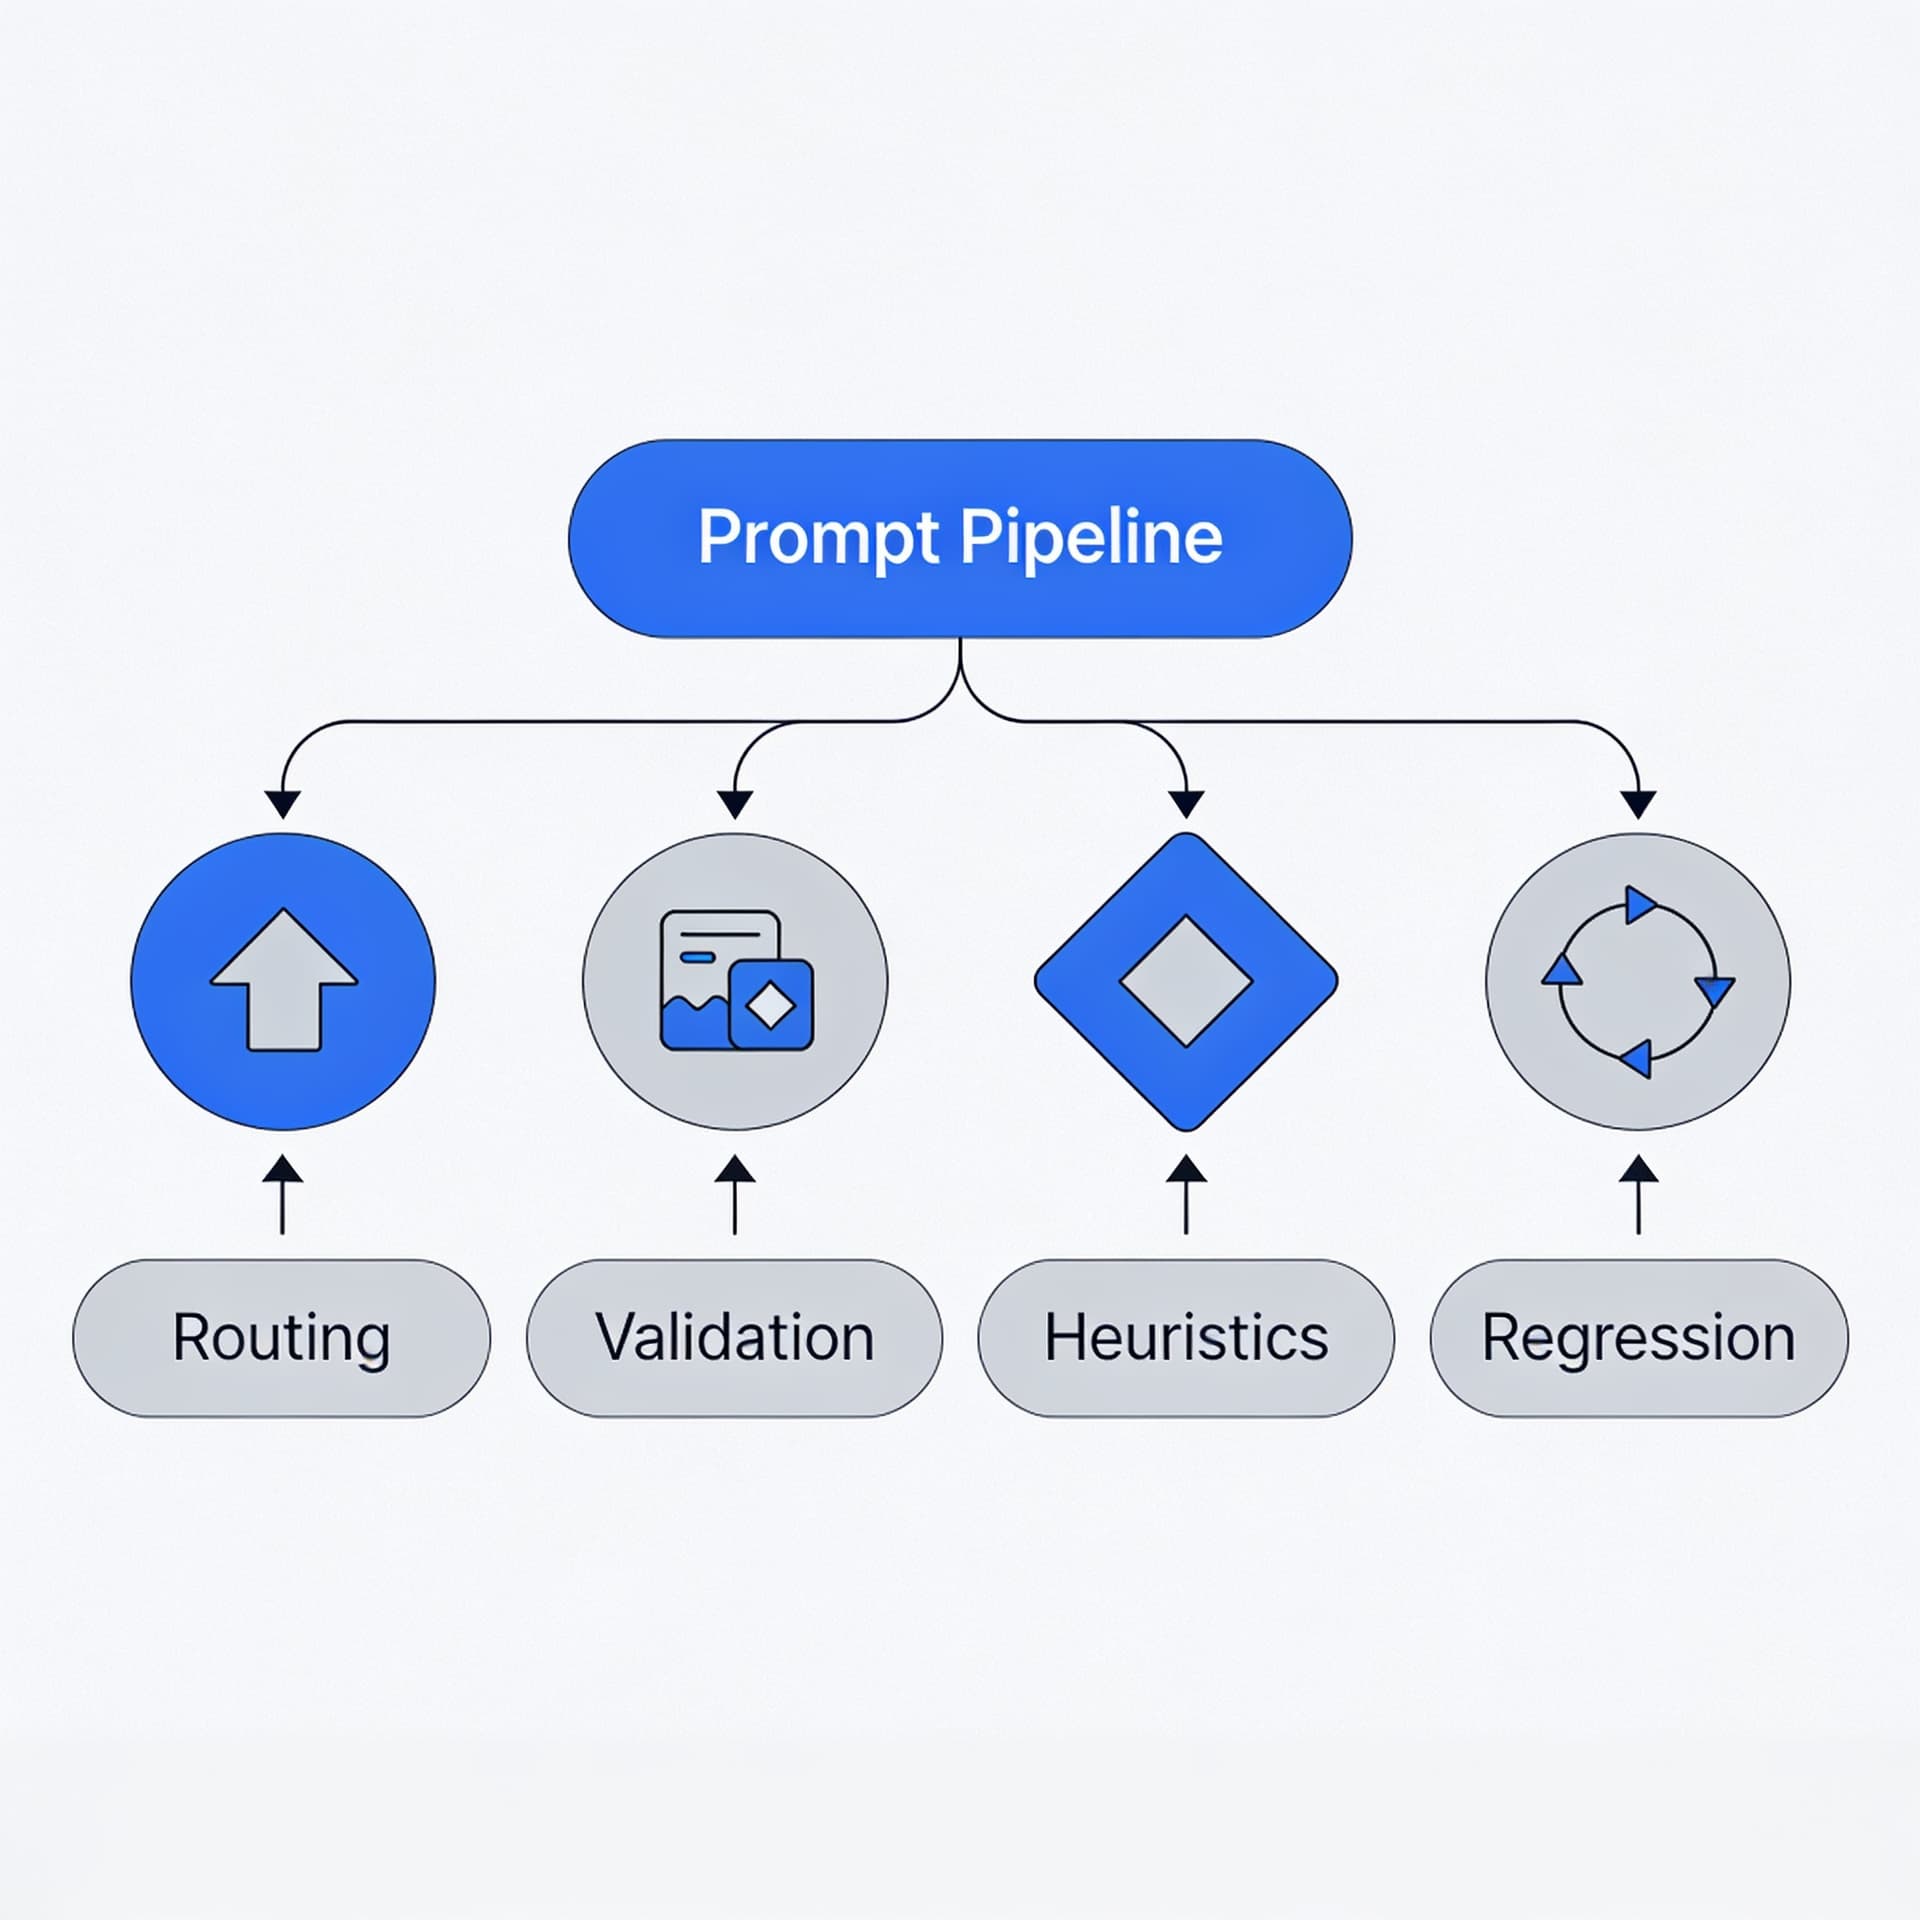
Покажем, как превратить единичный промпт в воспроизводимый пайплайн: ветвление по типу запроса, контроль качества входных/выходных данных, правила для fallback и набор регрессионных тестов. Статья будет полезна тем, кто внедряет LLM в продукт, а не просто
Содержание
При внедрении LLM в продукт быстро выясняется простая истина: «правильный промпт» почти никогда не равен «правильной системе». Единичный запрос в чате может выглядеть убедительно, но в боевых условиях вы сталкиваетесь с непредсказуемостью поведения модели, различиями во входных данных, требованиями к формату ответа, задержками, стоимостью токенов и сложной бизнес-логикой.
Поэтому практичный вопрос звучит иначе:
Как превратить один промпт в воспроизводимый промпт-пайплайн, который стабильно работает на разных типах запросов, контролирует качество и выдерживает изменения модели?
Ниже — структурированный подход к пайплайну прикладных LLM: маршрутизация, валидация, эвристики и fallback, а также регрессионные тесты, которые превращают LLM-часть в инженерный модуль, а не в «магический вызов».
Что такое промпт-пайплайн и зачем он нужен
Промпт-пайплайн — это не просто строка с инструкциями. Это последовательность стадий (иногда с ветвлениями), где каждый шаг:
- готовит вход (нормализация, выбор шаблона);
- выбирает стратегию (какую модель/температуру/формат использовать);
- проверяет качество входа и/или выхода;
- применяет правила деградации (fallback);
- логирует и измеряет метрики;
- запускает регрессионные тесты при изменениях.
В типичном продукте пайплайн отвечает на вопросы, извлекает сущности, классифицирует запросы, генерирует структурированный результат (JSON/табличные поля), пишет тексты по заданным правилам или выполняет пошаговые действия.
Проблема экспериментов в том, что они почти не фиксируют:
- контракт между системой и LLM (формат, обязательные поля, ограничения);
- поведение при ошибках (что делать, если ответ “почти” правильный);
- пороговые значения качества (как решать, что считать приемлемым);
- неизменность результата при обновлении модели/промпта/параметров.
Пайплайн решает это инженерно: вы задаёте правила игры и делаете их исполнимыми.
Шаг 1. Договориться о контракте: вход, выход и “границы” ответственности
Прежде чем строить ветвления и fallback, определите контракт. Без него любые проверки превращаются в субъективные “кажется, норм”.
Входной контракт
Определите, в каком виде система получает запрос:
user_text— текст пользователя;context— метаданные: язык, домен, роль пользователя, настройки доступов;constraints— ограничения: максимальная длина, язык ответа, стиль, запреты (например, без мед. советов);request_type(опционально) — если маршрутизатор использует это поле.
Дополнительно полезно хранить:
schema_version— версия контракта формата;request_id— для трассировки;grounding(если есть) — сведения из базы/документов, на которые модель должна опираться.
Выходной контракт
LLM должен возвращать либо:
- строго структурированный объект (например, JSON по JSON-Schema);
- или текст по заранее заданным правилам (но всё равно с проверками).
Практически всегда предпочтительнее структурированный ответ. Даже если конечный продукт покажет пользователю текст, внутренний контракт стоит делать машиночитаемым.
Пример минимального контракта для задачи “классификация + краткий ответ”:
{
  "request_type": "billing_question",
  "intent": "refund",
  "confidence": 0.82,
  "summary": "Похоже, вы хотите вернуть оплату за ...",
  "actions": [
    { "type": "ask_clarification", "question": "Укажите номер заказа ..." }
  ]
}
Границы ответственности
Чётко разделите:
- что делает LLM (семантика, синтез, извлечение из текста);
- что делает код/сервис (валидация, проверка прав доступа, выбор тарифов, транзакции).
LLM не должен решать бизнес-операции без проверок. Ему можно делегировать “предложение действий”, но финальное исполнение — всегда в коде.
Шаг 2. Маршрутизация: ветвление по типу запроса
Первый практический этап — определить, какому “режиму” следовать. Маршрутизатор должен быть быстрым и относительно дешевым, чтобы не тратить ресурсы на сложную обработку до понимания типа запроса.
Подходы к маршрутизации
- Правила (regex/ключевые слова/эвристики) — хорошо для явных классов.
- Классификация модели (LLM-as-a-router) — если классы семантические.
- Гибрид — правила для базовой сегментации + модель для тонкой классификации.
На практике чаще всего работает гибрид: правила отсеивают очевидное, а модель обрабатывает “пограничные” случаи.
Выбор стратегии на основе request_type
Примеры стратегий:
- формат ответа: JSON vs текст;
- требуемый уровень детализации;
- необходимость поиска в БД (RAG);
- температура/стохастика: ниже для классификаций, выше для генерации;
- выбор “инструментальной” схемы: использовать tool-calling или чистую генерацию.
Маршрутизатор: пример на Python
Ниже — каркас маршрутизации с валидацией решений. В реальном проекте классификацию можно сделать LLM-запросом или локальным классификатором.
from enum import Enum
from dataclasses import dataclass
import re

class RequestType(str, Enum):
    BILLING = "billing_question"
    SUPPORT = "support_request"
    GENERAL = "general_chat"
    UNKNOWN = "unknown"

@dataclass
class RouteDecision:
    request_type: RequestType
    strategy: str          # имя стратегии пайплайна
    confidence: float      # для эвристик fallback
    needs_retrieval: bool  # нужно ли RAG/поиск

def route(user_text: str) -> RouteDecision:
    t = user_text.lower()

    # 1) Жёсткие правила
    if re.search(r"\b(возврат|refund|вернуть|возместить)\b", t):
        return RouteDecision(RequestType.BILLING, "billing/refund", 0.93, False)

    if re.search(r"\b(как|почему|где|что делать)\b", t) and len(t) < 250:
        return RouteDecision(RequestType.SUPPORT, "support/short_answer", 0.78, False)

    # 2) Плавающий случай — сюда можно вставить LLM-классификацию
    # route_conf = llm_router_confidence(...)
    route_conf = 0.55
    if route_conf >= 0.6:
        return RouteDecision(RequestType.GENERAL, "general/assistant", route_conf, True)

    return RouteDecision(RequestType.UNKNOWN, "general/assistant", route_conf, True)
Важно: маршрутизатор не должен “выдумывать”. Если он не уверен — включайте fallback в более безопасную стратегию (например, короткие уточняющие вопросы или универсальный режим).
Шаг 3. Валидация входа: проверка качества данных до вызова LLM
Если вход плохой, LLM может выглядеть “неправильной”, хотя проблема в данных. Валидация входа — это способ стабилизировать систему.
Что валидировать
- Язык: ожидаемый язык ответа/домена.
- Размер: лимиты контекста, число символов/токенов.
- Пустые/мусорные сообщения: слишком короткий текст, одни служебные символы.
- Контекстные поля: наличие
user_id, корректность прав доступа. - Санитизация: удаление управляющих символов, нормализация пробелов.
Валидация по схеме и правилам
Рекомендуется хранить схему входных данных (например, через Pydantic или JSON-Schema). Так проверки будут воспроизводимыми и версионируемыми.
Пример упрощённой валидации входа:
from pydantic import BaseModel, Field, ValidationError

class LLMInput(BaseModel):
    user_text: str = Field(min_length=1, max_length=4000)
    user_language: str
    request_id: str
    constraints_json: dict | None = None

def validate_input(payload: dict) -> LLMInput:
    try:
        return LLMInput(**payload)
    except ValidationError as e:
        # Важно: вернуть управляемую ошибку, а не падать.
        raise ValueError(f"Invalid input: {e}")
Шаг 4. Формирование промпта как “композиция”, а не строка
Чтобы пайплайн был поддерживаемым, промпт должен быть построен из компонент:
- системные инструкции (роль, политика);
- контракт вывода (schema/формат);
- данные пользователя и контекст;
- ограничения: стиль, язык, длина;
- требования к ошибкам: “если данных нет — запросить уточнение”.
Принцип: промпт должен быть проверяемым
Хорошая практика — включать в промпт:
- точные определения классов/полей;
- запрет на “лишние” поля;
- требование: при неопределенности — fallback ответ.
Пример компонента промпта для извлечения структурированных действий:
Ты — модуль извлечения intents и плана действий.
Верни строго JSON без пояснений.

Схема ответа:
{
  "request_type": string,
  "intent": string | null,
  "confidence": number 0..1,
  "summary": string | null,
  "actions": [
    {"type": "ask_clarification", "question": string}
  ]
}

Правила:
- Если не хватает данных для intent — intent=null и actions=[ask_clarification].
- confidence отражает уверенность на 0..1.
- Не добавляй дополнительные поля.
И да: промпт — это не гарантия. Он лишь повышает вероятность того, что LLM выдаст то, что вы просите. Гарантию дают валидации.
Шаг 5. Валидация выхода: проверка структуры, семантики и “разумности”
После ответа LLM вы обязаны проверить:
- Синтаксис/структура: JSON валиден, поля присутствуют, типы корректны.
- Семантика: значения в допустимых пределах, согласованность полей.
- Бизнес-правила: например, запрет действовать без уточнений.
- Качество: признаки халлюцинаций/противоречий (эвристически).
Проверка по JSON Schema
Если вы требуете JSON, используйте строгую валидацию.
Пример (идея, не привязка к конкретной библиотеке):
import json
from jsonschema import validate, Draft7Validator

RESPONSE_SCHEMA = {
    "type": "object",
    "properties": {
        "request_type": {"type": "string"},
        "intent": {"anyOf": [{"type": "string"}, {"type": "null"}]},
        "confidence": {"type": "number", "minimum": 0, "maximum": 1},
        "summary": {"anyOf": [{"type": "string"}, {"type": "null"}]},
        "actions": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "type": {"const": "ask_clarification"},
                    "question": {"type": "string", "minLength": 5}
                },
                "required": ["type", "question"],
                "additionalProperties": False
            }
        }
    },
    "required": ["request_type", "intent", "confidence", "summary", "actions"],
    "additionalProperties": False
}

def validate_output(output_text: str) -> dict:
    data = json.loads(output_text)
    Draft7Validator(RESPONSE_SCHEMA).validate(data)
    return data
Семантические проверки (которые JSON Schema не поймает)
JSON schema не проверит, например, что intent согласован с actions. Такие проверки делаются отдельными правилами.
Пример:
- Если
intent=None, тоactionsдолжны содержать толькоask_clarification. - Если
confidence < 0.45, тоже просим уточнение или делаем fallback.
def semantic_checks(data: dict) -> None:
    if data["intent"] is None:
        # Должны быть запрос уточнения
        if not data["actions"] or data["actions"][0]["type"] != "ask_clarification":
            raise ValueError("When intent=None, actions must ask clarification.")

    if data["confidence"] < 0.45:
        # Высокий шанс ошибки: требуем уточнение
        if not data["actions"] or data["actions"][0]["type"] != "ask_clarification":
            raise ValueError("Low confidence must trigger ask_clarification.")
Проверка “контроля качества” через отдельный LLM-критик
Иногда стоит добавить второй этап: LLM-критик, который проверяет качество ответа по критериям (формат, полнота, отсутствие запрещённых утверждений). Это не заменяет строгие проверки, но может усилить “контроль” в сложных текстовых задачах.
Ключевой нюанс: критик — тоже источник ошибок, поэтому его вывод должен быть формализован (вердикт + причины + поля). И желательно делать это детерминированнее: меньшая температура.
Шаг 6. Эвристики и fallback: как система деградирует предсказуемо
Fallback — это то, что отличает инженерный пайплайн от “потыкали промпт и повезло”.
Типовые сценарии fallback
- Невалидный формат: JSON не парсится → повтор с инструкцией “верни валидный JSON”.
- Низкая confidence: вместо попытки угадать — задать уточняющий вопрос или выбрать безопасный универсальный режим.
- Семантическое несоответствие: schema верна, но логика конфликтует → повтор с указанием ошибки или переход в другой тип стратегии.
- Токсичность/нарушения политики: включить безопасный модерационный режим (или отказ).
- Недостаточно контекста для решения: включить retrieval или уточнения.
Эвристики: что реально помогает
- Повторы ограниченного типа: вместо “ещё раз, попробуй лучше” — “исправь конкретные ошибки в JSON/полях”.
- “Fix-it” промпт: отдельный шаблон для коррекции ответа по ошибкам парсинга/валидации.
- Ограничение на количество попыток: обычно 1–2, иначе рост стоимости и задержек.
- Трассировка причин: сохраняйте, что именно пошло не так (парсинг, schema, sem-check).
- Снижение творческой части при fallback (температура ниже, инструкции строже).
Пример пайплайна с fallback (упрощённо)
MAX_ATTEMPTS = 2

def run_llm_pipeline(llm, route_decision, input_payload):
    last_error = None

    for attempt in range(MAX_ATTEMPTS):
        try:
            prompt = build_prompt(route_decision, input_payload, attempt=attempt)
            output_text = llm.generate(prompt, temperature=0.2)

            data = validate_output(output_text)
            semantic_checks(data)

            return {
                "data": data,
                "attempts": attempt + 1,
                "fallback_used": attempt > 0
            }

        except Exception as e:
            last_error = e
            # fallback логика: формируем “исправляющий” промпт
            # например, если ошибка парсинга — просим вернуть JSON.
            # если семантика — просим привести actions к правилам.
            continue

    # Последний шаг: безопасная деградация
    return {
        "data": {
            "request_type": "unknown",
            "intent": None,
            "confidence": 0.0,
            "summary": None,
            "actions": [{
                "type": "ask_clarification",
                "question": "Не удалось однозначно понять запрос. Можете уточнить, что именно вы хотите получить?"
            }]
        },
        "attempts": MAX_ATTEMPTS,
        "fallback_used": True,
        "error": str(last_error)
    }
Обратите внимание: fallback не “скрывает проблему”. Он делает системное поведение предсказуемым и пригодным для аналитики.
Шаг 7. Регрессионные тесты: как перестать бояться изменений
Llm-пайплайны ломаются не только из-за “плохих промптов”. Типичные причины:
- обновили модель (другая логика, другое поведение на пограничных примерах);
- изменили промпт-компоненты;
- поменяли schema/валидацию;
- поменяли retrieval-контент;
- вырос/упал контекст (другие прецеденты внутри модели).
Регрессионные тесты нужны, чтобы поймать эти изменения до продакшена.
Что тестировать
Разделите тесты на несколько уровней:
- Парсинг/валидация: на наборе входов LLM всегда возвращает корректный JSON по схеме.
- Семантические инварианты: например,
intent=None⇒ actions=ask_clarification. - Точность маршрутизации: классы запросов остаются теми же (с допусками по confidence).
- Отсутствие запрещённых режимов: например, не рекомендуем действия, требующие платежа, без соответствующих данных.
- Детерминированность при температуре=0 (если вы так используете). Это полезно для контроля, но не всегда возможно.
Как измерять качество
Не всегда нужно сравнивать “строку в строку”. Для многих задач достаточно набора проверок:
- JSON валиден;
- обязательные поля есть;
- confidence в разумном диапазоне;
- request_type/intent совпадает с ожидаемым классом;
- действия соответствуют правилам.
Для некоторых задач (генерация текста) может быть нужен эвристический скоринг: например, проверка присутствия ключевых утверждений, отсутствие запрещённых формулировок, соответствие длине.
Формат регрессионного датасета
Обычно делают “golden set”:
input_payload(вход);- ожидаемые инварианты (
expected_schema_version,expected_request_type, правила по confidence); - допустимые отклонения (например, intent может быть null на неразмеченных кейсах).
Пример теста в стиле pytest (псевдореальность, но структура понятна):
def test_refund_routing_and_actions(llm, client):
    payload = {
        "user_text": "Хочу вернуть деньги за заказ #12345",
        "user_language": "ru",
        "request_id": "t1",
        "constraints_json": {"max_answer_chars": 800}
    }

    route_decision = route(payload["user_text"])
    result = run_llm_pipeline(llm, route_decision, payload)
    data = result["data"]

    assert data["request_type"] == "billing_question"
    assert data["intent"] in ("refund", "return", None)
    assert 0.0 <= data["confidence"] <= 1.0

    # При низкой уверенности должна быть просьба уточнить
    if data["confidence"] < 0.45:
        assert data["actions"][0]["type"] == "ask_clarification"
Контракт на стабильность: “что меняем — что тестим”
Чтобы регрессионные тесты работали как инженерный инструмент, нужна договорённость:
- Если поменяли промпт-компонент — прогоняем тесты полного набора.
- Если поменяли только схему/валидацию — прогоняем тесты на JSON-контрактах.
- Если поменяли routing — прогоняем тесты маршрутизации и fallback.
- Если поменяли retrieval — прогоняем тесты с зафиксированным контекстом (снимки документов или seed).
Шаг 8. Наблюдаемость: логирование, трассировка и причины отказов
Даже идеальный пайплайн требует мониторинга. Минимальный набор:
- вход (с редактированием PII при необходимости);
- выбранная стратегия (route_decision);
- версия промпта (template_version);
- версия schema;
- параметры модели (температура, max_tokens);
- сырое значение ответа LLM (или хотя бы хэш);
- ошибки валидации (парсинг/JSON schema/semantic_checks);
- факт fallback (сколько попыток, почему);
- метрики качества (например, доля валидных JSON, доля кейсов с confidence < threshold).
Эта “телеметрия” превращает разбор инцидентов из гадания в конкретику: вы сможете увидеть, на каком шаге деградирует система и при каких входах.
Практический эталон пайплайна: собранный скелет
Суммируем архитектуру в виде структуры:
- Validate input (Pydantic/Schema + нормализация).
- Route decision (правила + router или универсальный режим).
- Build prompt (композиция инструкций + контракт вывода).
- Call LLM (параметры под режим).
- Validate output (JSON schema + semantic checks).
- Fallback (исправляющий промпт или безопасный режим).
- Persist logs + metrics.
- Regress tests (золотой набор + инварианты).
Так вы получаете предсказуемость и воспроизводимость.
Частые ошибки при построении промпт-пайплайнов
Ошибка 1: считать промпт “технической спецификацией”
Промпт — лишь подсказка. Технические гарантии дают схемы, проверки и тесты.
Ошибка 2: отсутствие контракта “что считать ошибкой”
Если вы не определили, когда включается fallback, система будет либо слишком часто “деградировать”, либо скрывать ошибки.
Ошибка 3: отсутствие семантических проверок поверх JSON
JSON schema закрывает синтаксис, но не логику. Без semantic_checks вы будете принимать противоречивые ответы.
Ошибка 4: бесконтрольные повторные вызовы LLM
Повторы без ограничения и без “исправляющей” инструкции приводят к росту стоимости и задержек и часто не дают улучшения.
Ошибка 5: тесты “по строке”
Для прикладных задач лучше тестировать инварианты и структуру. Сравнение “ровно такое же” почти всегда делает тесты хрупкими.
Вывод
Хороший промпт-пайплайн — это дисциплина инженерии: маршрутизация по типу запроса, строгий контракт входа/выхода, валидация и семантические проверки, предсказуемый fallback и регрессионный тест-набор, который отслеживает качество при изменениях модели и промпта.
Если вам нужно углубиться в подходы к построению таких систем (включая практики для качества, тестирования и архитектуры вокруг LLM), можно начать с материала из курса — как отправной точки для системного понимания, а дальше развивать это под требования вашего продукта.
Главная мысль простая: LLM в продукте — это не “один промпт”, а контур контроля, где модель — только один из компонентов, а воспроизводимость обеспечивается правилами, валидацией и тестами.