Внедрение ruff в существующий проект: стратегия “снизу вверх”, чтобы не сломать команду
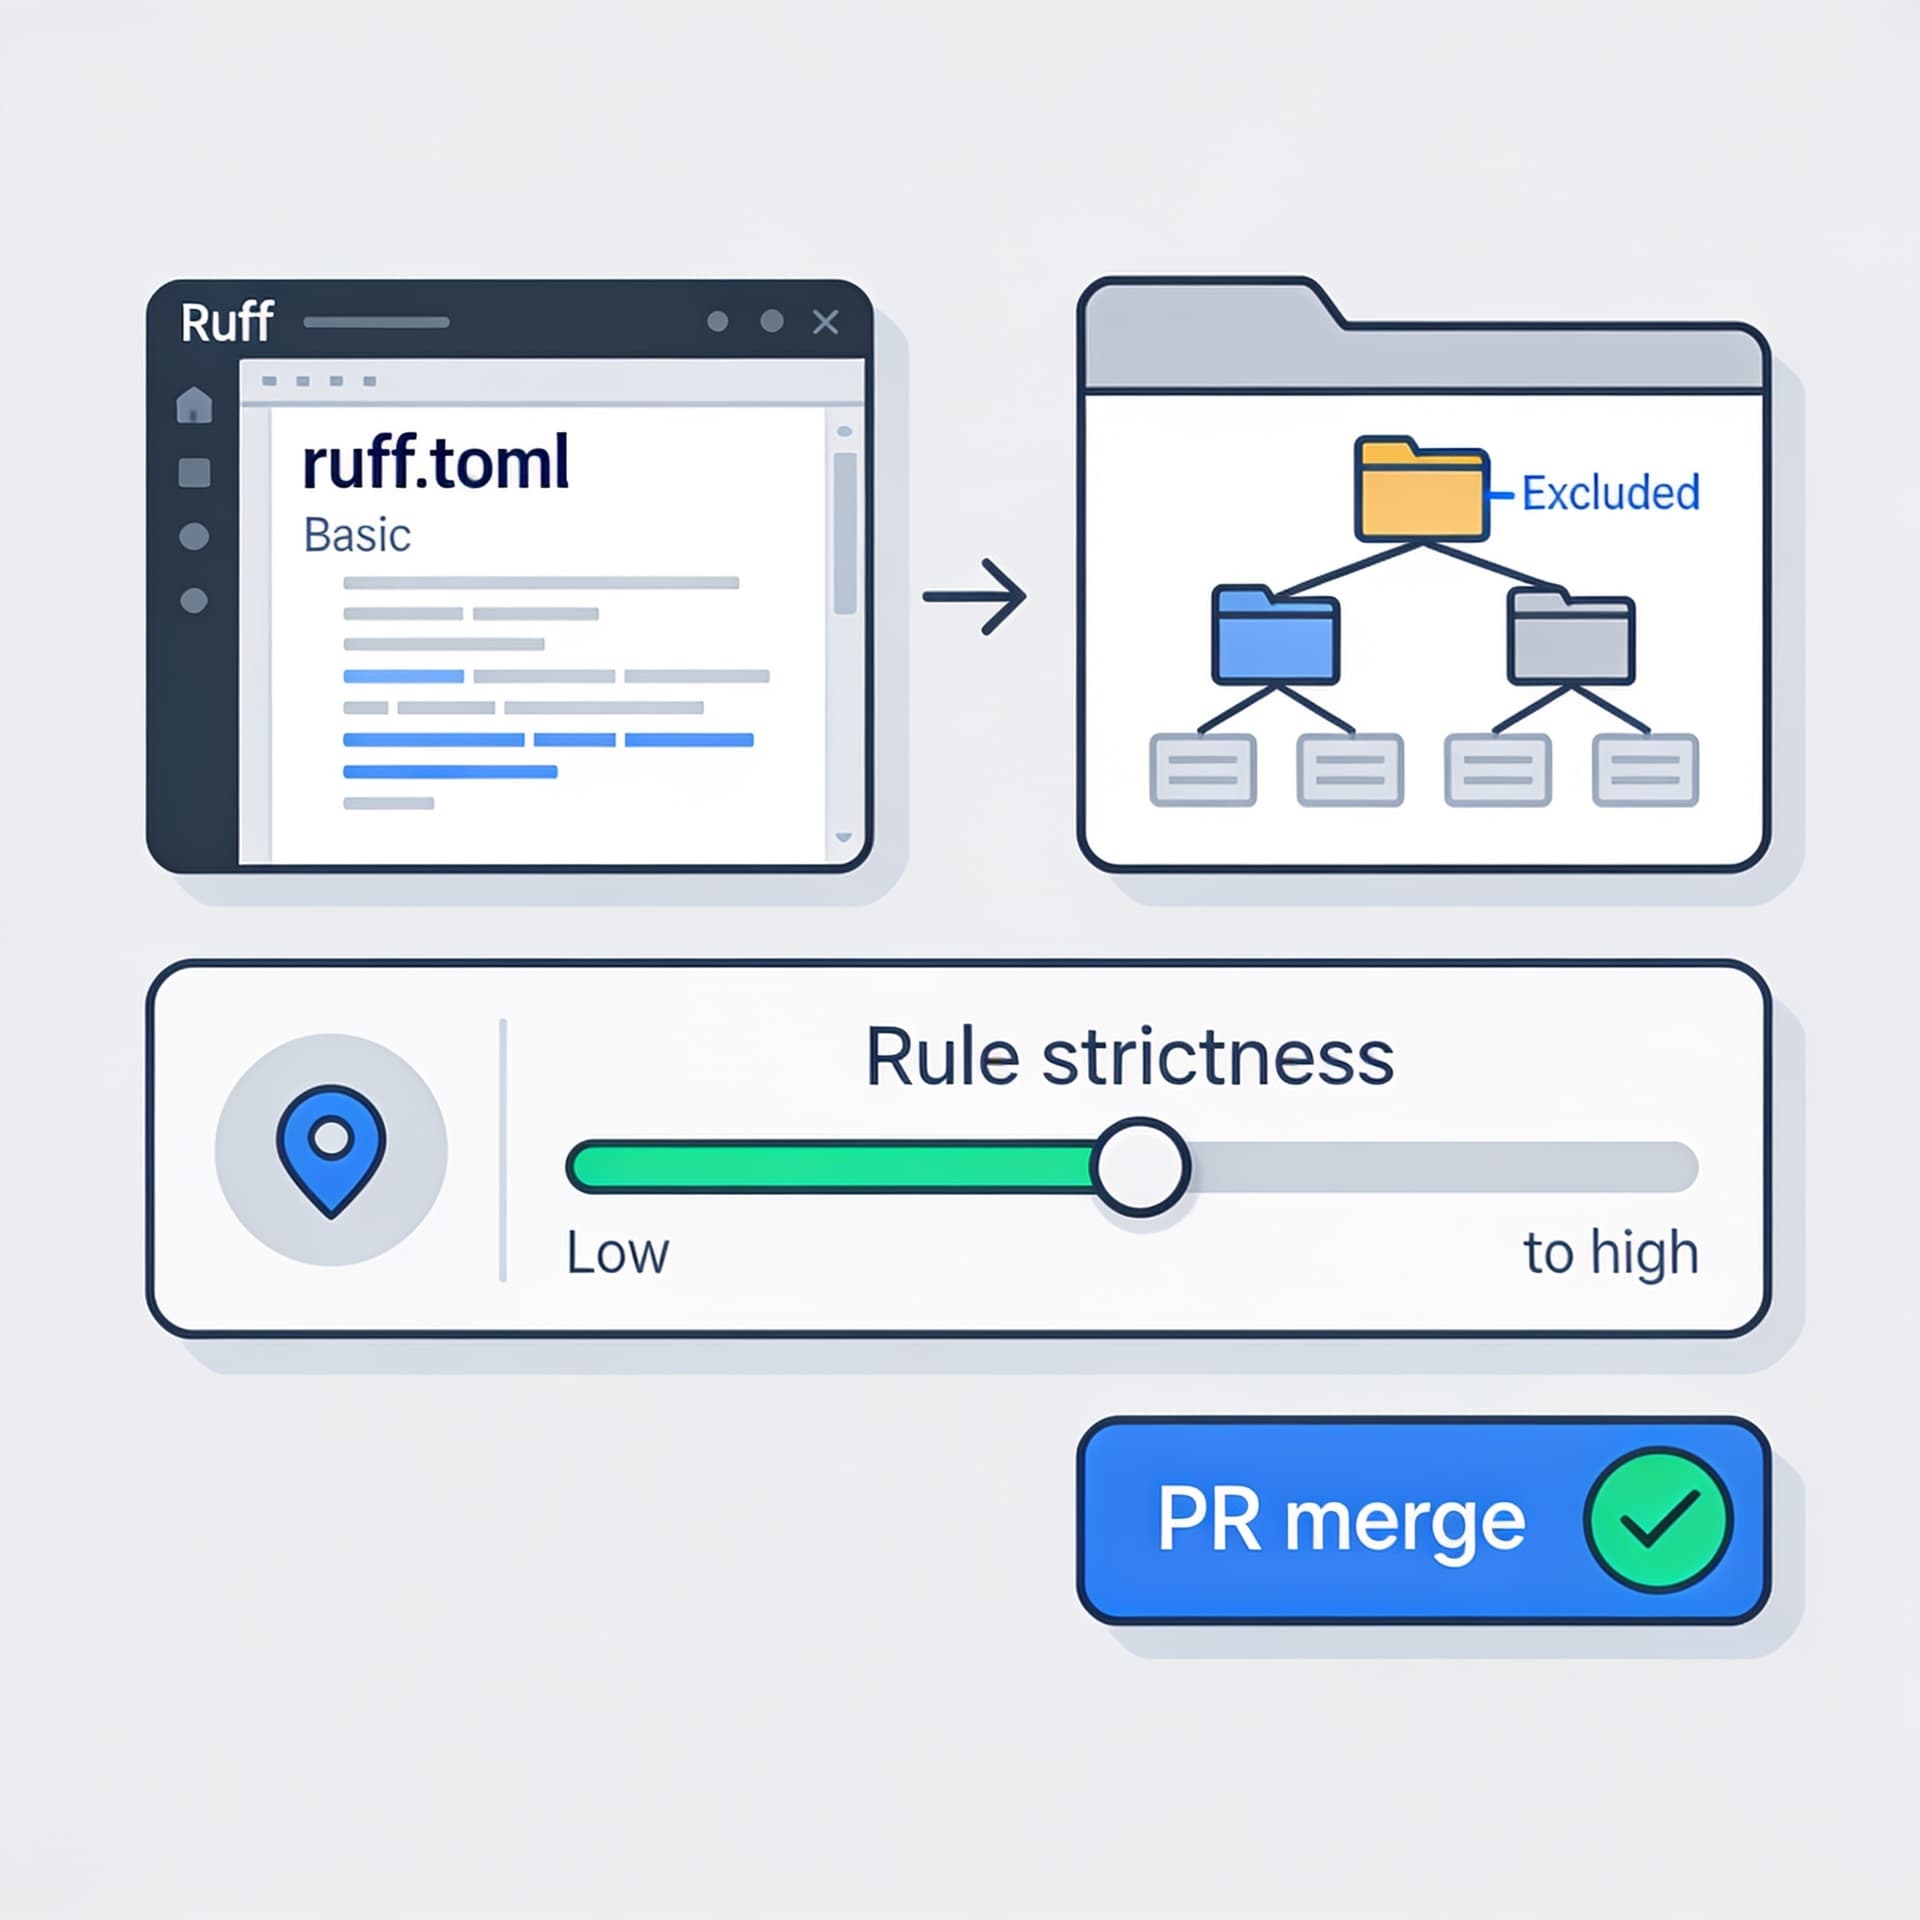
Как добавить линтер поэтапно: базовая конфигурация, исключения по каталогам, поэтапное ужесточение правил и контроль качества в PR. Дадим план внедрения на 2–4 недели.
Содержание
Когда в проекте появляется новый линтер, это почти всегда конфликт интересов: команда хочет улучшений, но не хочет “взять и переделать полрепозитория”. Особенно болезненно линтеры ощущаются в момент внедрения — ведь предупреждения копятся годами, а правила меняются от версии к версии.
Выход — внедрять ruff поэтапно “снизу вверх”, не начиная с максимального набора правил и не обещая немедленного “идеального кода”. Вместо этого мы:
- добавляем минимальную базовую конфигурацию;
- настраиваем исключения и “границы” внедрения по каталогам;
- ужесточаем правила постепенно;
- переносим качество в процесс через контроль качества в PR.
Ниже — практичный план на 2–4 недели, с конфигурацией, типичными проблемами и чеклистом для команды.
Что ruff делает и почему важно внедрять его осторожно
Ruff — быстрый Python-линтер/форматтер, который агрегирует правила из экосистемы (в т.ч. flake8-подобные и более современные проверки). Его сильные стороны:
- высокая скорость работы (что важно для CI и локальной разработки);
- единая конфигурация в
pyproject.toml; - возможность включать/выключать правила с высокой детализацией.
Но у “скорости” есть обратная сторона: ruff выдаёт много проблем почти сразу, если включить широкие наборы правил. В существующем проекте это может привести к:
- лавине коммитов “только под линтер”;
- конфликтам стилей между разными участками кода;
- росту времени PR (и раздражению ревьюеров);
- ощущению, что “линтер сломан”, хотя он корректно находит проблемы.
Стратегия “снизу вверх” решает это организационно и технически.
Рамки внедрения: сначала согласуем договорённости
Перед правками кода стоит договориться, что именно мы хотим получить от ruff в ближайшие недели.
Цели на первую итерацию (обычно 2–4 недели):
- остановить деградацию качества: новые нарушения не попадают в
main; - привести проект к “минимально управляемому” уровню текущих проблем;
- заложить основу для дальнейшего ужесточения.
Не цели первой итерации:
- “закрыть 100% проблем сегодня”;
- “мгновенно включить все правила и сделать идеальный стиль”.
На практике в первой итерации лучше стремиться к тому, чтобы ruff проходил CI с разумным набором правил и чтобы разметка “что считается нарушением” была понятна всем.
Неделя 0 (до старта): подготовка и аудит “поверхности”
1) Определяем, где живёт конфигурация
В большинстве Python-проектов конфигурация ruff хранится в pyproject.toml. Если у вас есть отдельные конфиги — это не проблема, но единый источник правды упрощает сопровождение.
2) Уточняем, есть ли автоформатирование
У ruff есть ruff format. Но даже если вы планируете форматтер, для “снизу вверх” можно начать только с линтинга. Форматтер легко ломает историю коммитов на старте, если подключить слишком рано.
3) Проверяем текущее состояние проекта
Откройте примерно 10–20 PR за последнее время и оцените:
- как часто ревьюеры ругают за стиль/простые ошибки;
- есть ли в PR постоянные мелкие нарушения (import order, типичные опечатки, “неиспользуемые” и т.п.).
Это помогает выбрать первичные правила.
Неделя 1: базовая конфигурация без истерики
Шаг 1. Устанавливаем ruff и добавляем базовую конфигурацию
Для начала важно, чтобы конфигурация была минимальной: включаем то, что обычно полезно и не приводит к спорным правкам.
Обычно стартуют с набора “базовая гигиена”, а не с максимально строгих линтеров. Например, вы можете выбрать правила уровня F (часто “ошибки”) и E/W-подобные проверки, а спорные вещи включить позже.
Пример минимального pyproject.toml (настройте под ваш проект):
[tool.ruff]
target-version = "py311"
line-length = 100
src = ["src"]

[tool.ruff.lint]
# Для старта можно включить только часть правил.
# Ruff использует коды правил — это удобно для поэтапного ужесточения.
select = ["E", "F", "W"]
ignore = []

# В первой итерации лучше не устраивать строгий контроль импортов и т.п.,
# если вы не готовы к массовым правкам.
# Позже можно расширить select.
Ключевые моменты:
srcзадаёт корневые каталоги для анализа.select— “что считаем нарушениями”. На старте — относительно небольшой список.target-versionиline-lengthфиксируют ожидания от кода.
Шаг 2. Запускаем ruff локально в “мягком режиме”
Запуск без CI-ограничений важен, чтобы команда увидела масштабы.
Например:
ruff check .
На этом этапе вам не нужно “победить все” — вам нужно получить карту проблем.
Шаг 3. Снимаем шум: исключения и каталогная политика
В проектах обычно есть:
- сгенерированный код;
- миграции БД;
- vendored зависимости;
- папки с прототипами или legacy.
Чтобы не ломать команду, вводим исключения по каталогам и, при необходимости, по файлам.
Пример:
[tool.ruff]
exclude = [
  ".git",
  ".venv",
  "build",
  "dist",
  "migrations",
  "vendor",
  "__pycache__",
]

# Можно исключать конкретные шаблоны файлов через per-file-ignores (ниже).
Если у вас есть каталоги, где линтер должен работать “мягко” (например, миграции или код, генерируемый инструментами), лучше исключать их полностью на первой итерации или применять точечные подавления.
Неделя 1 (продолжение): per-file-ignores как инструмент “границ”
Исключения по каталогам — хорошо, но иногда слишком грубо: например, в папке tests/ нарушения могут быть “допустимыми” только для конкретных правил (например, проверка на “неиспользуемые аргументы” или “пустые тела” — в тестах бывают оправданные).
Для таких случаев используем per-file-ignores.
Например:
[tool.ruff.lint.per-file-ignores]
"tests/*" = ["F811"]  # пример: разные реализации/переопределения
"src/legacy/*" = ["E501"]  # пример: строка длиннее лимита в одном месте
Это позволяет:
- сохранить линтинг в целом;
- при этом не заставить команду переписывать легаси “в моменте”.
Важно: per-file-ignores не должны превращаться в свалку. Их нужно вести как часть плана: “почему игнорируем”, “когда перестанем”, “какие правила будем ужесточать позже”.
Практика: заведите короткую запись в документации проекта (“ruff policy”) или в тикетах/задачах, где перечислены исключения и план их уменьшения.
Неделя 2: контроль качества в PR — делаем линтер частью процесса
На этом этапе цель не в том, чтобы заставить всех “в моменте исправить всё”, а чтобы обеспечить правило:
Любой PR не должен ухудшать состояние относительно текущего baseline.
Есть несколько подходов. Простейший — сделать линтер обязательным для PR с текущими правилами, но это может сломаться, если baseline уже очень плохой.
Поэтому обычно делают так: либо допускают определённое количество нарушений, либо настраивают правило на “только новые” нарушения через политику внедрения (в ruff это лучше делать через точечные ограничения и постепенно расширяющиеся правила).
Шаг 1. Включаем ruff в CI, но на адекватной “жёсткости”
Например, GitHub Actions:
# .github/workflows/lint.yml
name: Lint

on:
  pull_request:
  push:
    branches: [ main ]

jobs:
  ruff:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - name: Install dependencies
        run: |
          python -m pip install --upgrade pip
          pip install ruff
      - name: Ruff check
        run: ruff check .
Если CI начнёт падать массово на существующих файлах — это сигнал, что нужно:
- ужесточить исключения;
- временно ограничить select;
- либо согласовать отдельный baseline-тикет для “первого прохода”.
Шаг 2. Пишем для команды понятную схему “как исправлять”
Чтобы ruff не превратился в “кнопку для наказаний”, полезно заранее определить:
- как запускать линтер локально;
- какие команды автоисправления (если включены) использовать;
- что делать, если правило конфликтует с намерением автора кода.
Ruff поддерживает автоисправления для части нарушений через --fix (но не для всех). Для старта обычно безопасно использовать fix локально.
Пример:
ruff check . --fix
Важно: если включите --fix в CI и он начнёт менять файлы — PR станет неуправляемым. На старте лучше держать CI как “проверка”, а исправления — ручными/локальными.
Шаг 3. Проверяем “качество в PR” с точки зрения команды
На практике качество — это не только отчёт линтера. Важно, чтобы ревьюеры могли быстро оценить PR.
С точки зрения процесса:
- ruff должен быть быстрым;
- результаты должны указывать на файл и строку;
- сообщения должны быть интерпретируемыми;
- количество ошибок должно быть в пределах разумного (иначе ревью превращается в “охоту на всё подряд”).
Если за первый день в PR стали появляться сотни проблем — нужно откатывать расширение правил или усиливать границы через исключения.
Неделя 3: поэтапное ужесточение правил — расширяем select аккуратно
Когда команда “привыкла” и ruff стабильный в PR, можно расширять контроль. Но расширять лучше по блокам, а не “сразу включить всё”.
Подход: включаем новые группы правил только после того, как baseline стабилен
Типовая логика ужесточения:
- ошибки синтаксиса/логики (F, часть E);
- потенциальные проблемы (W и производные);
- “стиль, который не спорит” (часть рекомендаций);
- правила повышенной строгости (когда команда готова).
Например, можно добавить правила про импорт-организацию, упрощения, аннотации и т.п. — но только после того, как это не приводит к массовым конфликтам.
Пример идеи расширения select (в чистом виде — подстройте под ваш проект):
[tool.ruff.lint]
select = ["E", "F", "W", "I", "UP"]
Где:
I— import-related правила (точные коды и наборы зависят от ruff и включённых плагинов/правил);UP— упрощения/обновления, зависящие от версии Python.
Ключевой момент: если вы добавите импортные правила без согласования структуры проекта, вы получите волну форматных правок.
Неделя 3 (продолжение): фиксируем “границы” для легаси
Ужесточение правил часто выявляет реальность: в “старых” папках проблемы намного больше.
Вместо того чтобы заставить команду “переписать всё”, используйте стратегию:
- легаси остаётся с прежней строгостью;
- новые изменения в легаси постепенно приводятся к стандарту;
- новые правила включаются, но с
per-file-ignoresили exclude, где оправдано.
Пример: вы включили ещё один набор правил, но для конкретного каталога временно игнорируете часть.
[tool.ruff.lint.per-file-ignores]
"src/legacy/*" = ["UP", "I"]
Да, это снова исключения. Но это “временная инфраструктура”, а не пожизненная индульгенция — если вы фиксируете, какие правила и когда планируете снять.
Неделя 4: финальная настройка качества и “ритуал” в PR
К этому моменту ruff уже должен:
- стабильно проходить CI на main (с вашим baseline);
- не допускать новых нарушений в типовых PR;
- иметь понятную конфигурацию и исключения.
Шаг 1. Документируем “policy” на уровне репозитория
Короткий файл docs/ruf-policy.md или раздел в README/CONTRIBUTING поможет:
- объяснить, как запускать линтер;
- как запускать автофиксы (если разрешены);
- где описаны исключения;
- как действовать при конфликте стиля и логики.
Это снижает нагрузку на тимлида/ревьюеров, потому что ответы становятся частью документа, а не “устными традициями”.
Шаг 2. Настраиваем режим для PR
Есть практичная политика:
- ruff обязателен для всех PR, но расширение правил делается только по плану;
- исключения пересматриваются периодически (например, раз в спринт).
Если вы заметили, что какие-то правила чаще всего игнорируются “по делу” — это знак, что их стоит либо ослабить, либо исключить на конкретных участках с аргументацией.
Шаг 3. Смотрим на регрессии скорости
ruff обычно быстрый, но в крупных монорепах могут появиться ситуации, когда анализ “всего” стал дорогим.
В таком случае:
- уточняйте
srcиexclude; - избегайте анализа директорий с большим количеством “мёртвого” мусора;
- при необходимости разделяйте проверки: ruff для Python и отдельные проверки для других частей.
Типичные ошибки внедрения ruff (и как их избежать)
Ошибка 1: включить “всё и сразу”
Решение: расширяйте select блоками и фиксируйте baseline.
Ошибка 2: доверить конфиг одному человеку без ревью
Решение: на старте согласуйте исключения и границы: кто определяет “что линтер должен искать”, а что остаётся legacy.
Ошибка 3: игнорировать per-file-ignores без плана снятия
Решение: добавляйте комментарии в документацию или заведите список “временных исключений”.
Ошибка 4: включить автоформаттер/автофикс массово на старте
Решение: сначала внедрите ruff check, затем по желанию добавьте форматирование, когда команда готова к структурным изменениям.
Ошибка 5: не проверить совместимость версий Python и библиотек
Решение: задайте target-version, убедитесь что команда использует сопоставимую версию интерпретатора и зависимостей в CI.
Пример “пакета” конфигурации: базовый вариант + границы
Ниже — пример более целостной конфигурации pyproject.toml для стратегии снизу вверх. Она не претендует на универсальность, но показывает, как структурировать настройки.
[tool.ruff]
target-version = "py311"
line-length = 100

# Анализируем только код в src (или подставьте свои каталоги)
src = ["src"]

# Исключаем инфраструктуру и легаси, где линтер пока не даёт пользы
exclude = [
  ".git",
  ".venv",
  "build",
  "dist",
  "__pycache__",
  "migrations",
  "vendor",
]

[tool.ruff.lint]
# Начинаем с аккуратного набора
select = ["E", "F", "W"]
ignore = []

# Можно задать уровень логики по игнорированию “типичных” вещей
# (например, по месту неиспользуемых импортов — но аккуратно, не скрывайте ошибки)
# per-file-ignores применяем для тестов/легаси
[tool.ruff.lint.per-file-ignores]
"tests/*" = ["F401"]        # пример: тесты часто содержат фикстуры/импорты
"src/legacy/*" = ["E501"]  # пример: временно разрешаем длинные строки

# На следующих итерациях можно расширять select
# select = ["E", "F", "W", "I", "UP"]
План внедрения на 2–4 недели (конкретный таймбокс)
Ниже — практичный план, которым удобно руководствоваться.
Неделя 1
- Установить ruff и добавить минимальную конфигурацию в
pyproject.toml. - Запустить
ruff checkлокально/в CI без массовых правок. - Добавить exclude по “неанализируемым” каталогам.
- Настроить
per-file-ignoresдля проблемных зон (tests/legacy). - Зафиксировать первый baseline: сколько нарушений сейчас, что нужно исключить.
Результат: ruff работает и не требует “переписать всё”.
Неделя 2
- Включить ruff в обязательные проверки PR.
- Определить правила поведения: “как