SQL-диагностика на практике: как понять, почему запрос медленный, по статистике, плану и индексовому покрытию
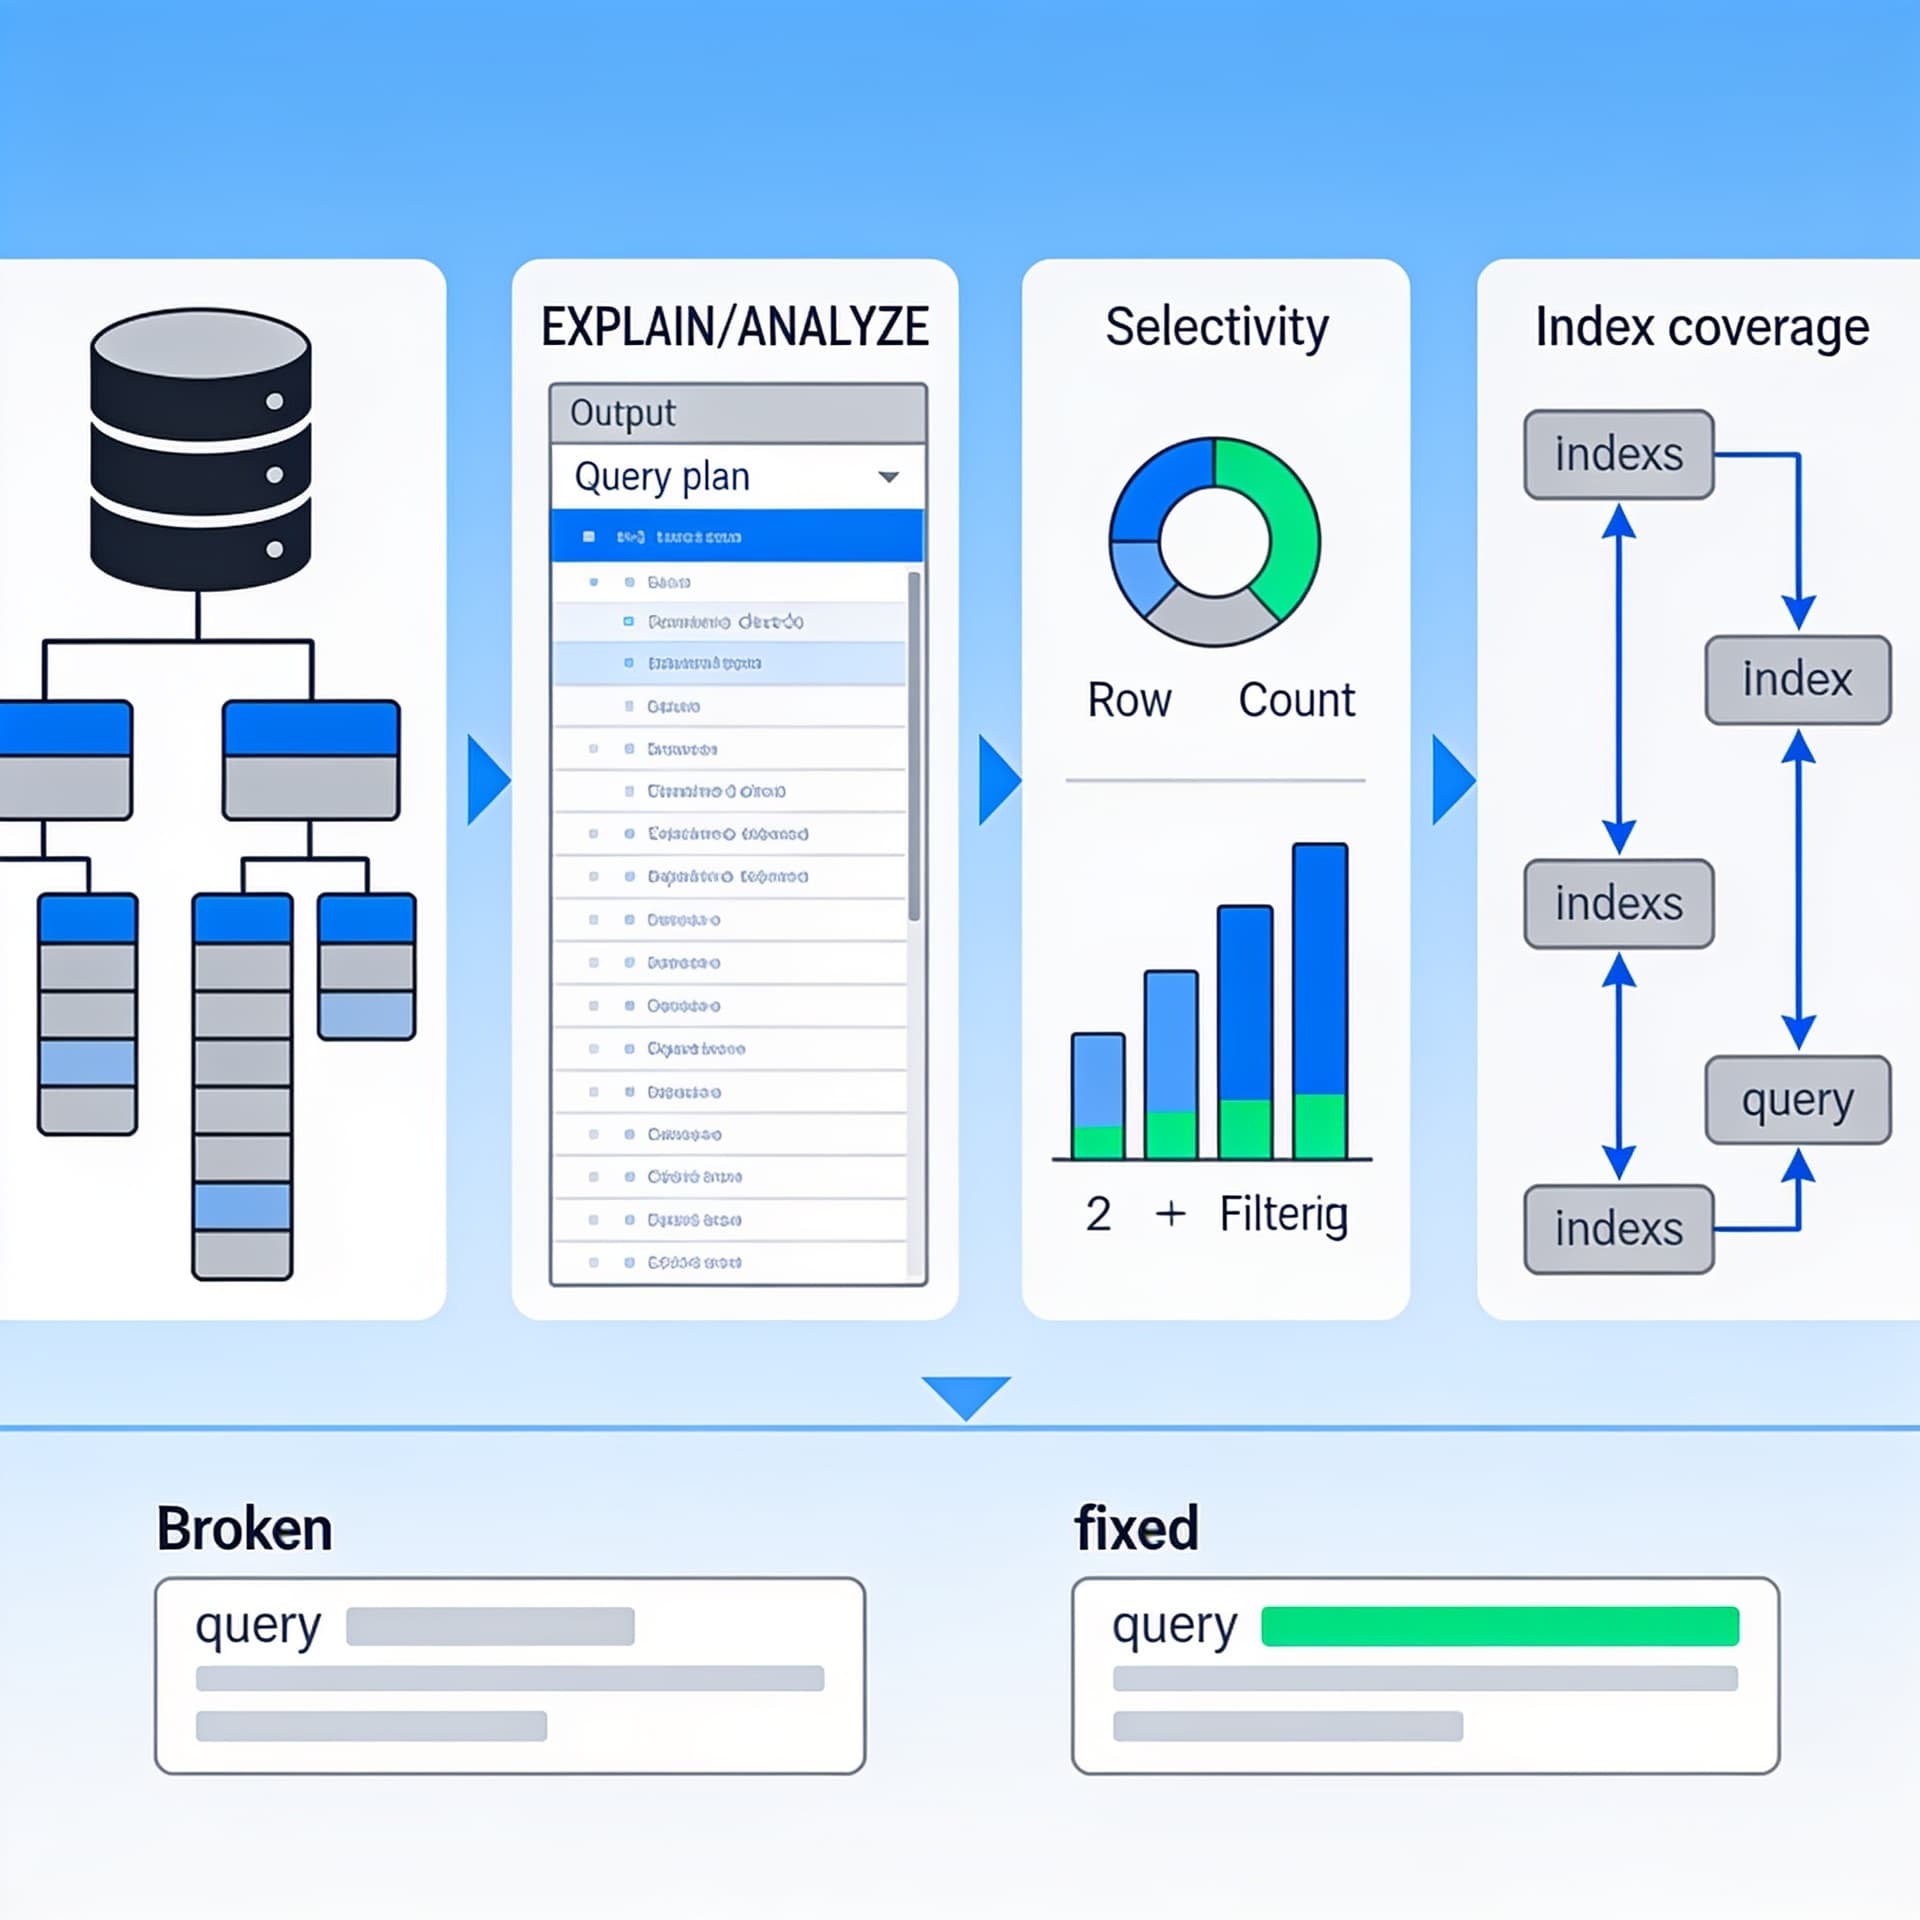
Покажем пошаговый подход: от EXPLAIN/ANALYZE до проверки селективности и покрытия индексами. На реальных типовых ошибках разберём, что менять в запросе и схеме, чтобы ускоряться стабильно.
Содержание
Медленный запрос — почти всегда симптом. Причина может лежать в статистике оптимизатора, в том, как сформулирован SQL, в выборе индексов, в кардинальности (сколько реально строк проходит на каждом шаге) или в «скрытых» факторах вроде типов данных и коллаторации. В этой статье разберём практический и воспроизводимый подход к диагностике: как пройти путь от EXPLAIN/ANALYZE до проверки селективности и индексового покрытия, а затем понять, что именно менять — в запросе или в схеме — чтобы ускоряться стабильно.
Материал ориентирован на типичную линейку реляционных СУБД (PostgreSQL / MySQL / аналоги). Термины и команды могут отличаться деталями, но логика диагностики — одна.
1) Начинаем с правильных артефактов: что и почему измеряем
1.1. Сначала фиксируем контекст
Прежде чем смотреть планы, уточните:
- Какая СУБД и версия (оптимизатор, форматы
EXPLAIN, поддержка покрывающих индексов). - Тип запроса:
SELECT,UPDATE,DELETE,INSERT ... SELECT, агрегаты, оконные функции. - Размер данных: порядок величин таблиц и распределение по фильтрам.
- Частота и окно времени: «медленно иногда» может означать промахи по кэшу, рост статистики, блокировки или план, который устарел.
1.2. Делаем замер не только по времени
Обычно полезны два вида метрик:
- Время выполнения (wall time).
- Сколько строк реально обработал план (по
rows,actual rowsи т. п.).
На практике самая частая ошибка — диагностировать по времени, но игнорировать фактическую кардинальность. Оптимизатор может выбрать «не ту» стратегию не потому, что индекс плохой, а потому что оценки кардинальности у него неверные.
2) EXPLAIN/ANALYZE: как понять, что оптимизатор делает на самом деле
2.1. План без исполнения: что смотреть в EXPLAIN
EXPLAIN (без ANALYZE) покажет предполагаемые оценки:
- Типы шагов:
Index Scan,Seq Scan,Nested Loop,Hash Join,Sort,Aggregate. - Порядок соединений (join order).
- Оценки строк:
rows(например, ожидаемые 1 000 при реальных 10 млн). - Используемые индексы и условия
Filter/Index Cond.
Важное правило: план — это гипотеза оптимизатора. Он может ошибаться, особенно при устаревшей статистике, неравномерном распределении или сложных выражениях.
2.2. План с исполнением: ключ к реальной проблеме
EXPLAIN ANALYZE (или аналог) покажет:
- actual rows — фактическое число строк.
- loops — сколько раз выполнялся шаг.
- время по узлам плана (зависит от СУБД).
И вот тут часто выясняется, что узкое место — не тот шаг, который «кажется логическим». Пример сценария:
- Вы думаете, что тормозит сортировка.
- Но
EXPLAIN ANALYZEпоказывает, что сортировка делается уже по 200 строкам, а проблема — вSeq Scanна 200 млн строк из-за неиспользования индекса.
2.3. Сигналы «план неверен»
На практике красные флаги:
expected rowsсильно отличается отactual rows(на порядки).- В плане есть
Seq Scanпо большим таблицам, хотя очевидные фильтры существуют. - Join выполняется
Nested Loop, но ожидаемо должны быть более «масштабные» стратегии (или наоборот). - Много
Sort/Hashпо промежуточным результатам из-за неправильных индексов или формулировки запроса.
3) Разбор по слоям: запрос → селективность → индексы → покрытие
Дальше удобно мыслить слоями, как инженер, который не «угадывает», а проверяет гипотезы.
3.1. Слой A: селективность фильтров
Селективность — доля строк, которую «оставляют» условия WHERE. Оптимизатор выбирает план, ориентируясь на оценки селективности.
Типичная проблема
Фильтр вида:
WHERE status = 'ACTIVE'
может быть либо суперселективным (1%), либо почти неразборчивым (90%) — зависит от данных.
Если статистика устарела, оптимизатор может думать, что status='ACTIVE' редкое значение, и выбирать индексный план, который превращается в чтение миллионов строк.
Как проверить
- Посмотрите оценки в
EXPLAIN. - Посмотрите реальные пропуски — либо через отдельные
COUNT(*)с теми же условиями (временно), либо через анализ распределения (в зависимости от СУБД).
Пример «приближённой диагностики»:
SELECT
  status,
  COUNT(*) AS cnt
FROM orders
GROUP BY status
ORDER BY cnt DESC;
3.2. Слой B: выражения и типы (почему индекс «не видят»)
Очень частая причина медленности: индекс есть, но не применяется из‑за преобразований выражений.
Например, если столбец created_at типа timestamp, а условие написано так, что приводит к вычислению функции от колонки:
WHERE DATE(created_at) = '2026-08-01'
Оптимизатор часто не сможет использовать обычный btree по created_at, потому что индекс по created_at не соответствует выражению DATE(created_at).
Вместо этого лучше писать:
WHERE created_at >= TIMESTAMP '2026-08-01'
  AND created_at <  TIMESTAMP '2026-08-02'
То же относится к:
- приведениям типов (неявные
CAST); - преобразованиям строк (например,
LOWER(email) = ...); - применениям функций к полям в join/where.
3.3. Слой C: join-условия и порядок
Join может внезапно стать «дорогим», если:
- соединение выполняется по неиндексированному ключу;
- условие join содержит вычисления;
- выбран не тот ключ для соединения;
- кардинальность оценивается неправильно.
Схема мышления:
- Для каждого join посмотрите, какой стороне доступен индекс.
- В плане посмотрите, есть ли
Index Condпо ключу join. - Убедитесь, что соединение не «взорвало» кардинальность из-за неправильной логики (например, join на неуникальные поля без дополнительных условий).
4) Индексы: не просто «есть/нет», а «поддерживают ли нужный доступ»
4.1. Проверяем, какой тип индекса действительно подходит
Для btree полезны:
- равенства (
=,IN); - диапазоны (
>=,<,BETWEEN); - сортировка и группировка по левому префиксу составного индекса.
Для полнотекстового поиска нужны специализированные индексы (GIN/GiST, FULLTEXT и т. п.).
Для LIKE с префиксом LIKE 'abc%' обычно подходит btree (в зависимости от колляции/настроек). Но LIKE '%abc%' обычно требует другие подходы.
4.2. Покрытие индексом (index coverage): ускорение без доступа к таблице
Покрытие — это когда СУБД может получить нужные колонки только из индекса, без обращения к heap/кластеру таблицы.
Результат: меньше I/O и ускорение, особенно на больших таблицах.
Простой пример:
- есть индекс
(user_id, created_at) - запрос делает выборку только
user_idиcreated_at(и фильтрует поuser_id) - оптимизатор может сделать
Index Only Scan(в PostgreSQL) или аналогичный сценарий.
В терминах диагностики:
- в плане ищите узлы типа
Index Only Scan(PostgreSQL) или признаки «покрытия». - смотрите, есть ли
Heap Fetches(для PostgreSQL), которые означают обращения к таблице даже при наличии покрытия.
5) Практический сценарий: методика «от плана к исправлениям»
Ниже — шаблонный процесс, который удобно применять к вашему запросу.
5.1. Шаг 1: воспроизвести EXPLAIN ANALYZE и понять главную цену
Допустим, запрос:
SELECT
  o.id,
  o.user_id,
  o.total_amount
FROM orders o
WHERE o.status = 'ACTIVE'
  AND o.created_at >= '2026-08-01'
ORDER BY o.created_at DESC
LIMIT 50;
План без ANALYZE может быть оптимистичным. Нас интересуют узлы:
- где самый большой вклад во время;
- сколько фактически строк отфильтровано.
Если видим Seq Scan по orders, либо индекс не используется для status/created_at, то идём дальше.
5.2. Шаг 2: проверить, почему индекс не выбран
Типовые причины:
- Фильтр не соответствует индексу (функция от колонки, неправильные типы).
- Низкая селективность (оптимизатор считает, что индекс не выгоден).
- Устаревшая статистика.
- Слишком много сортировки/скачков из-за порядка
ORDER BY.
В нашем запросе важны два аспекта:
- фильтрация по
statusи диапазону поcreated_at; - сортировка по
created_at DESC+LIMIT.
Если подходящий составной индекс существует не в том порядке, вы можете получить дорогую сортировку.
5.3. Шаг 3: предложить индексы под запрос, а не «в общем»
Для btree классическая стратегия — составной индекс, который поддерживает и фильтр, и порядок сортировки.
Если часто делаете status = ... и ORDER BY created_at DESC LIMIT ..., то кандидат:
(status, created_at DESC).
Например:
CREATE INDEX idx_orders_status_created_at
ON orders (status, created_at DESC);
Что это даст:
- поиск по
status; - затем уже отсортированный доступ по
created_atбез отдельногоSort.
5.4. Шаг 4: оценить покрытие
Если запрос ещё выбирает id и total_amount, а таблица не кластеризована под индекс, может остаться обращение к строкам таблицы.
В PostgreSQL вы увидите Heap Fetches. Если их много — покрытие неполное.
Варианты:
- добавить остальные колонки в индекс (создать «covering index» ценой увеличения размера индекса);
- или переписать запрос так, чтобы получать минимум колонок до следующей операции;
- иногда выгодно хранить производные/ключевые колонки в отдельной таблице, чтобы уменьшить ширину.
Пример «приближения к покрытию» (идея, а не универсальный рецепт):
CREATE INDEX idx_orders_cover
ON orders (status, created_at DESC)
INCLUDE (id, total_amount);
Если СУБД не поддерживает INCLUDE, придётся либо:
- добавить колонки в ключ индекса (но это может ухудшить использование из-за изменения структуры),
- либо оставить как есть и принять heap fetch как неизбежность.
6) Статистика: когда всё вроде правильно, но план всё равно плохой
6.1. Что значит «неверная статистика» в терминах оптимизатора
Оптимизатор оценивает:
- число строк после фильтров (
WHERE); - число строк после join;
- распределение значений (histogram, MCV — most common values);
- селективность диапазонов.
Если данные сильно меняются (например, статусы часто переключаются), но статистика не обновляется, оценки начинают «врать».
6.2. Когда обновлять статистику и как понимать эффект
В PostgreSQL есть ANALYZE, в MySQL — ANALYZE TABLE, в других — аналогичные команды.
Практический подход:
- Выполнить
EXPLAIN ANALYZEдо обновления статистики. - Обновить статистику для таблиц, участвующих в запросе.
- Повторить
EXPLAIN ANALYZEи сравнить:- изменились ли оценки
rows; - поменялся ли тип скана/джойна;
- сократилось ли число обработанных строк.
- изменились ли оценки
Типичный «симптом» устаревшей статистики:
- план выглядит логично, но фактические строки отличаются на порядки;
- оптимизатор выбирает индексный план, который на практике делает почти то же самое, что
Seq Scan.
6.3. Подводные камни статистики
- Композиции условий: отдельные столбцы статистики могут быть корректными, но их совместное распределение — нет. Например,
status='ACTIVE'встречается часто, но сочетаниеstatus='ACTIVE' AND region='EU'— редкое. Если оптимизатор не умеет достаточно точно оценивать корреляции, план может быть неверным. - Сложные выражения: если фильтр вычисляется функциями, статистика может не применяться напрямую.
- Низкая частота некоторых значений: редкие значения трудно оценивать точно.
Иногда решение не в «обнови статистику», а в переписывании условия так, чтобы оно выглядело «индексируемо».
7) Типовые ошибки, которые ломают производительность (и что менять)
7.1. Ошибка: условие в WHERE построено так, что ломает sargability
Классический пример:
WHERE DATE(created_at) = '2026-08-01'
Исправление:
WHERE created_at >= TIMESTAMP '2026-08-01'
  AND created_at <  TIMESTAMP '2026-08-02'
7.2. Ошибка: join по типам с приведением
Если один ключ user_id — INT, а другой — VARCHAR, то сравнение может вызвать преобразования. В плане вы можете увидеть, что индекс не применяется.
Исправление:
- привести типы на уровне схемы;
- или привести в запросе так, чтобы преобразование делалось на «константу», а не на колонку.
Правило: если приходится CAST(column AS ...), это часто красный флаг.
7.3. Ошибка: порядок колонок в составном индексе не соответствует условиям
Составной btree использует левый префикс. Индекс (created_at, status) не поможет так же хорошо, как (status, created_at), если фильтр по status равенство, а потом диапазон по created_at.
Исправление:
- пересобрать индекс под наиболее частый паттерн фильтрации и сортировки;
- подтвердить
EXPLAIN ANALYZE.
7.4. Ошибка: сортировка перед LIMIT
Если запрос требует ORDER BY и LIMIT, но индекс не поддерживает нужный порядок, СУБД может отсортировать огромный набор.
Исправление:
- обеспечить индекс, который покрывает и фильтры, и порядок
ORDER BY; - минимизировать ширину выбираемых колонок до момента, где это критично.
7.5. Ошибка: «погоня за одним индексом» вместо понимания плана
Иногда создают индекс, но всё равно не ускоряется: причина в другой части плана — например, в дорогом join или в aggregate.
Метод:
- по
EXPLAIN ANALYZEопределить самый дорогой узел; - индексировать и переписывать именно его входные данные.
8) Как оценить индексовое покрытие и понять, стоит ли делать INCLUDE
8.1. Что именно считать «покрытием»
Покрытие — это не только «есть нужный индекс». Это:
- нужные колонки для
SELECT; - плюс условия фильтра и сортировка/группировка (в идеале);
- плюс минимизация «обращений к таблице».
Проверка (на примере PostgreSQL):
- узел
Index Only Scanозначает потенциальное покрытие; Heap Fetchesпоказывает, что покрытие неполное (например, из-за видимости/хранения MVCC).
8.2. Стоимость индексов: не делайте «сверхширокие» без измерения
Индексы ускоряют чтение, но:
- увеличивают время вставок/обновлений;
- увеличивают размер базы;
- могут ухудшить работу кэшей.
Подход:
- создайте один разумный индекс под критичный запрос;
- проверьте
EXPLAIN ANALYZE; - если проблема в heap fetch — добавляйте покрытие точечно.
9) Репродуцируемый чеклист: что делать при следующем медленном запросе
- Снимаем
EXPLAIN ANALYZEи находим узел с максимальным вкладом во время. - Сравниваем expected vs actual rows на ключевых узлах. Если разница огромная — думайте о статистике или непредвиденной селективности.
- Проверяем, применяется ли индекс:
- есть ли
Index Condпо ключевым условиям; - не ломает ли sargability функции/CAST;
- не конфликтует ли тип данных.
- есть ли
- Проверяем порядок индекса и
ORDER BY/GROUP BY:- поддерживает ли индекс нужный порядок?
- не превращается ли
ORDER BYв дорогуюSort?
- Если
LIMIT, убеждаемся, что СУБД не сортирует миллионы строк. - Оцениваем индексовое покрытие:
- есть ли
Index Only Scan; - есть ли дорогие heap fetch.
- есть ли
- Обновляем статистику и смотрим, меняется ли план/оценки.
- Только после этого фиксируем «узкое место»:
- переписываем запрос (sargability, join condition);
- или меняем схему (составные индексы, INCLUDE/cоверы, возможно — перепланировка хранения).
10) Как углубиться: когда нужна системная практика
Этот подход хорошо работает как «операционная инструкция», но практика диагностирования быстро приводит к более глубоким темам: как оптимизатор оценивает кардинальность, как читаются планы в конкретной СУБД, как корректно моделировать индексы под реальные паттерны запросов и как избежать ложных оптимизаций, которые ломают другие сценарии. Если хотите углубиться именно в систематизацию навыков (а не только в разовые советы), можно посмотреть раздел «Производительность и надёжность» в курсе «Продвинутый SQL».
Вывод
SQL-диагностика — это не гадание по «похоже, тут индекс нужен». Это инженерная процедура: фиксируем факты (EXPLAIN/ANALYZE), ищем расхождения между оценками и реальностью, проверяем селективность, убеждаемся, что условия индексируемы (sargability), затем проверяем индексовое покрытие и соответствие индекса WHERE/ORDER BY/LIMIT. Большинство ускорений получается не от «добавить любой индекс», а от точечного изменения того, что мешает оптимизатору (устаревшая статистика, неверные выражения, несоответствие порядка составного индекса) и того, что заставляет СУБД делать лишнюю работу (сортировки, heap fetch, дорогие join-стратегии).
Если выстроить эту диагностику как чеклист и регулярно сравнивать план до/после, скорость вы начнете повышать предсказуемо — без магии и без риска случайно ухудшить другие запросы.