Как отлаживать проблемы с производительностью FastAPI: профилирование, трассы и поиск медленных мест по слоям
Покажем подход «сверху вниз»: где смотреть (CPU/IO/БД/серилизация), как использовать трассировки и профили, как отличить медленную функцию от медленного ожидания. В конце — чек-лист диагностики на боевых метриках.
Содержание
Проблемы производительности в FastAPI редко бывают «одной ошибкой». Чаще это сочетание факторов: CPU у сервера перегревается сериализацией, I/O ждёт внешние сервисы, база «держит» транзакции, а в коде между ними лежат участки, которые медленно растут со временем (кеши без ограничений, N+1-запросы, лишние конверсии данных, неаккуратные зависимости FastAPI).
В этой статье — подход «сверху вниз»: от системных признаков (CPU/IO/БД/серилизация) к точным виновникам с помощью профилирования и трассировок. Главная цель — научиться отличать медленную функцию от медленного ожидания и собрать чек-лист диагностики на боевых метриках, который реально помогает на проде, а не только в локальной среде.
1) С чего начать: определить тип проблемы (CPU vs ожидание)
Прежде чем включать профилировщики, важно понять, что именно «болит». FastAPI запускается как ASGI-приложение, и тайминг запроса складывается из нескольких частей:
- CPU-работа внутри процесса: обработка логики, валидация Pydantic, формирование ответа, сериализация JSON, маппинги, генерация файлов и т.п.
- I/O-ожидание: сеть до внешних сервисов, чтение/запись в БД, ожидание очередей, задержки в DNS/TLS.
- Очереди и backpressure: рост времени ожидания в event loop, переполнения, долгие запросы, которые держат ресурсы.
1.1. Быстрый диагностический разрез по метрикам
Если у вас есть привычные метрики (Prometheus/Grafana, APM), полезно смотреть хотя бы:
- event loop latency (если есть) или косвенно: рост времени ответа при стабильном CPU.
- CPU usage процесса/воркера:
- высокое CPU при растущих p95/p99 — подозрение на сериализацию/валидацию/бизнес-логику;
- низкое/умеренное CPU при высоких p95/p99 — чаще ожидание I/O (БД/внешние сервисы).
- количество активных запросов (in-flight) и очередь в воркерах (если используете gunicorn/uvicorn с несколькими воркерами).
- время запросов на уровне маршрутов (middleware/endpoint metrics).
- свои метрики по БД: время запроса, число запросов, ошибки/таймауты.
- ошибки таймаутов и ретраи (внешние сервисы).
Профессиональная привычка: сначала разделить проблему на «CPU-bound» и «I/O-bound». Это резко сокращает пространство поиска.
2) «Сверху вниз»: карта слоёв времени запроса в FastAPI
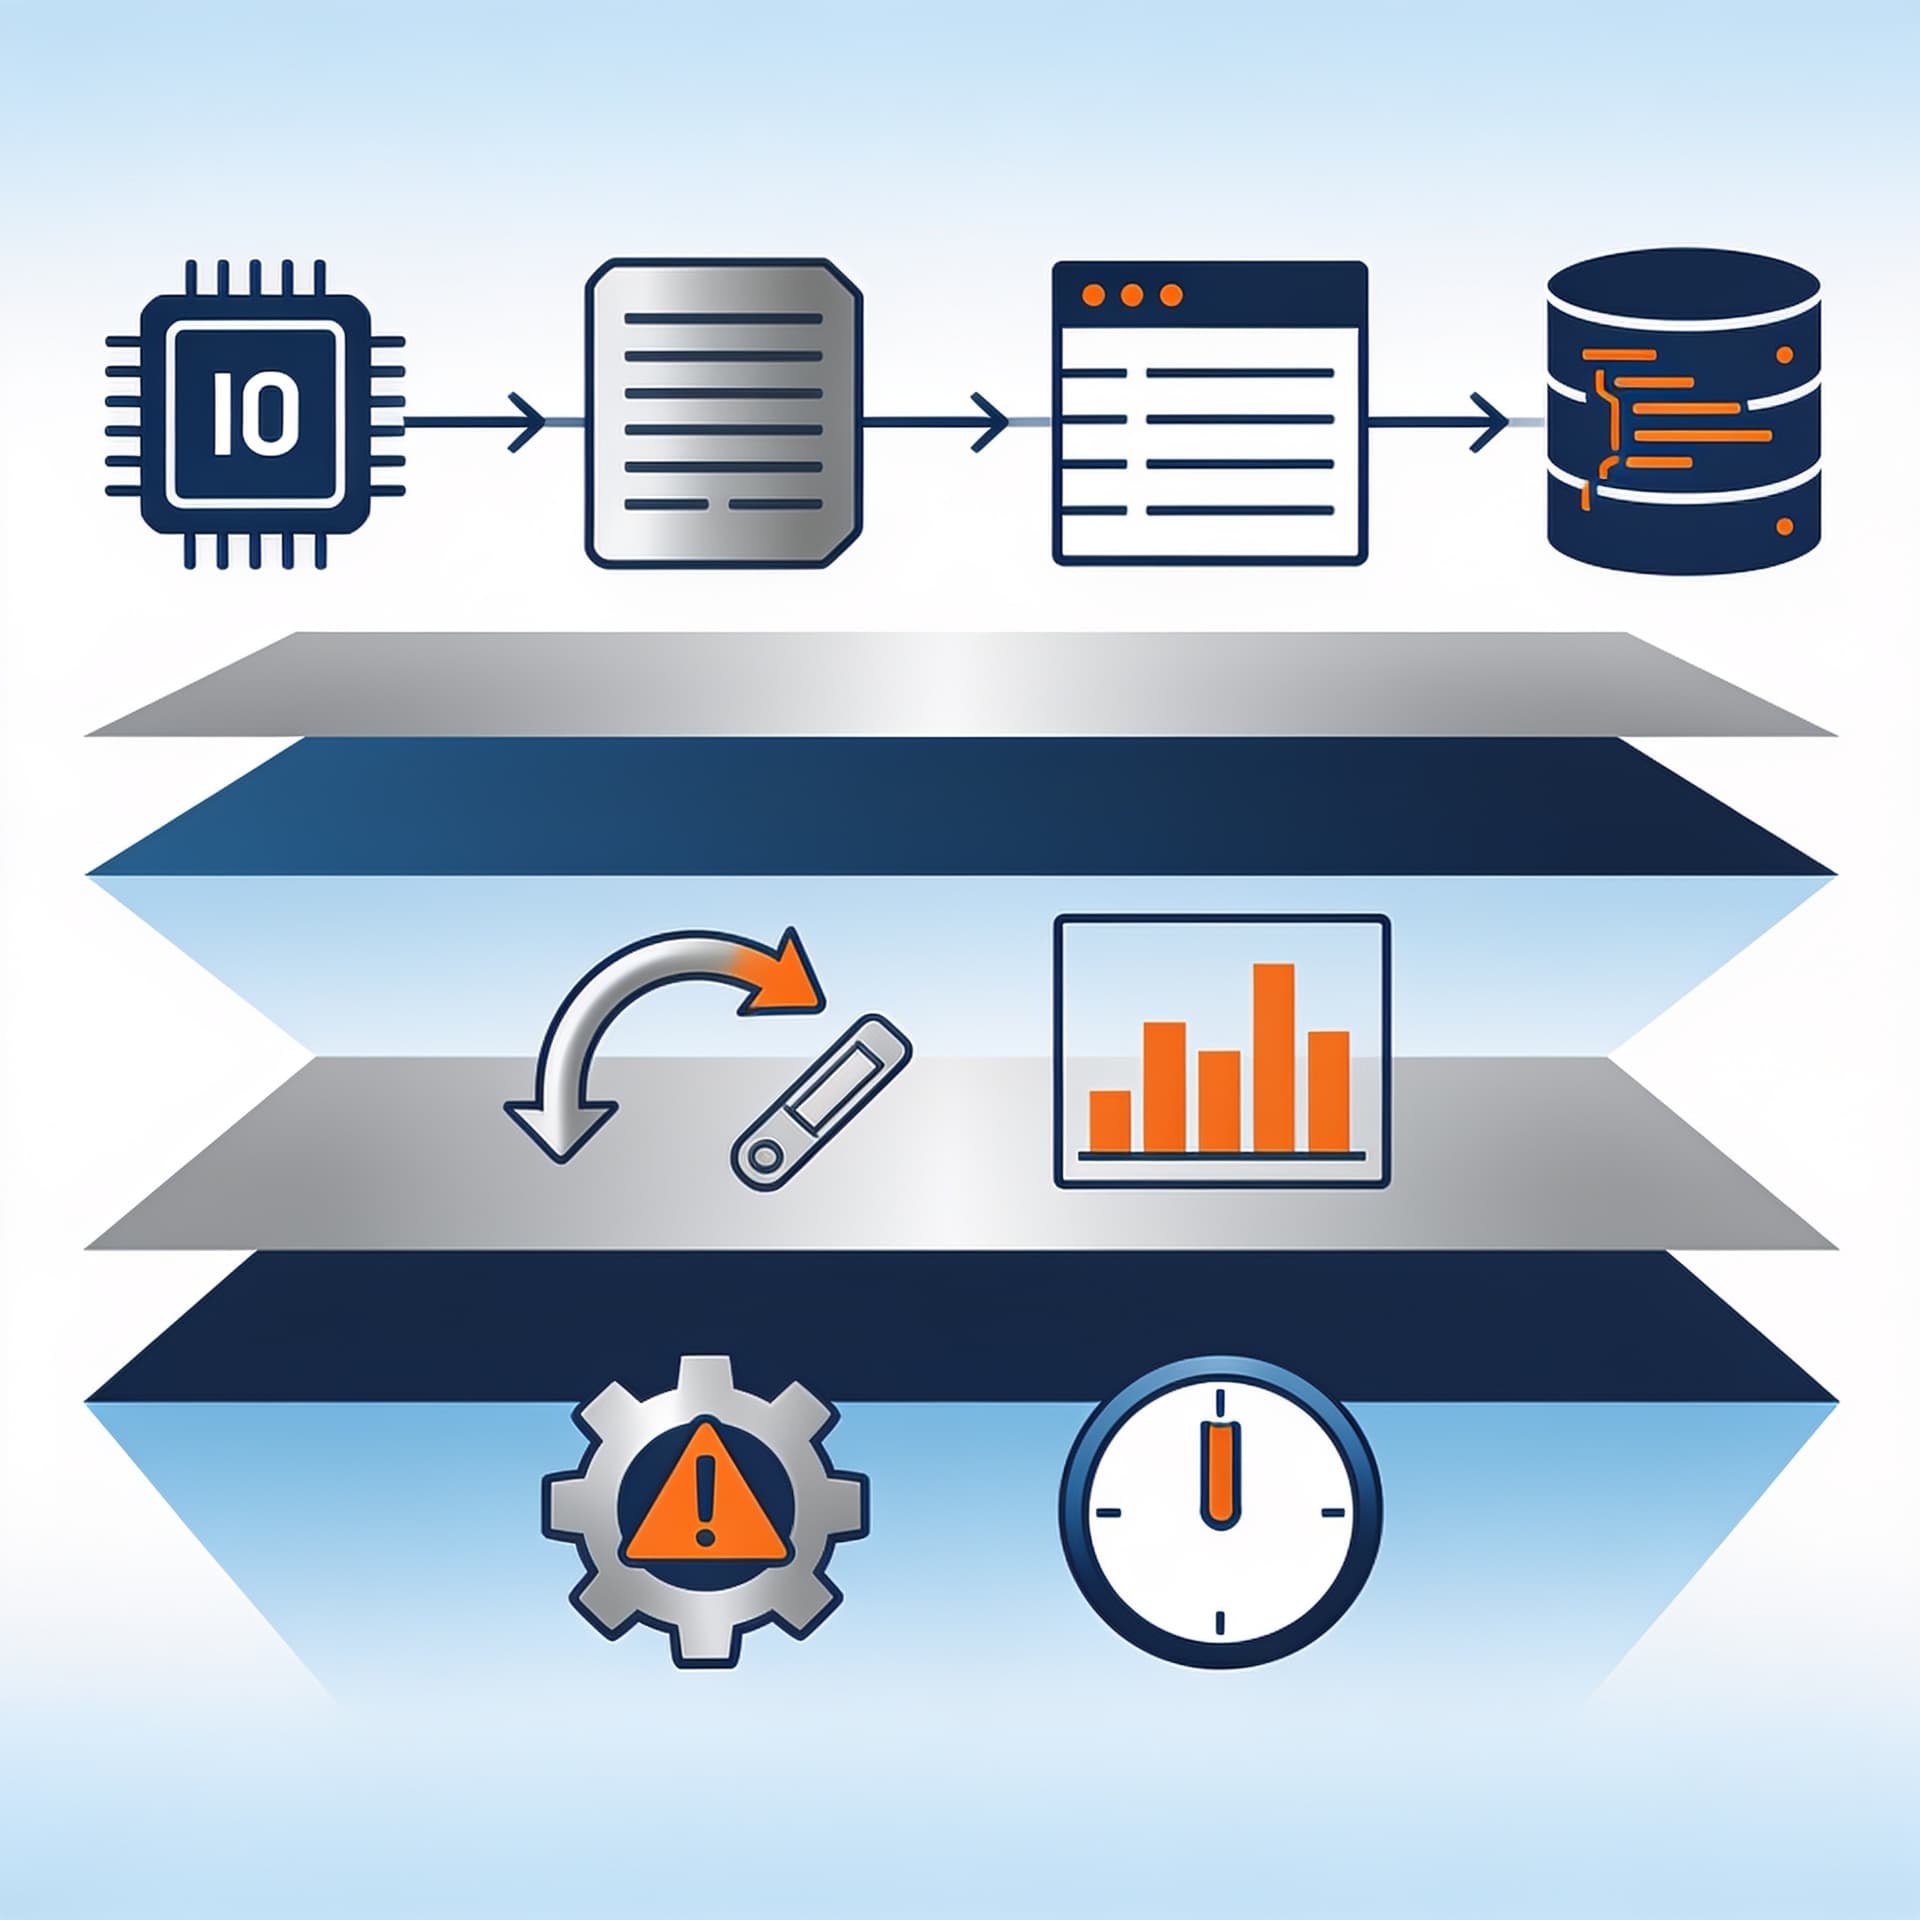
При отладке производительности удобно мысленно разделять запрос на слои. Для FastAPI условная диаграмма такая:
2.1. HTTP/ASGI слой и обработка запроса
- Принятие запроса, parsing заголовков.
- Вызовы middleware (включая CORS, auth, логирование, rate limit).
- Валидация входных данных:
request body -> Pydantic модели.
2.2. Бизнес-слой (CPU или логика)
- Основные вычисления.
- Построение структур ответа.
- Вызовы сервисов (снаружи — обычно I/O, внутри — CPU).
2.3. Слой I/O: БД и внешние сервисы
- Асинхронные запросы к БД (например, SQLAlchemy Async / asyncpg).
- HTTP-вызовы к другим API (например, aiohttp/httpx).
- Файловые операции, кеши (Redis).
2.4. Сериализация и формирование ответа
response_modelи Pydantic сериализация.- JSON генерация.
- Превращение datetime/decimal в строки/числа.
- Потенциально — сжатие (gzip/br) на уровне middleware или reverse proxy.
2.5. Где обычно прячется «медленное»
Частые причины по слоям:
- Валидация/серилизация: большие схемы Pydantic, вложенные модели, много полей, сложные валидаторы,
json_encoders,@root_validator. - БД: N+1 запросы, отсутствие индексов, лишние сортировки, долгие транзакции, несоответствие типов в WHERE, неверные join-и.
- Внешние сервисы: таймауты, медленные ретраи, отсутствие дедлайнов, большие payload, отсутствие HTTP keep-alive.
- Код в event loop: синхронные блокировки (использование
requests/файловых чтений без executor), тяжёлые вычисления в async-хендлере. - Механика FastAPI/Starlette: лишние middleware, слишком частое логирование с форматированием “на горячую” (особенно синхронные хуки), сериализация огромных ответов.
3) Профилирование: что делать, когда неясно, где тормозит
Профилирование в Python обычно делят на:
- статистическое CPU-профилирование (sample-based);
- трассировки по времени (tracing/spans);
- инструментирование по участкам (manual timers, contextvars, metrics).
Для FastAPI важно: CPU профилируют во времени исполнения в процессе, а трассы — чтобы связать запрос с БД/внешними сервисами и увидеть “ожидание”.
3.1. CPU-профиль в async-сервисе: осторожно
Классический инструмент — py-spy (часто удобнее, чем “встраиваемое” профилирование, и меньше ломает event loop):
Пример (в реальном проде обычно запускают отдельно, через sidecar/агент):
py-spy top --pid <PID> --rate 100
py-spy record -o report.svg --pid <PID> --duration 30
Что это даёт:
- hotspots по CPU: функции, на которых тратится вычислительное время;
- косвенно — подтверждает, что проблема не только “ожидание”.
Если CPU низкий, а p99 высокий, CPU-профиль может показать мало интересного — тогда ставка на трассы и “ожидания”.
3.2. Явные таймеры по шагам (low friction, но очень полезно)
Добавьте ручные измерения для ключевых участков. Например, измерьте отдельно:
- время валидации тела (можно частично через middleware),
- время выполнения бизнес-логики,
- время вызова БД,
- время сериализации.
Пример с middleware (идея, адаптируйте под ваш стек логирования):
import time
from fastapi import Request, Response
from starlette.middleware.base import BaseHTTPMiddleware

class TimingMiddleware(BaseHTTPMiddleware):
    async def dispatch(self, request: Request, call_next):
        t0 = time.perf_counter()
        response: Response = await call_next(request)
        t1 = time.perf_counter()
        # Здесь чаще фиксируют total latency; детальный разбор — ниже через трассы/метрики
        request_id = request.headers.get("x-request-id", "-")
        print(f"[{request_id}] {request.method} {request.url.path} total_ms={(t1-t0)*1000:.2f}")
        return response
Это не заменяет tracing, но помогает быстро увидеть, что «всё время ушло в total» и на каких маршрутах.
3.3. Инструментирование ожиданий: важный трюк
Для async-сервиса полезно разделять:
- время активной обработки (CPU work);
- время ожидания I/O.
В трассах это обычно видно как время span. Но если у вас tracing частично, можно делать измерение вокруг await:
import time
from contextlib import contextmanager

@contextmanager
def timer():
    start = time.perf_counter()
    yield lambda: (time.perf_counter() - start)

# Пример вокруг DB вызова
async def fetch_user(session, user_id: str):
    with timer() as end_timer:
        result = await session.execute(
            # ...
        )
        rows = result.fetchall()
    waited_s = end_timer()
    print(f"DB span ms={waited_s*1000:.2f}")
    return rows
Если такие “await-heavy” блоки соответствуют p99 — вы нашли ожидание, а не CPU.
4) Трассировки (tracing): как увидеть “где именно” теряется время
Профилирование отвечает на вопрос «где CPU». Tracing отвечает на вопрос «где запрос проводит время» — включая БД и внешние сервисы, если вы настроили инструментацию.
4.1. Почему tracing критичен именно для FastAPI
В одном запросе у вас может быть:
- несколько обращений к БД,
- несколько HTTP вызовов,
- долгий сериализационный этап.
Профилировщик CPU может показать пустоту, потому что процесс “ждёт”, а tracing покажет, что ожидание именно в SELECT или в вызове внешнего API.
4.2. Базовая схема: spans и кореляция
Правильная трассировка обычно работает так:
- Входящий запрос в FastAPI создаёт root span.
- Каждый вызов внешних компонентов (БД, HTTP-клиент, кеш) создаёт child spans.
- Корреляция идёт через
trace_idиspan_id.
Если у вас OpenTelemetry (OTel) — чаще всего берут готовые инструменты:
- instrumentation для FastAPI/Starlette,
- SQLAlchemy/asyncpg/DB driver,
- httpx/aiohttp.
4.3. Как выглядит расследование по трассам
Типичный сценарий:
- Откройте trace для p99 запроса.
- Посмотрите дерево spans:
- root span: общий latency.
- child span “validate request” (иногда отдельный).
- child “db.query user” и его длительность.
- child “http call X”.
- child “serialize response”.
Если вы видите:
- root span 1500ms,
- db span 1200ms,
- остальное по 50ms, — значит, проблема в БД/транзакциях/индексах, а не в Pydantic.
Если наоборот:
- db spans по 5–20ms,
- но serialize span — 900ms, — виновата сериализация/валидация или объём ответа.
4.4. Неочевидные ловушки трассировок
- Неполная инструментировка: вы видите only HTTP spans, а внутренний async SQL — без spans. Тогда вы ошибочно считаете, что “всё быстро”, когда на самом деле ждёте неинструментированные участки.
- Смешивание воркеров и trace context: если у вас нестандартная схема отправки задач, trace context может потеряться.
- Слишком мелкая детализация: огромное число spans делает трассы дорогими, а расследование — медленным.
Практика: определите 10–20 критичных точек (маршруты, операции БД, внешние сервисы) и инструментируйте их. Остальное — по необходимости.
5) Отличить медленную функцию от медленного ожидания: практические правила
Одна из самых частых ошибок при анализе — смотреть только “самые большие значения” без интерпретации.
5.1. Правило №1: медленное ожидание почти всегда “await внутри трассы”
Если трасса показывает span “db.query” или “http call” на сотни миллисекунд/секунды — это почти наверняка ожидание I/O. Даже если рядом есть “функция обработчика”, она не обязательно делает CPU.
5.2. Правило №2: медленная функция тянет CPU и обычно видна в CPU profile
Когда часть времени тратится на:
- сериализацию больших моделей,
- сложные валидаторы,
- преобразования данных, вы увидите:
- рост CPU,
- и в CPU профиле соответствующие места.
5.3. Правило №3: если async блокируется синхронным кодом, это выглядит как “ожидание”, но является CPU-bound
Например, внутри async endpoint вы сделали:
- синхронный запрос
requests.get(...), - тяжёлое вычисление без
await, - файловые операции в основном event loop, и event loop начинает “подвисать”.
На трассах это часто проявляется как длинный gap без I/O spans, а на профиле — как CPU внутри конкретной функции или системные вызовы.
Пример анти-паттерна:
from fastapi import FastAPI
import requests

app = FastAPI()

@app.get("/bad")
async def bad():
    # request blocking: остановит event loop до завершения
    r = requests.get("https://example.com")
    return {"len": len(r.text)}
Правильнее:
- либо async HTTP-клиент,
- либо вынести в threadpool:
import asyncio
import requests
from fastapi import FastAPI

app = FastAPI()

@app.get("/good")
async def good():
    def blocking():
        return requests.get("https://example.com").text
    text = await asyncio.to_thread(blocking)
    return {"len": len(text)}
6) Поиск медленных мест по слоям: методика расследования
Разберём “сквозной” процесс. Представьте, что на проде p95 на /orders/{id} вырос с 200ms до 1200ms.
6.1. Шаг 1: определите, какие запросы деградируют и есть ли корреляции
- Смотрите разрез по маршрутам: только один endpoint или весь сервис?
- Смотрите по внешним факторам: всплеск нагрузки, изменения конфигураций, релизы, сетевые инциденты.
- Корреляция с БД: рост latency БД, рост lock waits, увеличение времени отдельных запросов.
6.2. Шаг 2: сравните CPU и I/O
- CPU растёт? Тогда сериализация/валидация/логика.
- CPU стабильный, а latency растёт — ждём I/O: БД/HTTP/кеш.
6.3. Шаг 3: откройте трассу “типичного” p95 и “самого плохого” p99
Сравните две трассы:
- количество db calls (сильно ли изменилось?),
- какие конкретно запросы стали медленнее (индексы? объём?),
- появился ли новый внешний вызов или изменился размер ответа.
6.4. Шаг 4: на уровне БД — что искать
На стороне SQL обычно есть три крупных виновника:
- Отсутствие индексов по условиям фильтрации/джойнов.
- Непредсказуемые планы: функции в WHERE, casting типов, строковые преобразования.
- N+1: циклы с отдельными запросами на каждую сущность.
Если используете ORM, N+1 может быть “незаметным” до тех пор, пока объём данных не вырастет.
Пример N+1 (типичный):
# Псевдо-код: сначала получаем список пользователей,
# потом в цикле получаем их заказы отдельными запросами
users = await session.execute(select(User).limit(100))
for user in users.scalars():
    orders = await session.execute(select(Order).where(Order.user_id == user.id))
Как чинят:
- объединяют запросы (join),
- используют eager loading (selectinload/joinedload),
- батчат операции.
6.5. Шаг 5: на уровне сериализации/валидации — что искать
Проблемы сериализации часто всплывают так:
- в p99 много “CPU внутри endpoint”;
- tracing может показывать “serialize response” как крупный span (если инструментирован).
Типовые причины:
- огромные
response_modelс вложенными моделями; - лишние поля/DTO, которые не нужны клиенту;
- использование валидаторов, которые выполняют дорогие операции на каждом запросе;
- преобразования дат/decimal без необходимости;
- отправка больших списков без пагинации.
Практический подход:
- Сравните размер ответа (количество объектов/полей).
- Отключите временно
response_modelили уменьшите поля (в тестовой ветке) — чтобы проверить гипотезу. - В CPU profile посмотрите, “что” занимает место: Pydantic internals, ваши преобразования, JSON кодер.
7) Метрики и дизайн эксперимента: чтобы не лечить симптом
Производительность — область, где легко “улучшить не то”. Поэтому важно соблюдать дисциплину эксперимента:
- Меняйте одну переменную: например, только индексы или только пагинацию.
- Делайте A/B или канареечные релизы, если это возможно.
- Сравнивайте не средние значения, а percentiles: p95/p99 важнее.
Особенно осторожно с:
- увеличением пула соединений к БД без проверки (может увеличить нагрузку и ухудшить lock contention),
- уменьшением таймаутов (может “спасти” p99, но повысит ошибки и ретраи),
- кешированием без лимитов (может улучшить латентность, но привести к утечкам памяти).
8) Чек-лист диагностики на боевых метриках
Ниже — практический чек-лист, который удобно применять, когда прод “проседает”. Он рассчитан на ситуацию, когда tracing и профилирование доступны, но решение всё равно нужно принимать быстро.
8.1. Сбор фактов
- Как изменились p95/p99 по конкретным маршрутам?
- Есть ли корреляция с релизами/конфигами?
- Растёт ли CPU процесса/воркеров?
- Растёт ли время I/O (БД/HTTP-клиенты)?
- Растёт ли число in-flight запросов или очереди?
8.2. Разделение “CPU-bound vs I/O-bound”
- Если CPU высокое: открывайте CPU profile, ищите сериализацию/валидацию/вычисления.
- Если CPU низкое: открывайте трассы и смотрите самые длинные spans (обычно db или external http).
8.3. Трассы: поиск “длинной ветки”
- В p99 trace найдите span, который даёт основной вклад.
- Сравните p95 vs p99: поменялось ли количество вызовов (db calls count), поменялась ли длительность конкретного вызова.
- Проверьте, не потерялась ли контекстность (trace_id отсутствует в child spans).
- Убедитесь, что сериализация/response model инструментированы (если нет — добавьте временно метки).
8.4. БД
- Есть ли признаки N+1 (много одинаковых запросов на один endpoint)?
- Смотрится ли план запроса: используются ли индексы?
- Вырос ли размер выборки/джойнов?
- Нет ли lock waits / рост транзакционного времени?
- Правильные ли типы в фильтрах (cast в WHERE может ломать индексы)?
8.5. Серилизация и Pydantic
- Увеличился ли размер ответа (кол-во объектов/полей)?
- Есть ли дорогие валидаторы / root validators?
- Не отправляете ли больше данных, чем нужно (уменьшение response_model на тесте — быстрый тест-гипотеза)?
- Нет ли повторной сериализации (например, формирование dict -> JSON руками -> снова в response)?
8.6. Асинхронная корректность
- Проверить, нет ли синхронного I/O в async пути (requests, время на файловые операции, heavy CPU).
- Если есть heavy CPU — выделить в executor/процесс либо оптимизировать алгоритм.
- Проверить, есть ли таймауты и дедлайны на внешних запросах.
8.7. Итог: план устранения и верификация
- Сформулировать гипотезу “источник” (CPU сериализация / конкретный SELECT / конкретный внешний API).
- Провести точечное исправление (индекс, eager loading, уменьшение schema, замена синхронного вызова).
- Проверить эффект на p95/p99 и на ошибках (timeouts, 5xx), а не только на среднем.
Вывод
Отладка производительности FastAPI — это не “пощёлкать профайлером и посмотреть верхние функции”. Это системный процесс, в котором вы сначала классифицируете задержку (CPU-bound или I/O-bound), затем по трассам находите “самую длинную ветку”, и уже там делаете точечный разбор: БД (индексы/N+1/планы), сериализация и Pydantic (объём ответа/валидаторы/response_model), корректность async (исключить блокировки event loop).
Если хотите закрепить практику на примерах и выстроить устойчивый workflow от метрик к трассам и обратно, полезно дополнительно пройти структурированную программу по теме наблюдаемости и диагностики (например, через курс по профилированию и трассировкам: [ /course/ ]). Но даже без обучения ключевой навык один: всегда отделяйте ожидание от вычислений и привязывайте вывод к конкретному span/запросу/участку CPU — тогда проблема будет решаться предсказуемо, а не “угадыванием”.
Если расскажете, какой у вас источник трасс (Prometheus+Grafana, ELK, Datadog, Jaeger, OpenTelemetry) и какой стек БД/ORM, можно предложить более конкретный план диагностики под вашу конфигурацию и примерную структуру spans для FastAPI.