Принципы контрактов в интеграциях: версии схем, совместимость и миграции
Построим стратегию версионирования API/событий, чтобы не ломать клиентов. Рассмотрим breaking vs non-breaking изменения, обратную совместимость и миграции данных.
Новости индустрии, разборы технологий и практические гайды для разработчиков.
Построим стратегию версионирования API/событий, чтобы не ломать клиентов. Рассмотрим breaking vs non-breaking изменения, обратную совместимость и миграции данных.
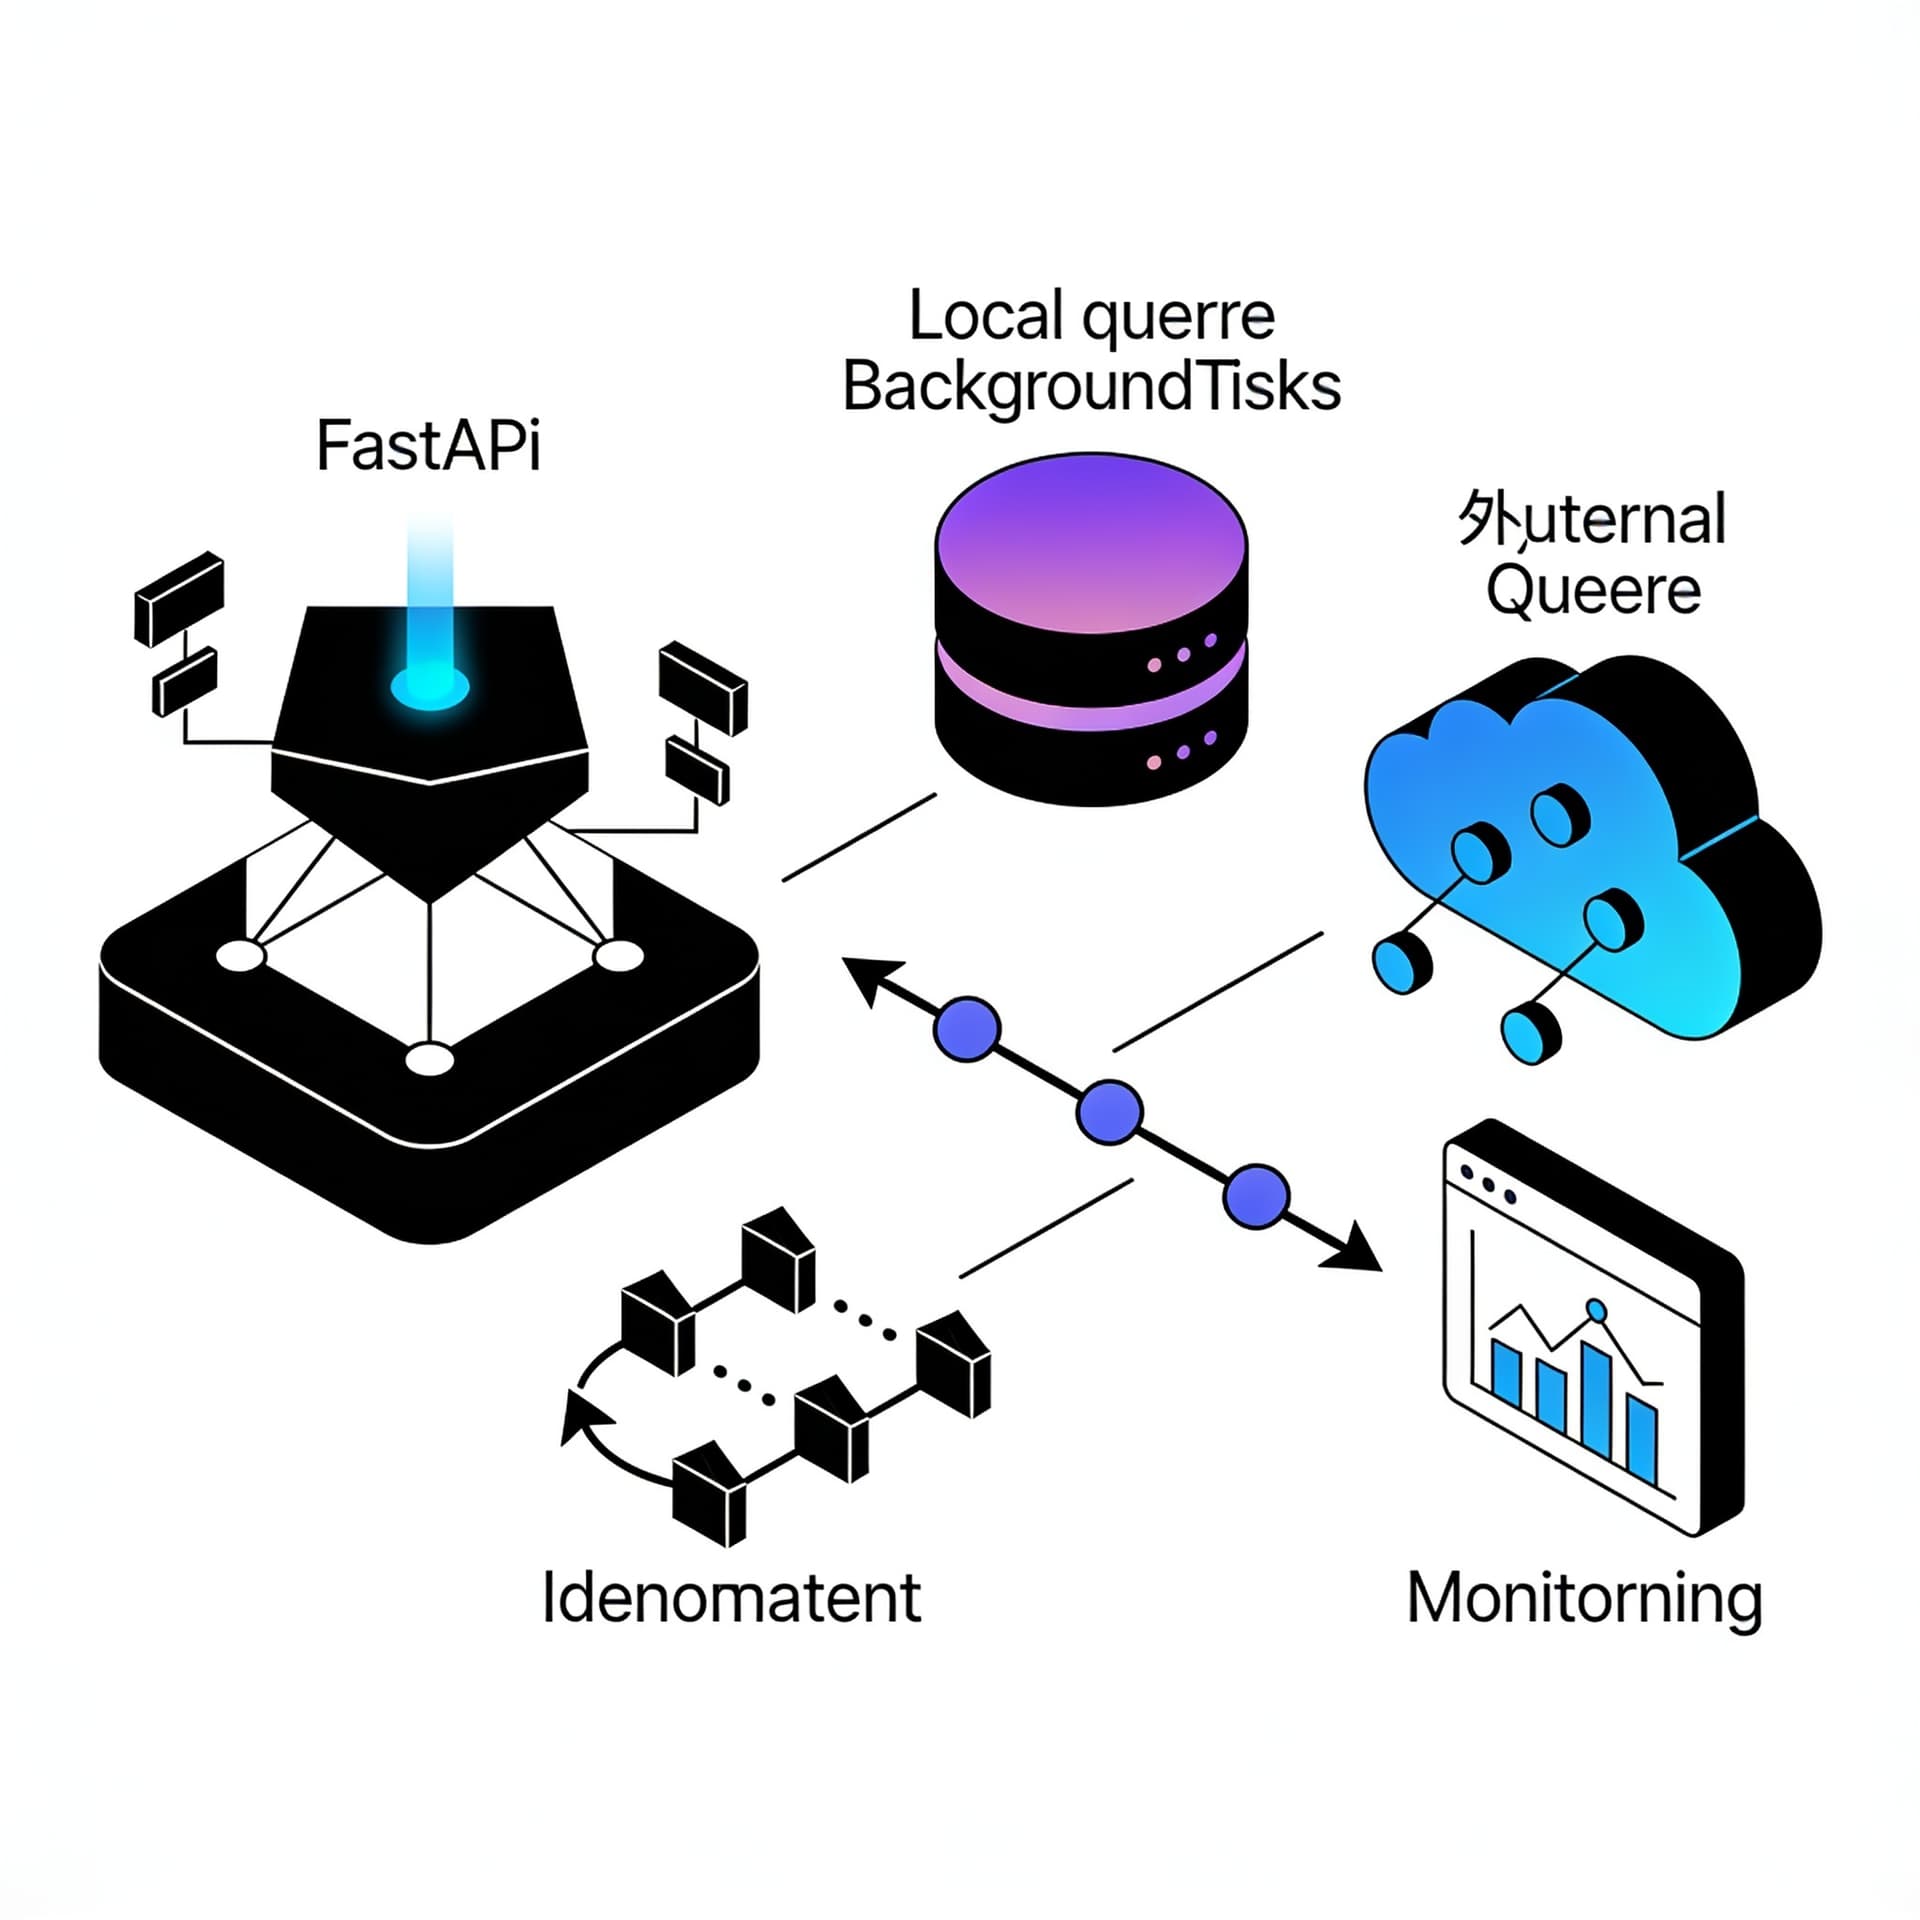
Поймём различия между синхронной обработкой, BackgroundTasks и внешними очередями. Разберём idempotency, ретраи и мониторинг фоновых процессов.
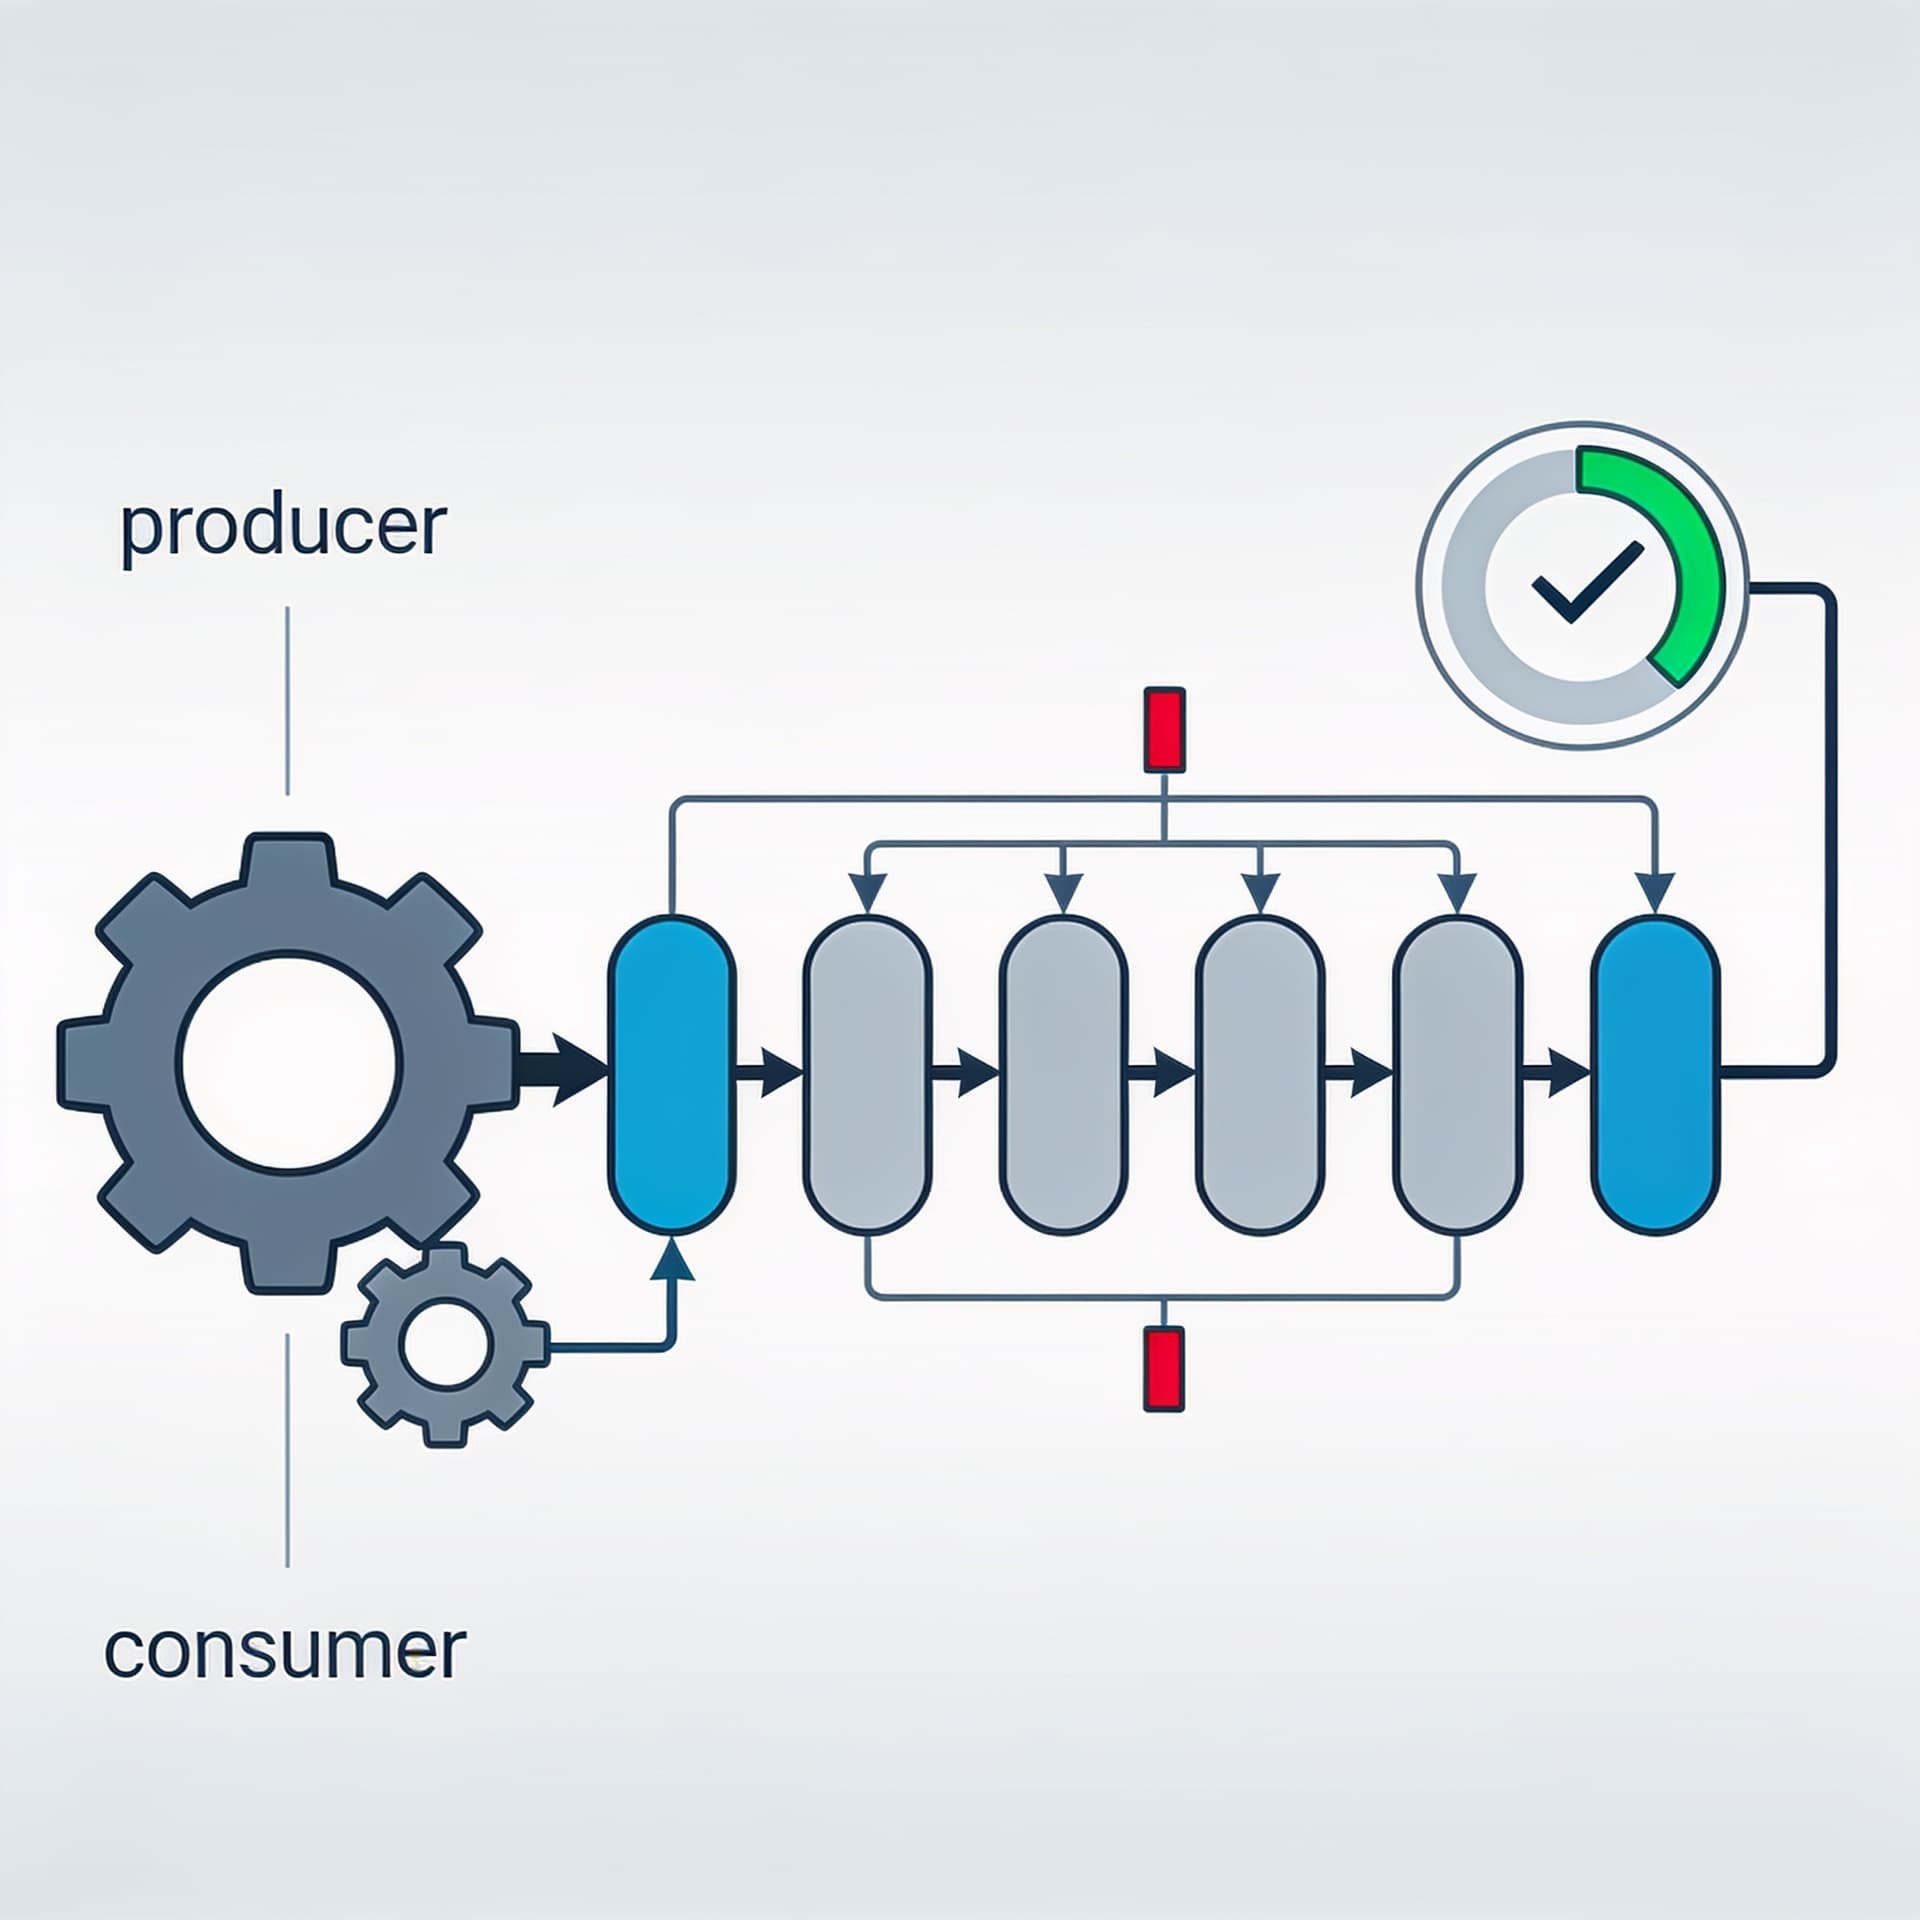
Объясним, как выбирать размеры очередей, где ставить ограничители и как реагировать на переполнение. Разберём паттерны consumer-producer и корректное завершение фоновых задач.
Поясним, как добавлять подтверждения, прогресс, выбор вариантов, нормальную обработку Ctrl+C и понятный UX. Рассмотрим структуру команды и контракты аргументов.
Разберём типовые источники проблем: инъекции, небезопасные десериализации, неверная обработка секретов и ошибок. Дадим практические шаблоны защиты.
Соберём доменную модель так, чтобы API отражало смысл, а не “табличную” структуру. Рассмотрим границы контекстов, модели команд/запросов и избегание утечек.
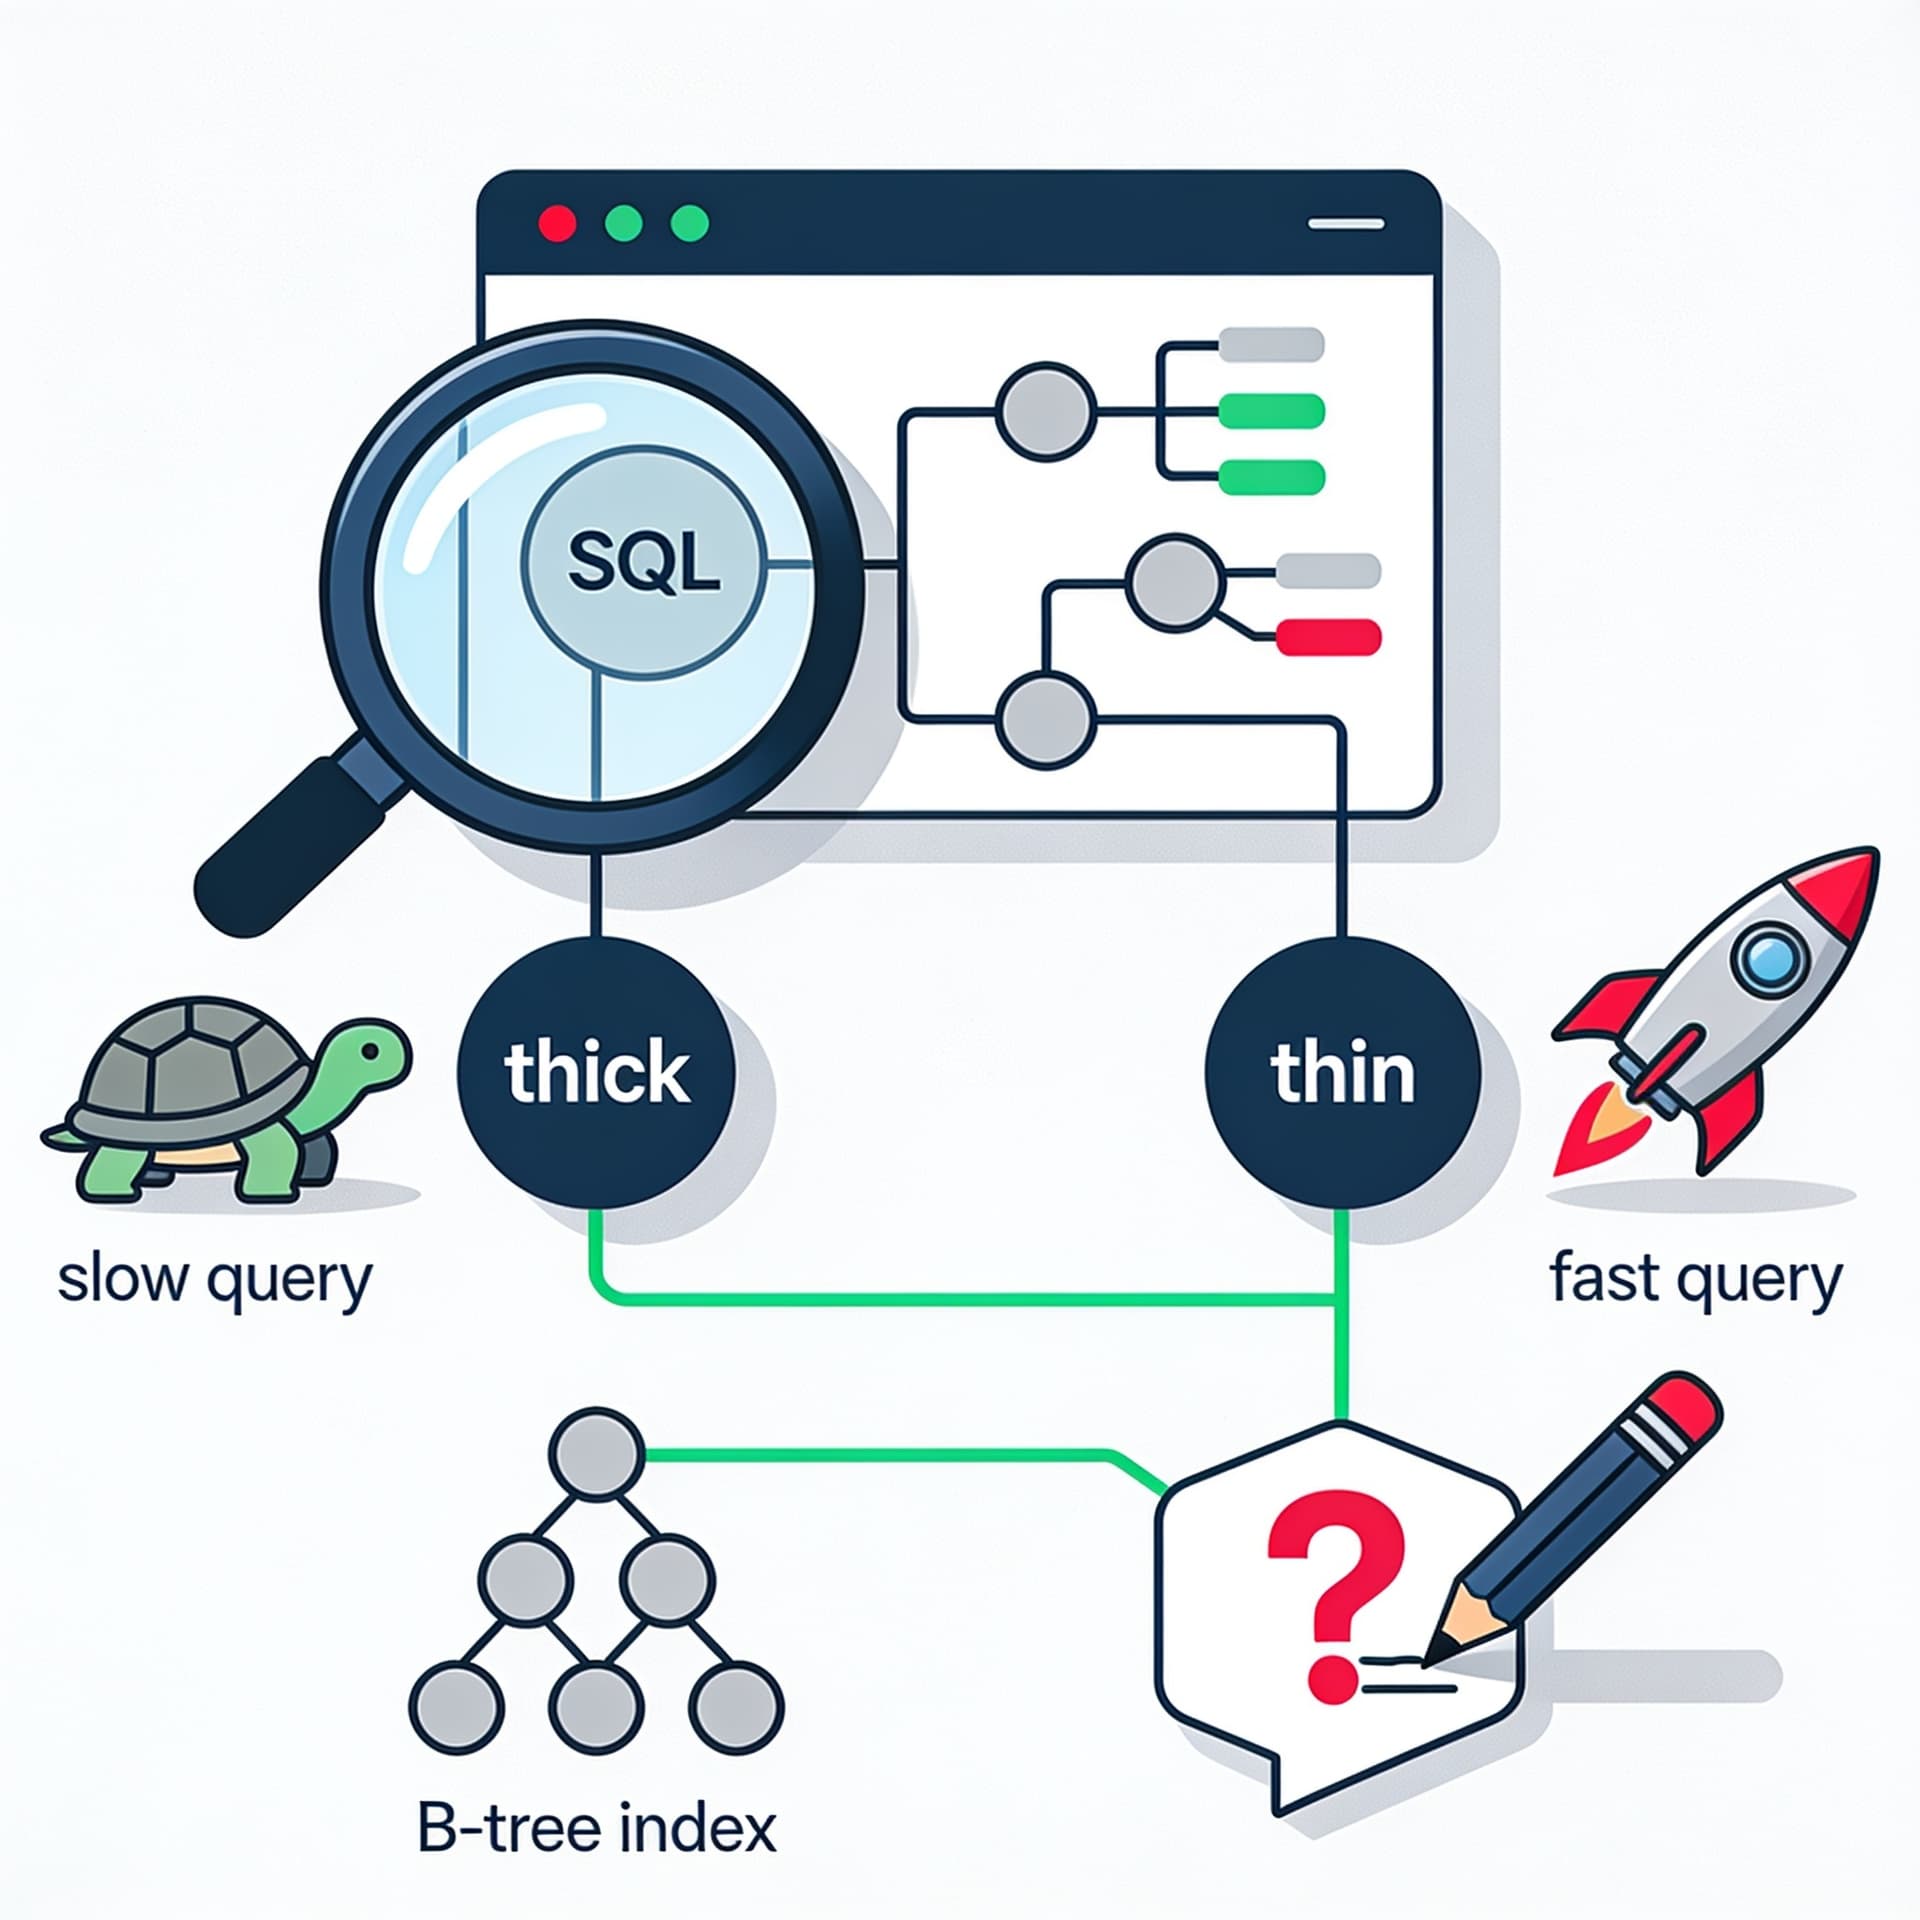
Покажем, как читать план выполнения, находить узкие места и формулировать запросы заново. Разберём случаи, где индекс “есть”, но ускорения нет.
Научим распознавать тип входных данных и выбирать подходящую структуру данных. Разберём “интуитивные” оценки сложности на реальных задачах.
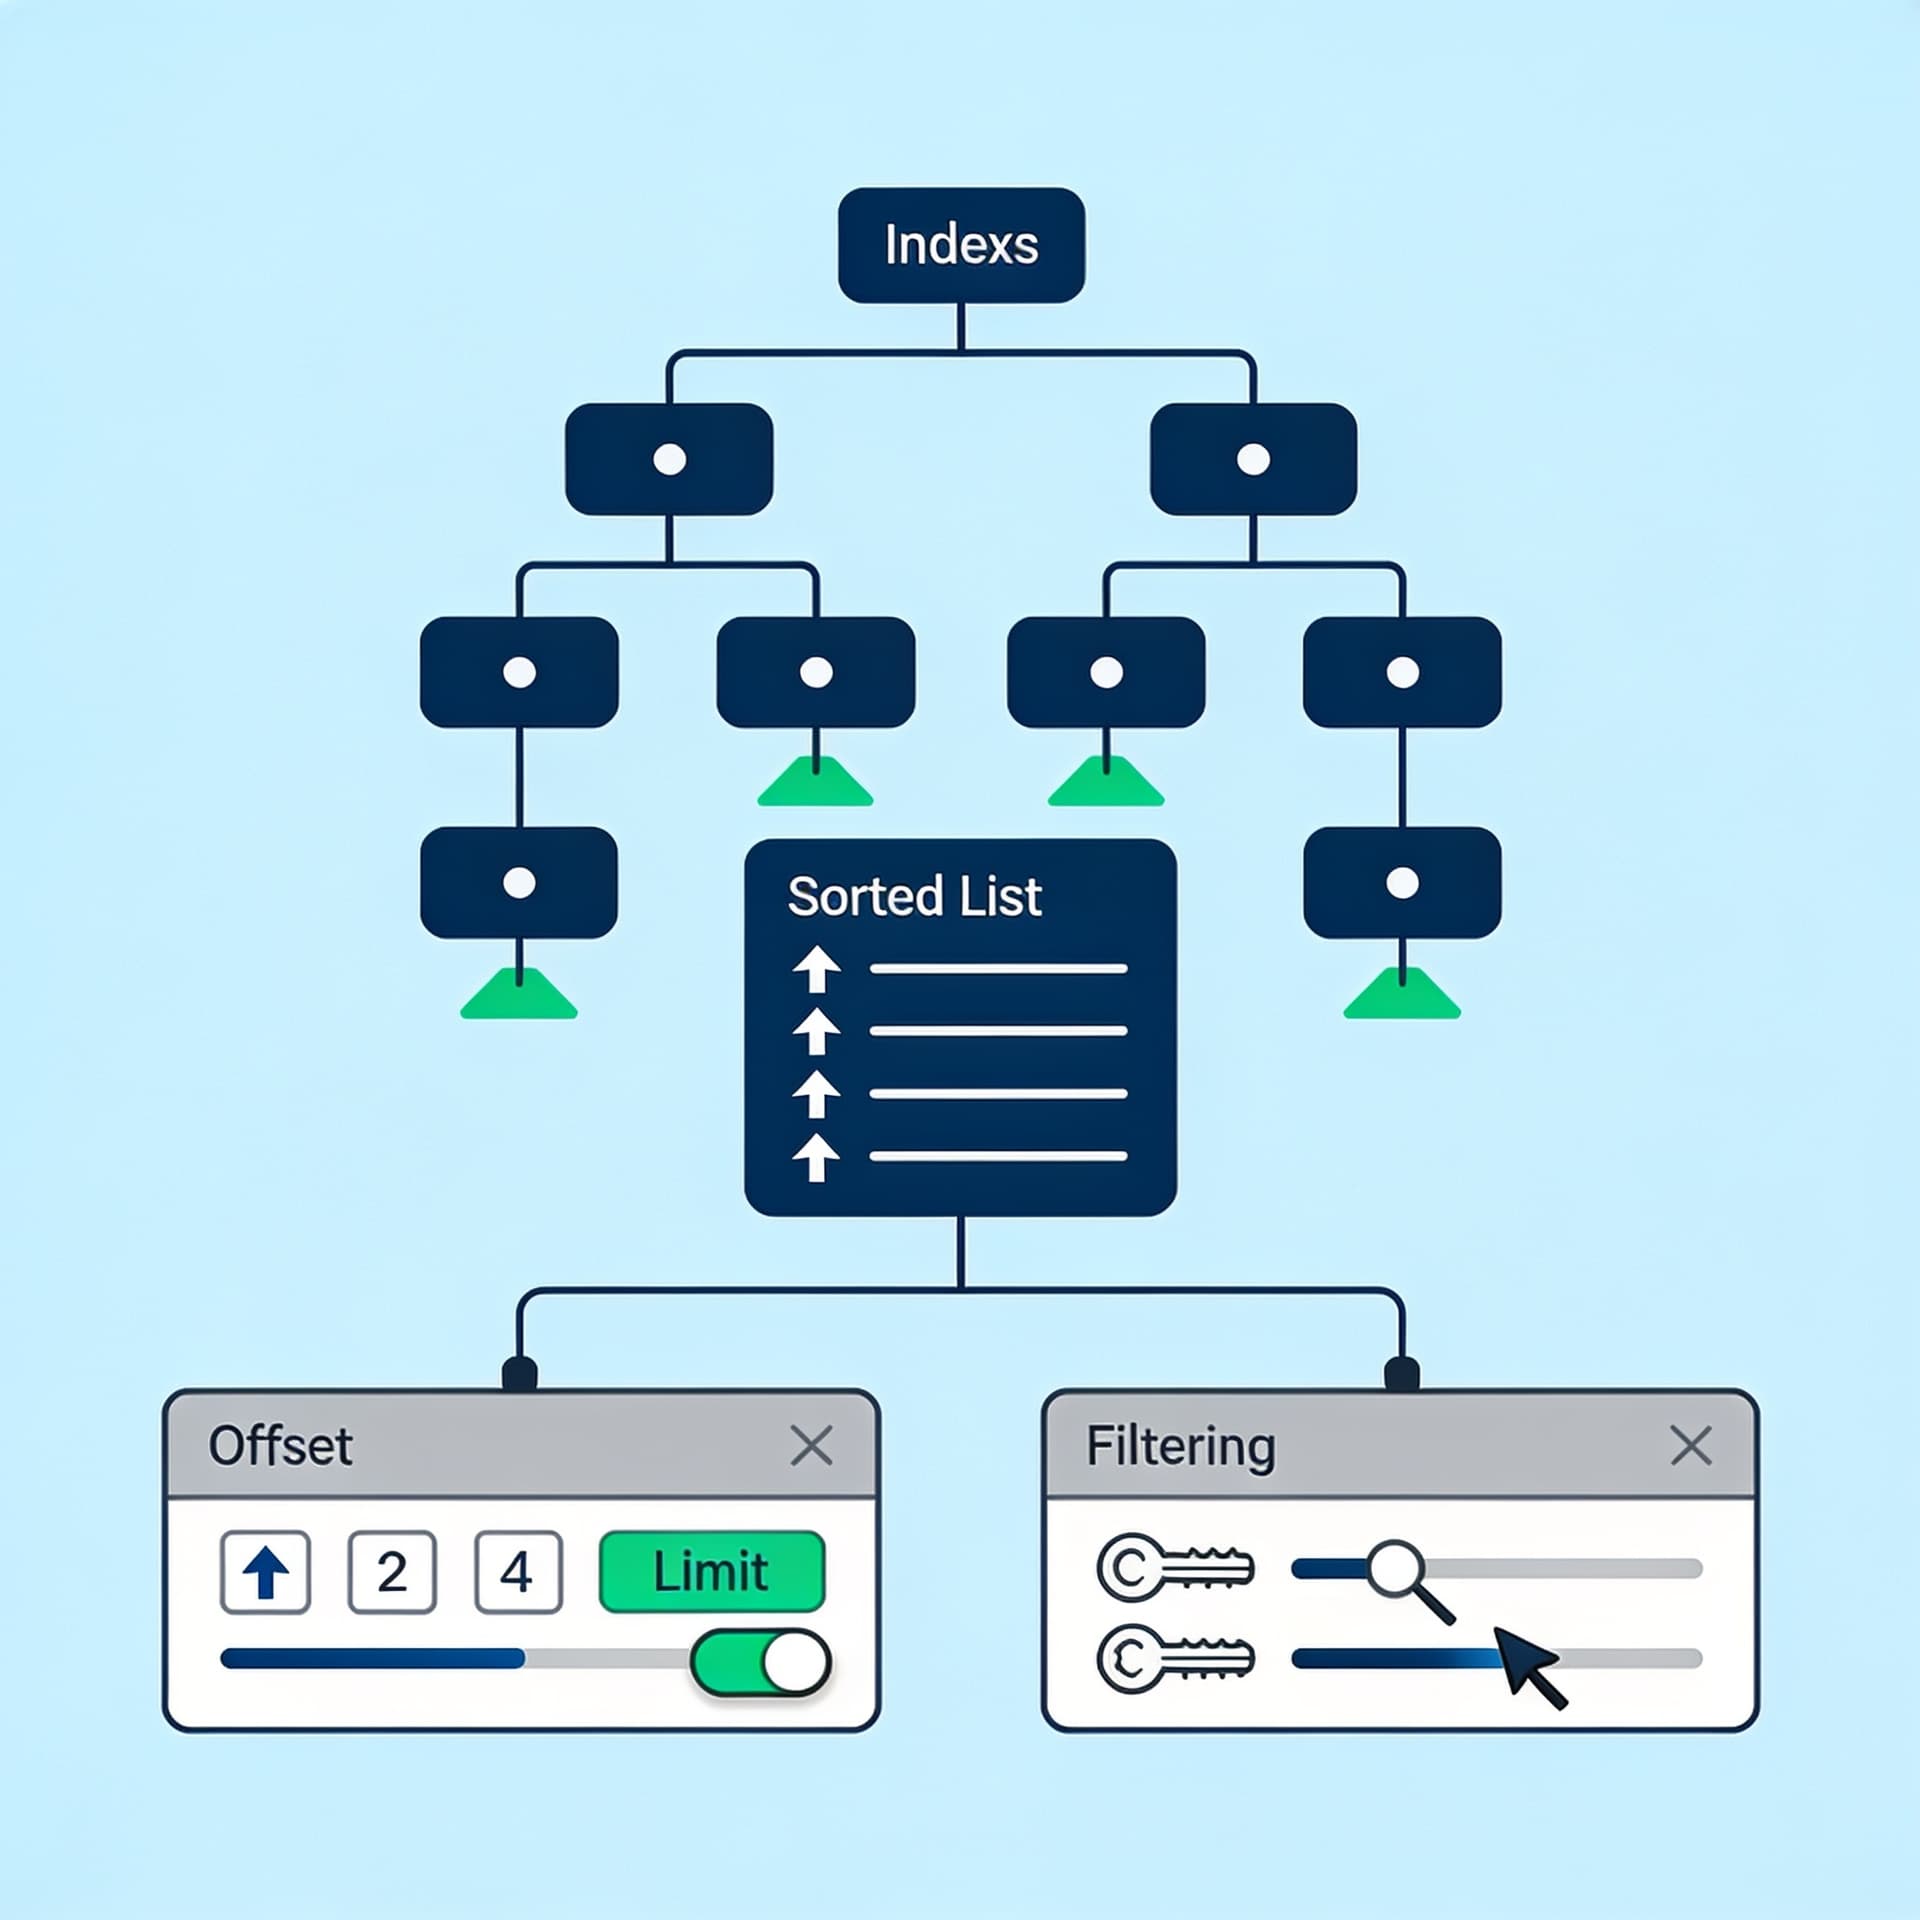
Разберём, как организовать фильтрацию и сортировку так, чтобы результаты были стабильными. Сравним offset/limit и keyset pagination и объясним влияние индексов.
Поговорим о ключах идемпотентности, дедупликации, повторе запросов и схемах ошибок. Покажем, как не ломать бизнес-логику при ретраях клиентов.
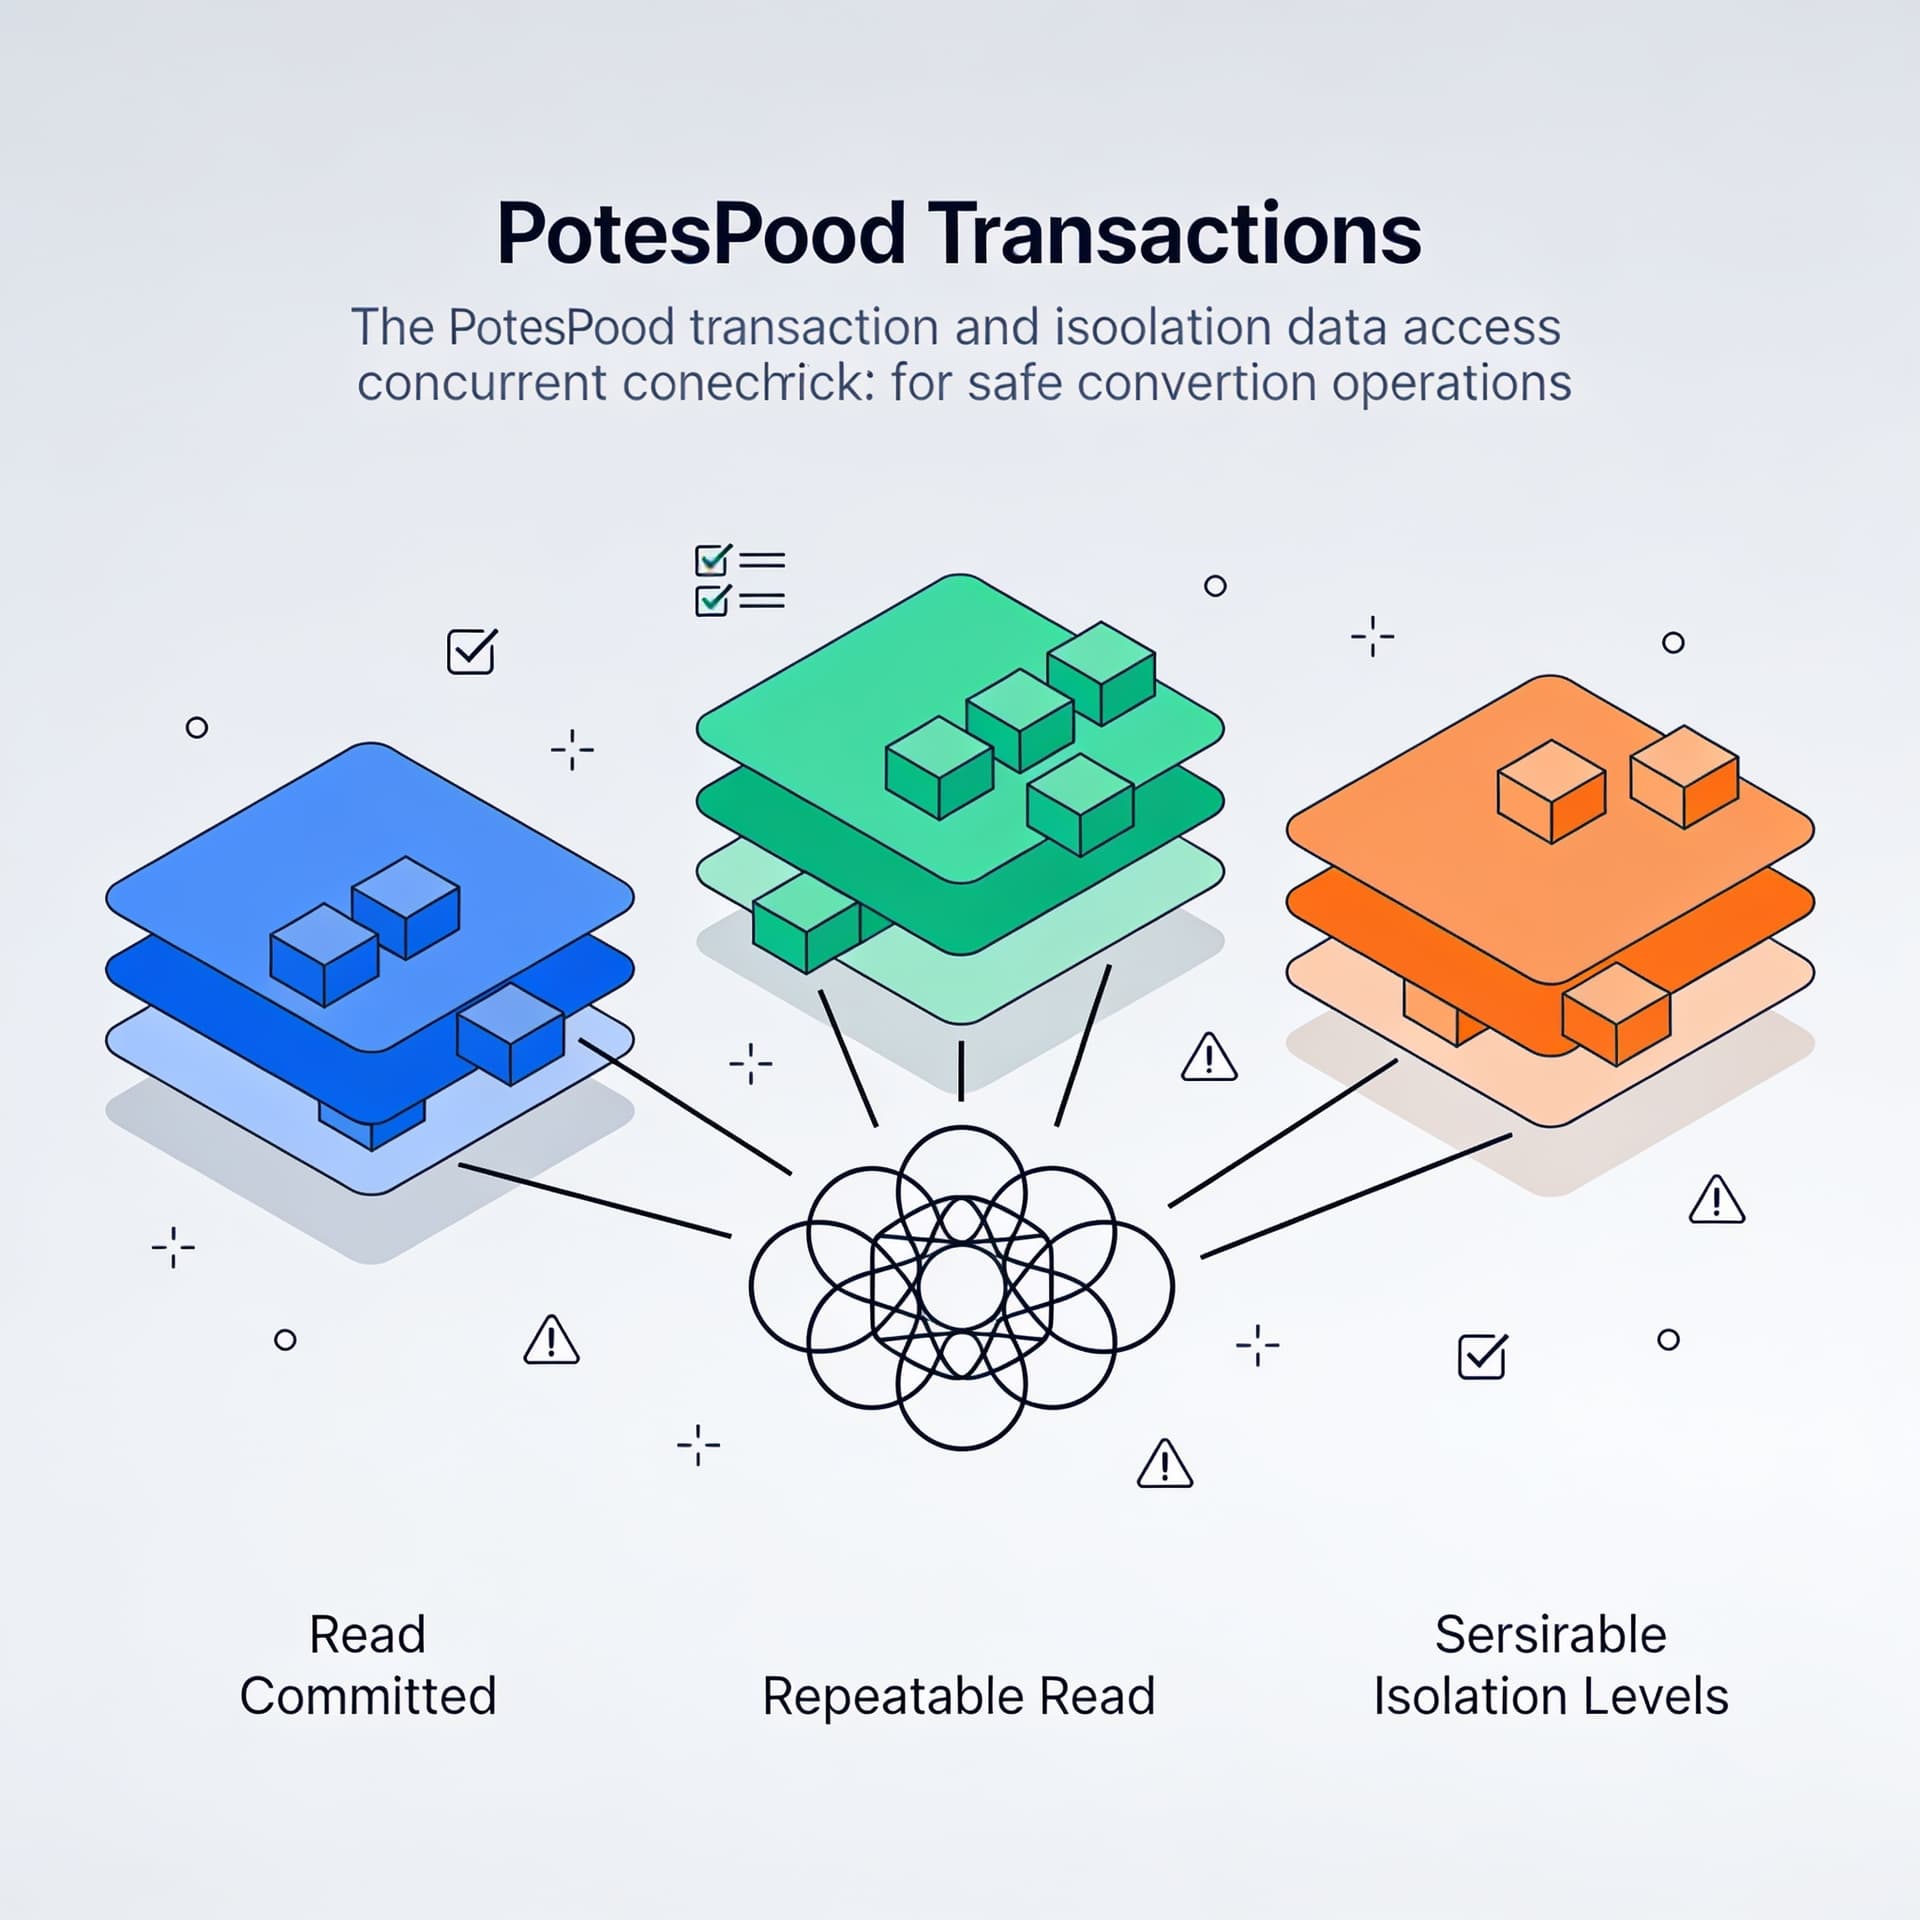
Разберём Read Committed/Repeatable Read/Serializable на примерах аномалий и реальных паттернов. Дадим чек-лист, как безопасно читать и писать в конкурентной среде.
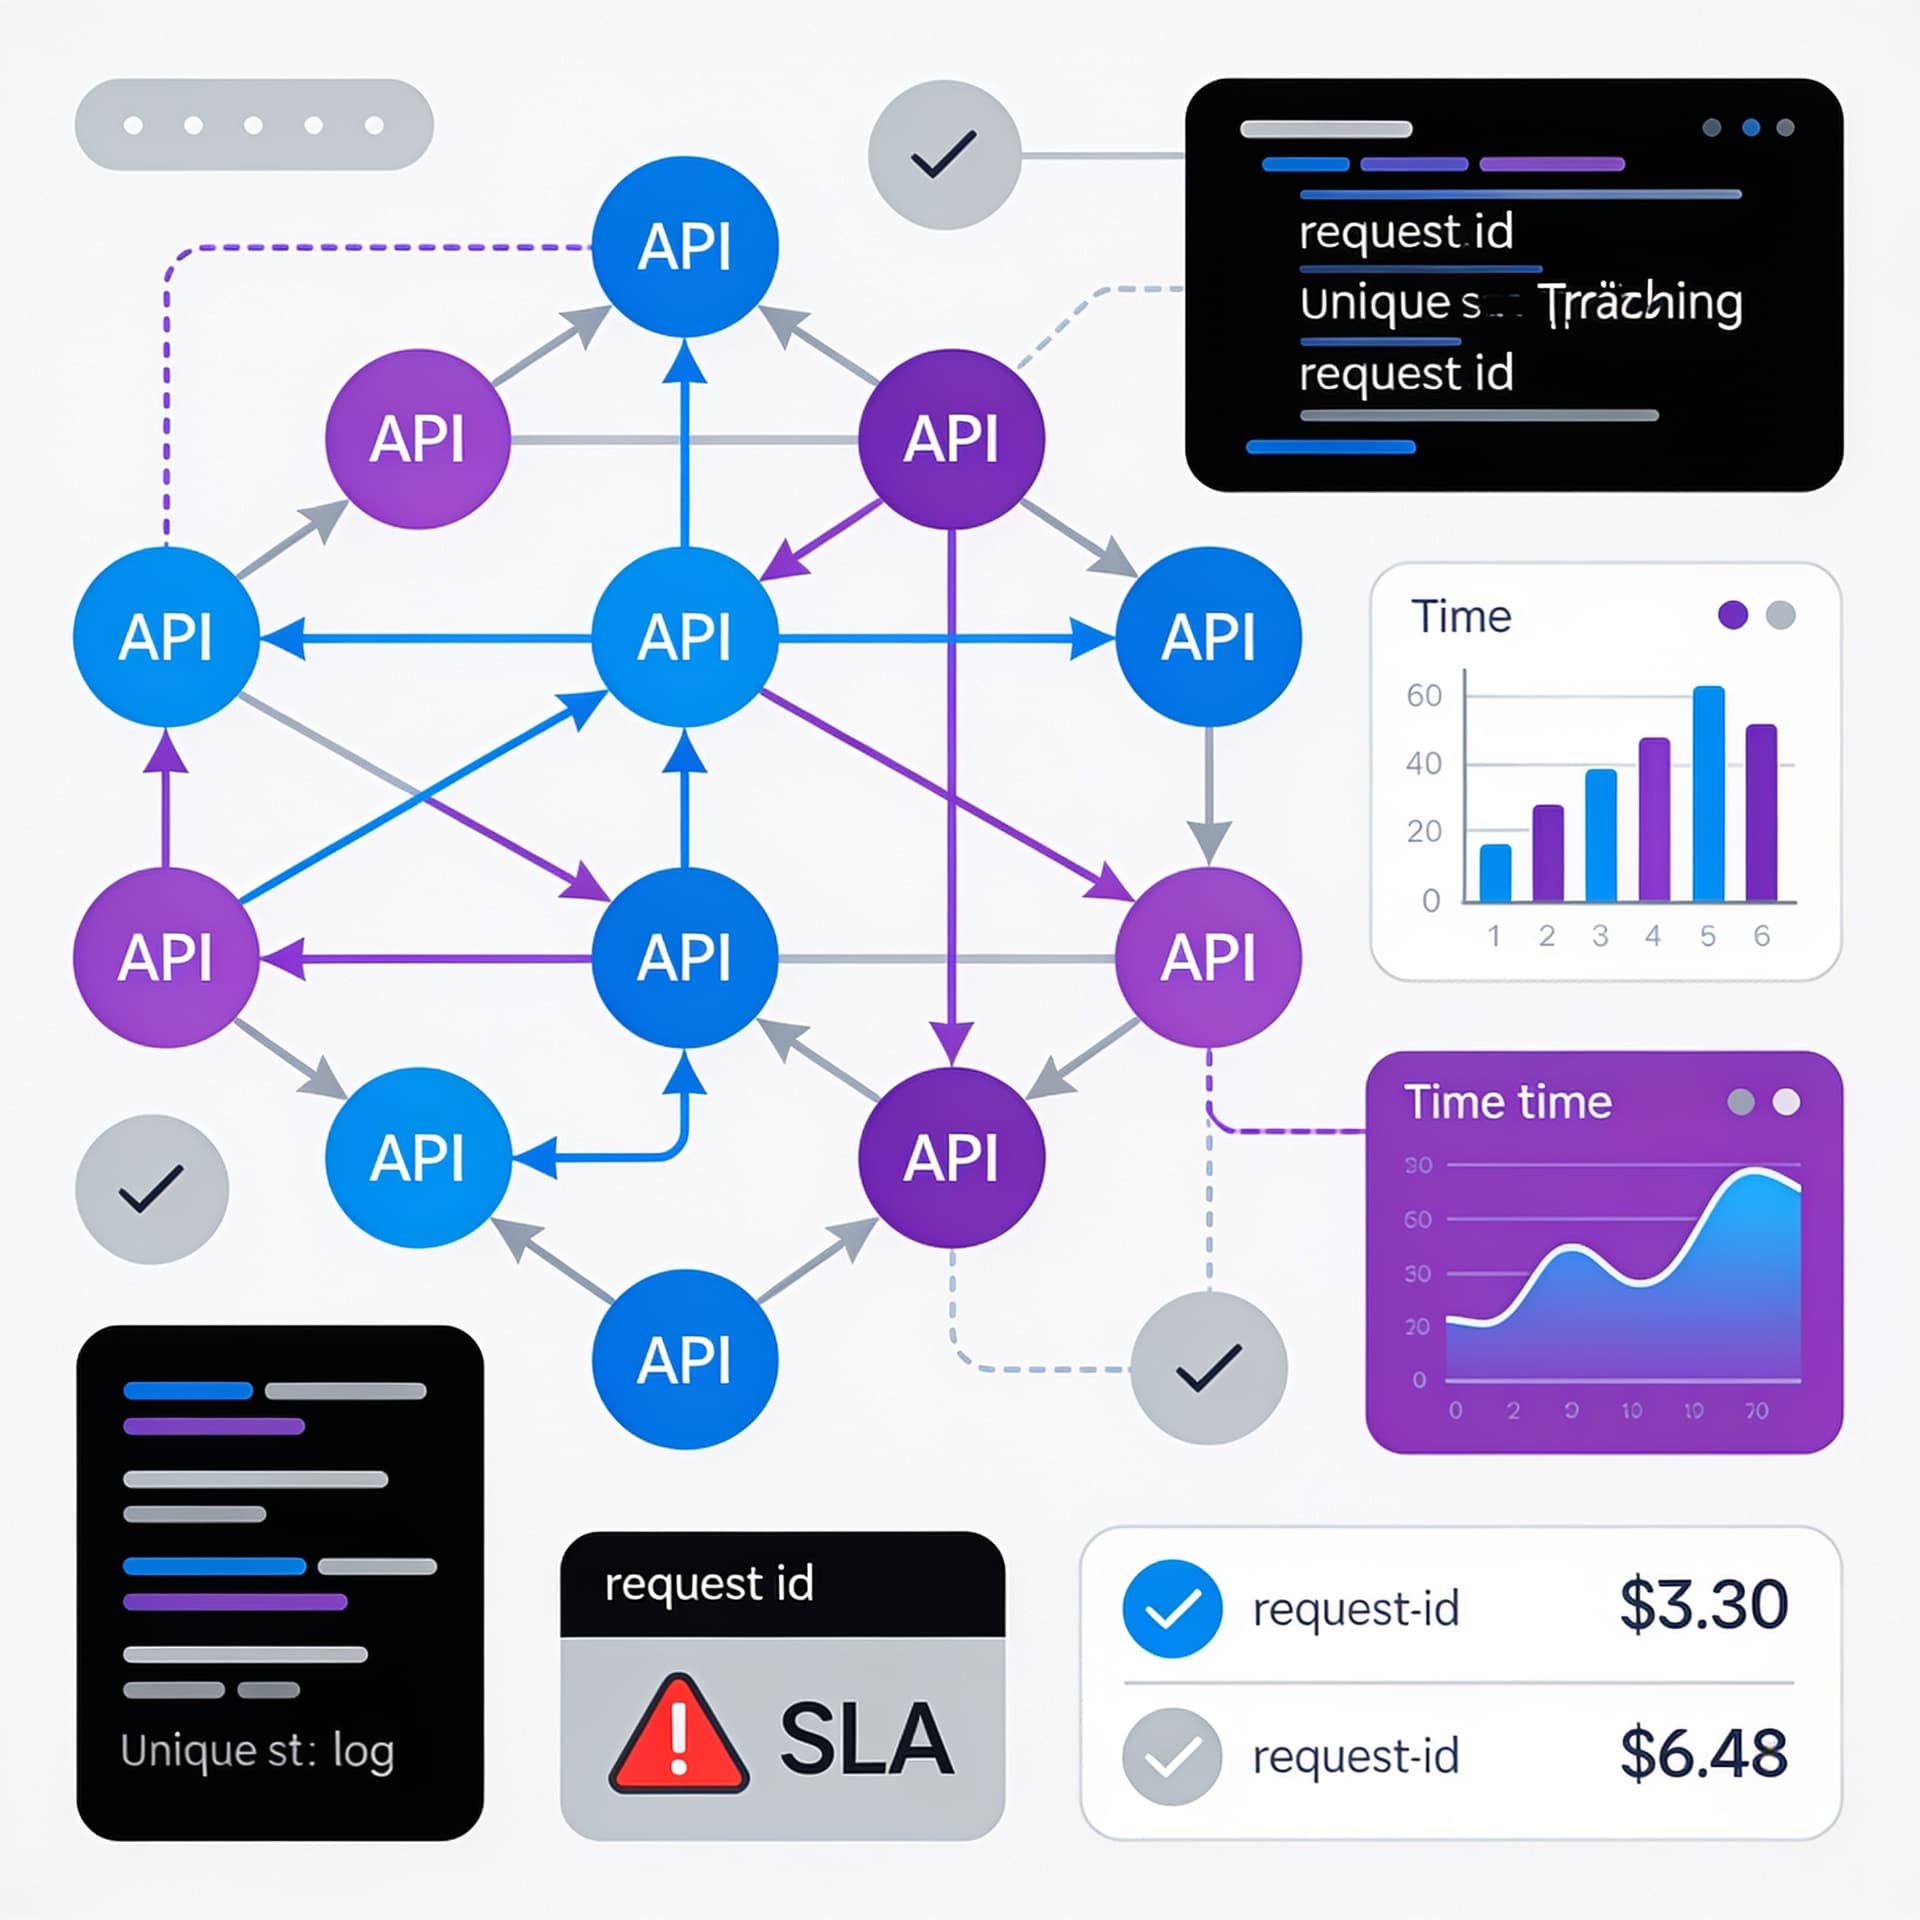
Настроим подход к логам/метрикам/трейсам так, чтобы инциденты находились за минуты, а не “по ощущениям”. Рассмотрим корреляцию по request-id и практики формирования событий.